
Action Aggregate PySpark
Chaque attribut de destination doit être associé à un attribut source. Lorsque plusieurs tables sources sont sélectionnées
Objectif
L'action Aggregate PySpark vous permet de transférer des données depuis n'importe quelle table préexistante vers n'importe quelle autre table (y compris la même table), à l'aide d'Apache Spark™.
La portée de l'action Aggregate PySpark — qui permet généralement la gestion du SQL ainsi que la jointure de plusieurs tables et le regroupement des résultats — est large, ce qui en fait l'une des actions les plus utilisées dans les workflows de traitement de données.
Configurer une action Aggregate PySpark
Une action Aggregate PySpark est composée d'une liste d'une ou plusieurs tables sources à partir desquelles les valeurs seront extraites et placées dans une seule table de destination. Chaque attribut de destination doit être associé à un attribut source.
Lorsque plusieurs tables sources sont sélectionnées, il est nécessaire de spécifier une condition de jointure, tout comme cela se fait en SQL.
Notez que laisser un attribut de destination non associé dans la configuration de l'action Aggregate PySpark déclenchera une erreur au lancement de l'action. Si vous préférez laisser le champ de destination vide, veillez simplement à le retirer de la liste des attributs associés.
Lorsque des attributs de destination sont retirés de la liste des attributs associés, le comportement suivant est à prévoir :
- Si l'action Aggregate PySpark insère de nouvelles lignes, elle remplira simplement la colonne de l'attribut de destination avec des valeurs NULL.
- Si l'action Aggregate PySpark met à jour des lignes existantes (c'est-à-dire insère par-dessus des données existantes), elle laissera la valeur précédente intacte, qu'elle soit NULL ou non.
Des exemples de cas d'usage pour une table source unique et pour plusieurs tables sources sont décrits ci-dessous.
Transférer des données brutes vers une table principale
Créez une nouvelle action Aggregate PySpark :
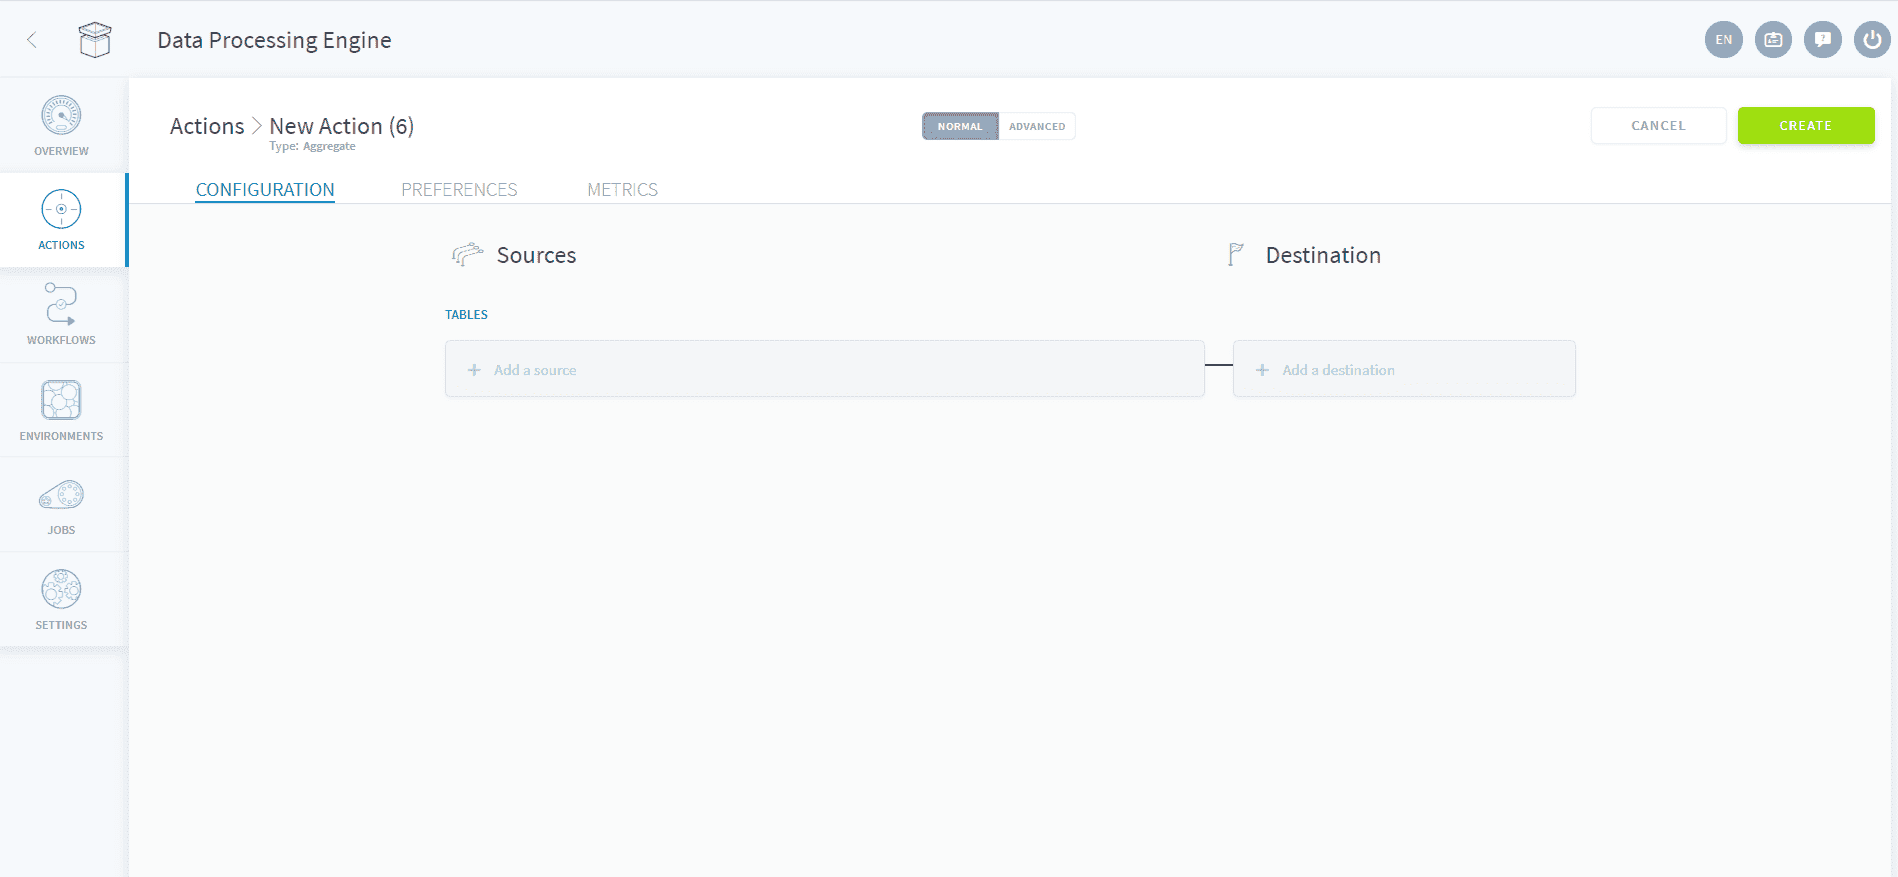
Sélectionnez la table source (à gauche) et la table de destination. Les attributs correspondants sont automatiquement associés lorsque cela est possible. Il est possible de sélectionner manuellement quels attributs sont associés entre la source et la destination.
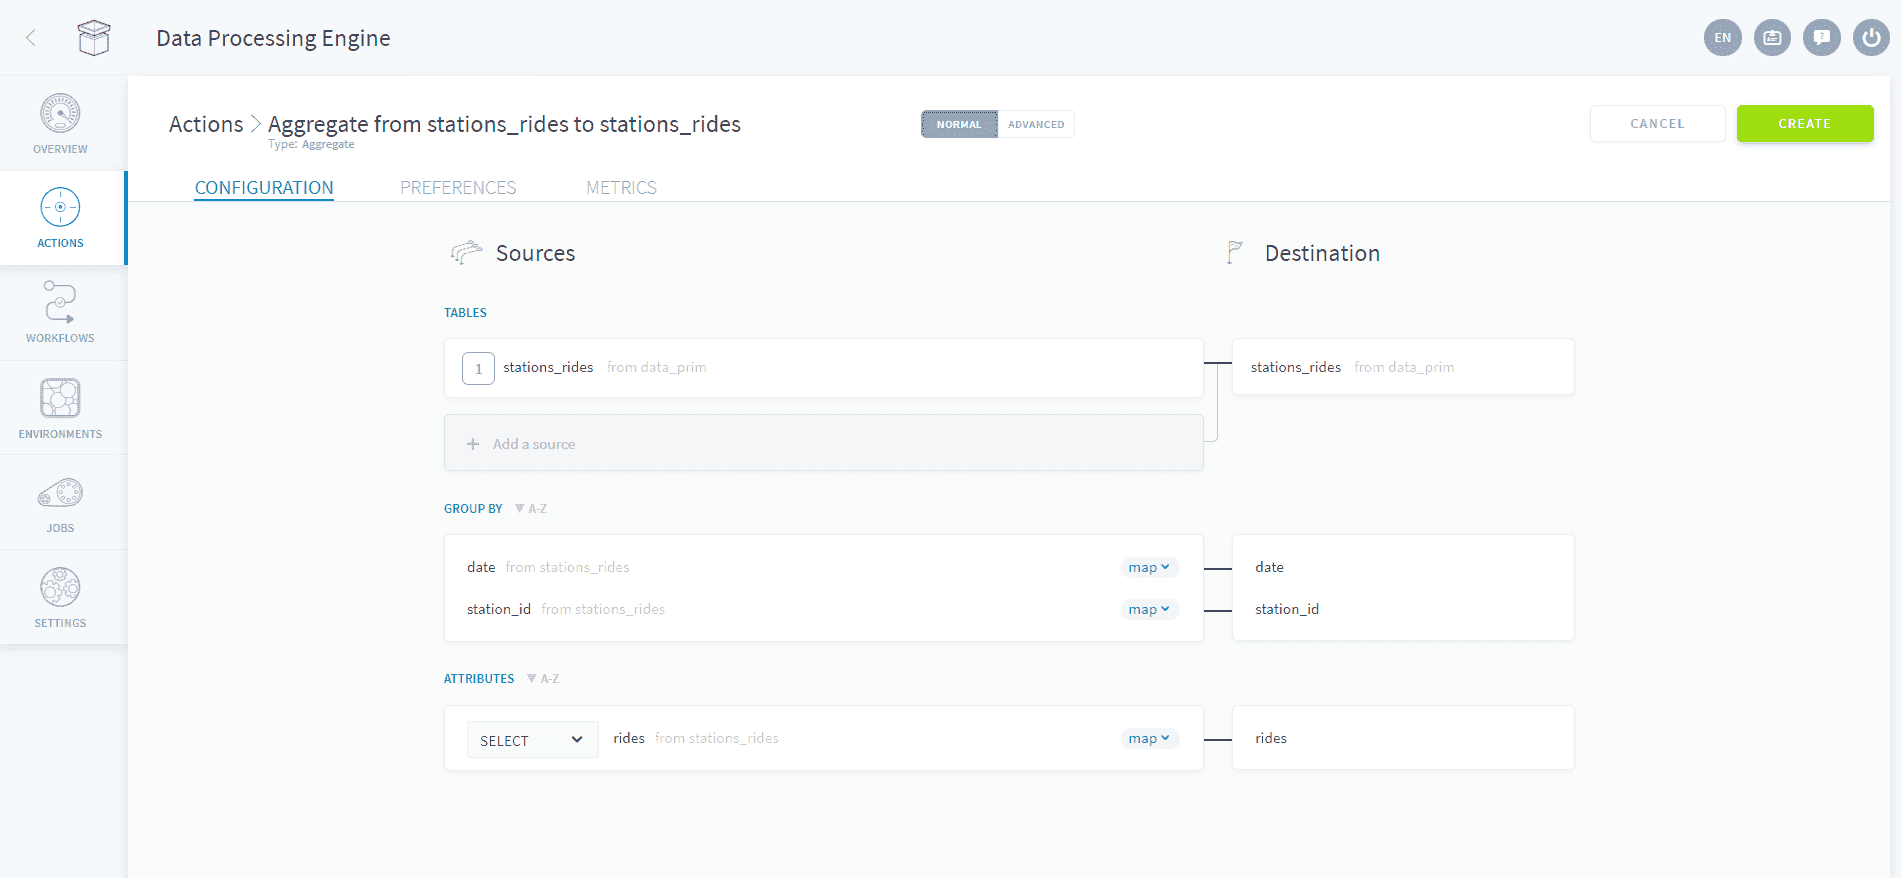
Si nécessaire, vous pouvez changer l'association en SQL ou en texte brut en cliquant sur le bouton MAP et en sélectionnant SQL ou txt.
Dans la section des attributs, il est également possible de changer le mode de calcul de chaque attribut. Dans l'exemple ci-dessus, SELECT a été choisi, mais d'autres options sont disponibles.
Appuyez sur Create en haut à droite pour créer l'action.
Associer un référentiel à une table principale
Pour spécifier une jointure, cliquez sur Add a source situé juste en dessous de la table source, vous serez invité à sélectionner une table avec laquelle effectuer la jointure. Sélectionnez le type de jointure dans le menu déroulant, et saisissez les conditions de jointure dans l'interface. Plusieurs tables sources peuvent être jointes.
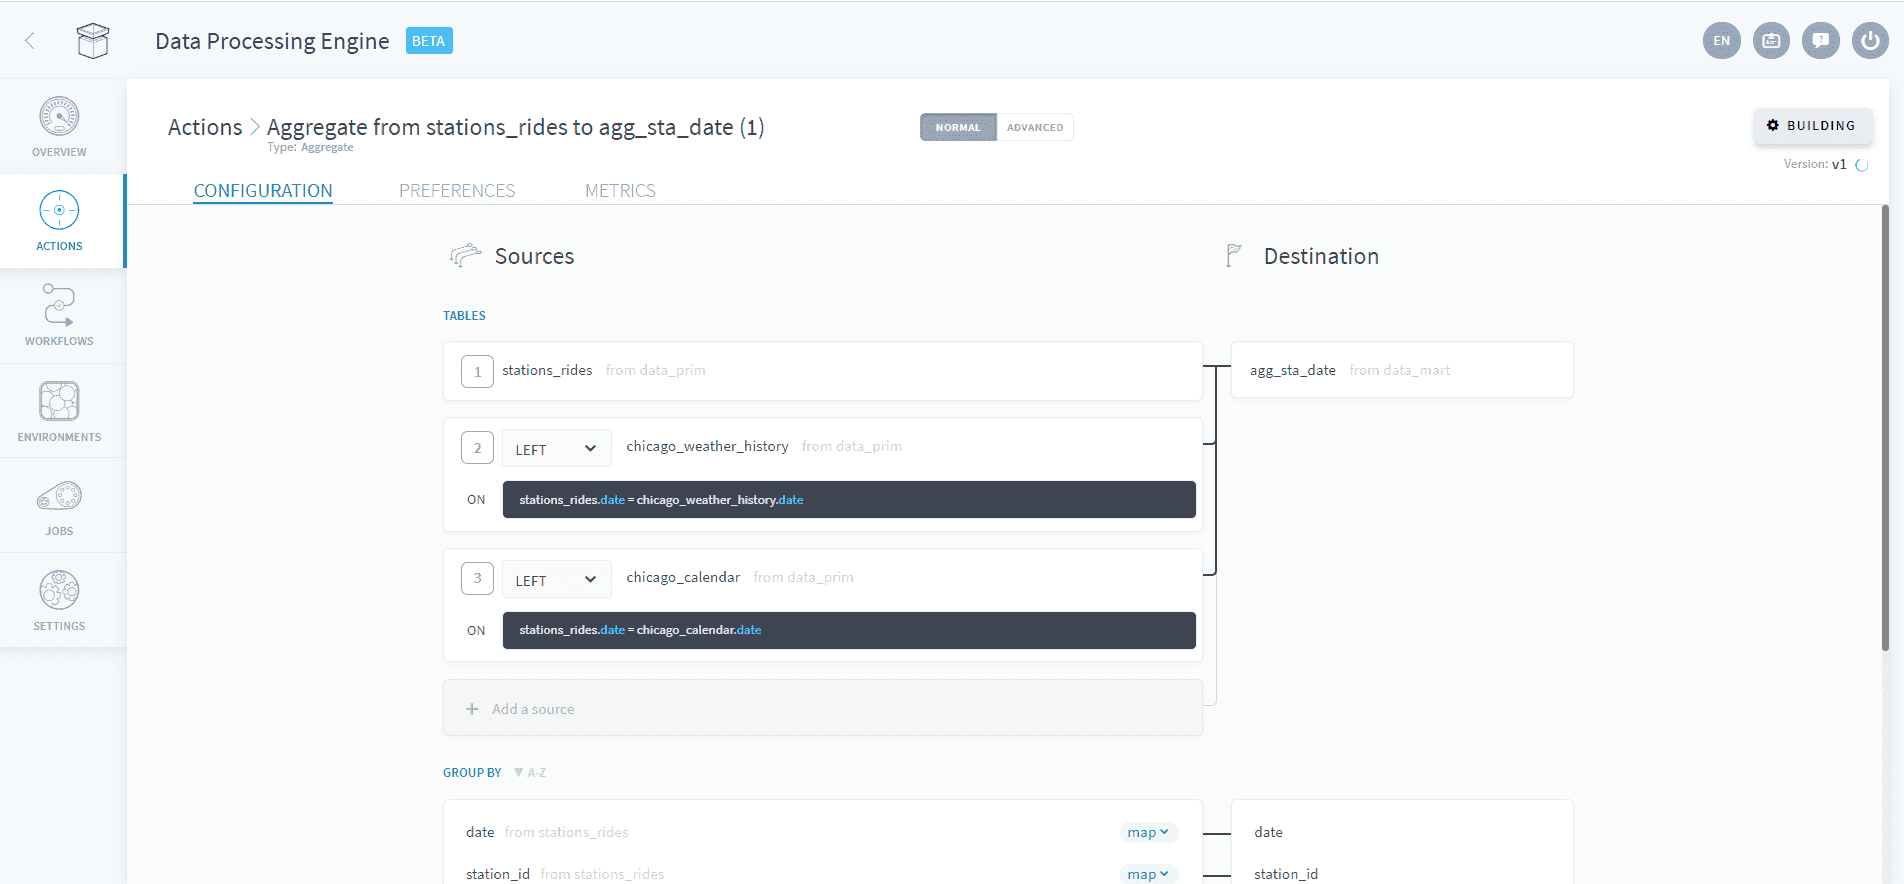
Les attributs de toutes les tables jointes peuvent ensuite être sélectionnés dans la section des attributs en bas, soit depuis les menus déroulants, soit en SQL.
Configurer les préférences de l'action
Une fois satisfait de l'association de vos attributs, utilisez l'onglet préférences pour configurer les paramètres de l'action.
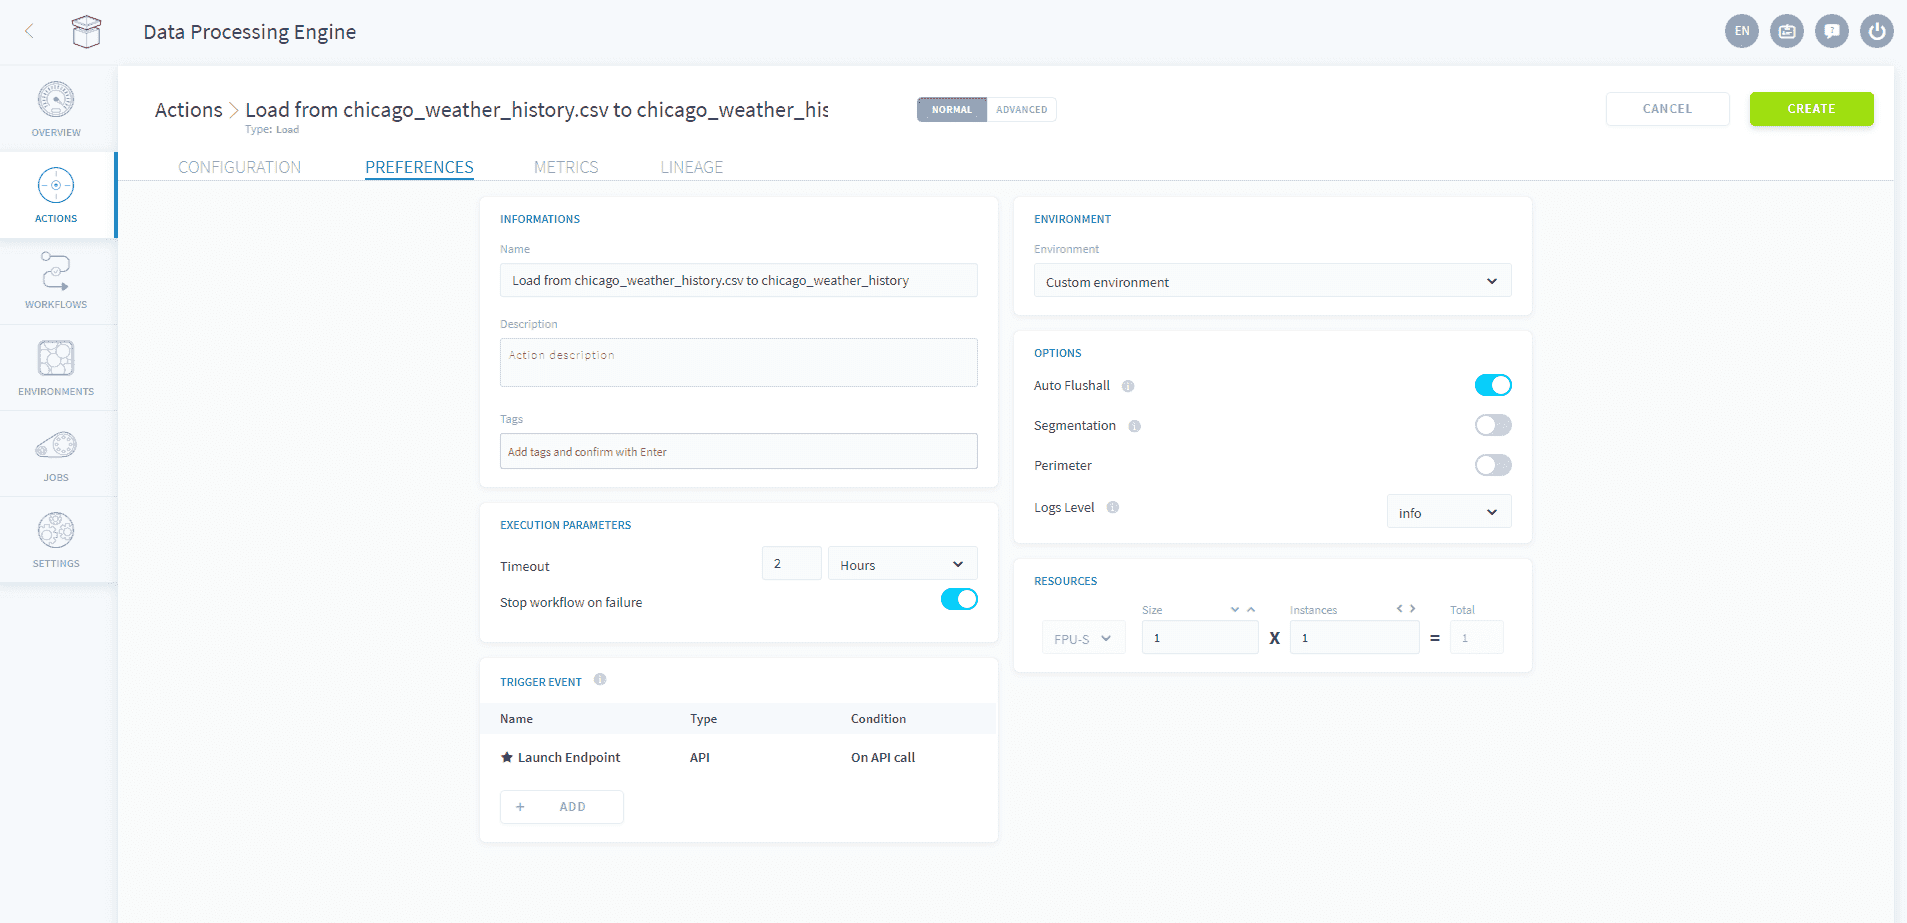
Notez que le mode d'exécution Always-up n'est pas disponible avec l'action PySpark et que vous devez utiliser le mode serverless avec celle-ci.
Utiliser le mode avancé
Si vous devez accéder au fichier de configuration JSON de l'action, vous pouvez activer le mode Advanced en cliquant sur Advanced en haut de la page.
Utiliser le mode avancé d'une action Aggregate
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.