
Data Processing Engine
Actions, workflows et notebooks, et les jobs qui les exécutent.
Qu'est-ce que le Data Processing Engine ?
Le Data Processing Engine construit et exécute les pipelines de données d'un projet, des sources brutes jusqu'aux tables que les analystes interrogent. Il couvre l'extraction et le chargement depuis une source enregistrée, la transformation des données déjà détenues dans le projet, et la planification et le déclenchement autour des deux.
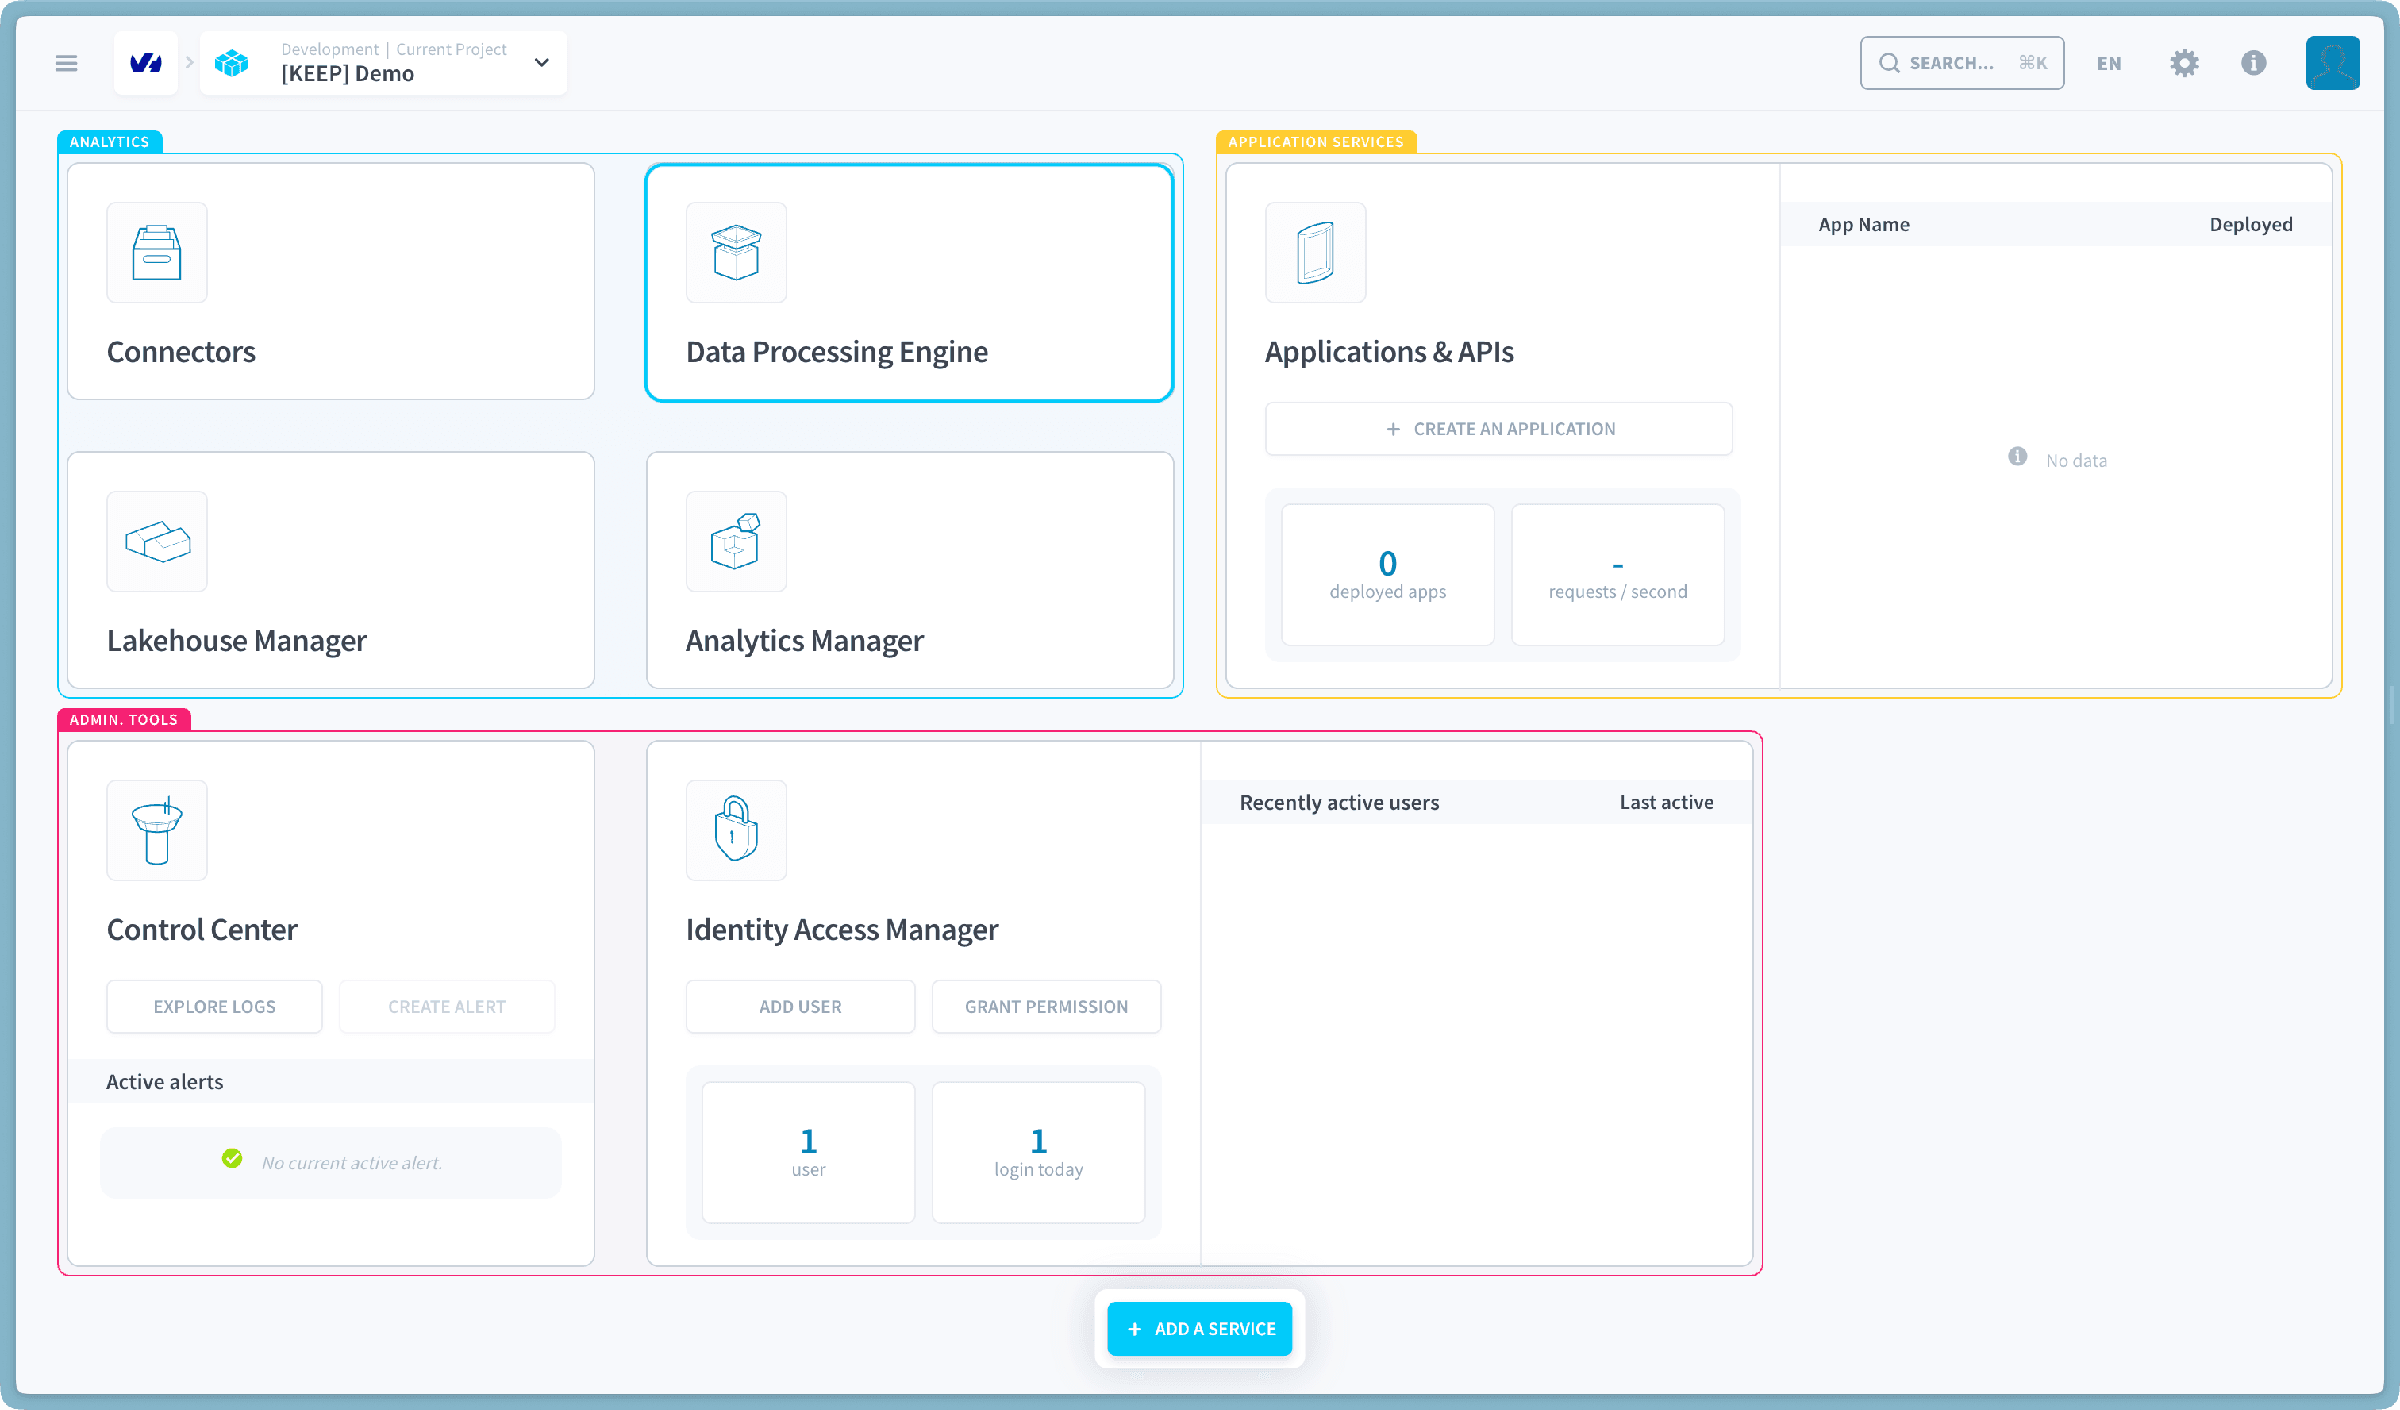
Quatre objets composent le modèle :
- Une action est une unité de travail : charger une table, l'agréger, exécuter du SQL, exécuter du Python ou du PySpark personnalisé.
- Un workflow enchaîne des actions en étapes selon un ordre d'exécution donné.
- Un environnement est un ensemble réutilisable de paramètres d'exécution, couvrant les ressources, le périmètre, la segmentation et les variables, partagé entre actions et workflows.
- Un job est une exécution d'une action ou d'un workflow.
L'exécution est basée sur des jobs plutôt que continue. Lorsqu'une action ou un workflow est déclenché, la platform construit un worker avec les ressources demandées, exécute le job, puis arrête le worker, de sorte que le compute n'est facturé que pour l'exécution. Un mode d'exécution toujours actif est disponible pour les charges de travail qui ne peuvent pas attendre le provisionnement.
Chaque job s'exécute en tant que compte de service, et les rôles IAM de cette identité décident de ce que le job peut lire et écrire. Les Notebooks sont l'équivalent interactif : des instances Jupyter pour explorer les données avant que leur logique ne devienne une action. Pour les jobs PySpark, le Spark History Server conserve l'UI Spark des exécutions passées disponible, de sorte qu'un job terminé peut toujours être inspecté étape par étape.
Actions→
Une unité de travail : charger, transformer, exporter ou nettoyer.
Workflows→
Enchaîner des actions en étapes selon un ordre d'exécution.
Environnements→
Paramètres d'exécution réutilisables partagés entre actions.
Jobs→
Chaque exécution, son état, ses ressources et son historique.
Notebooks→
Instances Jupyter pour explorer les données de manière interactive.
Spark History Server→
Inspecter une exécution Spark terminée et son analyse DataFlint.
Paramètres→
Valeurs par défaut et quotas au niveau du moteur.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.