
AI Deploy - Tutoriel - Déployer une app de classification audio grâce à Streamlit
Comment déployer une app Streamlit pour classifier les sons des mammifères marins
AI Deploy est couvert par les Conditions particulières OVHcloud Public Cloud.
Objectif
L'objectif de ce tutoriel est de déployer une application permettant de classifier des sons à partir d'un modèle pré-entraîné.
Le cas d'usage porte sur les sons de mammifères marins, un sujet déjà traité dans un précédent tutoriel.
Pour cela, vous allez utiliser Streamlit, un framework Python qui transforme des scripts en application web partageable. Vous apprendrez également à construire et à utiliser une image Docker personnalisée pour une application Streamlit.
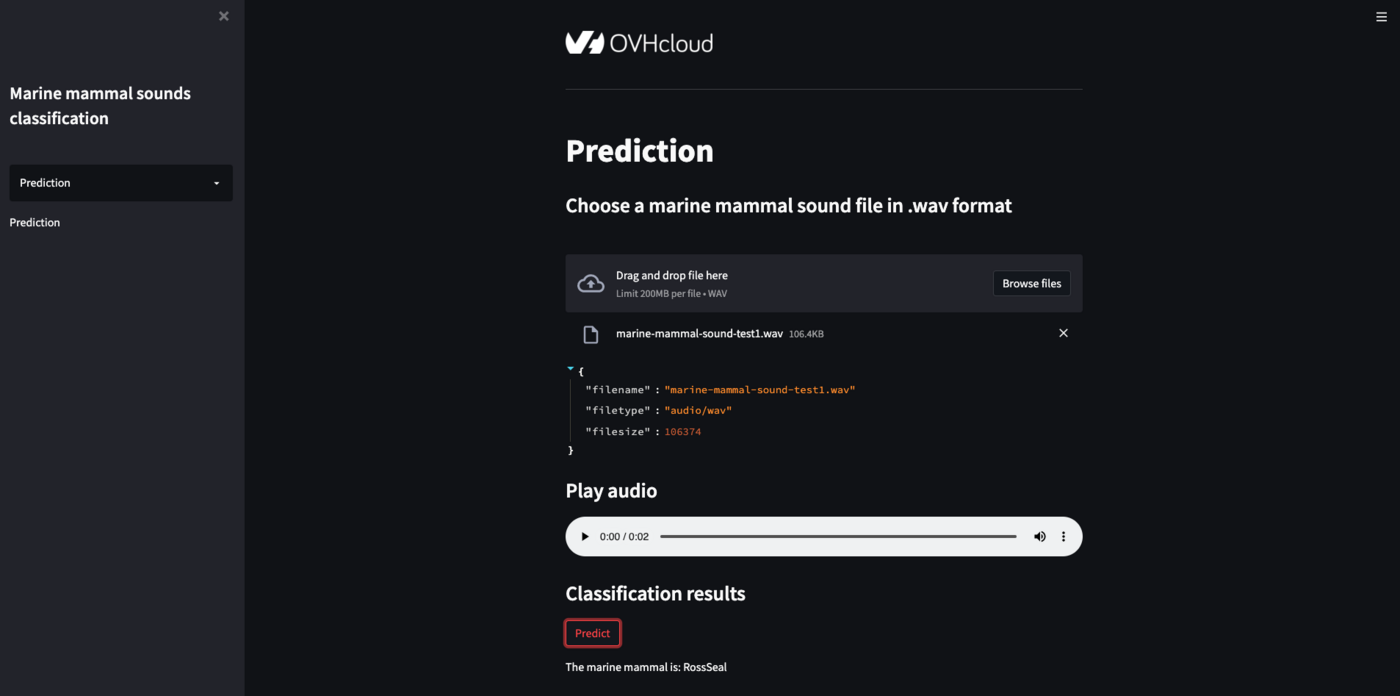
Aperçu de l'app :
Prérequis
- Un projet AI Deploy créé au sein d'un projet Public Cloud dans votre compte OVHcloud ;
- Un utilisateur pour AI Deploy ;
- Docker installé sur votre ordinateur local ;
- Quelques connaissances sur la construction d'images et les Dockerfile ;
- Vous devez également avoir suivi les étapes du notebook de classification des sons de mammifères marins du dépôt GitHub. Vous pourrez ainsi obtenir votre fichier
data.csvet sauvegarder votre modèle.
En pratique
Vous allez suivre différentes étapes pour construire votre application Streamlit.
- Plus d'informations sur les capacités de Streamlit sont disponibles ici.
- Le lien direct vers le fichier python complet est disponible ici.
Écrire l'application Streamlit
Créez un fichier Python nommé app.py.
À l'intérieur de ce fichier, importez les modules requis.
Créez la fonction qui permet de sauvegarder les sons envoyés dans un Object Container.
Créez la fonction qui permet de transformer chaque son en fichier csv.
Définissez la fonction qui classifie les sons à partir du modèle précédemment entraîné.
Pour en savoir plus sur la façon de sauvegarder un modèle avec TensorFlow, reportez-vous à l'étape 8 "Save the model for future inference" du notebook.
Ici, vous allez utiliser votre modèle entraîné, puis le sauvegarder dans un Object Container. Cliquez ici pour en savoir plus sur Object Storage.
Dans la barre latérale, si vous avez choisi Prediction, vous accédez à la fonction choice_prediction.
Elle vous permet d'envoyer un fichier son, de le convertir en fichier csv et d'obtenir le résultat de la classification en appelant les fonctions définies précédemment.
Il ne reste plus qu'à définir le main, où sont créées la barre latérale et la page d'accueil.
Écrire le fichier requirements.txt de l'application
Le fichier requirements.txt nous permettra d'indiquer tous les modules nécessaires au fonctionnement de notre application. Ce fichier sera utile lors de l'écriture du Dockerfile.
Nous allons ici principalement voir comment écrire le code app.py, le fichier requirements.txt et le Dockerfile. Si vous souhaitez voir le code complet, reportez-vous au dépôt GitHub.
Écrire le Dockerfile de l'application
Votre Dockerfile doit commencer par l'instruction FROM indiquant l'image parente à utiliser. Dans notre cas, nous choisissons de partir de l'image python:3.8 :
Créez le répertoire personnel et ajoutez-y vos fichiers :
Installez le fichier requirements.txt qui contient les modules Python nécessaires à l'aide d'une commande pip install ... :
Définissez votre commande de lancement par défaut pour démarrer l'application :
Attribuez les droits d'accès corrects à l'utilisateur ovhcloud (42420:42420) :
Construire l'image Docker depuis le Dockerfile
Depuis le répertoire contenant votre Dockerfile, exécutez l'une des commandes suivantes pour construire l'image de votre application :
-
La première commande construit l'image en utilisant l'architecture par défaut de votre système. Cela peut fonctionner si votre machine utilise déjà l'architecture
linux/amd64, qui est requise pour exécuter des containers avec nos produits AI. Cependant, sur des systèmes avec une architecture différente (par exempleARM64surApple Silicon), l'image résultante ne sera pas compatible et ne pourra pas être déployée. -
La seconde commande cible explicitement l'architecture
linux/amd64afin de garantir la compatibilité avec nos services AI. Elle nécessitebuildx, qui n'est pas installé par défaut. Si vous n'avez jamais utilisébuildxauparavant, vous pouvez l'installer en exécutant :docker buildx install
L'argument point . indique que votre contexte de build (emplacement du Dockerfile et des autres fichiers nécessaires) est le répertoire courant.
L'argument -t vous permet de choisir l'identifiant à donner à votre image. Les identifiants d'image sont généralement composés d'un nom et d'un tag de version <name>:<version>. Pour cet exemple, nous avons choisi streamlit_app:latest.
Tester en local (optionnel)
Lancez la commande Docker suivante pour lancer votre application localement sur votre ordinateur :
L'argument -p 8501:8501 indique que vous souhaitez exécuter une redirection de port depuis le port 8501 de votre machine locale vers le port 8501 du container Docker. Le port 8501 est le port par défaut utilisé par les applications Streamlit.
N'oubliez pas l'argument --user=42420:42420 si vous souhaitez simuler exactement le même comportement que celui qui se produira sur les apps AI Deploy. Il exécute le container Docker en tant qu'utilisateur OVHcloud spécifique (utilisateur 42420:42420).
Une fois démarrée, votre application devrait être disponible sur http://localhost:8501.
Envoyer l'image vers le registre partagé
Le registre partagé ne doit être utilisé qu'à des fins de test. Pensez à créer et à rattacher votre propre registre. Plus d'informations à ce sujet sont disponibles ici. Les images envoyées vers ce registre sont réservées aux workloads AI Tools et ne seront pas accessibles pour des usages externes.
Trouvez l'adresse de votre registre partagé en lançant cette commande :
Connectez-vous au registre partagé avec vos identifiants habituels d'utilisateur AI Platform :
Envoyez l'image compilée vers le registre partagé :
Lancer l'app AI Deploy
La commande suivante démarre une nouvelle app exécutant votre application Streamlit :
--default-http-port 8501 indique que le port à atteindre sur l'URL de l'app est le 8501.
--cpu 1 indique que nous demandons 1 CPU pour cette app.
Pour lancer votre app Streamlit, vous devez attacher 3 volumes à votre app.
Le premier volume contient les fichiers csv issus de la transformation des fichiers son. Au lancement de l'app, cet Object Container ne contient que le fichier data.csv créé à l'étape 4 "Data preprocessing" du notebook.
--volume <my_csv_files>@<region>/:/workspace/csv_files:RW est le premier volume attaché pour stocker les fichiers csv. Ce volume est en lecture/écriture (RW) car de nouveaux fichiers csv seront créés et sauvegardés à chaque envoi d'un nouveau son.
Le second volume contient les fichiers son que vous enverrez directement depuis l'app Streamlit. Au lancement de l'app, cet Object Container est vide. Il se remplira au fur et à mesure de l'envoi des fichiers son.
--volume <my_audio_files>@<region>/:/workspace/audio_files:RW est le second volume attaché pour stocker les fichiers audio. Ce volume est attaché en lecture/écriture (RW) car de nouveaux fichiers audio y seront sauvegardés.
Le troisième conteneur contient le modèle que vous avez entraîné précédemment à l'étape 8 "Save the model for future inference" du notebook.
--volume <my_saved_model>@<region>/:/workspace/saved_model:RO est le troisième volume attaché pour utiliser votre modèle pré-entraîné. Ce volume est en lecture seule (RO) car vous avez seulement besoin d'utiliser le modèle, sans apporter de modifications à cet Object Container.
Si vous souhaitez que votre notebook soit accessible sans avoir besoin de vous authentifier, spécifiez-le comme suit.
Pensez à ajouter l'attribut --unsecure-http si vous souhaitez que votre application soit accessible sans authentification.
Aller plus loin
- Vous pouvez imaginer déployer un modèle d'IA avec un autre outil : Gradio. Reportez-vous à ce tutoriel.
- Une autre façon de créer une app AI Deploy est d'utiliser Flask ! C'est par ici.
Pour une formation ou une assistance technique sur la mise en œuvre de nos solutions, contactez votre commercial ou consultez la page Professional Services pour obtenir un devis et faire analyser votre projet par nos experts.
Votre avis nous intéresse !
N'hésitez pas à nous faire part de vos questions, retours et suggestions pour améliorer le service :
- Sur le serveur Discord OVHcloud