
AI Notebooks - Tutoriel - Analyse de sentiments en utilisant Hugging Face
Comment utiliser les modèles d'Hugging Face pour faire de l'analyse de sentiments sur des tweets
Objectif
L'objectif de ce tutoriel est de montrer comment il est possible d'utiliser les modèles pré-entraînés Hugging Face pour analyser les sentiments sur des Tweets. Hugging Face est une entreprise connue pour créer des logiciels open source tels que Transformers et Datasets, utilisés pour construire des systèmes de NLP. Ce logiciel peut être utilisé pour la classification, la réponse à des questions, la traduction et de nombreuses autres tâches de NLP.
Pourquoi utiliser des modèles existants ?
- Quelqu'un a peut-être déjà rencontré le même problème que vous. Un modèle peut donc déjà exister pour la tâche que vous essayez de résoudre
- Pas assez de données : vous n'avez peut-être pas assez de données pour entraîner un modèle à partir de zéro
- Pas assez de puissance de calcul
- Manque de connaissances dans le domaine
- Gain de temps !
Comment définir le NLP ?
Le Traitement du langage naturel est une branche du Machine Learning qui vise à donner aux programmes informatiques la capacité de comprendre le langage humain naturel.
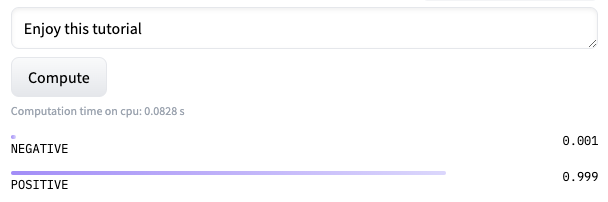
Hugging Face nous permet d'afficher les sentiments des Tweets selon leur sujet.
Pour cela, nous allons comparer 3 modèles sur l'analyse de sentiments de Tweets : 2 modèles d'analyse de sentiments fonctionnant en français et un autre en multilingue.
- Modèle basé sur CamemBERT : pt-tblard-tf-allocine
- Modèle basé sur BARThez : barthez-sentiment-classification
- Modèle basé sur BERT : bert-base-multilingual-uncased-sentiment
Nous utiliserons également un modèle pour classer les Tweets selon leur sujet : un modèle de classification Zero-Shot fonctionnant en français.
- Modèle basé sur CamemBERT : camembert-base-xnli
Prérequis
- Un projet Public Cloud dans votre compte OVHcloud ;
- Un utilisateur Public Cloud disposant des droits pour démarrer des AI Notebooks ;
- Un compte Hugging Face (si vous le souhaitez !).
Accès à l'espace client OVHcloud
- Lien direct :
- Pour accéder à vos services :
Public Cloud> Sélectionnez votre projet >Object Storage
En pratique
Dans ce tutoriel, nous récupérons nos Tweets et constituons notre base de données sous forme de fichier .csv.
Au préalable, si vous souhaitez stocker vos données (Tweets) dans un conteneur d'objets, veuillez suivre l'étape suivante.
Envoyer votre jeu de données sur Public Cloud Storage
Si vous souhaitez l'envoyer depuis l', allez dans la section Object Storage et créez un nouveau conteneur d'objets en cliquant sur Object Storage > Créer un conteneur d'objets.
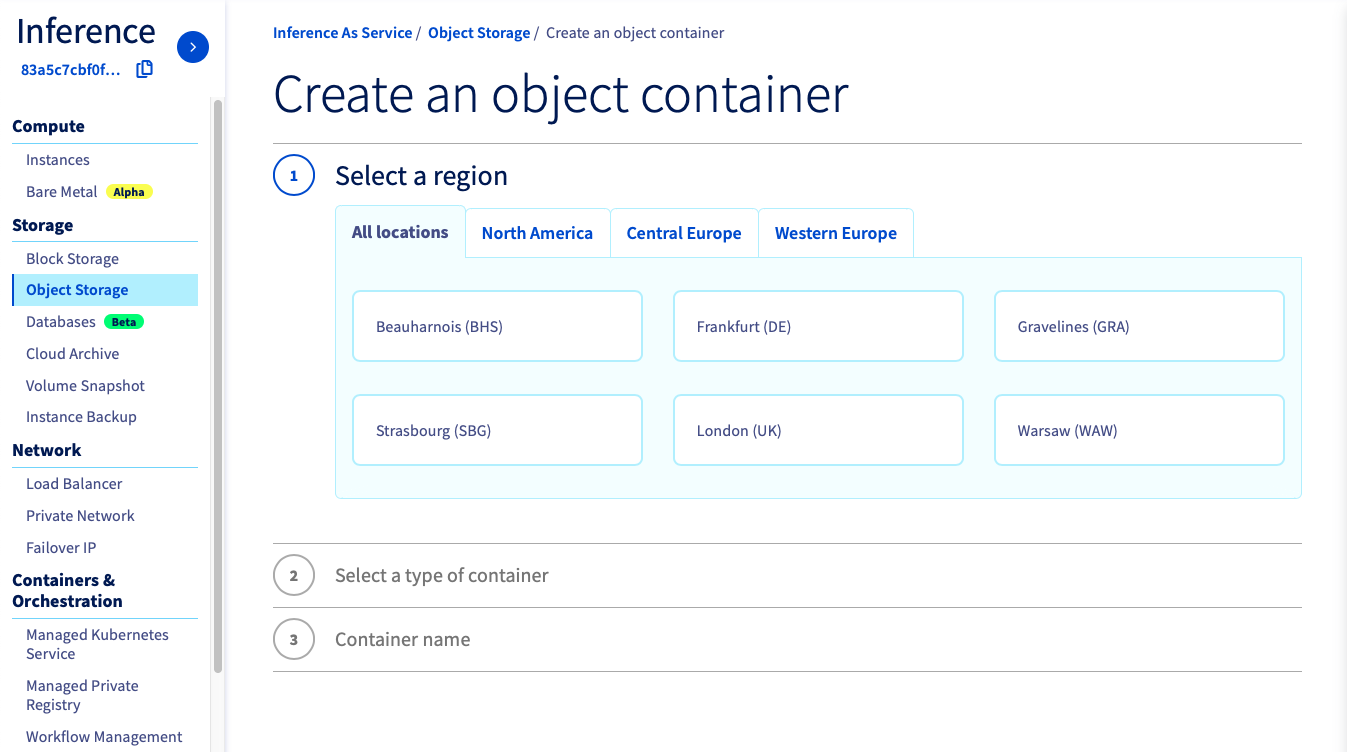
Si vous souhaitez le faire avec la CLI, suivez simplement ce guide. Vous devez choisir la région, le nom de votre conteneur et le chemin où se trouvent vos données, puis utiliser la commande suivante :
Lancer et accéder à un notebook Jupyter
La première étape consistera à créer un notebook Jupyter avec OVHcloud AI Notebooks.
Tout d'abord, vous devez installer la CLI ovhai, puis choisir le nom du notebook (<notebook-name>), l'image Hugging Face (huggingface-transformers) et le nombre de GPU (<nb-gpus>) à utiliser sur votre notebook. Vous pouvez également attacher vos données, préalablement stockées dans l'Object Storage (<container@region/prefix:mount_path:permission>), et utiliser la commande suivante :
Expérimenter l'analyse de sentiments sur des Tweets avec les notebooks d'exemples OVHcloud
Une fois le dépôt cloné, trouvez le(s) notebook(s) de votre choix.
- Notebook pour l'analyse de sentiments avec CamemBERT (pt-tblard-tf-allocine) :
ai-training-examples > notebooks > natural-language-processing > text-classification > hugging-face > sentiment-analysis-twitter > CamemBERT > hugging_face_camembert_sentiment_analysis_tweets.ipynb
- Notebook pour l'analyse de sentiments avec BARThez (barthez-sentiment-classification) :
ai-training-examples > notebooks > natural-language-processing > text-classification > hugging-face > sentiment-analysis-twitter > BARThez > hugging_face_barthez_sentiment_analysis_tweets.ipynb
- Notebook pour l'analyse de sentiments avec BERT (bert-base-multilingual-uncased-sentiment) :
ai-training-examples > notebooks > natural-language-processing > text-classification > hugging-face > sentiment-analysis-twitter > BERT > hugging_face_bert_sentiment_analysis_tweets.ipynb
Les instructions sont directement affichées dans les notebooks. Vous pouvez les exécuter avec le bouton "Play" standard dans l'interface du notebook.
Tester les différents modèles
Test de 3 modèles...
Analyse de sentiments avec pt-tblard-tf-allocine
Théophile Blard, French sentiment analysis with BERT, (2020), dépôt GitHub
Les Tweets sont répartis en 2 classes selon leur sentiment : positif ou négatif.
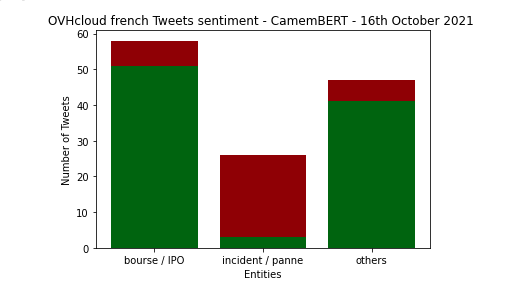
Analyse de sentiments avec barthez-sentiment-classification
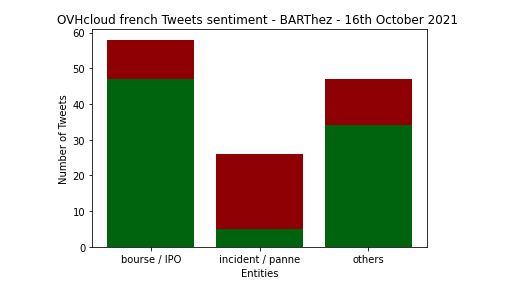
Eddine, Moussa Kamal and Tixier, Antoine J-P and Vazirgiannis, Michalis, BARThez: a Skilled Pretrained French Sequence-to-Sequence Model, (2020), dépôt GitHub
Les Tweets sont répartis en 2 classes selon leur sentiment : positif ou négatif.
Analyse de sentiments avec bert-base-multilingual-uncased-sentiment
Voir NLP Town
Les Tweets sont répartis en 5 classes, de 1 à 5 étoiles, selon leur sentiment : 1 étoile correspond à un tweet très négatif, tandis que 5 étoiles correspondent à un tweet très positif.
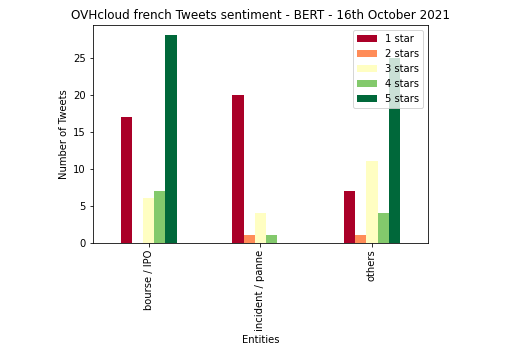
Comparer les performances des modèles
Précédemment, nous avons testé 3 modèles Hugging Face basés sur BARThez, BERT et camemBERT. Deux d'entre eux peuvent être comparés sur notre jeu de données : BARThez et CamemBERT.
Il est possible de traiter nos données manuellement et de comparer nos résultats avec les prédictions des modèles. Nous pourrons ainsi afficher le taux de réussite des modèles pour voir lequel a été le meilleur sur notre jeu de données.
La matrice de confusion nous donnera également des informations sur les faux positifs ou les faux négatifs.
Matrice de confusion - BARThez x sentiments réels
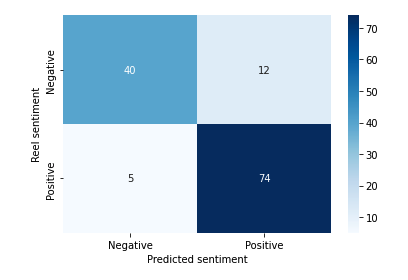
Taux de réussite : 87,02 %
Matrice de confusion - CamemBERT x sentiments réels
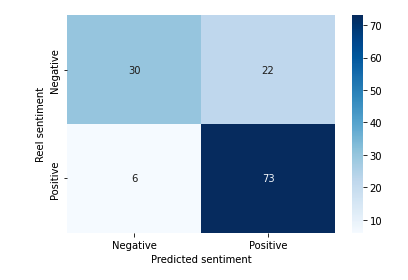
Taux de réussite : 78,63 %
Conclusion
Pour résumer, nous constatons que les résultats de ces modèles pré-entraînés sont satisfaisants. Nous notons que la performance du modèle basé sur BARThez est meilleure sur notre jeu de données que celle du modèle basé sur CamemBERT.
Cependant, cela dépend du jeu de données que vous utilisez.
N'hésitez pas à tester plusieurs modèles !
Expérimenter avec les notebooks
Un aperçu des trois notebooks est disponible sur GitHub ici.
Aller plus loin
- Vous pouvez également déployer une application Flask pour classifier des sentiments de texte avec des modèles Hugging Face. Consultez cette documentation.
- Si vous vous intéressez au NLP (traitement du langage naturel), familiarisez-vous avec la reconnaissance vocale en suivant ce tutoriel.
Pour une formation ou une assistance technique sur la mise en œuvre de nos solutions, contactez votre commercial ou consultez la page Professional Services pour obtenir un devis et faire analyser votre projet par nos experts.
Votre avis nous intéresse !
N’hésitez pas à nous faire part de vos questions, retours et suggestions pour améliorer le service :
- Sur le serveur Discord OVHcloud