
Découvrir la segmentation "Basée sur un attribut d'une table de projet"
Divisez une action en tâches, chacune gérant les valeurs d'un attribut choisi d'une table du Lakehouse Manager
Objectif
Votre action sera divisée en plusieurs tâches, chaque tâche gérant un sous-ensemble de valeurs provenant d'un attribut choisi d'une table donnée du Lakehouse Manager.
Vous trouverez la page de documentation produit dédiée à la segmentation, détaillant le comportement et les spécifications de cette fonctionnalité sur cette page.
Prérequis
Avant d'utiliser ce type de segmentation, certains points doivent être vérifiés.
1. L'attribut var_name est-il indexé dans la table source ?
Si ce n'est pas le cas, la requête d'extraction sera beaucoup plus lente.
2. Y a-t-il suffisamment de CPU sur les bases de données source et destination ?
- Gardez à l'esprit que les opérations
selectetinsertsont gourmandes en CPU. - Par exemple, si votre base de données n'a qu'1 CPU, ce n'est probablement pas une bonne idée de configurer 6 workers pour effectuer des select et des insert simultanément sur l'instance du DBMS...
Règle générale : 1 CPU doit être disponible pour chaque worker s'exécutant simultanément.
3. Évitez de générer trop de tâches dans le même stage.
Pour garantir que le Data Processing Engine (DPE) fonctionne correctement, nous déconseillons d'avoir des stages avec plus de 500 tâches.
Ce n'est pas une limite stricte mais des dégradations de performance peuvent être observées au-delà de 500 tâches. Afin de réduire le nombre de tâches, vous pouvez définir une bucket size plus élevée, de sorte que chaque tâche gère davantage de valeurs (donc moins de tâches au final).
Comment utiliser ce type de segmentation ?
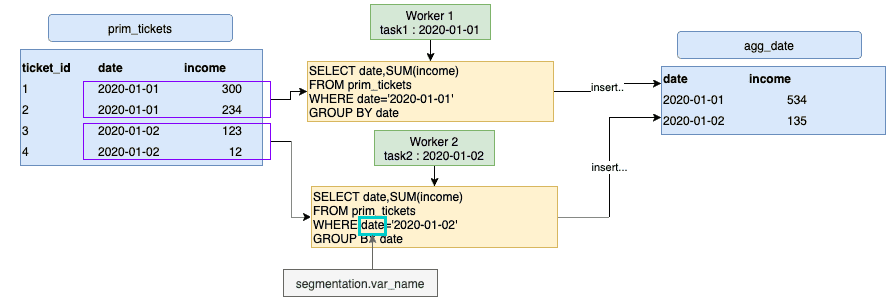
Pour l'exemple, utilisons une action aggregate sur la table prim_ticket suivante, afin d'agréger tous les revenus des tickets par date, et d'insérer le résultat dans la table agg_date.
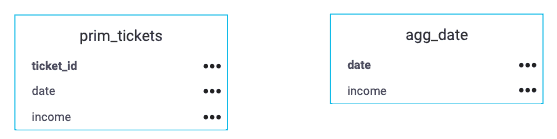
Pour optimiser le temps d'exécution de cette action, la charge de travail sera répartie en plusieurs tâches en fonction de chaque valeur de date.
Comprendre les paramètres avancés
Avant d'aller plus loin, voici comment l'onglet Preferences correspond aux champs JSON en Advanced mode.
Par souci de clarté, nous utiliserons ci-dessous les noms JSON techniques.
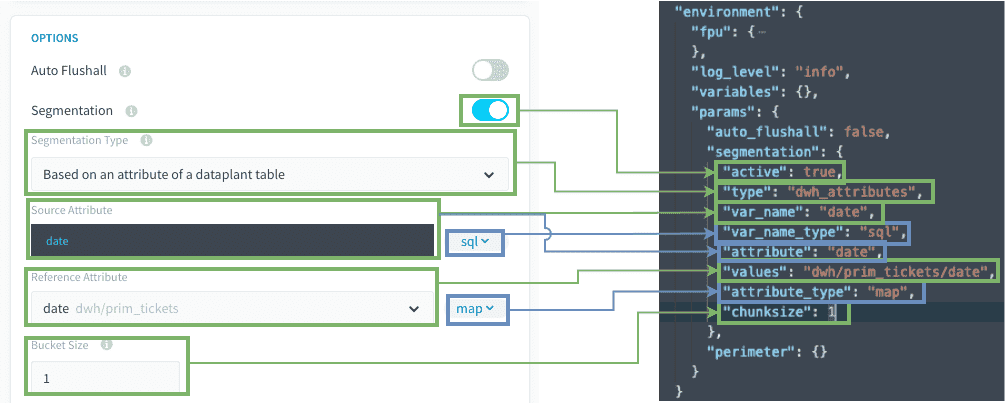
Veuillez noter que les carrés bleus ne sont utilisés que par l'UI pour plus de clarté. Les paramètres verts sont ceux utilisés par le DPE.
Source's attribute / var_name : attribut SQL qui sera utilisé pour le filtrage de la source.
Reference Attribute / Values : l'adresse à partir de laquelle l'ensemble des valeurs est récupéré. doit être formatée comme "dwh/TABLE_NAME/ATTRIBUTE_NAME" si elle provient d'une table de dataset. ou "dwh/SOURCE_NAME/TABLE_NAME/ATTRIBUTE_NAME" si elle provient d'une source.
Bucket size / Chunksize : nombre de valeurs à filtrer pour chaque tâche.
Choisir le bon attribut de segmentation
Choisir le bon attribut pour la segmentation est la clé d'un pipeline de données réussi et rapide. Les caractéristiques d'un bon attribut de segmentation sont :
1. Cardinalité
La cardinalité de l'attribut ne doit pas être trop élevée par rapport au nombre de lignes de la table source.
Vous pouvez vérifier la cardinalité avec une simple requête COUNT DISTINCT dans l'Analytics Manager.
2. Distribution des lignes
Idéalement, la distribution du nombre de lignes pour chaque valeur doit être à peu près égale.
3. Les valeurs ne doivent pas être des textes longs...
...sous peine de surcharger le job controller.
4. Pour les actions aggregate, diff et delete_diff
L'attribut de segmentation doit faire partie de la clé primaire de la table de destination.
Si ce n'est pas le cas, vous obtiendrez éventuellement des données incomplètes pour chaque groupe.
Par exemple, si vous utilisez la segmentation sur ticket_id tout en agrégeant par date, la task1 insérera le premier revenu de ticket, puis la task2 mettra à jour le revenu avec le ticket 2 survenu à la même date...
5. Conseils pour de bons candidats
- L'attribut qui décrit la date de vos faits est souvent un bon candidat :
- il fait souvent partie de la clé primaire de vos tables agrégées
- il peut avoir une cardinalité faible à moyenne
- il peut avoir une assez bonne distribution des lignes dans le temps.
- Les attributs qui font partie de vos principales tables référentielles peuvent également être de bons candidats.
Autres conseils
1. Vous pouvez utiliser des formules SQL
Pour segmentation.values (dans la dernière partie de l'attribut) et pour segmentation.var_name, vous pouvez utiliser des formules SQL, tant qu'elles sont compatibles avec votre DBMS. Veuillez noter que le DBMS peut changer au fil du temps et que vous devrez peut-être revérifier et corriger ces formules SQL si vous décidez de les utiliser.
Par exemple, vous pourriez avoir :
2. La table de segmentation.values peut être différente de la table source
Si votre ensemble de segmentation.values est contenu dans une table différente de votre table source, vous pouvez indiquer une table qui n'est pas la même que la table source utilisée dans l'action.
Cela peut être utile pour restreindre certains éléments et ne pas recalculer toute votre table à chaque fois.
Par exemple, segmentation.values pourrait provenir d'une table référentielle, ou d'une table temporaire, pour ne gérer que les données qui viennent d'arriver.
Comment cela fonctionne-t-il en coulisses ?
Si votre action a une segmentation basée sur un attribut d'une table de projet, lors de l'exécution de l'action, ou de l'action dans un workflow, voici ce qui va s'exécuter :
- Un pre-stage caché récupère toutes les valeurs distinctes du
table/attributeindiqué dans le champsegmentation.values.
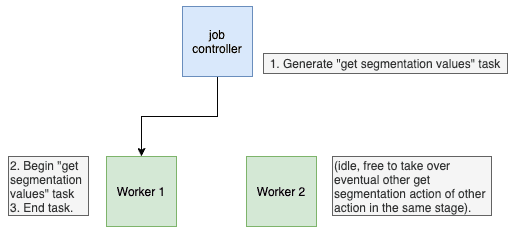
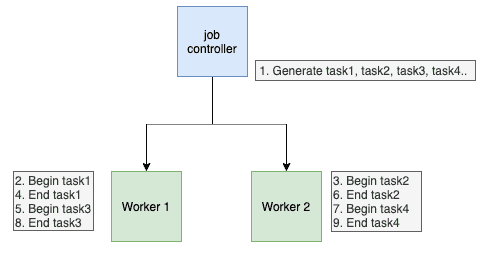
- Le Job Controller divise l'action en plusieurs tâches, chacune avec une valeur différente (ou un ensemble de valeurs, selon la configuration
chunksize) parmi les valeurs trouvées à l'étape 1. - Ensuite, chaque worker exécute chaque tâche une par une.
Cela signifie qu'il n'y a aucun problème à avoir des centaines de tâches, votre action sera parallélisée selon le nombre de workers.
Explications techniques
Revoyons exactement comment chaque partie de la configuration de segmentation est utilisée. Avec la configuration de segmentation suivante :
- La tâche de pre-stage récupère toutes les valeurs
datedistinctes deprim_ticketet remplace l'adressesegmentation.valuespar les valeurs réelles.
Veuillez noter comment l'adressesegmentation.valuesest construite.
Cette adresse peut être différente de latable sourceréellement sélectionnée dans l'action.
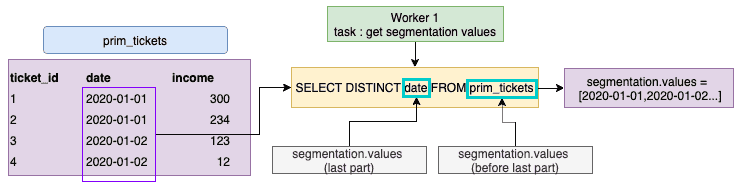
- Le Job Controller crée les tâches en fonction de la longueur de
segmentation.valueset duchunksize(nombre de valeurs que chaque tâche doit gérer) - Chaque worker traite les tâches une par une, voici un exemple avec une action aggregate.
À noter ;
segmentation.var_nameest utilisé comme attribut à filtrer dans la clause WHERE pour la requête d'extraction. Il peut donc être différent de celui utilisé danssegmentation.values.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.