
AI Notebooks - Tutoriel - Analyse et classification audio avec l'IA
Comment classifier des sons avec une IA
Objectif
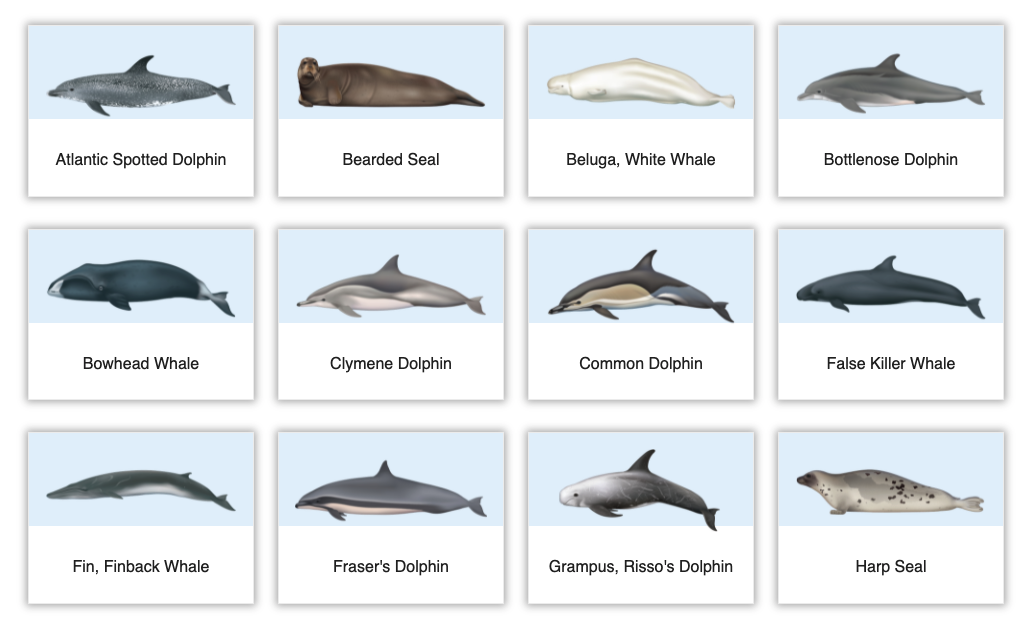
L'objectif de ce tutoriel est de montrer comment il est possible d'entraîner un modèle afin de classifier des sons. Pour cela, nous prenons comme exemple un dataset de sons de mammifères marins.
Prérequis
- Un projet AI Notebooks créé au sein d'un projet Public Cloud dans votre compte OVHcloud
- Un utilisateur pour AI Notebooks
- Deux conteneurs Object Storage pour stocker les données et le modèle
- Votre propre dataset
Accès à l'espace client OVHcloud
- Lien direct :
- Pour accéder à vos services :
Public Cloud> Sélectionnez votre projet >Object Storage
En pratique
Envoyer votre dataset sur Public Cloud Storage
Si vous souhaitez l'envoyer depuis l', rendez-vous dans la section Object Storage et créez un nouveau conteneur d'objets en cliquant sur Object Storage > Créer un conteneur d'objets.
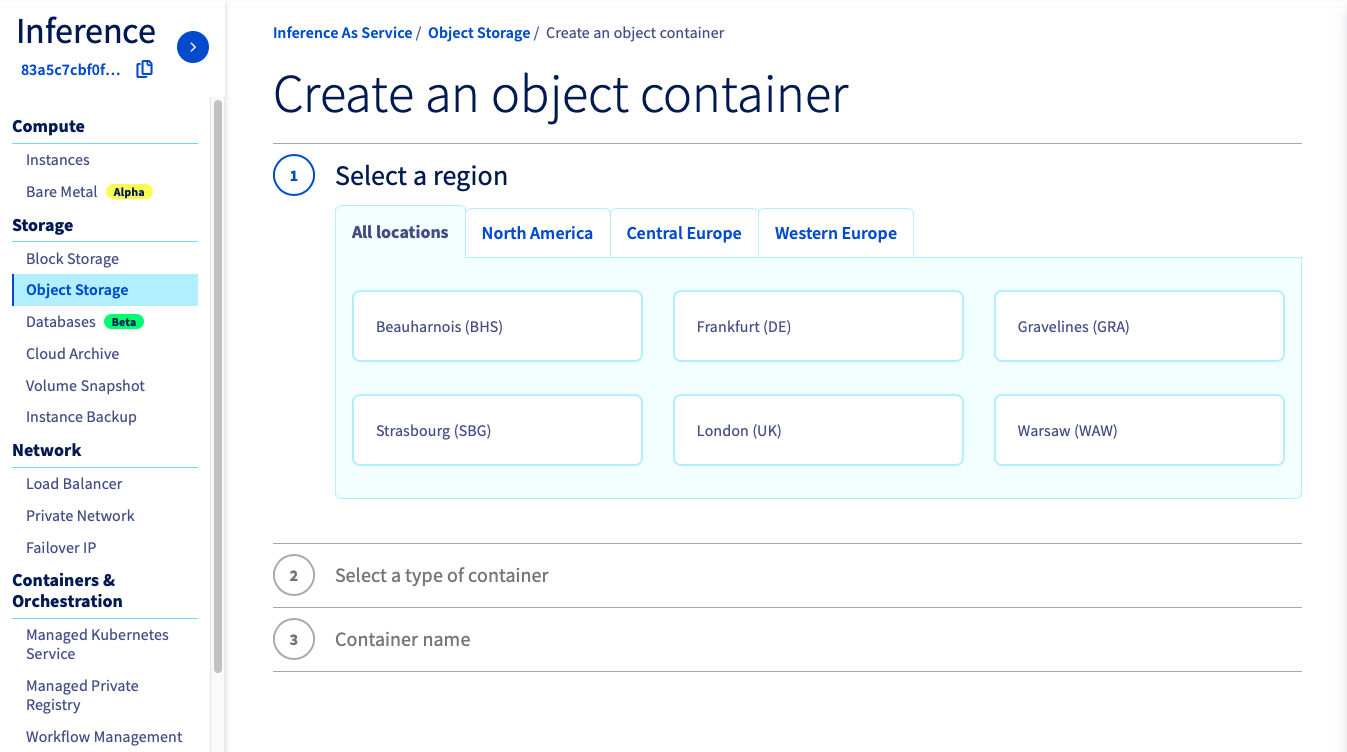
Dans l'espace client OVHcloud, vous pouvez envoyer des fichiers mais pas des dossiers. Par exemple, vous pouvez envoyer un fichier .zip pour optimiser la bande passante, puis le décompresser ultérieurement en y accédant depuis votre JupyterLab. Vous pouvez également utiliser la CLI AI OVHcloud pour envoyer des fichiers et des dossiers (et gagner en stabilité par rapport à votre navigateur).
Si vous souhaitez l'exécuter avec la CLI, suivez simplement ce guide. Vous devez choisir la région, le nom de votre conteneur et le chemin où se trouvent vos données, puis utiliser la commande suivante :
Ce tutoriel a été réalisé avec le Best of Watkins Marine Mammal Sound Database. Si vous ne disposez pas de votre propre dataset, vous pouvez l'utiliser en téléchargeant le dataset sur Kaggle.
Lancer et accéder à un notebook Jupyter avec le framework "One image to rule them all"
Bien que ce tutoriel repose sur l'utilisation de l'image TensorFlow, nous vous conseillons d'utiliser cette image : One image to rule them all. Cela vous évitera des erreurs lors de l'installation de bibliothèques audio Python telles que Librosa ou SoundFile.
Vous devez attacher un volume si vos données se trouvent dans votre Object Storage OVHcloud et que vous souhaitez les utiliser pendant votre expérimentation. Pour plus d'informations sur les données, les volumes et les permissions, consultez notre guide sur les données.
Pour pouvoir utiliser le code source ci-dessous dans cet article, vous devez créer 2 conteneurs Object Storage et un dépôt git montés comme suit :
- nom du point de montage :
/workspace/data, permissions :read & write - nom du point de montage :
/workspace/saved_model, permissions :read & write - nom du point de montage :
/workspace/ai-training-examples, permissions :read & write, URL Git :https://github.com/ovh/ai-training-examples.git
Choisissez la même région que votre conteneur d'objets > Framework "One image to rule them all" > Attachez des conteneurs Object Storage (celui qui contient votre dataset)
Si vous souhaitez le lancer avec la CLI, choisissez le volume que vous souhaitez attacher et le nombre de GPU (<nb-gpus>) à utiliser pour votre notebook, puis utilisez la commande suivante :
Par exemple :
Vous pourrez ensuite accéder à l'URL de votre notebook une fois qu'il est en cours d'exécution.
Trouvez le notebook en suivant ce chemin : ai-training-examples > notebooks > audio > audio-classification > notebook-marine-sound-classification.ipynb.
Expérimenter avec le notebook de classification de sons
Une fois votre dataset prêt et envoyé, vous êtes en mesure d'entraîner le modèle !
Un aperçu de ce notebook est disponible sur GitHub ici.
Aller plus loin
- Si vous souhaitez entraîner votre modèle, consultez ce tutoriel AI Training.
- Si vous souhaitez déployer une app Streamlit afin de classifier des sons de mammifères marins à l'aide de votre modèle, consultez ce notebook.
- Vous pouvez également comparer deux méthodes pour la tâche de classification audio en suivant ce tutoriel.
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Votre avis nous intéresse !
N’hésitez pas à nous faire part de vos questions, retours et suggestions pour améliorer le service :
- Sur le serveur Discord OVHcloud