
Déployer des workloads IA sur une instance 8x NVIDIA H200 NVL
Découvrez comment déployer des workloads IA sur une instance GPU 8x NVIDIA H200 NVL en tenant compte de sa topologie NVLink
Objectif
Nous vous recommandons de suivre ce guide si vous disposez d'une instance h200-1920-eph ou h200-1920. Les instances 8x NVIDIA H200 NVL (modèles h200-1920 et h200-1920-eph) sont organisées en deux groupes de 4 GPU, avec une connectivité NVLink uniquement au sein de chaque groupe et une liaison PCIe entre les deux groupes. Tenir compte de cette topologie vous permet d'obtenir les meilleures performances et une stabilité optimale pour vos workloads IA.
Actuellement, les instances 8x NVIDIA H200 NVL sont uniquement disponibles dans la région de Paris (EU-WEST-PAR).
Ce guide vous explique comment déployer et exploiter des workloads IA sur une instance GPU 8x NVIDIA H200 NVL
Prérequis
- Disposer d'un projet Public Cloud avec accès à la région où les modèles d'instance h200-1920 et h200-1920-eph sont disponibles (EU-WEST-PAR).
- Disposer d'une clé SSH créée pour déployer une instance GPU Linux.
Accès à l'espace client OVHcloud
- Lien direct :
- Pour accéder à vos services :
Public Cloud> Sélectionnez votre projet >Instances
En pratique
Vous trouverez ci-dessous les informations nécessaires pour déployer une instance 8x NVIDIA H200 NVL, comprendre sa topologie, puis y exécuter et surveiller vos workloads IA.
Déployer l'instance
Dans la section Accès rapide, cliquez sur Créer une instance. Sélectionnez ensuite la région EU-WEST-PAR et choisissez le modèle d'instance h200-1920 ou h200-1920-eph dans la catégorie Cloud GPU.
Suivez ensuite les étapes restantes, comme détaillé dans le guide « Comment créer une instance Public Cloud et s'y connecter ». Ce processus peut prendre quelques minutes.
Une fois l'instance livrée, installez le driver NVIDIA comme indiqué dans le guide « Déployer une instance GPU ».
Présentation du matériel
Disque éphémère (h200-1920-eph)
Le disque éphémère du modèle d'instance h200-1920-eph est déjà formaté avec un système de fichiers Ext4. Il peut déjà être monté automatiquement sous /mnt par cloud-init.
Pour vérifier si le disque éphémère est monté, exécutez la commande suivante :
Si le disque de 20 To affiche /mnt comme point de montage, il est prêt à l'emploi. Sinon, montez-le manuellement en remplaçant /dev/<device> par le nom du périphérique affiché par lsblk -f :
Les données stockées sur le disque éphémère ne sont pas incluses dans les sauvegardes d'instance et sont perdues lorsque l'instance est supprimée ou suspendue (shelved). Nous vous recommandons de sauvegarder vos données importantes sur une solution de stockage externe, telle que l'Object Storage.
Topologie GPU et architecture NVLink
Les 8 GPU sont organisés comme suit :
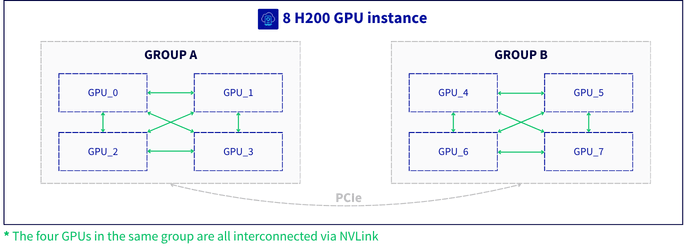
Pour répartir vos workloads sur cette instance, nous vous recommandons de :
- exécuter, dans la mesure du possible, chaque job au sein d'un seul groupe NVLink (4 GPU).
- traiter les deux groupes comme deux clusters distincts lorsqu'un même modèle nécessite les 8 GPU : conserver les parallélismes les plus gourmands en communications (comme le tensor parallelism) au sein de chaque groupe, et n'utiliser entre les deux groupes que des modes de communication plus légers (comme le pipeline parallelism). Un exemple est présenté dans les configurations recommandées ci-dessous.
- garder à l'esprit que les gains de performance du NVLink ne s'appliquent qu'au sein de chaque groupe de 4 GPU.
Conserver les opérations gourmandes en communications au sein de chaque groupe NVLink évite un trafic important sur le bus PCIe, ce qui garantit à la fois de meilleures performances et une meilleure stabilité.
Avant de lancer un workload, nous vous recommandons de vérifier quels GPU appartiennent à quel groupe NVLink :
Dans la matrice affichée, les GPU reliés par NVLink présentent une valeur NV# entre eux (# correspondant au nombre de liens NVLink). Les GPU reliés uniquement en PCIe affichent à la place un type de chemin PCIe (par exemple PHB, NODE ou SYS). Les 4 GPU présentant des valeurs NV# entre eux forment un groupe NVLink.
Vous pouvez également afficher l'état des liens NVLink d'un GPU donné (ici le GPU 0) :
Configurations recommandées
Les exemples ci-dessous utilisent vLLM pour illustrer le déploiement d'un modèle sur 4 ou 8 GPU dans le respect de la topologie NVLink.
Pour déployer sur 4 GPU, indiquez explicitement les identifiants des périphériques à utiliser, afin de vous assurer qu'ils appartiennent tous au même groupe NVLink :
Bonnes pratiques d'exploitation
Nous vous recommandons de :
- vérifier la correspondance entre les GPU et les groupes NVLink avant de lancer un workload (
nvidia-smi topo -m). - conserver tous les GPU utilisés par un même job au sein du même groupe NVLink, sauf si vous utilisez une configuration inter-groupes comme celle en pipeline parallelism décrite ci-dessus.
- surveiller l'état du NVLink et les logs du noyau (
dmesg) pendant l'exécution de vos workloads. - sauvegarder régulièrement vos données importantes.
Monitoring recommandé
Nous vous recommandons de surveiller les métriques suivantes pendant l'exécution de vos workloads :
Le driver NVIDIA signale les erreurs GPU et NVLink dans les logs du noyau sous forme de messages Xid. Pour un monitoring en continu, NVIDIA DCGM permet d'exporter ces métriques vers votre outil de monitoring. Les commandes smartctl et nvme sont fournies par les paquets smartmontools et nvme-cli (par exemple sudo apt-get install smartmontools nvme-cli sous Debian ou Ubuntu).
Aller plus loin
Échangez avec notre communauté d'utilisateurs.