
Configurer les imports et transformations de données
Le Data Processing Engine (DPE) est le composant qui vous permet de créer et d'exécuter des pipelines de données en dehors et au sein de la Platform
Objectif
Le Data Processing Engine (DPE) est le composant qui vous permet de créer et exécuter des pipelines de données en dehors et au sein de la Platform. Tout est automatisé, de la gestion et du déploiement à la scalabilité, pour vous permettre de vous concentrer sur la logique métier de votre Projet de données plutôt que sur sa logistique.
Alors que le Lakehouse Manager est l'endroit où vous planifiez votre structure de données au niveau conceptuel, le Data Processing Engine est l'endroit où vous exécutez des actions pour impacter physiquement vos données.
Ce tutoriel est destiné aux Standard Datasets utilisant le Lakehouse Manager Engine. Pour savoir comment suivre cette même étape avec des External Datasets, cliquez ici.
Actions
Une action consiste en une opération physique unitaire sur les données. Les actions peuvent être organisées en Stages afin de produire des pipelines de traitement de données automatisés appelés workflows.
Cliquez sur le menu Actions de votre Data Processing Engine. Vous devriez voir les deux actions Load qui ont été automatiquement générées à l'étape précédente :
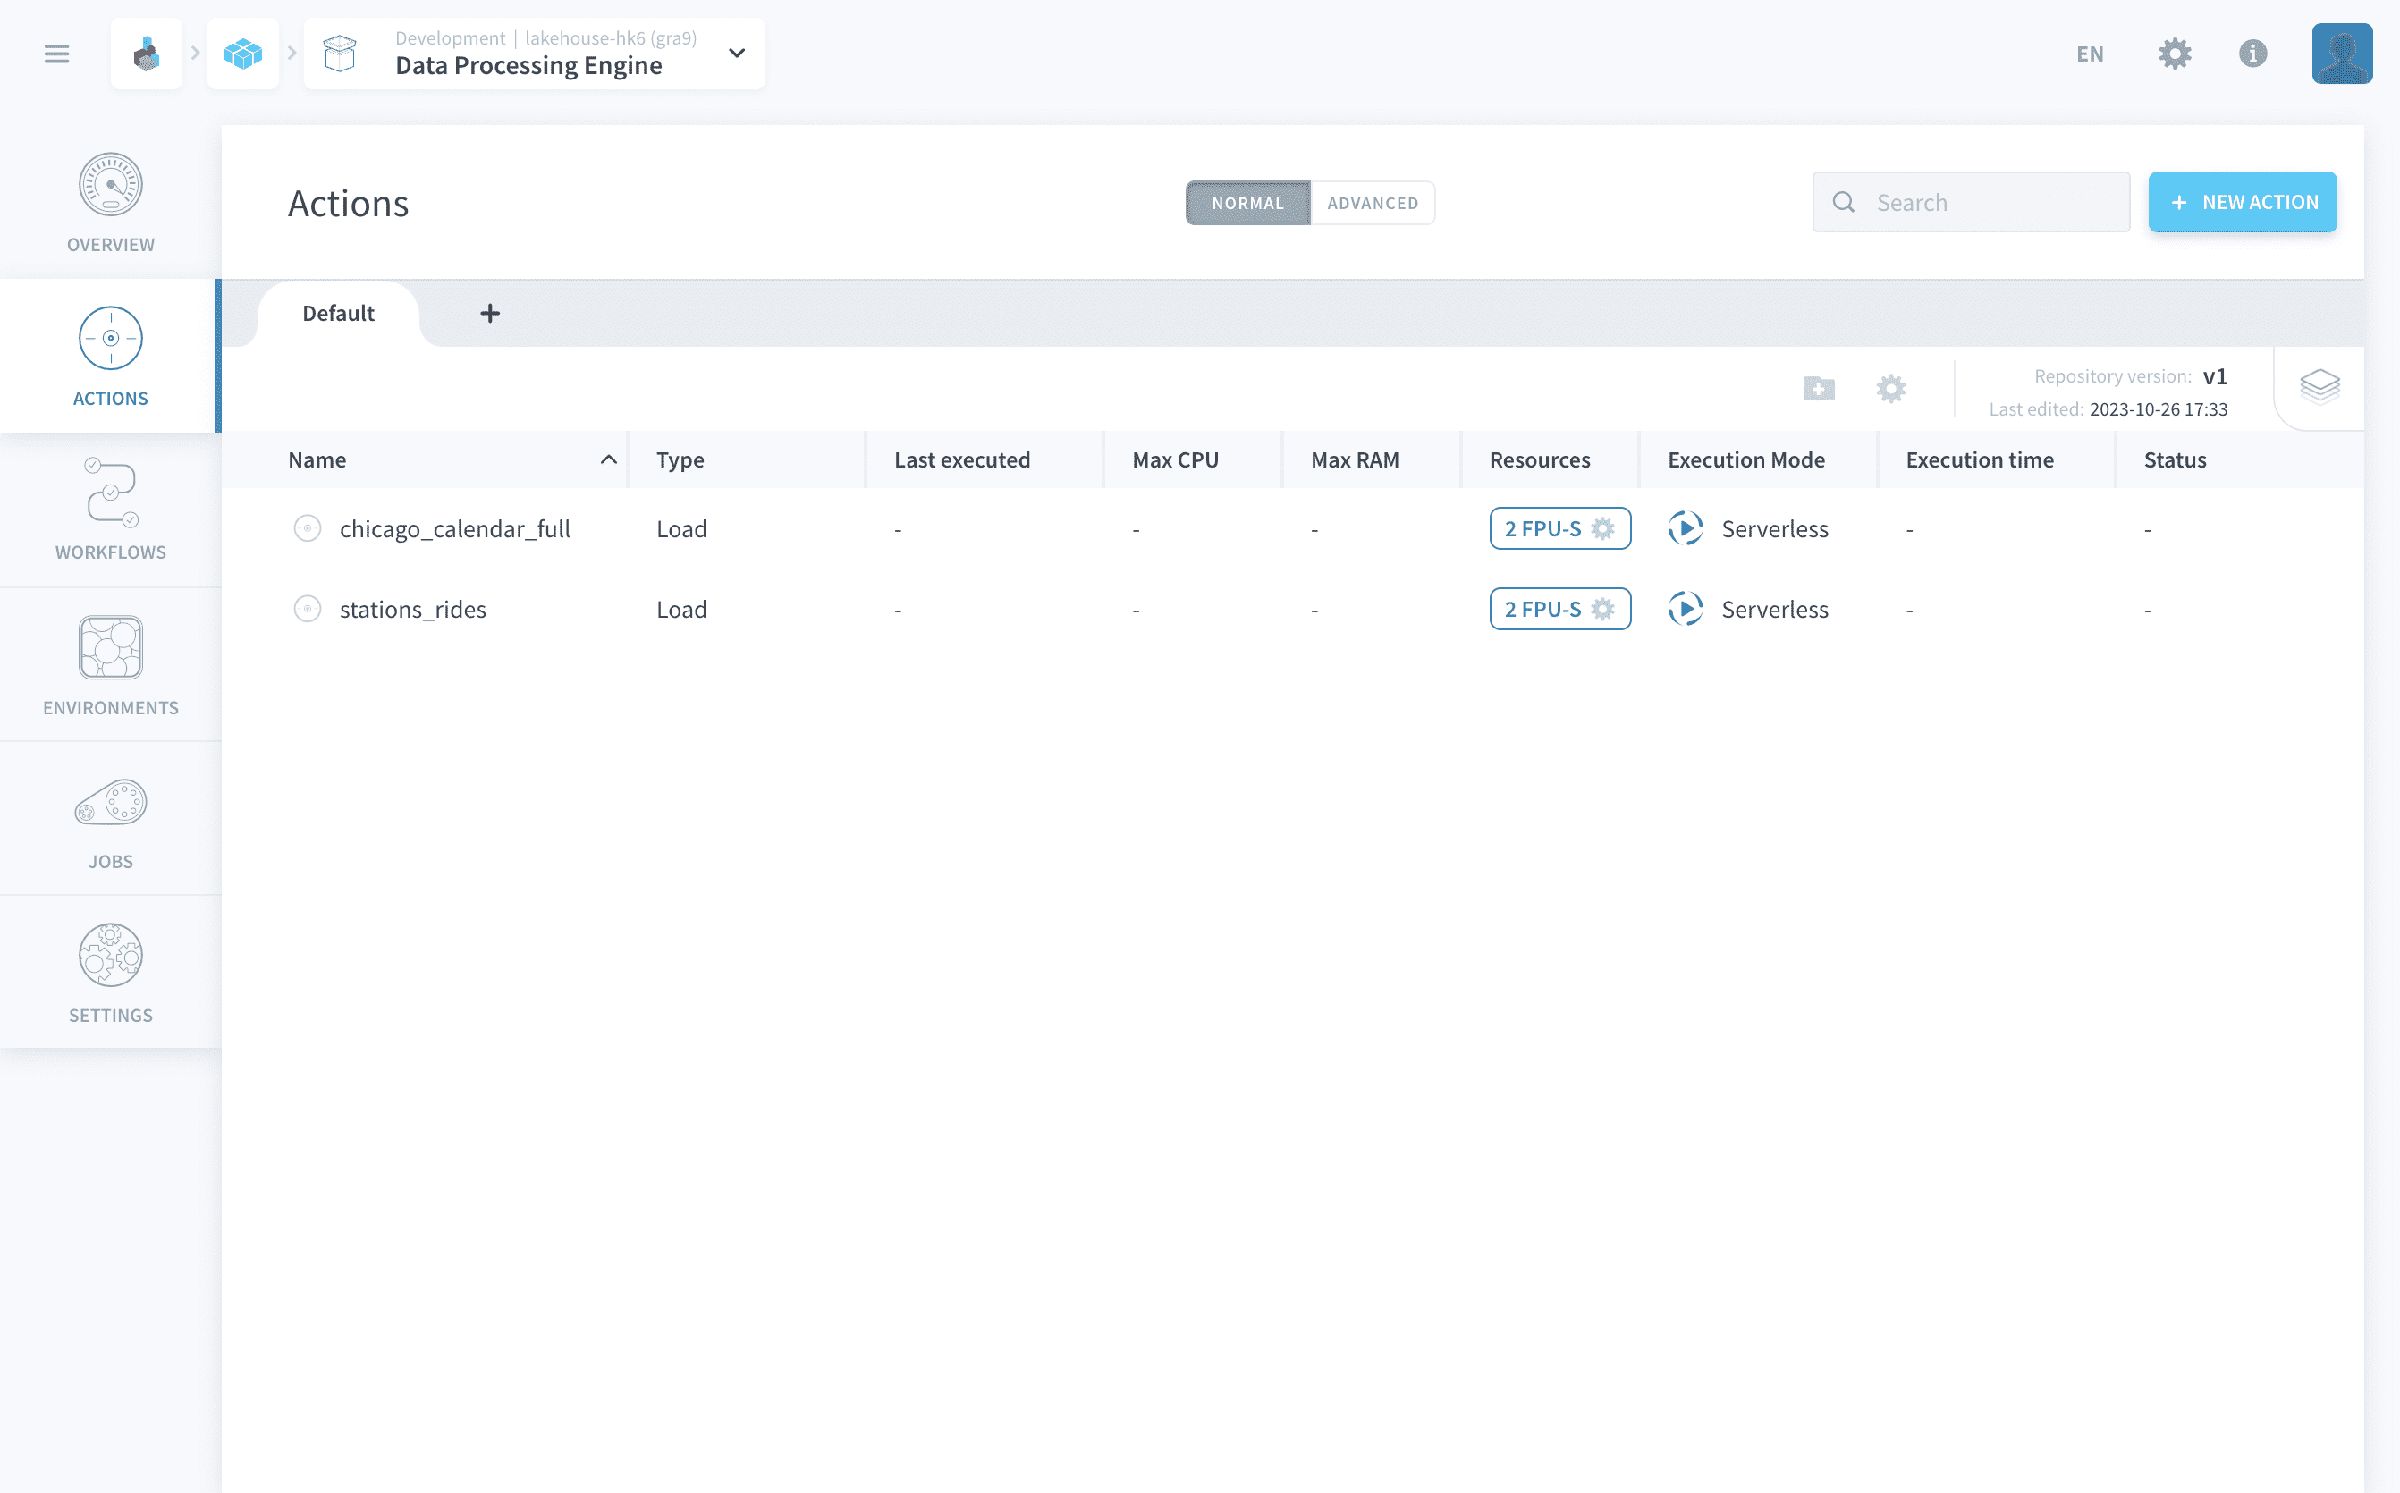
Ces actions Load vont physiquement extraire les données de vos sources et les charger dans votre entrepôt de données, en suivant le schéma réalisé dans le Lakehouse Manager.
Créer d'autres actions
Notre Marketplace vous donne accès à une douzaine d'actions sélectionnées pour démarrer rapidement vos Projets de traitement de données : actions load, actions aggregate, actions delete, etc. Si vous ne trouvez pas ce dont vous avez besoin dans le catalogue, vous pouvez toujours recourir à une action custom qui vous permet d'exécuter n'importe quel morceau de code Python 3+ au sein de vos pipelines de données.
En savoir plus sur les actions Custom.
Pour ce tutoriel, vous allez créer une action utilisée pour agréger vos données dans la table dataset_history que vous avez créée dans la partie précédente.
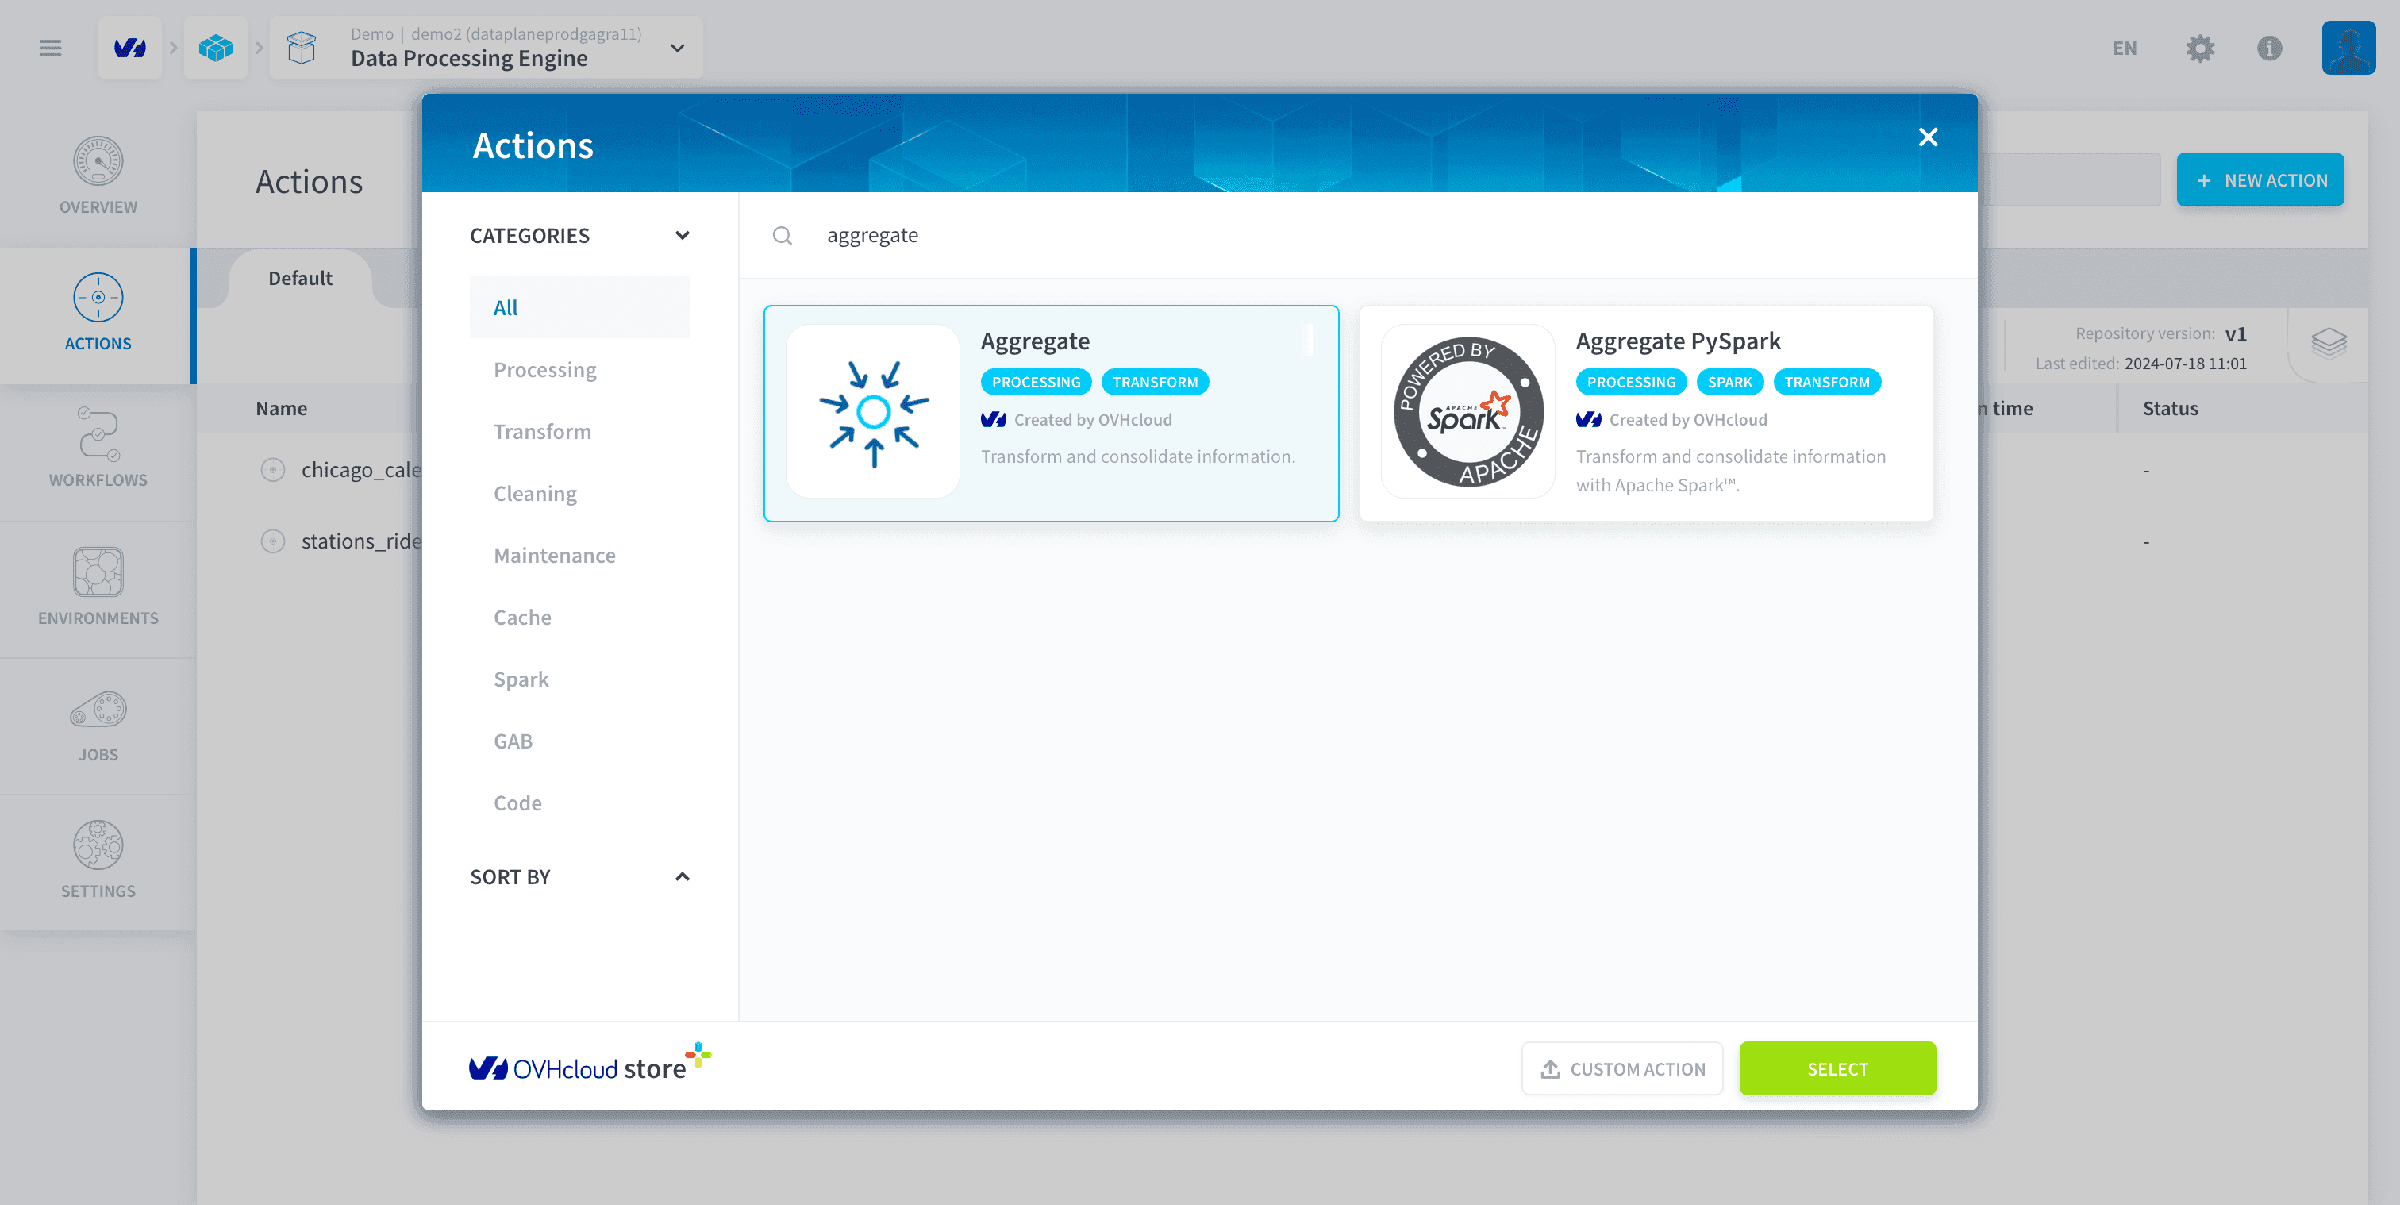
Cliquez sur New action et sélectionnez le modèle Aggregate action depuis le Store.
Il y aura 3 étapes simples pour configurer l'action Aggregate :
- (1) Sélectionner la table source : stations_rides
- (2) Sélectionner la table de destination : dataset_history
- (3) Sélectionner la table source : chicago_calendar_full
Changez la condition de jointure en un INNER join à l'aide du menu déroulant. Cela garantira que vous n'avez aucun champ null dans les enregistrements de votre table dataset_history. Assurez-vous également de copier-coller le code sql suivant pour indiquer à l'action aggregate comment les tables vont être liées :
Notez que ceci est nécessaire car le concept de jointure de tables à l'aide de clés primaires n'existe pas pour les Standard Datasets. Si vous utilisez un External Dataset, il sera généré automatiquement.
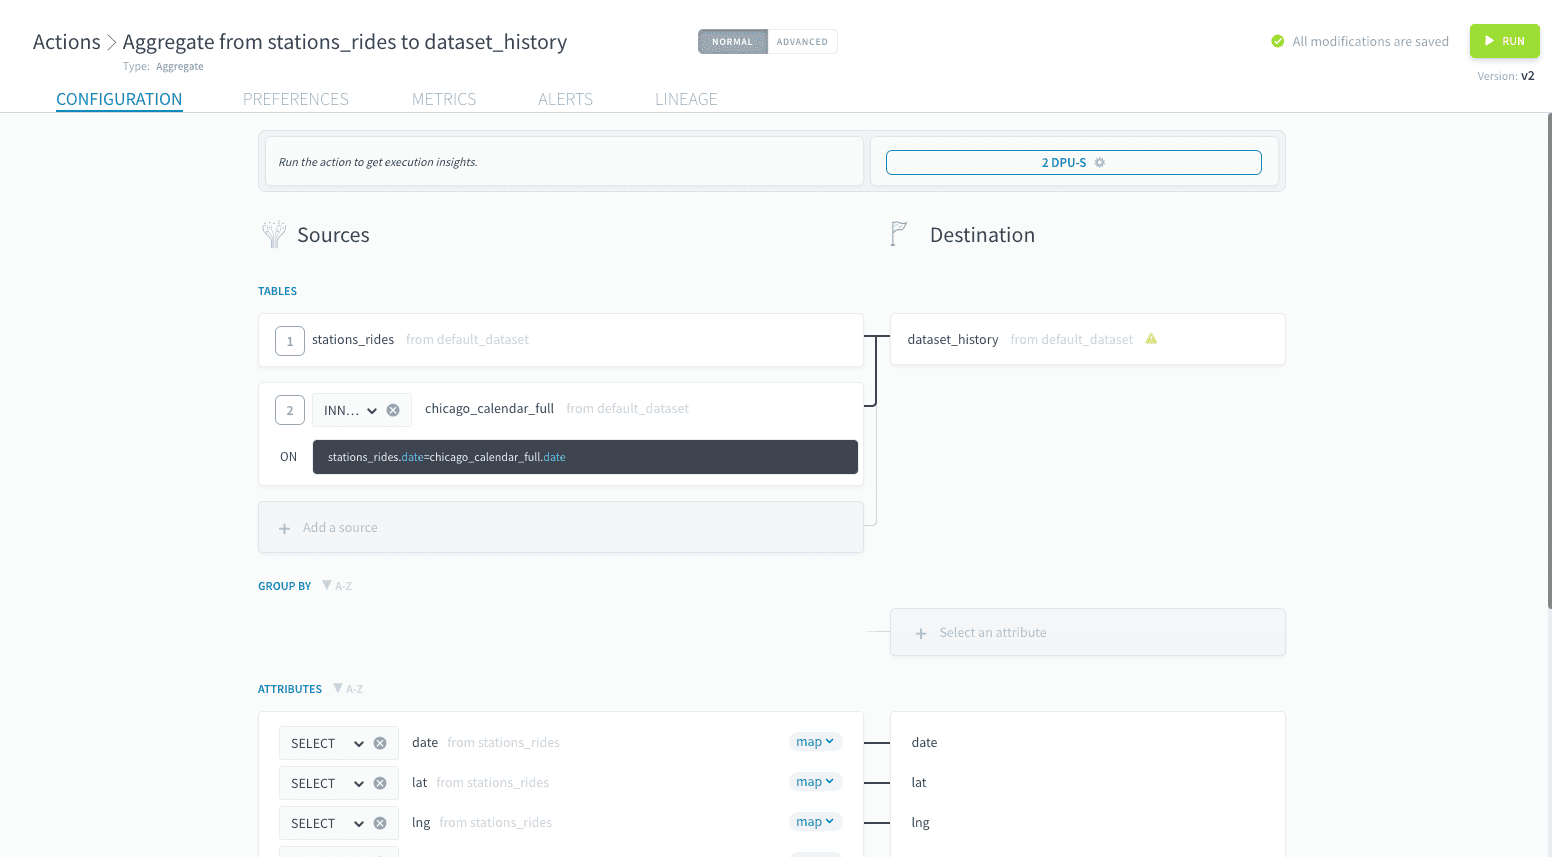
Les attributs doivent être mappés manuellement. Reportez-vous à la capture d'écran ci-dessous et assurez-vous que tous les attributs sont correctement mappés. Assurez-vous que tous les attributs sont dans la fonction SELECT.
Si vous utilisez un External Dataset, alors les attributs seront automatiquement mappés. Seul l'attribut rides doit être basculé sur SUM.
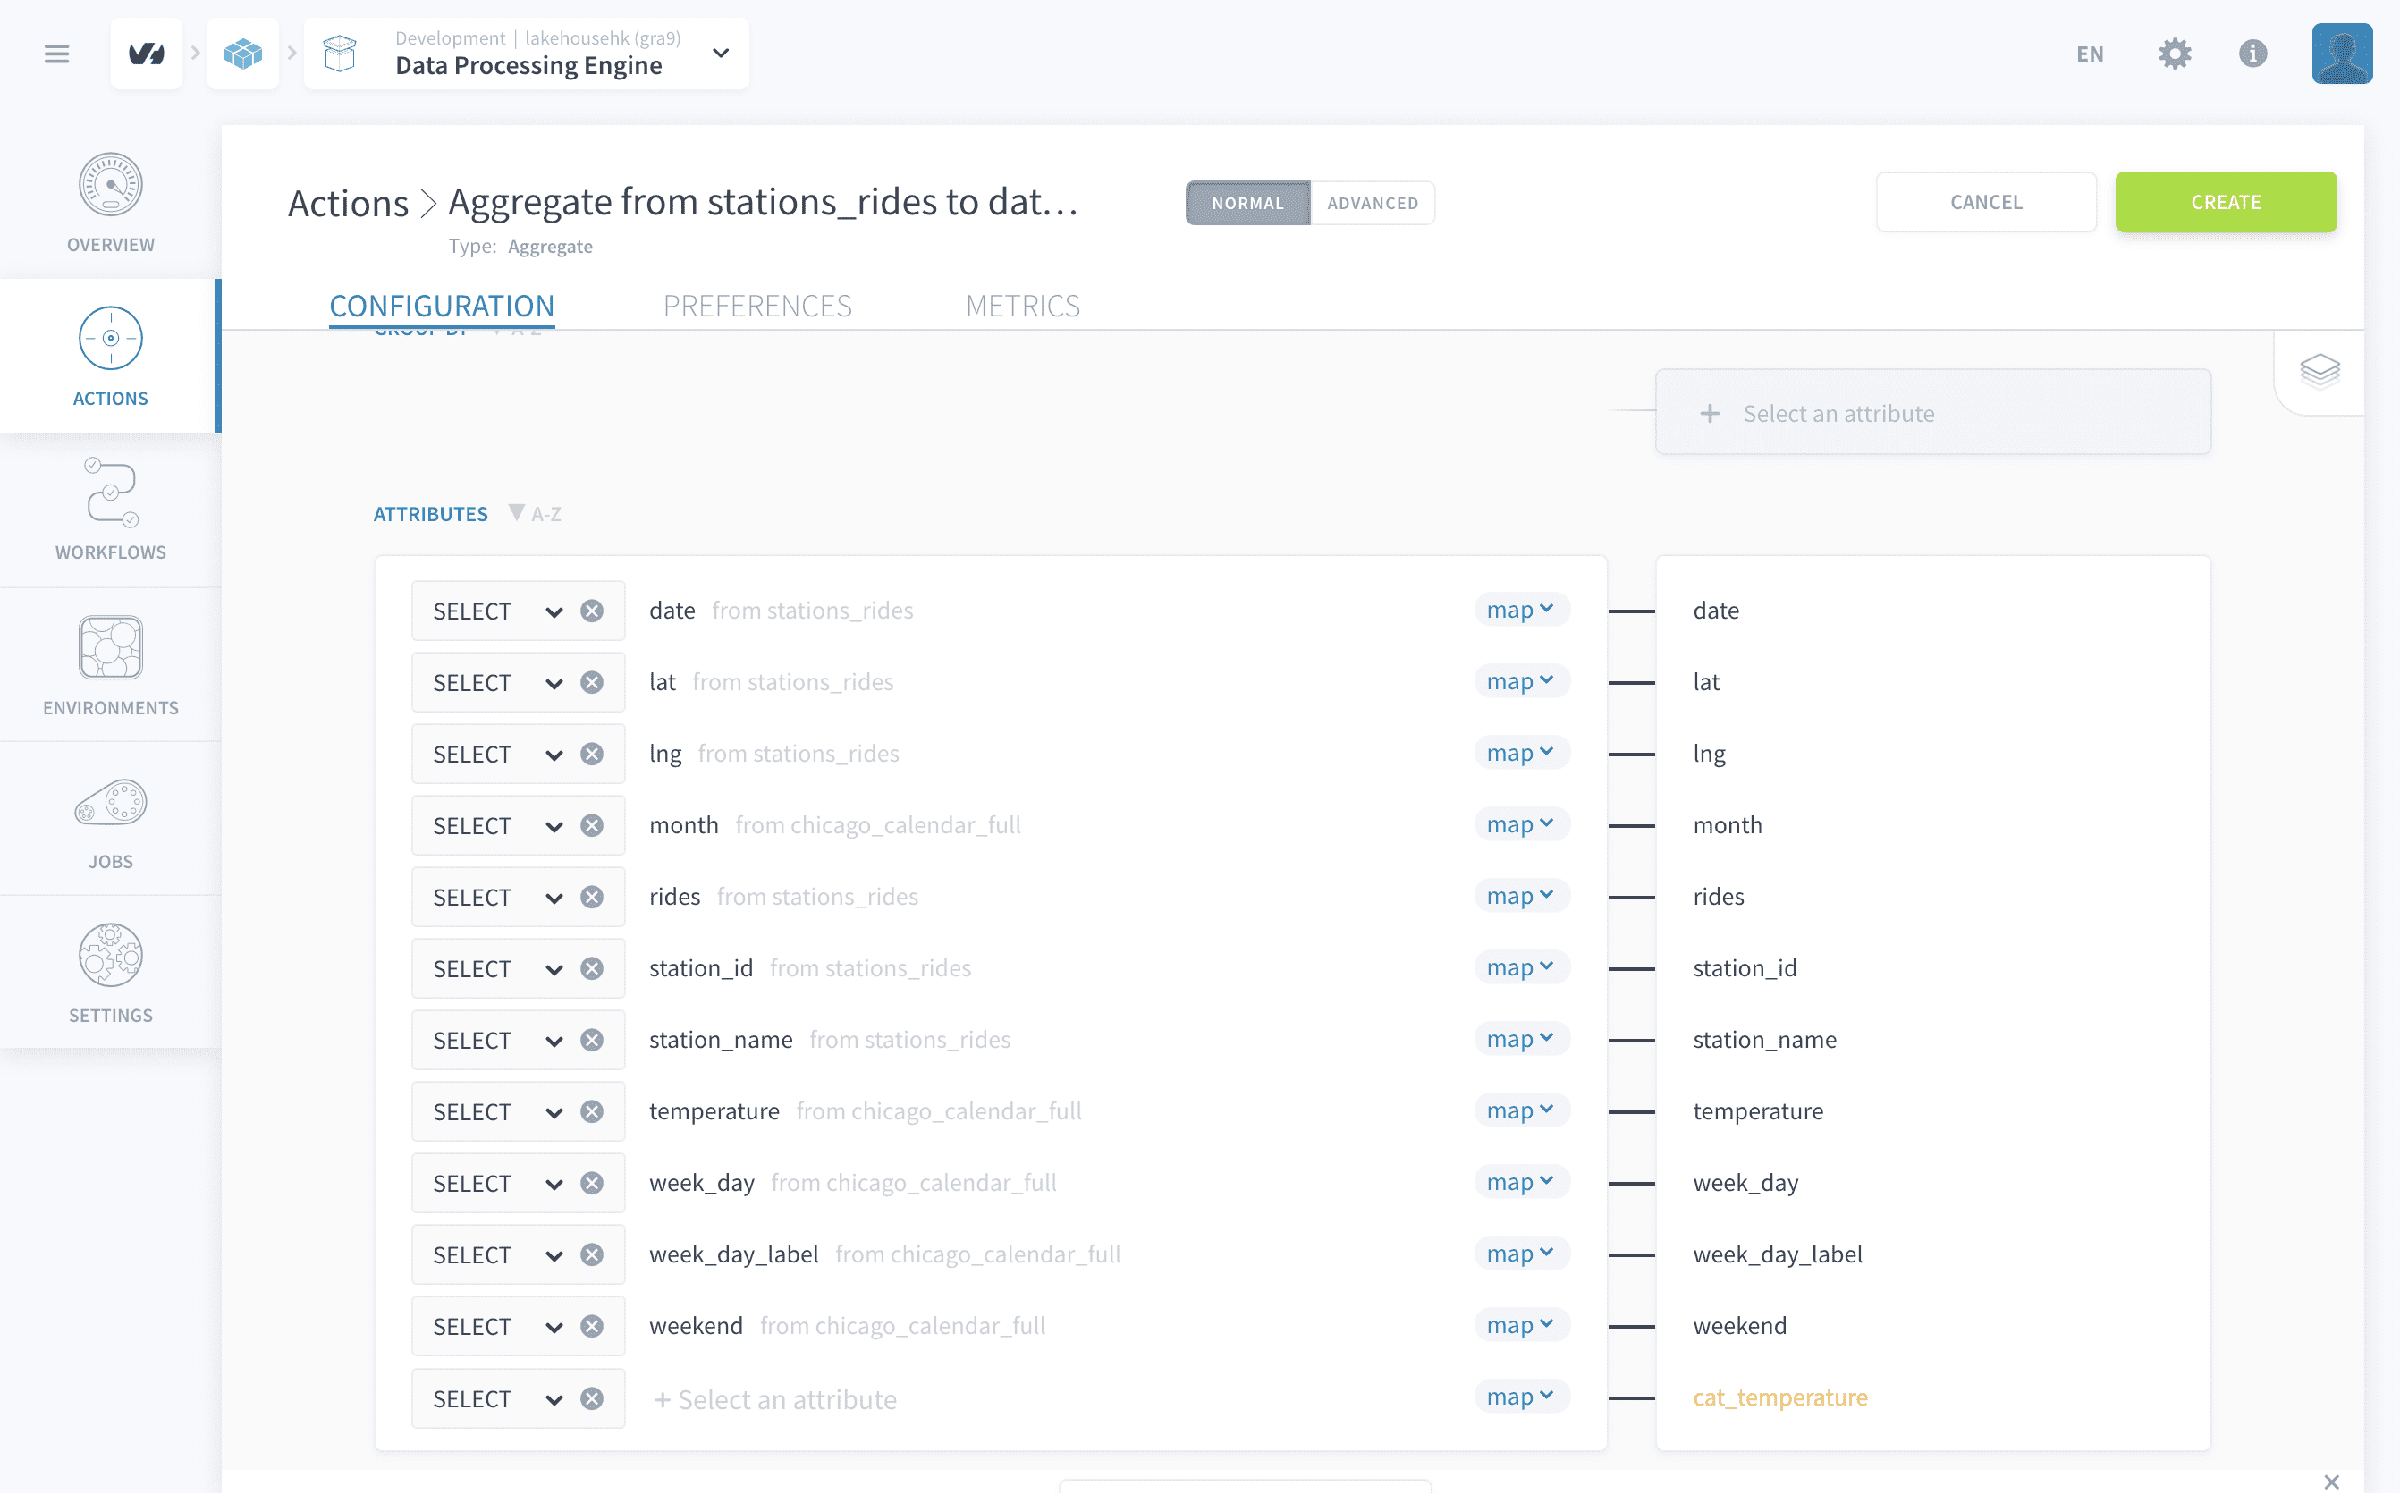
Enfin, définissons l'attribut catégoriel cat_temperature que vous avez créé précédemment. Cliquez sur l'option < map > (abréviation de "mapping") dans le menu déroulant bleu comme indiqué ci-dessous et basculez-le sur < sql >.
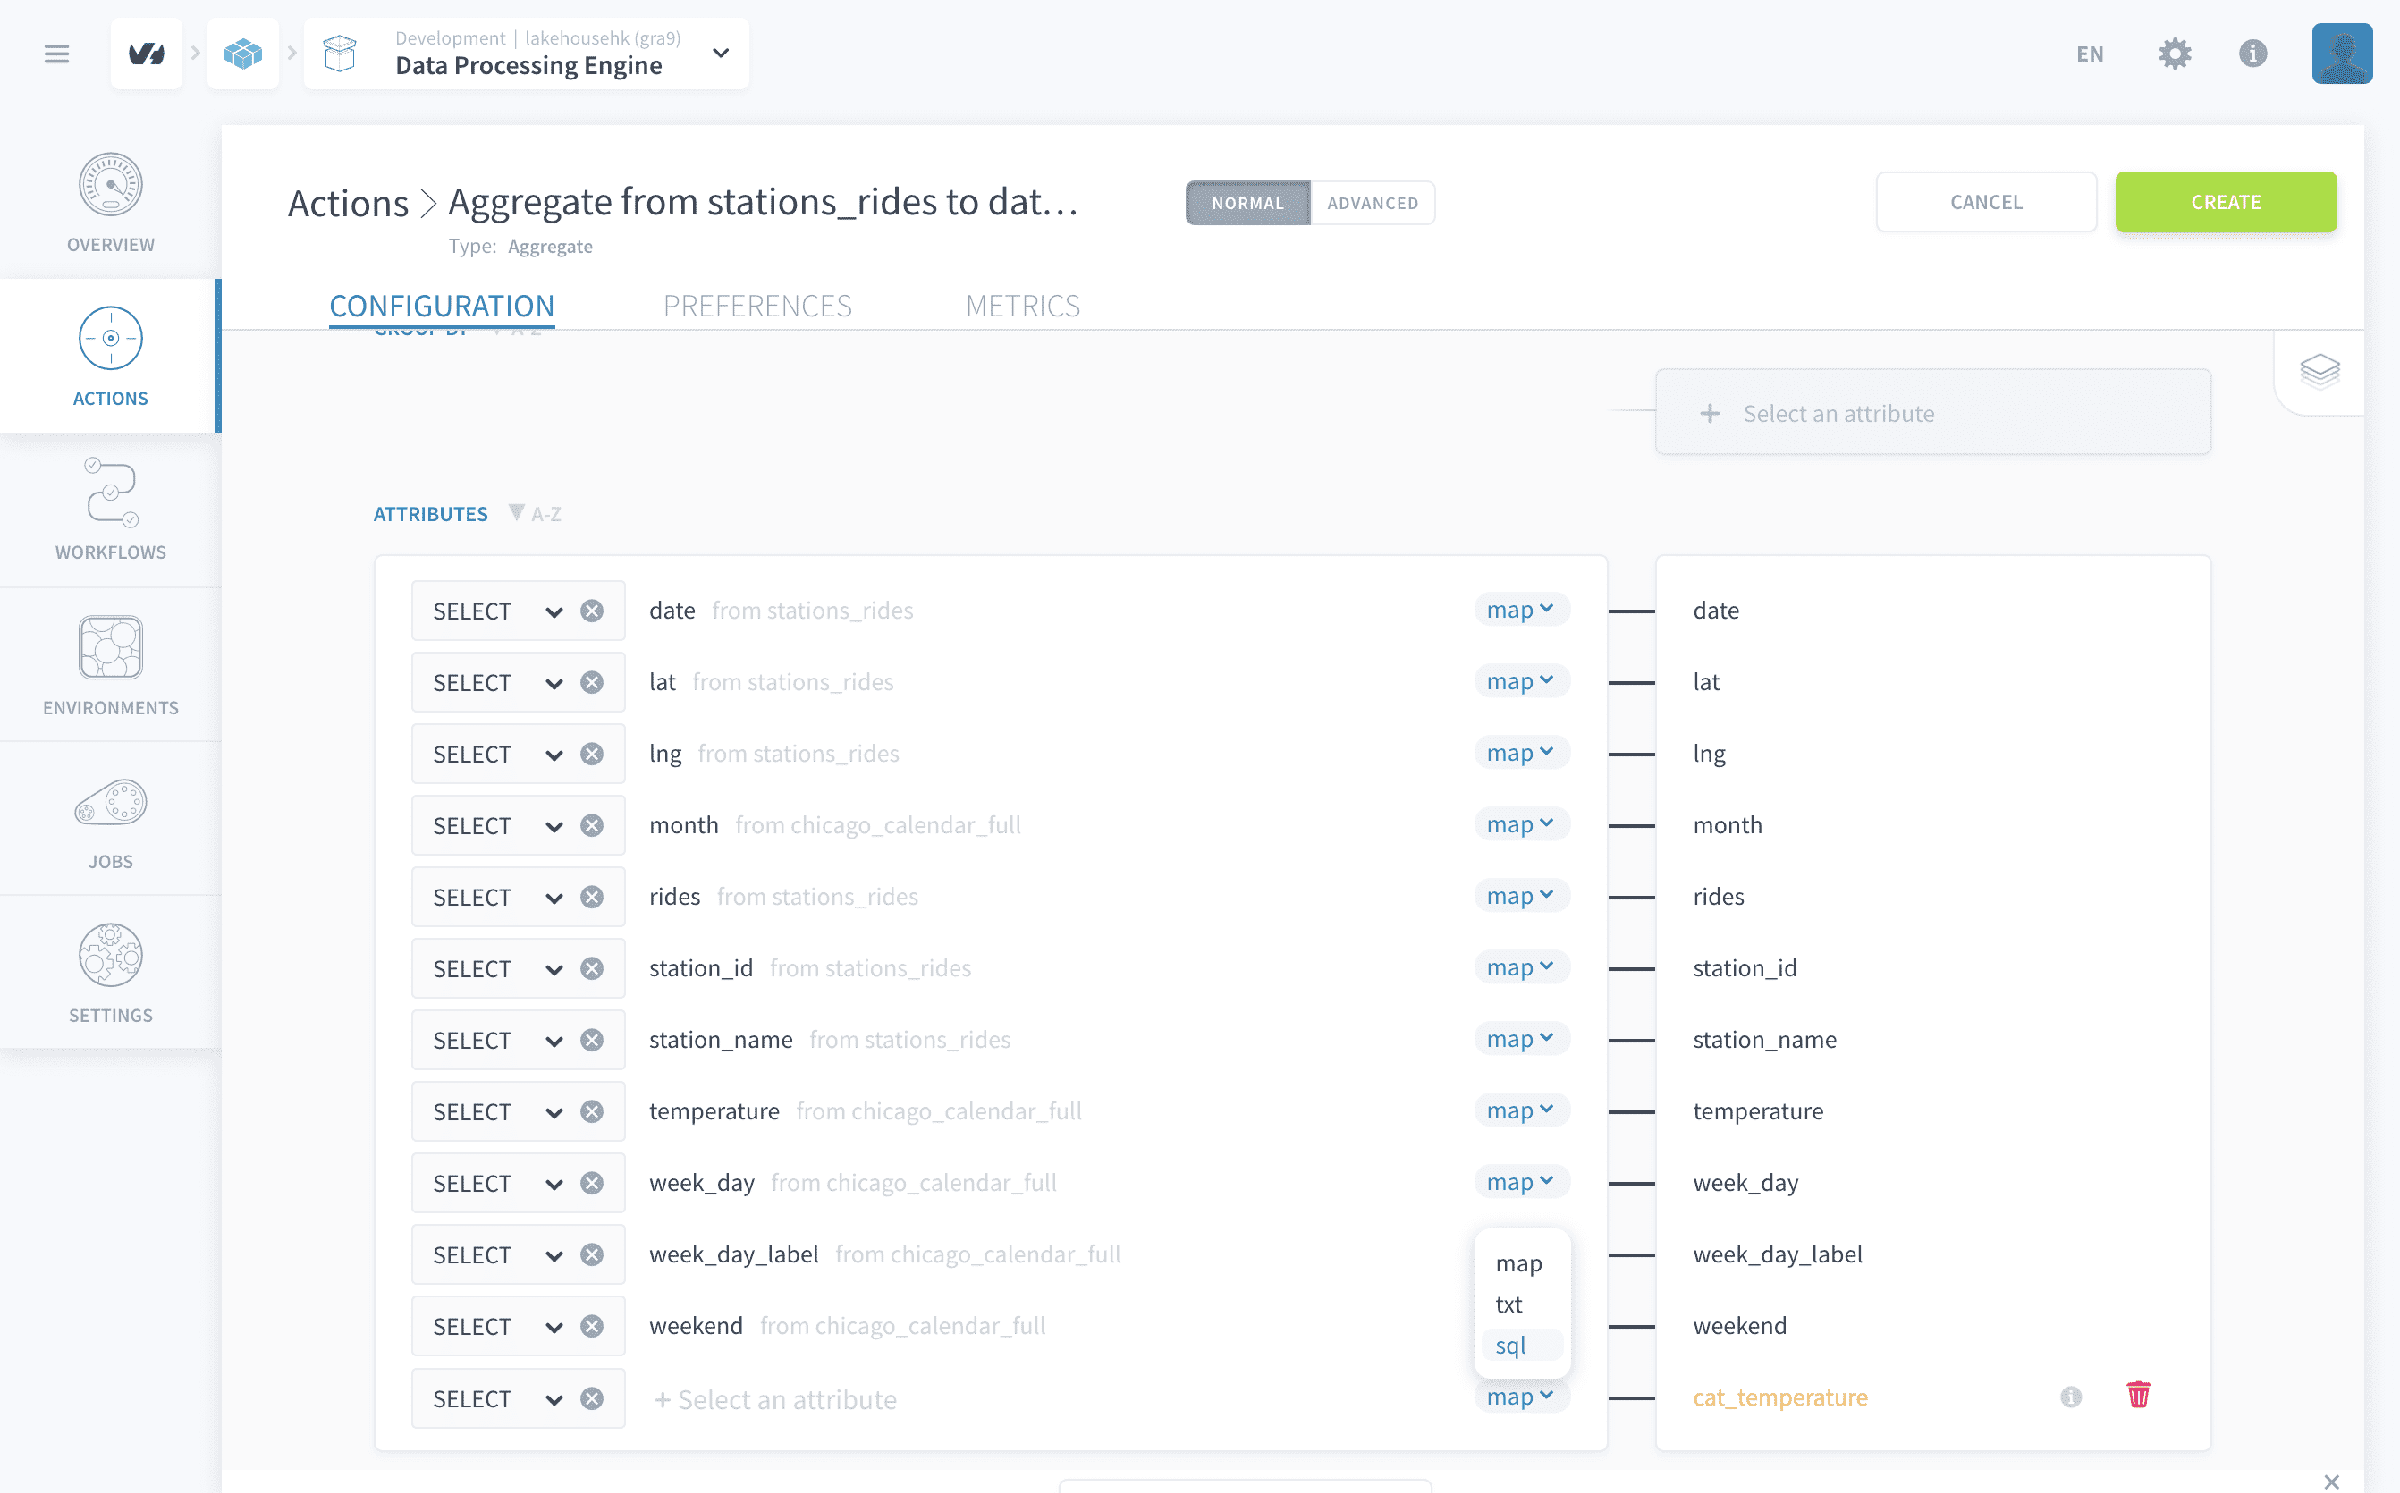
Copiez-collez simplement la commande SQL ci-dessous :
Laisser un attribut de destination non mappé dans la configuration de l'action Aggregate déclenchera une erreur lors du lancement de l'action. Si vous préférez laisser le champ de destination vide, veillez simplement à le retirer de la liste des attributs mappés.
En savoir plus sur les actions Aggregate
Cliquez sur Create en haut à droite.
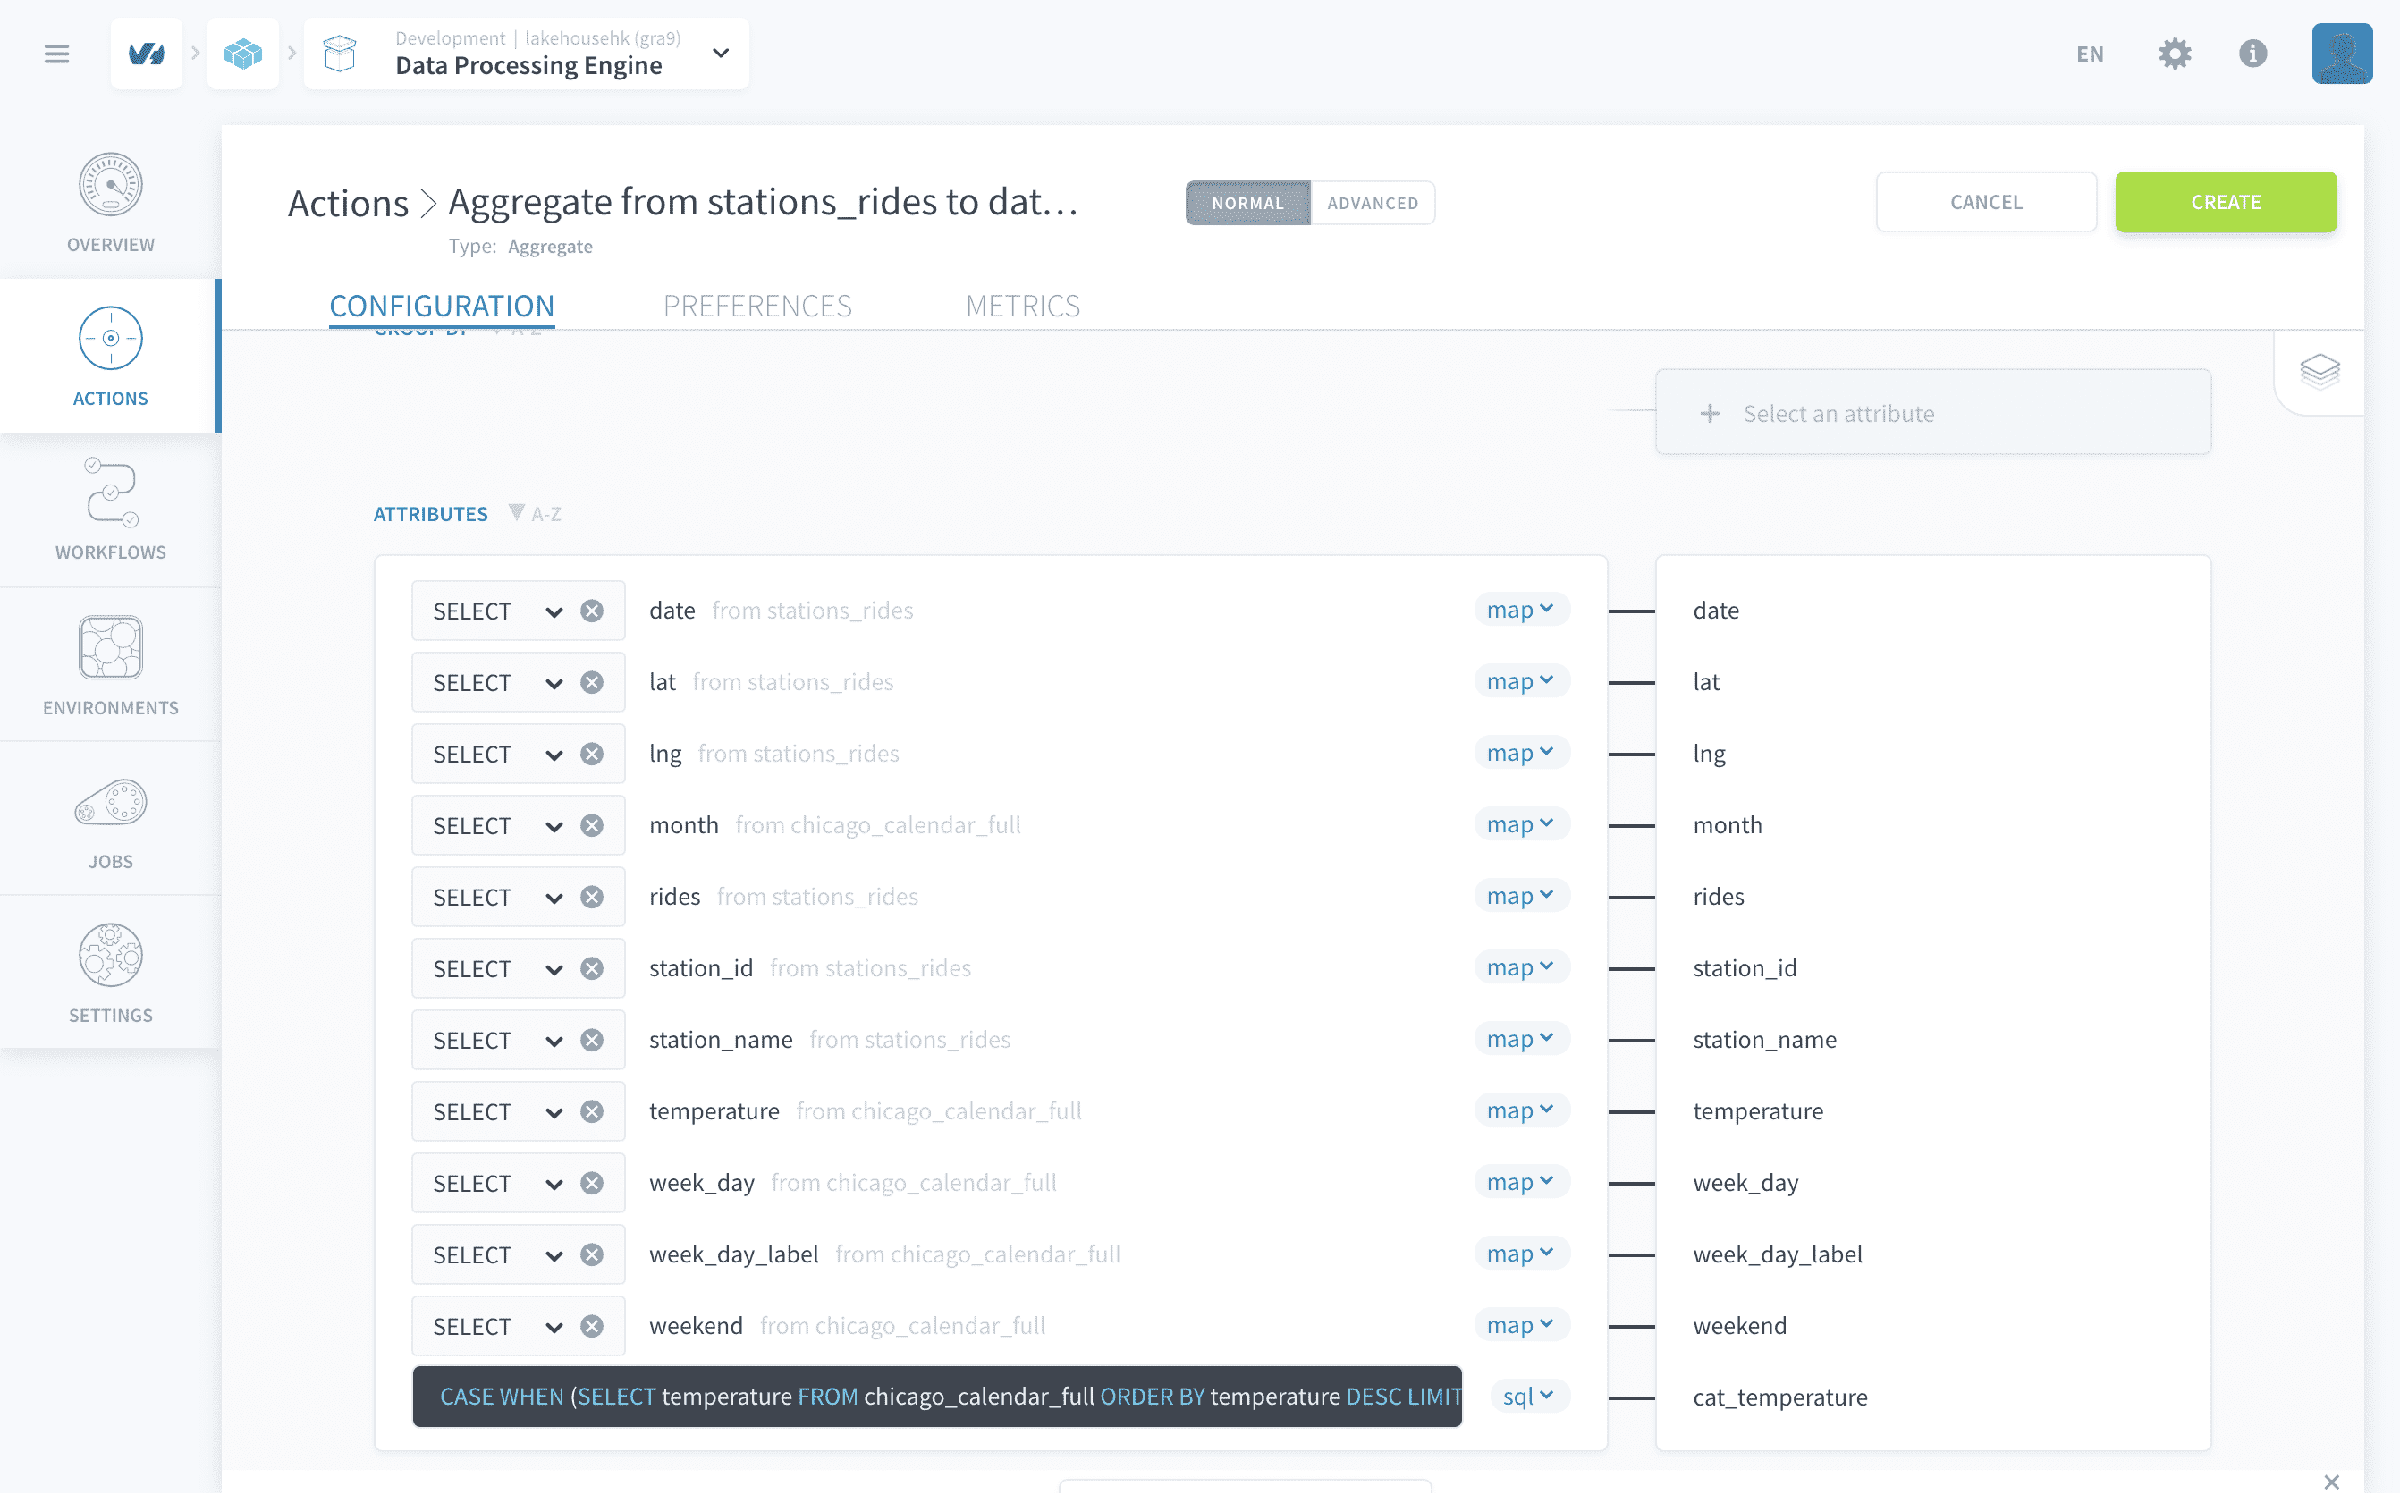
Vous avez maintenant généré toutes les actions requises pour ce tutoriel.
Bien sûr, votre Projet réel aura probablement plus de 3 actions. Vous pouvez organiser vos actions en dossiers et les renommer si nécessaire. Vous pouvez également utiliser plusieurs référentiels, notamment si vous travaillez en collaboration avec des coéquipiers. Les référentiels d'actions peuvent être versionnés et également synchronisés avec des dépôts Git externes. Consultez le guide Créer et gérer des actions pour en savoir plus sur la façon de procéder.
En savoir plus sur les Actions
Avant de passer à l'étape suivante de création des workflows, nous allons créer une dernière action - Delete.
Son usage est très simple : supprimer le contenu de la ou des tables sélectionnées.
Créez une nouvelle action delete et ajoutez toutes les tables que nous avons créées jusqu'à présent - l'idée est simple : si vous chargez une table avec de nouvelles données ou si vous rechargez la table avec d'anciennes données, vous devrez nettoyer la table au préalable, car c'est une bonne pratique.
Workflows
Un workflow définit l'ordre d'exécution de vos actions.
Au sein d'un workflow, les actions sont organisées en Stages séquentiels. Au sein d'un Stage, toutes les actions seront exécutées en parallèle tandis que les Stages s'exécuteront toujours les uns après les autres. La même action peut être utilisée plusieurs fois dans le même workflow. Un workflow, tout comme une action, peut être lancé manuellement, planifié pour s'exécuter selon un calendrier ou déclenché via un appel API.
Notez qu'il est important de se rappeler que les Stages s'exécutent les uns après les autres dans l'ordre où vous les avez planifiés, tandis que les actions contenues dans un Stage s'exécutent toutes en même temps, quel que soit leur ordre. En résumé, l'ordre des actions au sein d'un Stage n'a pas d'importance, contrairement à l'ordre des Stages au sein d'un workflow.
Pour créer votre premier workflow, vous devrez vous rendre dans l'onglet Workflow et cliquer sur New Workflow. Rendez-vous dans les preferences ou double-cliquez sur le nom d'en-tête pour définir un nouveau nom Import Chicago Data.
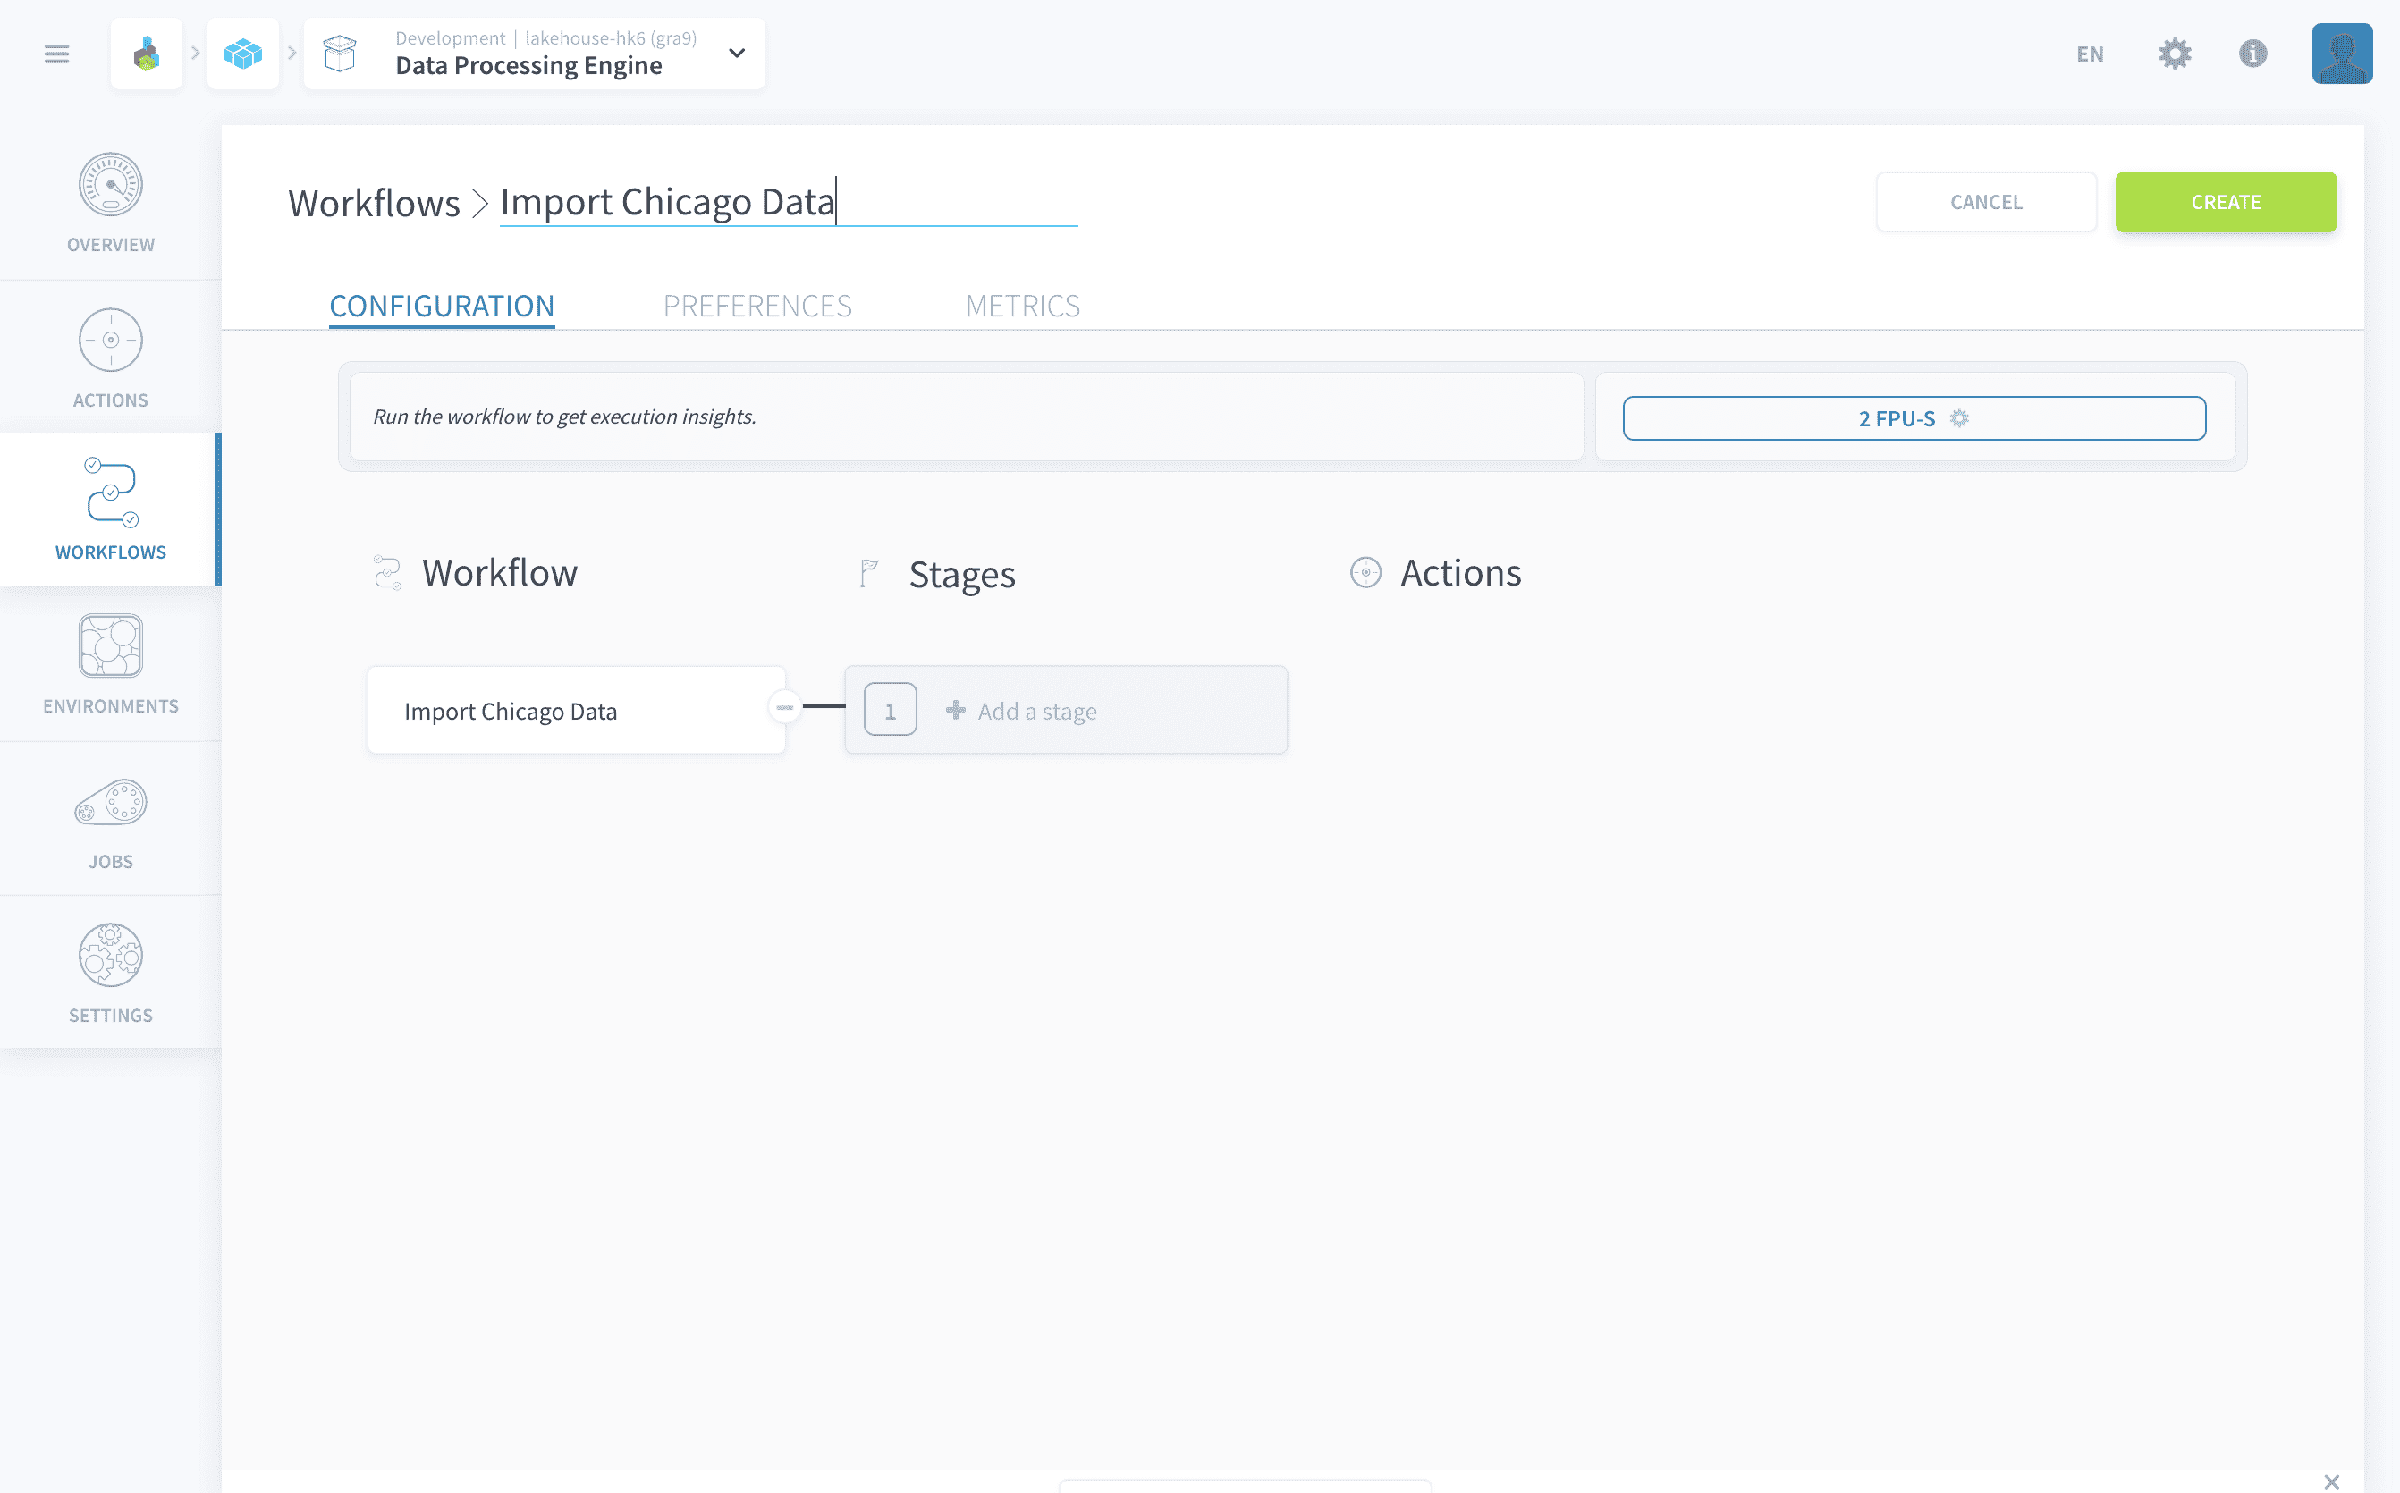
Commençons par définir trois Stages différents en cliquant sur Add a stage. Ensuite, ajoutez des actions dans chaque Stage à l'aide du sélecteur de recherche déroulant en suivant la capture d'écran fournie comme guide pour chaque Stage.
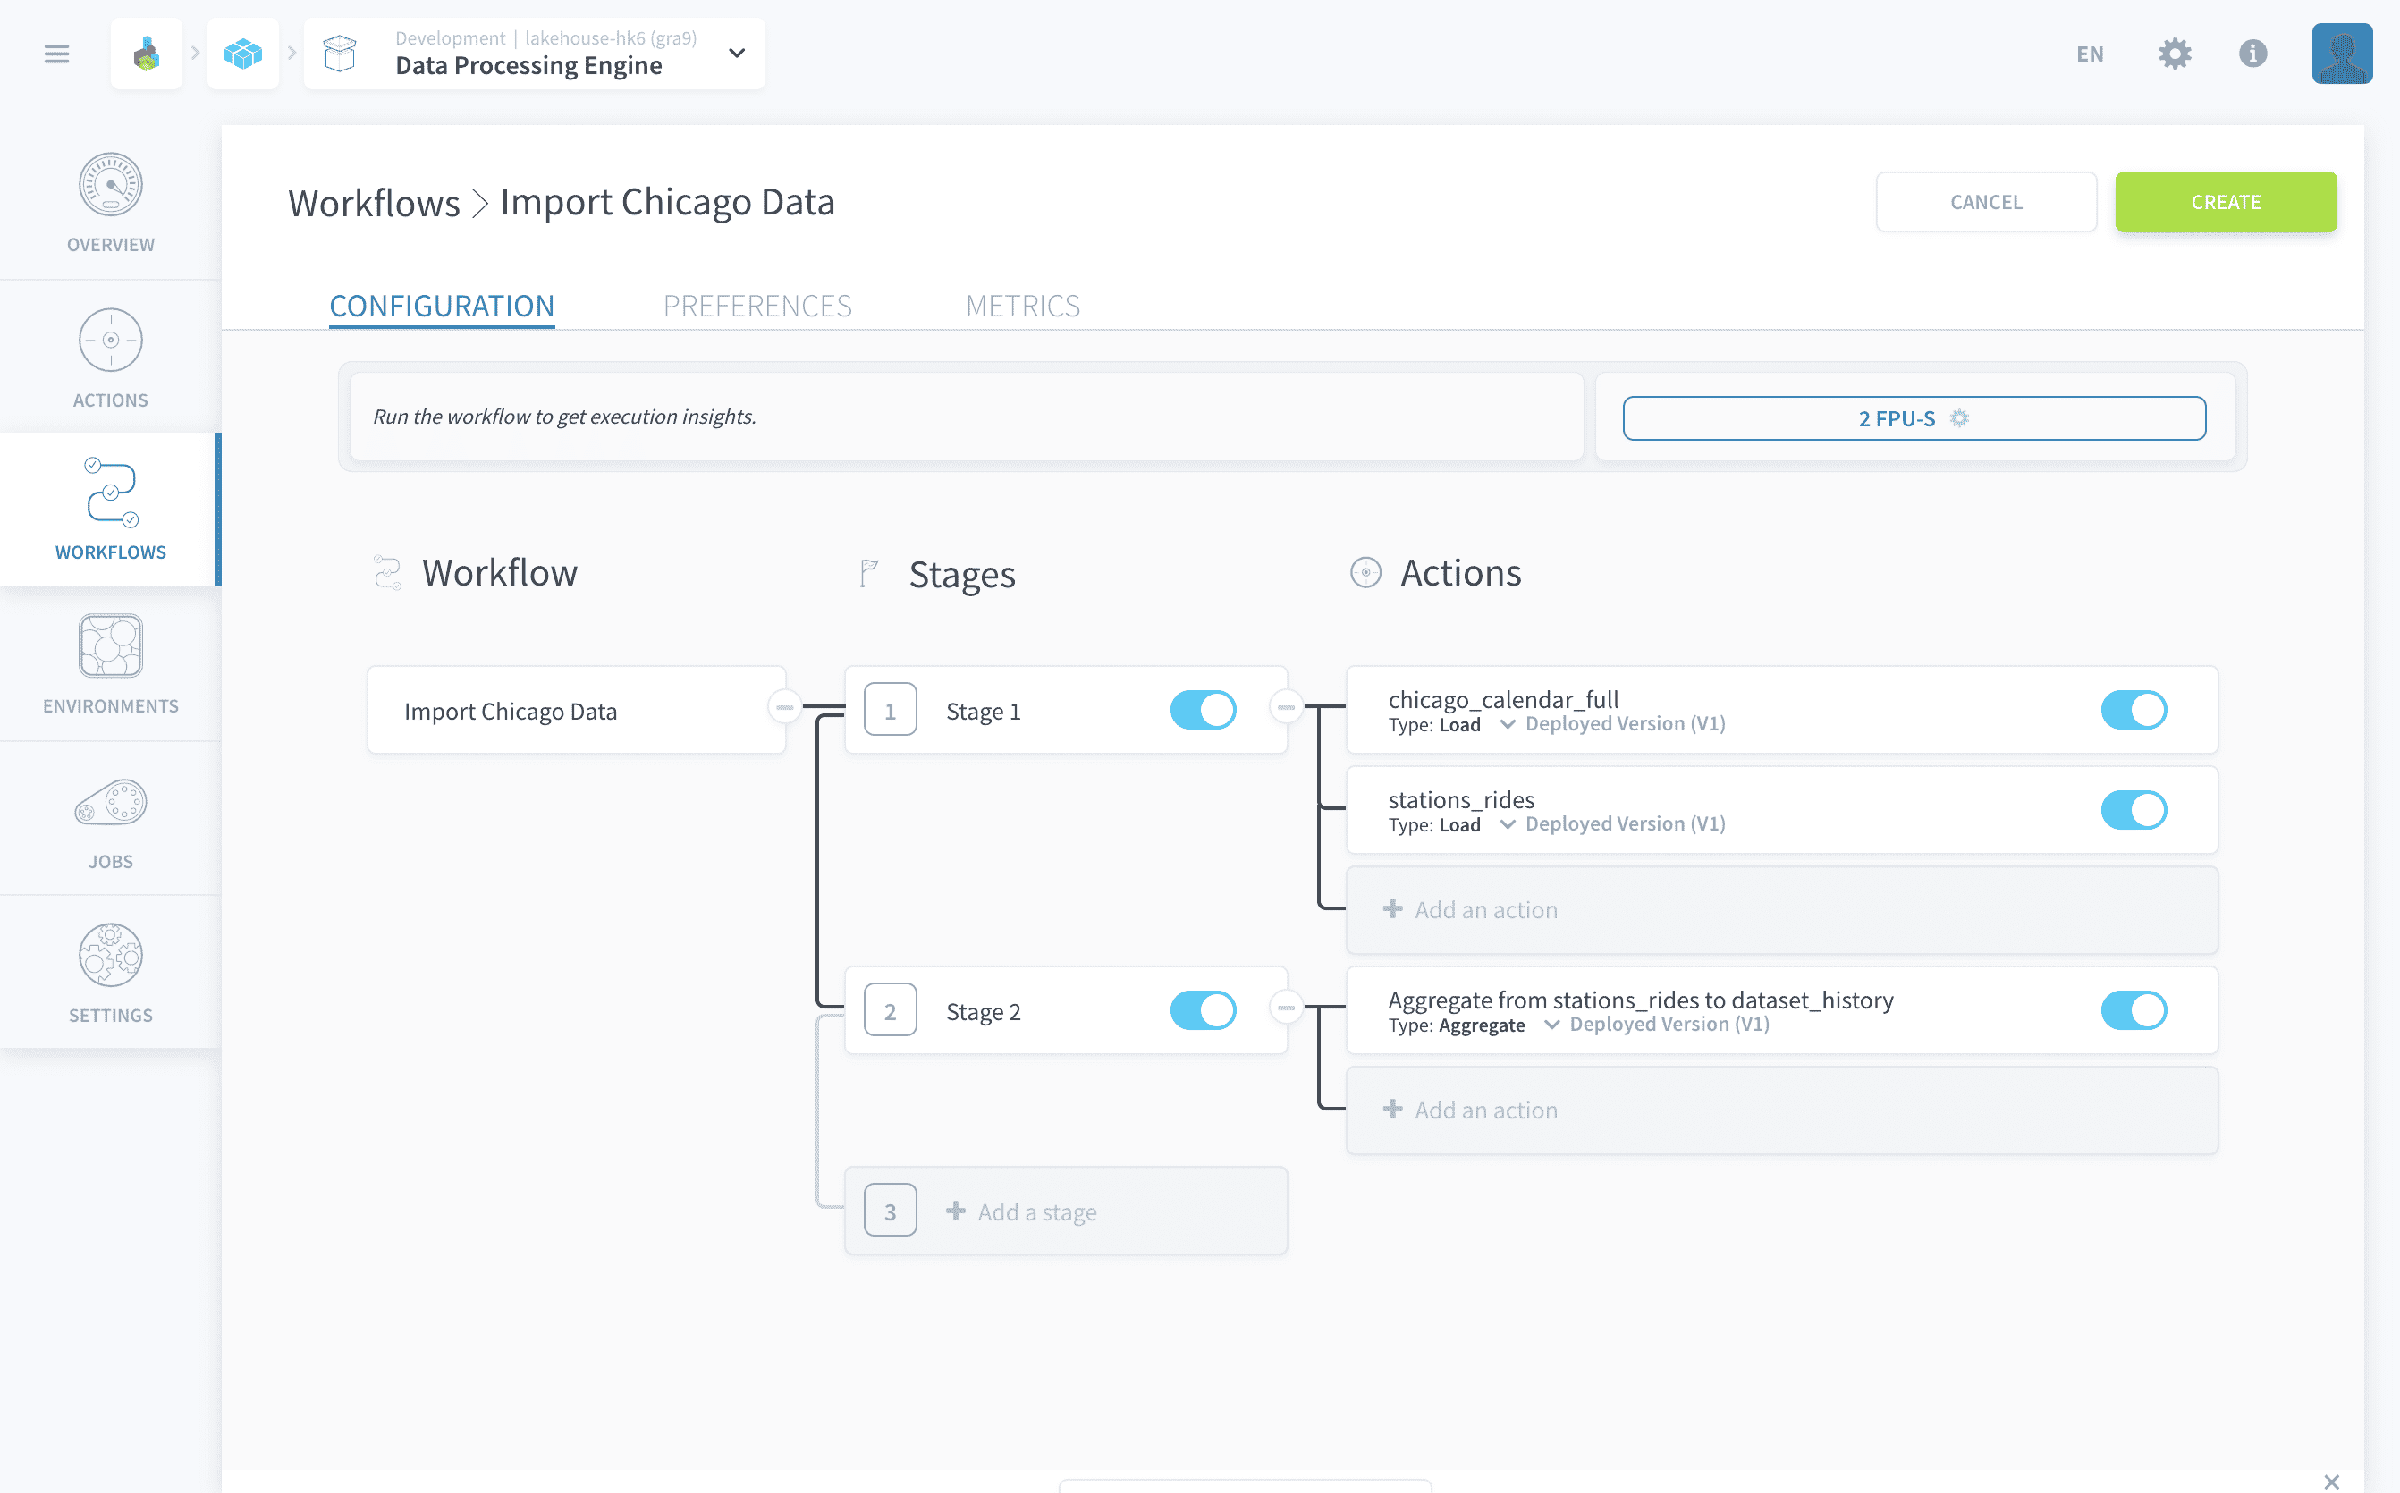
Après avoir créé le workflow (create), appuyez sur Play.
Notez que les workflows peuvent prendre quelques minutes à s'exécuter lorsque vous les lancez pour la première fois. Le temps total ne devrait pas dépasser 10 minutes - si c'est le cas, veuillez contacter notre équipe support.
Pendant que le workflow s'exécute, vous pouvez le planifier pour qu'il s'exécute quotidiennement à l'aide d'un déclencheur.
Rendez-vous dans l'onglet Preferences de vos workflows et faites défiler jusqu'au widget Triggers en bas à gauche. Cliquez sur +Add.
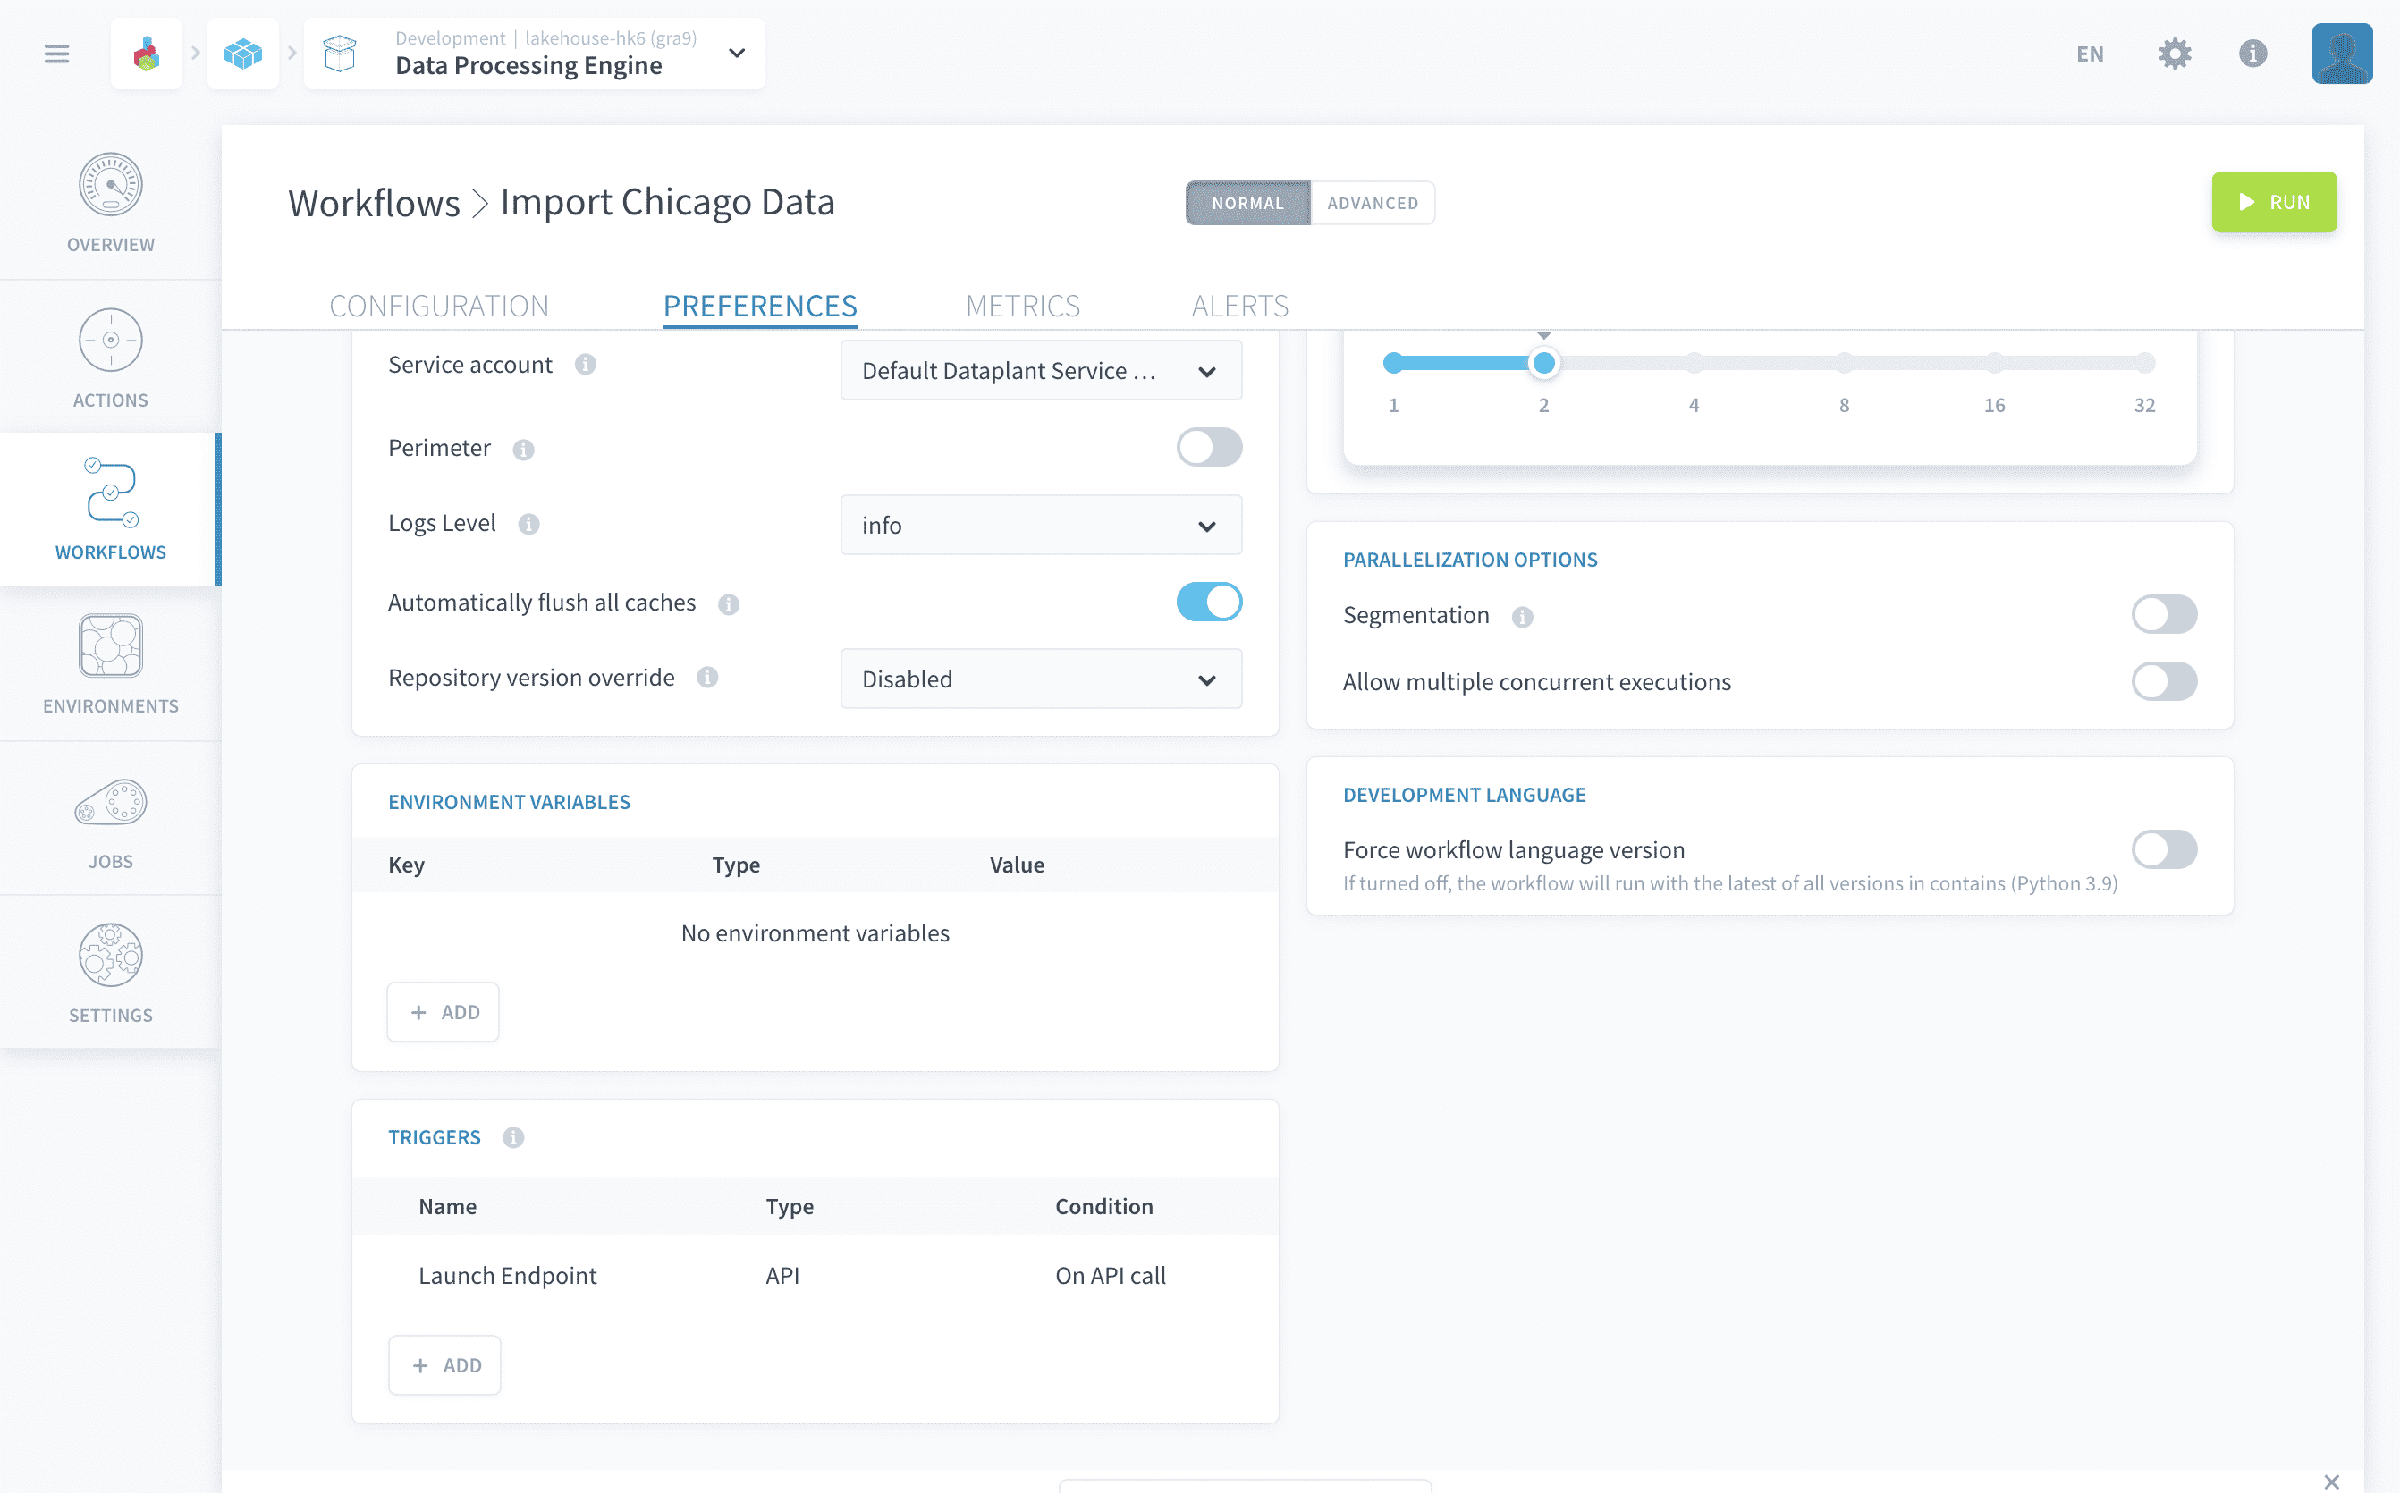
Sélectionnez le type de déclencheur CRON et le mode Simple. Naviguez vers l'onglet Daily et dans la liste des options, sélectionnez Every 1 day(s) comme indiqué sur l'image ci-dessous :
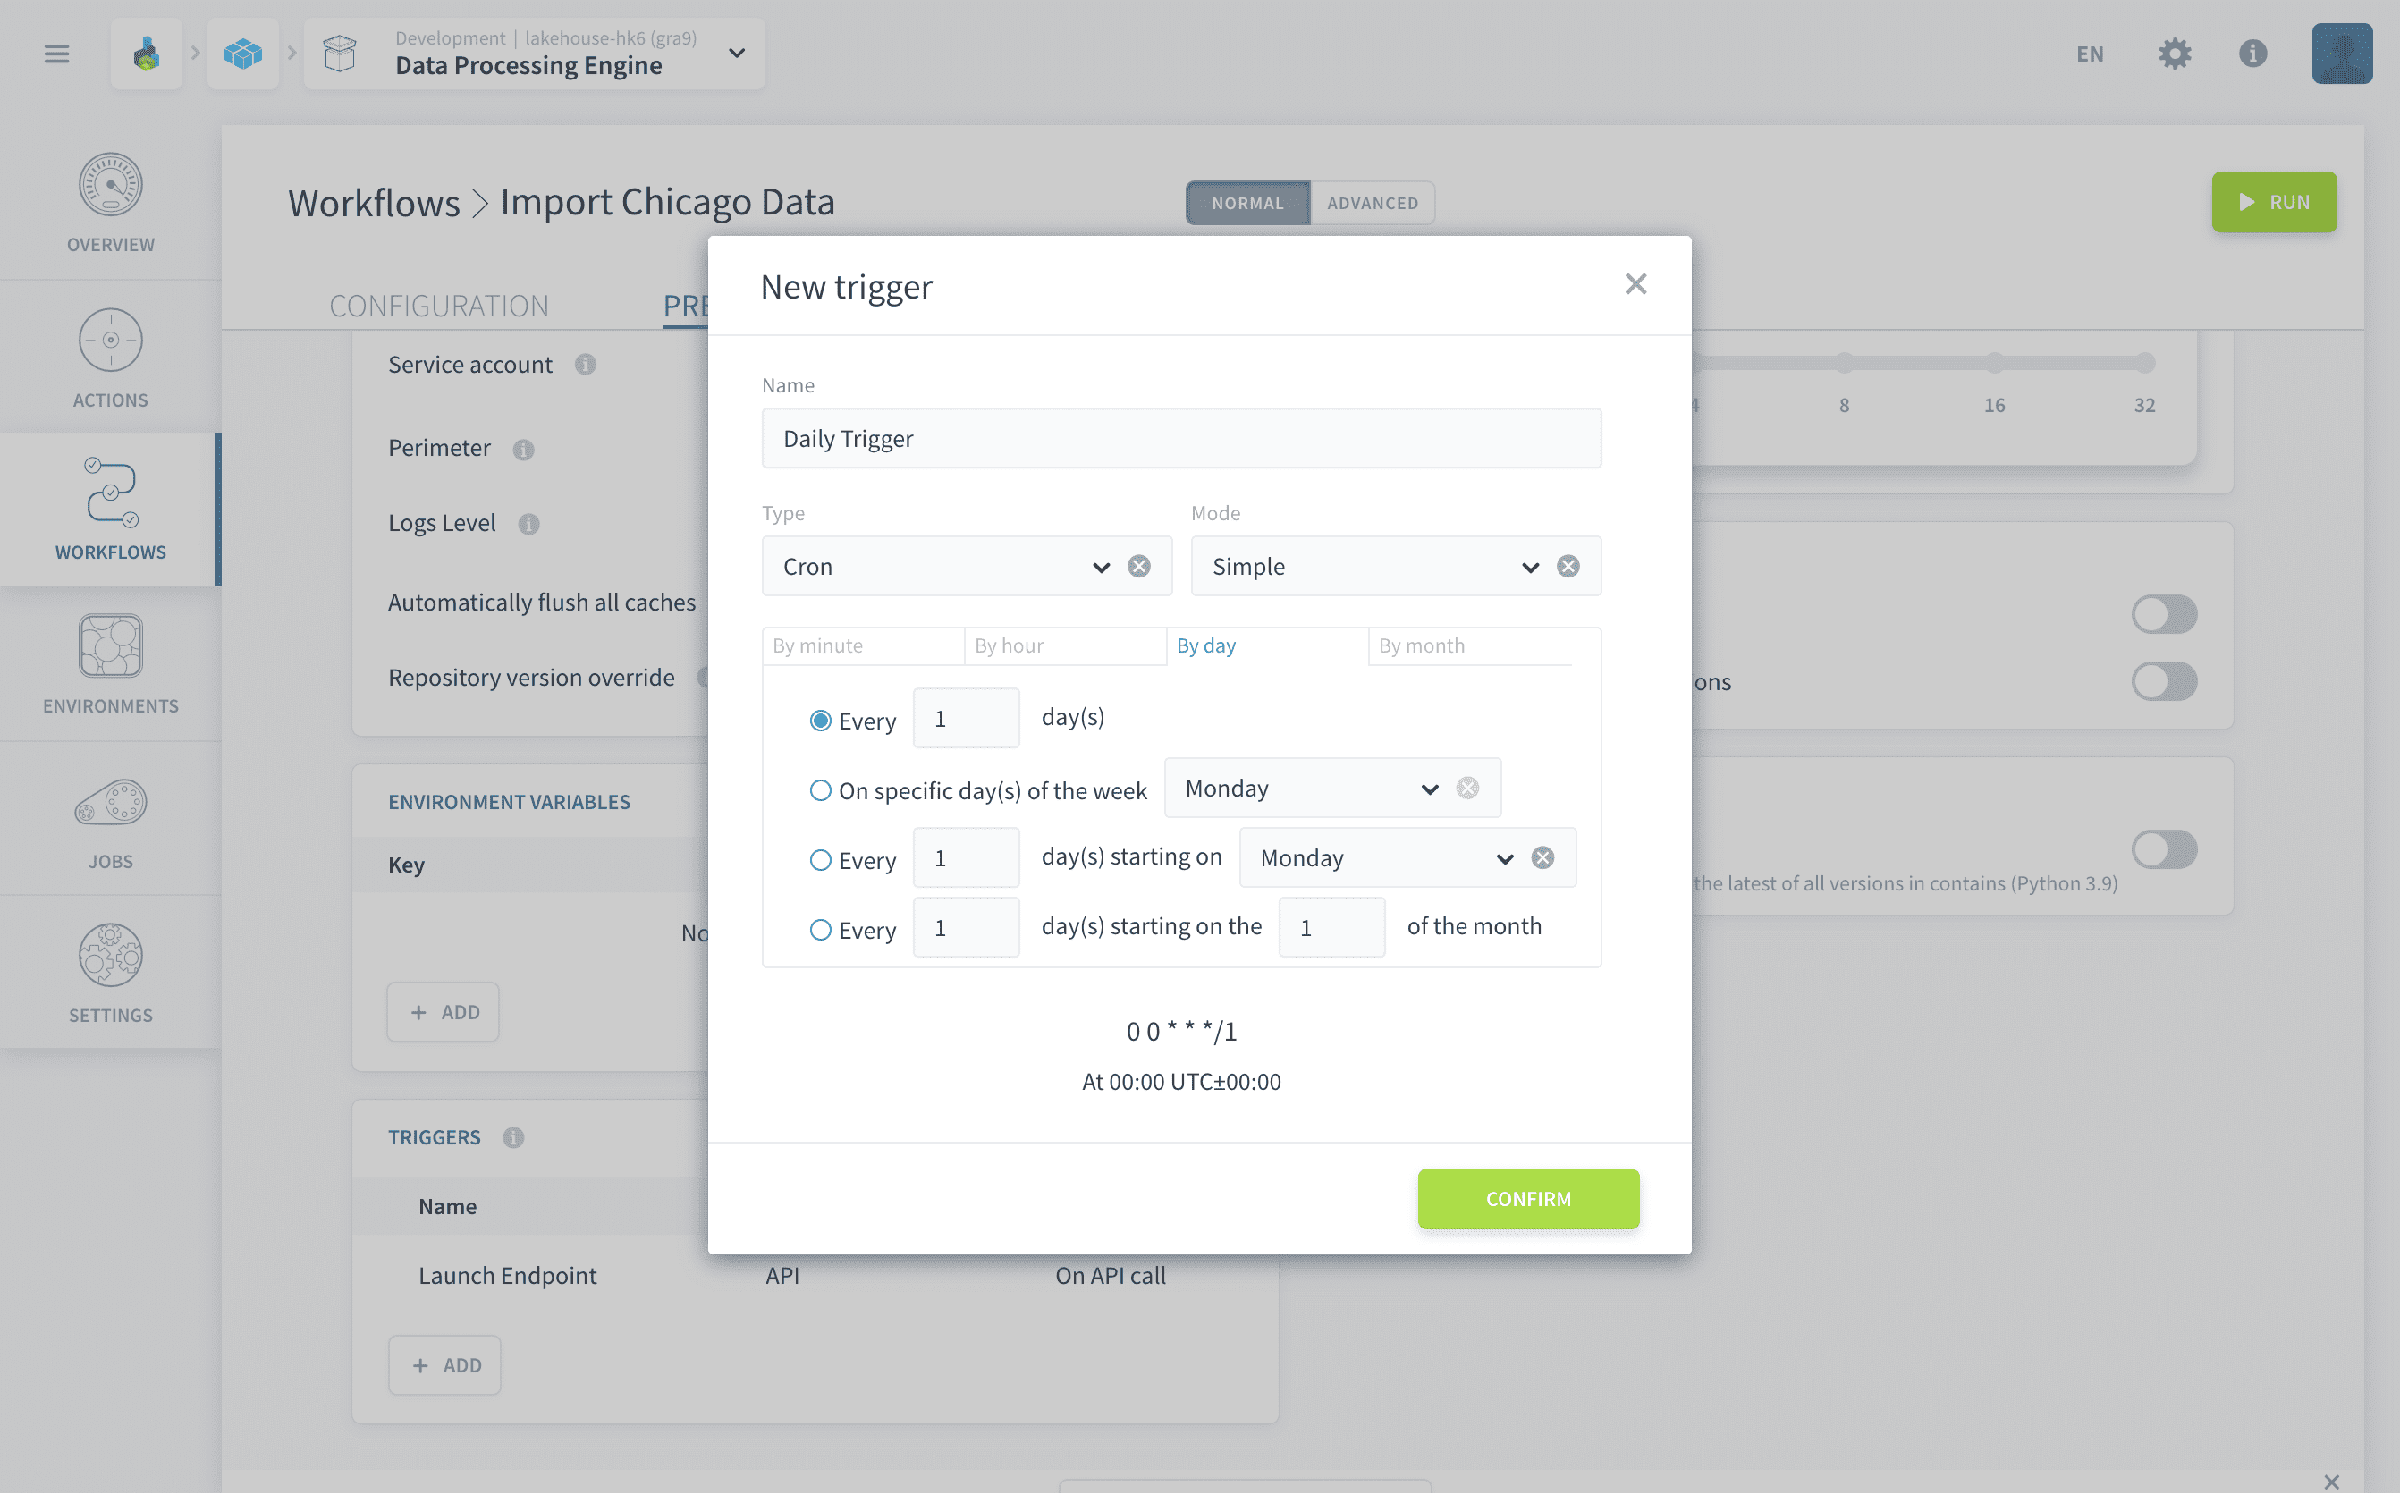
Appuyez sur le bouton Confirm pour créer le nouvel événement déclencheur avec le nom de votre choix, et il sera ajouté sous le Launch Endpoint présent par défaut dans le tableau des événements déclencheurs.
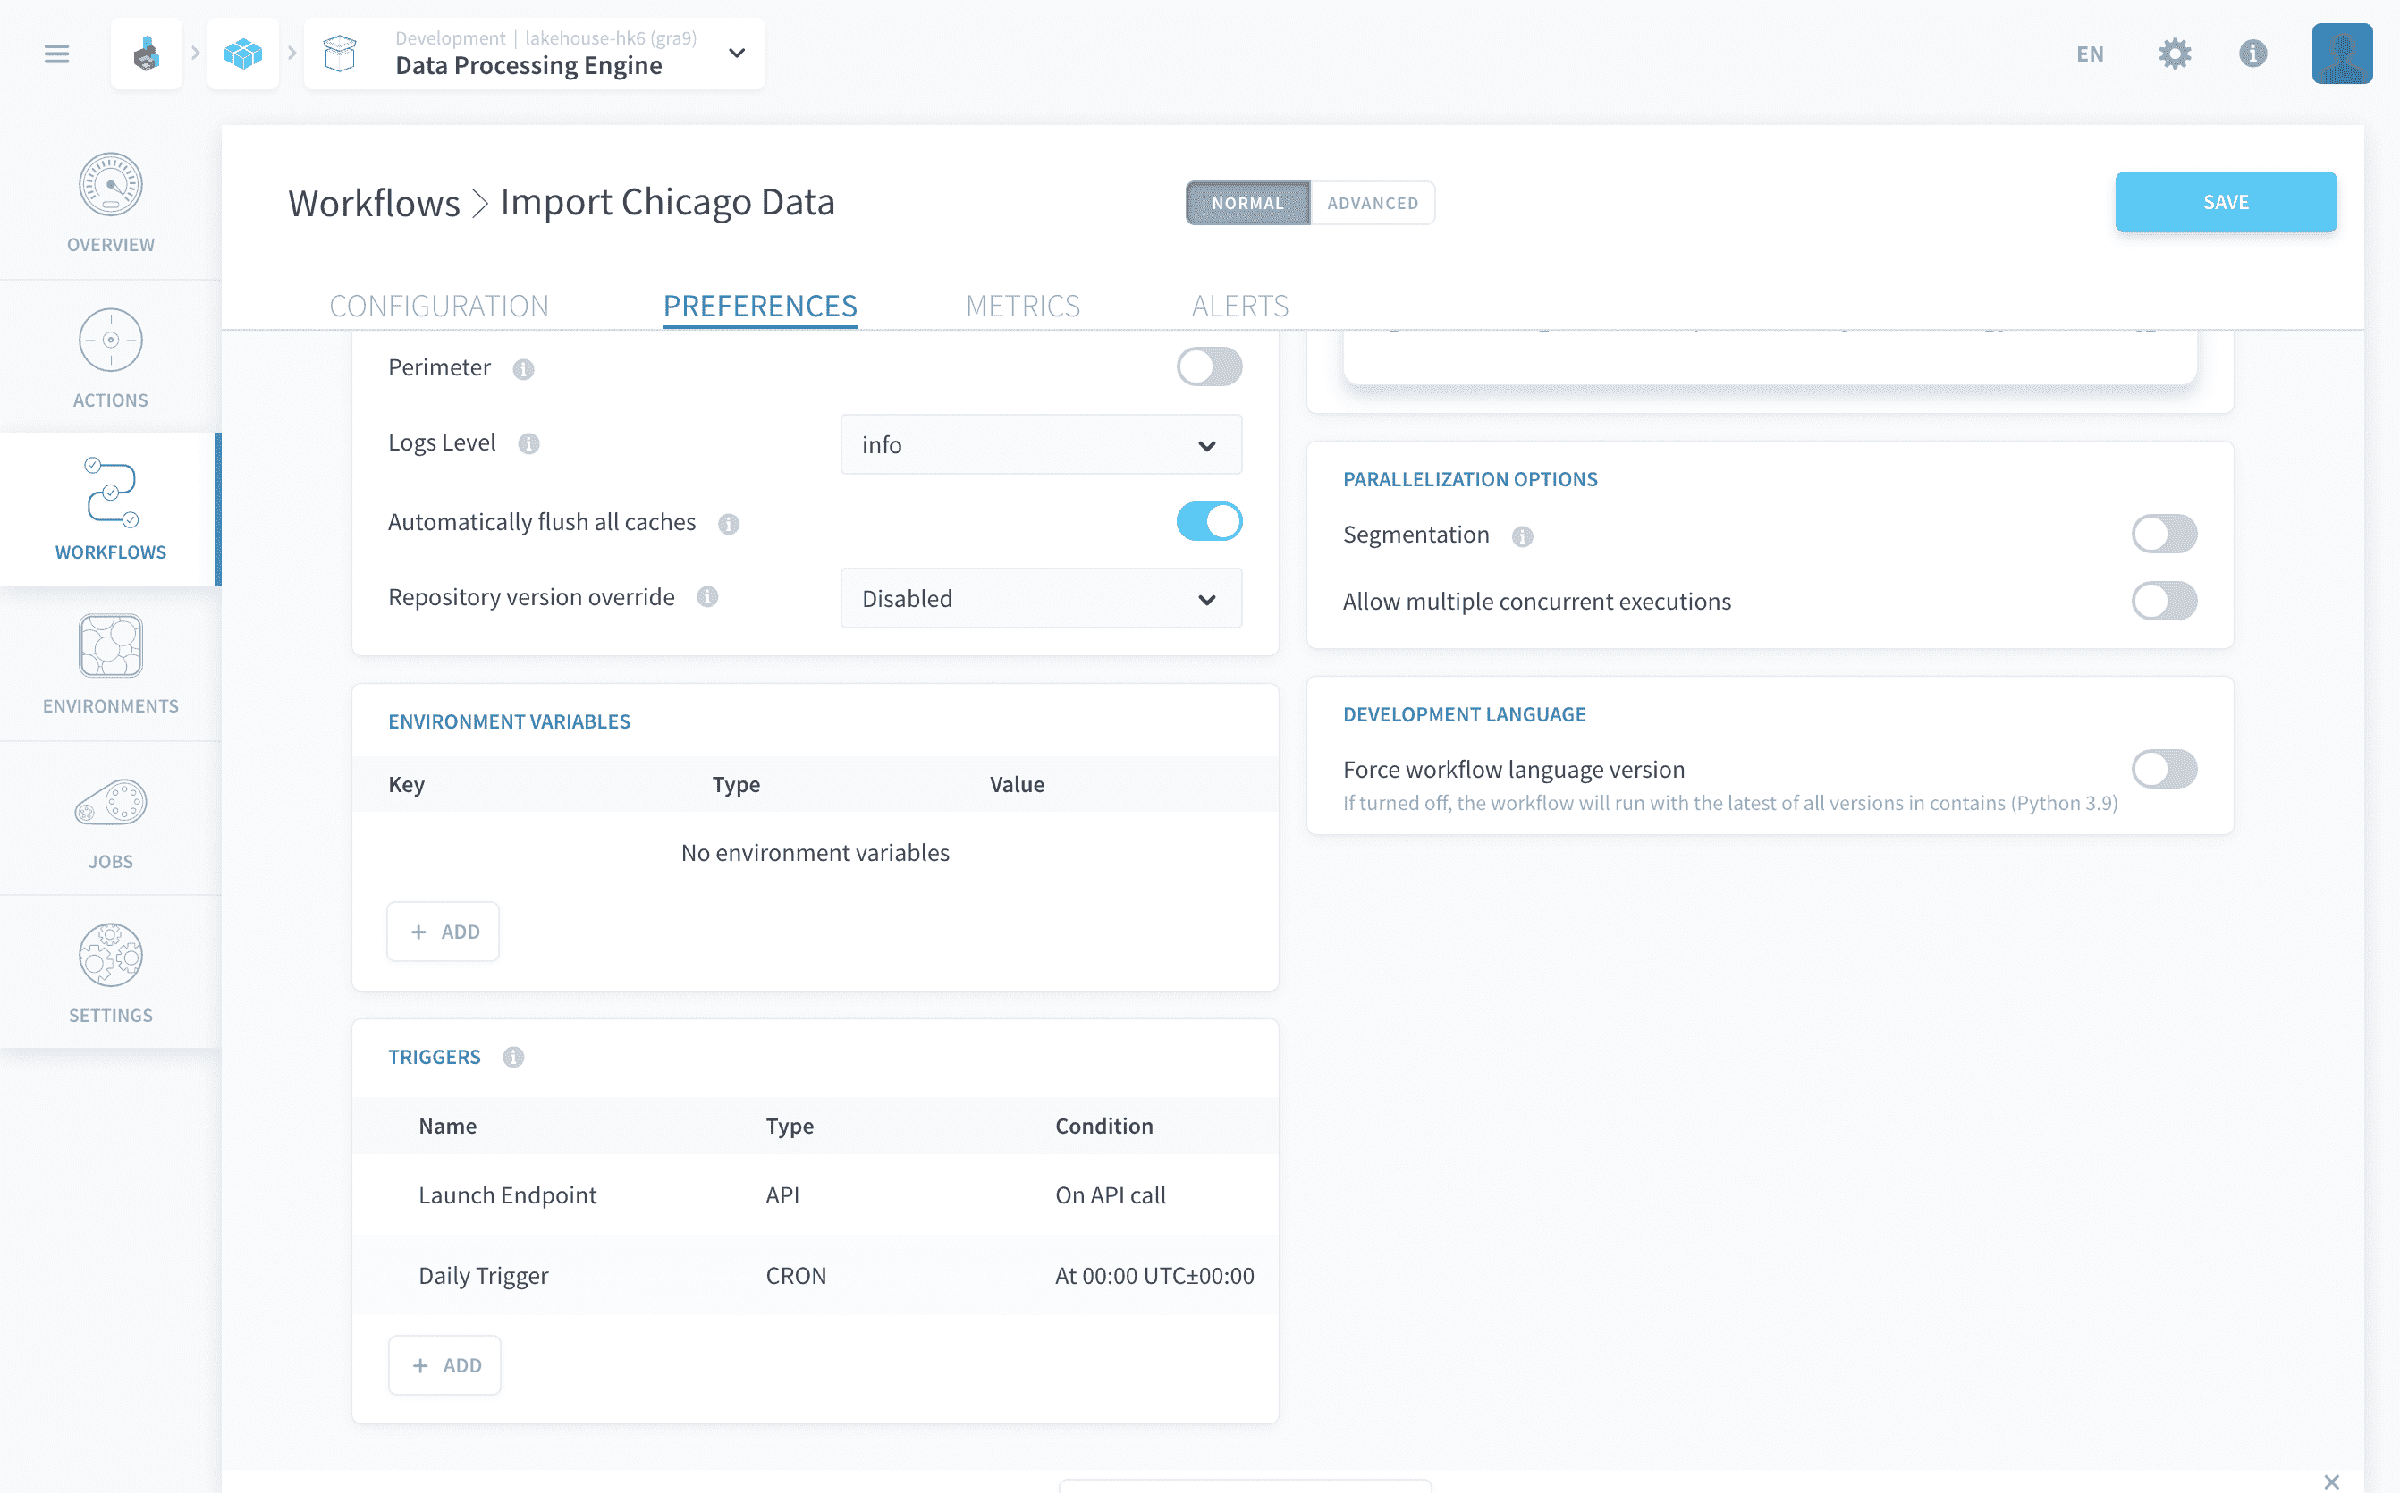
Il y a bien plus à configurer dans les preferences d'un workflow. Notamment, vous pouvez mettre à l'échelle horizontalement et verticalement n'importe quelle tâche de traitement, utiliser la segmentation de charge de travail pour accélérer le traitement des données et même sauvegarder toutes ces configurations pour une utilisation répétée grâce aux environnements.
En savoir plus sur la configuration des préférences d'exécution.
Assurez-vous de cliquer sur le bouton Save en haut à droite de l'écran chaque fois que vous apportez une modification à vos workflows. Les actions sont stockées dans des référentiels qui peuvent être versionnés, ce qui n'est pas le cas pour les workflows ou les environnements. Autosave est donc désactivé pour les workflows et les environnements.
Jobs
Pour conclure cette section, voici quelques mots sur le dernier onglet du composant Data Processing Engine : jobs.
L'onglet Jobs résume toutes les exécutions déclenchées dans le Data Processing Engine et inclut des rapports de métriques avancés. Les jobs sont répertoriés selon trois catégories principales : running, queued et past executions. En consultant les derniers jobs exécutés, vous pouvez vérifier le statut du workflow que vous venez de lancer.
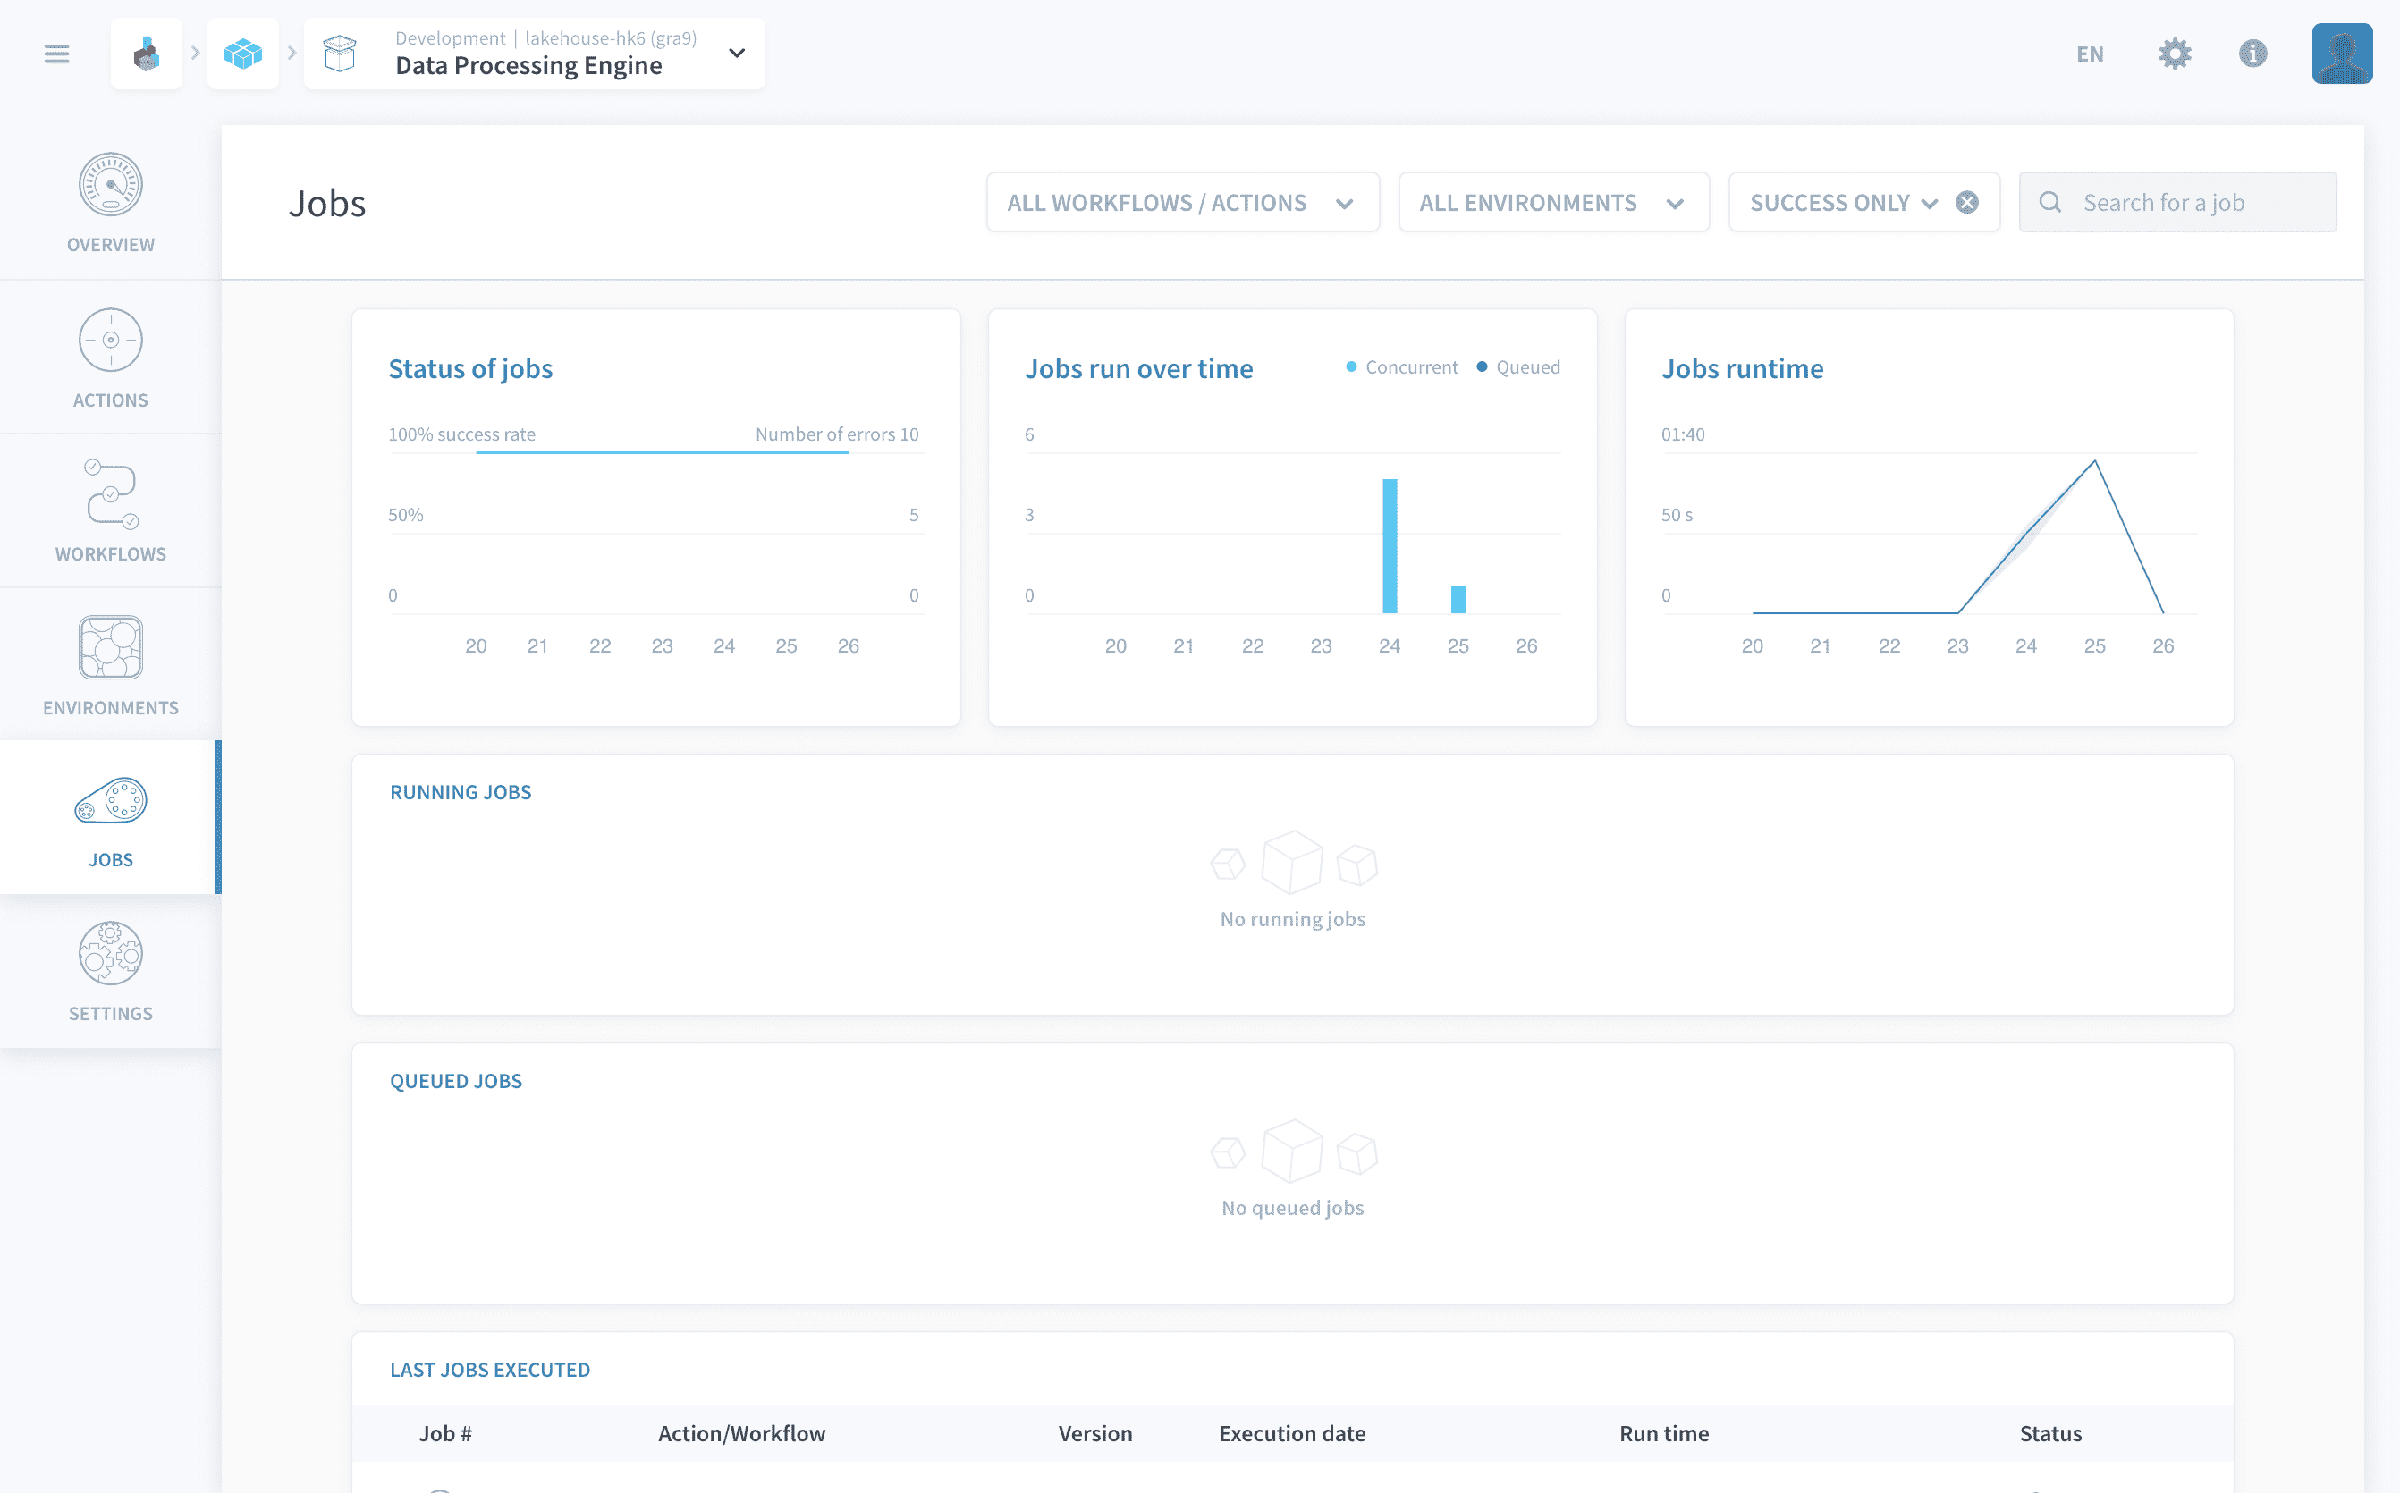
L'allocation des ressources sur la Platform se fait via des unités propriétaires appelées DPU, Data Platform Units. Vous pouvez modifier la quantité de DPU dédiée à une action ou à un workflow dans leurs preferences.
Vous avez maintenant terminé la section Data Engineering du tutoriel Premiers pas.
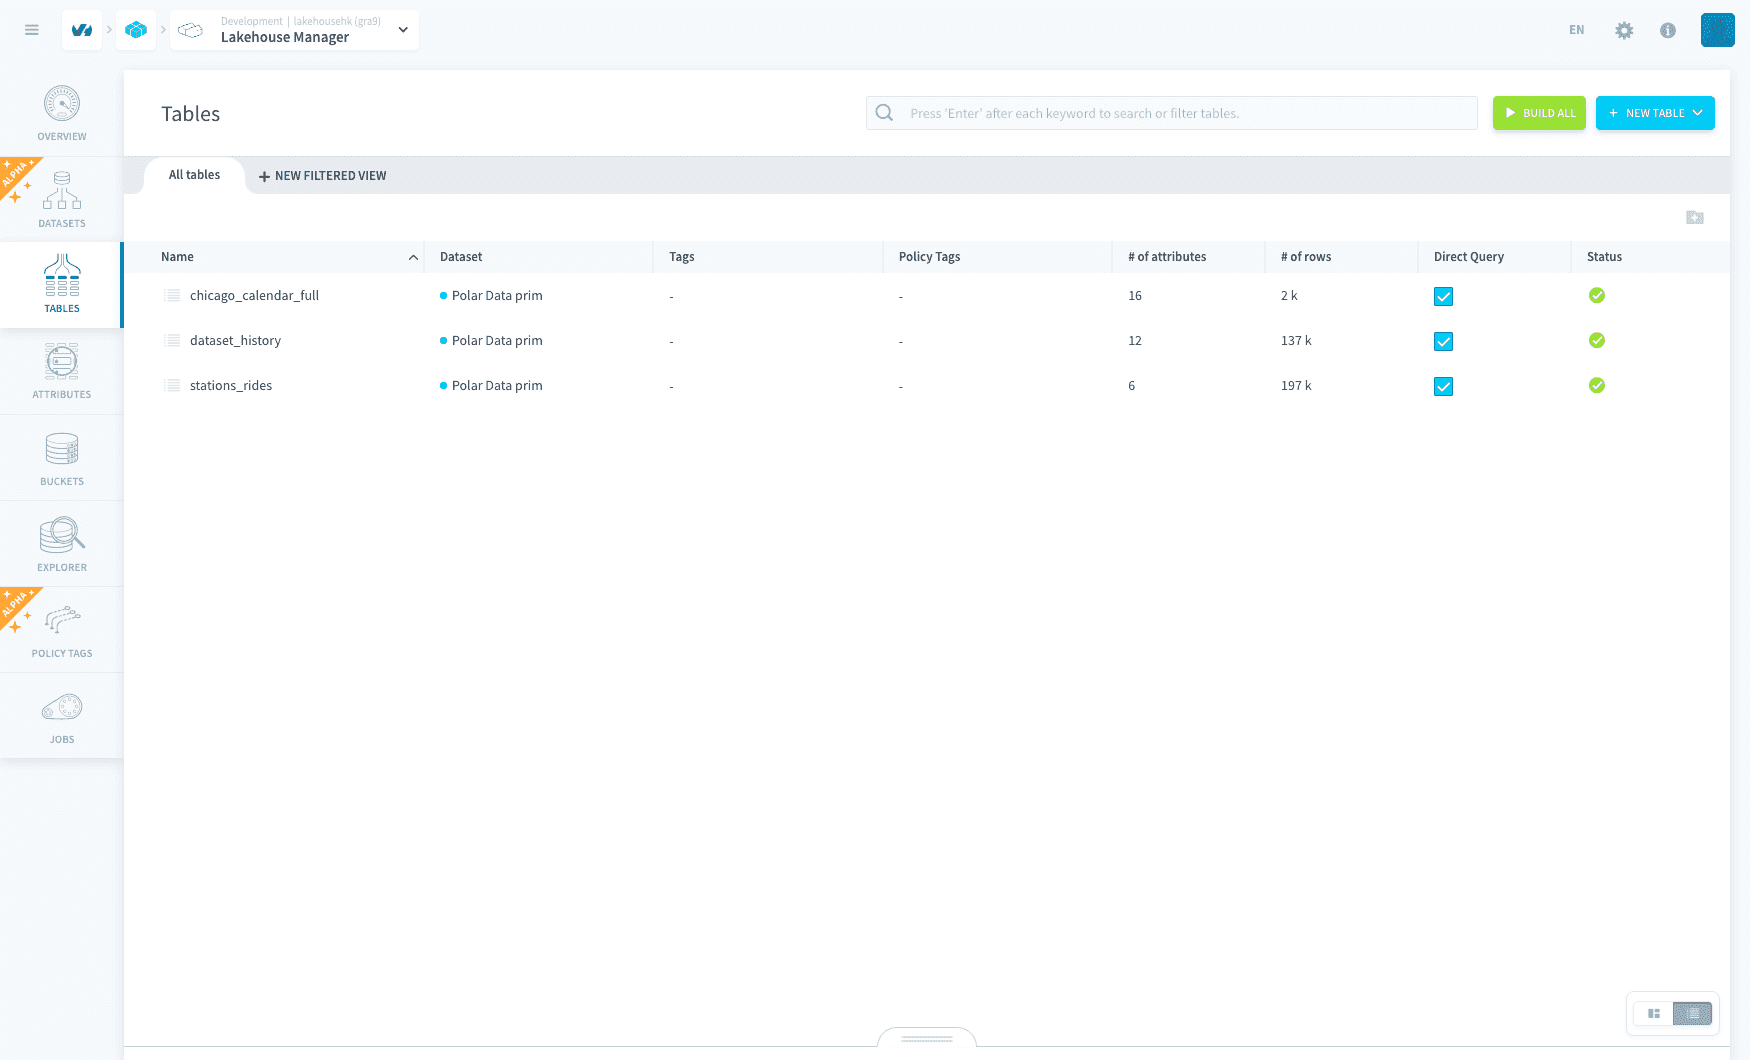
Une bonne façon de vous assurer que vos données sont correctement chargées est de retourner dans le Lakehouse Manager et de regarder le nombre de lignes chargées dans la table. Ouvrez simplement le mode d'affichage liste et vérifiez la colonne rows : si le champ contient un nombre (indiquant combien de lignes ont été chargées), alors tout a bien fonctionné.
Rappelez-vous que vous mettez en place un système de niveau production, c'est pourquoi vous avez besoin à la fois d'un Lakehouse Manager et d'un Data Processing Engine. N'hésitez pas à nous contacter sur le canal Data Platform au sein du serveur Discord si vous rencontrez des problèmes ou si vous souhaitez de l'aide pour accélérer vos pipelines de données, optimiser leurs performances, ajouter des sources de données exotiques personnalisées ou créer des scripts personnalisés !
Passons maintenant au prochain composant de votre système de données : l'Analytics Manager.
Créer des requêtes pertinentes avec l'Analytics Manager
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.