Analyse comparative des types de taxi à New York avec PySpark
Ce tutoriel prolonge notre analyse précédente pour comparer les schémas de trajets entre quatre datasets de transport différents à New York pour janvier 2025 : Yellow Taxi
Objectif
Ce tutoriel prolonge notre analyse précédente pour comparer les schémas de trajets entre quatre datasets de transport différents à New York pour janvier 2025 : Yellow Taxi, Green Taxi, For-Hire Vehicle (FHV), et High Volume FHV Trip Records. Nous allons réaliser une analyse comparative complète pour comprendre les différences d'usage des services au sein de l'écosystème de VTC de New York.
Ces datasets représentent des segments distincts du réseau de transport de New York :
- Yellow Taxi : les emblématiques taxis jaunes, services hélés dans la rue opérant principalement à Manhattan
- Green Taxi : taxis hélés dans la rue spécifiquement axés sur les arrondissements périphériques (Brooklyn, Queens, Bronx, Staten Island)
- FHV : véhicules de transport avec chauffeur (dont Uber, Lyft) réservés via des applications mobiles, couvrant tous les arrondissements
- High Volume FHV : fournisseurs à haut volume comme Uber et Lyft avec des volumes de trajets exceptionnellement élevés
En comparant le volume de trajets, la durée moyenne des trajets, et les zones de prise en charge selon les arrondissements, nous allons mettre au jour des différences clés dans les schémas d'usage des services. Cette analyse offre des enseignements précieux pour les urbanistes, les opérateurs de taxi, et les entreprises de VTC analysant la dynamique de marché et les stratégies opérationnelles.
Ce tutoriel s'appuie sur les techniques de nettoyage et de jointure de notre analyse Yellow Taxi précédente, réalise une analyse exploratoire des données (EDA) complète, et crée des visualisations pour mettre en évidence les schémas d'usage selon les différents modes de transport.
Prérequis
Avant de commencer cette analyse comparative, assurez-vous d'avoir :
- Configuration des données : les quatre datasets (
yellow_tripdata_2025_01.parquet, green_tripdata_2025_01.parquet, fhv_tripdata_2025_01.parquet, fhvhv_tripdata_2025_01.parquet) et le fichier taxi_zone_lookup.csv sont chargés dans vos Connectors et accessibles dans le Lakehouse Manager. Vous pouvez télécharger ces datasets depuis le site officiel NYC TLC Trip Record Data.
- Environnement : un notebook Jupyter avec PySpark activé, configuré sur la Data Platform OVHcloud
- Tutoriel précédent : avoir terminé le tutoriel Analyse du NYC Yellow Taxi Dataset pour une compréhension de base
Si vous n'avez pas encore réalisé la configuration des données, suivez les étapes 1 à 3 du tutoriel précédent pour :
- Charger les datasets dans les Connectors
- Créer des tables dans le Lakehouse Manager
- Configurer des load actions dans le Data Processing Engine (DPE)
Tutoriel étape par étape
L'intégralité du code PySpark est fournie ci-dessous avec des explications détaillées pour chaque étape. Copiez-collez ceci dans un nouveau notebook Jupyter sur la Data Platform OVHcloud. Chaque section inclut des commentaires et explications complets pour vous guider tout au long du processus d'analyse comparative.
Étape 1 : configuration de l'environnement et connexion aux données
Nous initialisons notre session PySpark et établissons les connexions pour accéder aux quatre datasets de transport.
import logging
from forepaas.dwh import connect
from pyspark.sql import SparkSession
from pyspark.sql.functions import lit, col, hour, dayofweek, unix_timestamp, avg, count, sum, when
from pyspark.sql.window import Window
from pyspark.sql.functions import row_number
import matplotlib.pyplot as plt
import seaborn as sns
import pandas as pd

# Variables de configuration
DATASET = "default_dataset"
PROJECT_ID = "PROJECT_ID"  # Remplacez par l'ID de votre projet
YEAR = "2025"
MONTH = "01"

# Configuration du logging pour le débogage
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')

# Initialisation de la SparkSession
try:
    spark = SparkSession.builder.appName("NYC_Taxi_Comparative_Analysis").getOrCreate()
    logging.info(f"Spark Version: {spark.version}")
except Exception as e:
    logging.error(f"Failed to initialize SparkSession: {e}")
    raise

# Connexion au Lakehouse
try:
    cn_prim = connect(f"dwh/{DATASET}/")
    logging.info(f"Connected to Lakehouse - Dataset: {DATASET}")
except Exception as e:
    logging.error(f"Failed to connect to Lakehouse - Dataset: {DATASET} | {e}")
    raise
Ce que fait ce code :
- Importe les librairies nécessaires pour le traitement des données et la visualisation
- Configure le logging pour le débogage et le monitoring
- Initialise une session PySpark optimisée pour le traitement de données à grande échelle
- Établit la connexion au Lakehouse de la Data Platform OVHcloud
Étape 2 : chargement des données et inspection initiale
Nous chargeons les quatre datasets de transport ainsi que la table de lookup des zones de taxi, puis vérifions que le chargement s'est bien déroulé et inspectons leurs schémas.
# Chargement de tous les datasets depuis le Lakehouse
yellow_df = cn_prim.query(f"SELECT * FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.yellow_tripdata_2025_01")
green_df = cn_prim.query(f"SELECT * FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.green_tripdata_2025_01")
fhv_df = cn_prim.query(f"SELECT * FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.fhv_tripdata_2025_01")
fhvhv_df = cn_prim.query(f"SELECT * FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.fhvhv_tripdata_2025_01")
taxi_zones_df = cn_prim.query(f"SELECT LocationID, Borough, Zone FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.taxi_zone_lookup")

# Mise en cache des DataFrames pour de meilleures performances
yellow_df.cache()
green_df.cache()
fhv_df.cache()
fhvhv_df.cache()
taxi_zones_df.cache()

# Vérification du bon chargement des données
logging.info(f"Yellow Taxi Records: {yellow_df.count():,}")
logging.info(f"Green Taxi Records: {green_df.count():,}")
logging.info(f"FHV Records: {fhv_df.count():,}")
logging.info(f"High Volume FHV Records: {fhvhv_df.count():,}")
logging.info(f"Taxi Zones Records: {taxi_zones_df.count():,}")

# Inspection des schémas des datasets
print("=== DATASET SCHEMAS ===")
print("\nYellow Taxi Schema:")
yellow_df.printSchema()
print("\nGreen Taxi Schema:")
green_df.printSchema()
print("\nFHV Schema:")
fhv_df.printSchema()
print("\nHigh Volume FHV Schema:")
fhvhv_df.printSchema()
print("\nTaxi Zones Schema:")
taxi_zones_df.printSchema()
Résultat attendu :
- Yellow Taxi : ~3 475 226 enregistrements
- Green Taxi : ~48 326 enregistrements (nettement plus petit, probablement un dataset partiel)
- FHV : ~1 894 659 enregistrements
- High Volume FHV : ~20 405 666 enregistrements (le plus grand dataset)
- Taxi Zones : 265 enregistrements
Pourquoi c'est important :
- La mise en cache améliore les performances pour les opérations répétées, particulièrement critique pour le dataset High Volume FHV
- L'inspection du schéma révèle des différences de colonnes qui doivent être standardisées
- Le nombre d'enregistrements aide à comprendre l'échelle relative de chaque mode de transport
Étape 3 : nettoyage et standardisation des données
Nous nettoyons chaque dataset pour supprimer les enregistrements invalides et standardisons les noms de colonnes et les types de données pour une analyse cohérente entre tous les modes de transport.
# Nettoyage du DataFrame Yellow Taxi
yellow_df_clean = yellow_df.filter(
    (col("tpep_pickup_datetime").isNotNull()) &
    (col("tpep_dropoff_datetime").isNotNull()) &
    (col("passenger_count").isNotNull()) &
    (col("passenger_count") > 0) &
    (col("trip_distance") > 0) &
    (col("fare_amount") > 0)
).withColumn("pickup_datetime", col("tpep_pickup_datetime")) \
 .withColumn("dropoff_datetime", col("tpep_dropoff_datetime")) \
 .withColumn("trip_duration", unix_timestamp("tpep_dropoff_datetime") - unix_timestamp("tpep_pickup_datetime")) \
 .withColumn("pickup_hour", hour("tpep_pickup_datetime")) \
 .withColumn("day_of_week", dayofweek("tpep_pickup_datetime")) \
 .withColumn("PULocationID", col("pulocationid").cast("double"))

# Nettoyage du DataFrame Green Taxi
green_df_clean = green_df.filter(
    (col("lpep_pickup_datetime").isNotNull()) &
    (col("lpep_dropoff_datetime").isNotNull()) &
    (col("passenger_count").isNotNull()) &
    (col("passenger_count") > 0) &
    (col("trip_distance") > 0) &
    (col("fare_amount") > 0)
).withColumn("pickup_datetime", col("lpep_pickup_datetime")) \
 .withColumn("dropoff_datetime", col("lpep_dropoff_datetime")) \
 .withColumn("trip_duration", unix_timestamp("lpep_dropoff_datetime") - unix_timestamp("lpep_pickup_datetime")) \
 .withColumn("pickup_hour", hour("lpep_pickup_datetime")) \
 .withColumn("day_of_week", dayofweek("lpep_pickup_datetime")) \
 .withColumn("PULocationID", col("pulocationid").cast("double"))

# Nettoyage du DataFrame FHV (remarque : PULocationID est une chaîne, castée en double)
fhv_df_clean = fhv_df.filter(
    (col("pickup_datetime").isNotNull()) &
    (col("dropoff_datetime").isNotNull()) &
    (col("pulocationid").isNotNull())
).withColumn("trip_duration", unix_timestamp("dropoff_datetime") - unix_timestamp("pickup_datetime")) \
 .withColumn("pickup_hour", hour("pickup_datetime")) \
 .withColumn("day_of_week", dayofweek("pickup_datetime")) \
 .withColumn("PULocationID", col("pulocationid").cast("double"))

# Nettoyage du DataFrame High Volume FHV (utilise trip_miles au lieu de trip_distance)
fhvhv_df_clean = fhvhv_df.filter(
    (col("pickup_datetime").isNotNull()) &
    (col("dropoff_datetime").isNotNull()) &
    (col("trip_miles").isNotNull()) &
    (col("trip_miles") > 0) &
    (col("pulocationid").isNotNull())
).withColumn("trip_duration", unix_timestamp("dropoff_datetime") - unix_timestamp("pickup_datetime")) \
 .withColumn("trip_distance", col("trip_miles")) \
 .withColumn("pickup_hour", hour("pickup_datetime")) \
 .withColumn("day_of_week", dayofweek("pickup_datetime")) \
 .withColumn("PULocationID", col("pulocationid").cast("double"))

# Application d'un filtrage et d'un plafonnement cohérents des valeurs aberrantes pour tous les datasets
yellow_df_clean = yellow_df_clean.filter(
    (col("trip_duration") >= 60) &
    (col("trip_distance") >= 0.1) &
    (col("trip_distance").isNotNull()) &
    (col("pickup_hour").isNotNull()) &
    (col("PULocationID").isNotNull())
).withColumn("trip_duration", when(col("trip_duration") > 3600, 3600).otherwise(col("trip_duration"))) \
 .withColumn("trip_distance", when(col("trip_distance") > 50, 50).otherwise(col("trip_distance")))

green_df_clean = green_df_clean.filter(
    (col("trip_duration") >= 60) &
    (col("trip_distance") >= 0.1) &
    (col("trip_distance").isNotNull()) &
    (col("pickup_hour").isNotNull()) &
    (col("PULocationID").isNotNull())
).withColumn("trip_duration", when(col("trip_duration") > 3600, 3600).otherwise(col("trip_duration"))) \
 .withColumn("trip_distance", when(col("trip_distance") > 50, 50).otherwise(col("trip_distance")))

fhv_df_clean = fhv_df_clean.filter(
    (col("trip_duration") >= 60) &
    (col("pickup_hour").isNotNull()) &
    (col("PULocationID").isNotNull())
).withColumn("trip_duration", when(col("trip_duration") > 3600, 3600).otherwise(col("trip_duration")))

fhvhv_df_clean = fhvhv_df_clean.filter(
    (col("trip_duration") >= 60) &
    (col("trip_distance") >= 0.1) &
    (col("pickup_hour").isNotNull()) &
    (col("PULocationID").isNotNull())
).withColumn("trip_duration", when(col("trip_duration") > 3600, 3600).otherwise(col("trip_duration"))) \
 .withColumn("trip_distance", when(col("trip_distance") > 50, 50).otherwise(col("trip_distance")))

# Vérification du nombre d'enregistrements après nettoyage
logging.info("=== CLEANED DATA COUNTS ===")
logging.info(f"Cleaned Yellow Taxi Records: {yellow_df_clean.count():,}")
logging.info(f"Cleaned Green Taxi Records: {green_df_clean.count():,}")
logging.info(f"Cleaned FHV Records: {fhv_df_clean.count():,}")
logging.info(f"Cleaned High Volume FHV Records: {fhvhv_df_clean.count():,}")
Étapes clés du nettoyage :
- Suppression des enregistrements invalides : datetimes nulles, distances nulles, nombres de passagers négatifs
- Standardisation des colonnes : création cohérente de
pickup_datetime, trip_duration, pickup_hour, day_of_week, et PULocationID
- Gestion des différences de schéma : cast de
PULocationID en double pour les datasets FHV, renommage de trip_miles en trip_distance pour High Volume FHV
- Plafonnement des valeurs aberrantes : limitation des durées de trajet à 1 heure (3600 secondes) et des distances à 50 miles pour réduire l'impact des valeurs extrêmes
- Filtrage des cas limites : suppression des trajets de moins de 60 secondes ou de distances inférieures à 0,1 mile
Étape 4 : contexte géographique via les jointures avec les zones de taxi
Nous joignons chaque dataset nettoyé avec la table Taxi Zone Lookup pour ajouter les informations d'arrondissement et de zone en vue de l'analyse géographique.
# Jointure de tous les datasets avec les zones de taxi pour le contexte du lieu de prise en charge
yellow_df_clean = yellow_df_clean.join(taxi_zones_df, yellow_df_clean.PULocationID == taxi_zones_df.LocationID, "left") \
    .withColumnRenamed("Borough", "pickup_borough") \
    .withColumnRenamed("Zone", "pickup_zone") \
    .drop("LocationID")

green_df_clean = green_df_clean.join(taxi_zones_df, green_df_clean.PULocationID == taxi_zones_df.LocationID, "left") \
    .withColumnRenamed("Borough", "pickup_borough") \
    .withColumnRenamed("Zone", "pickup_zone") \
    .drop("LocationID")

fhv_df_clean = fhv_df_clean.join(taxi_zones_df, fhv_df_clean.PULocationID == taxi_zones_df.LocationID, "left") \
    .withColumnRenamed("Borough", "pickup_borough") \
    .withColumnRenamed("Zone", "pickup_zone") \
    .drop("LocationID")

fhvhv_df_clean = fhvhv_df_clean.join(taxi_zones_df, fhvhv_df_clean.PULocationID == taxi_zones_df.LocationID, "left") \
    .withColumnRenamed("Borough", "pickup_borough") \
    .withColumnRenamed("Zone", "pickup_zone") \
    .drop("LocationID")

# Filtrage des enregistrements avec des informations géographiques invalides ou inconnues
yellow_df_clean = yellow_df_clean.filter(
    (col("pickup_zone") != "Unknown") &
    (col("pickup_borough") != "Unknown") &
    (col("pickup_borough") != "N/A") &
    (col("pickup_borough").isNotNull())
)

green_df_clean = green_df_clean.filter(
    (col("pickup_zone") != "Unknown") &
    (col("pickup_borough") != "Unknown") &
    (col("pickup_borough") != "N/A") &
    (col("pickup_borough").isNotNull())
)

fhv_df_clean = fhv_df_clean.filter(
    (col("pickup_zone") != "Unknown") &
    (col("pickup_borough") != "Unknown") &
    (col("pickup_borough") != "N/A") &
    (col("pickup_borough").isNotNull())
)

fhvhv_df_clean = fhvhv_df_clean.filter(
    (col("pickup_zone") != "Unknown") &
    (col("pickup_borough") != "Unknown") &
    (col("pickup_borough") != "N/A") &
    (col("pickup_borough").isNotNull())
)

# Vérification du nombre final d'enregistrements après filtrage géographique
logging.info("=== FINAL CLEANED DATA COUNTS ===")
logging.info(f"Final Yellow Taxi Records: {yellow_df_clean.count():,}")
logging.info(f"Final Green Taxi Records: {green_df_clean.count():,}")
logging.info(f"Final FHV Records: {fhv_df_clean.count():,}")
logging.info(f"Final High Volume FHV Records: {fhvhv_df_clean.count():,}")
Pourquoi le contexte géographique est important :
- Analyse de marché : comprendre quels arrondissements chaque service dessert principalement
- Enseignements opérationnels : identifier les zones à forte demande pour l'allocation des ressources
- Analyse concurrentielle : comparer la pénétration des services selon les différentes zones
- Urbanisme : soutenir les décisions relatives aux infrastructures de transport
Étape 5 : analyse exploratoire comparative des données
Nous réalisons maintenant une analyse comparative complète des quatre modes de transport afin d'identifier les schémas d'usage, les parts de marché, et les caractéristiques opérationnelles.
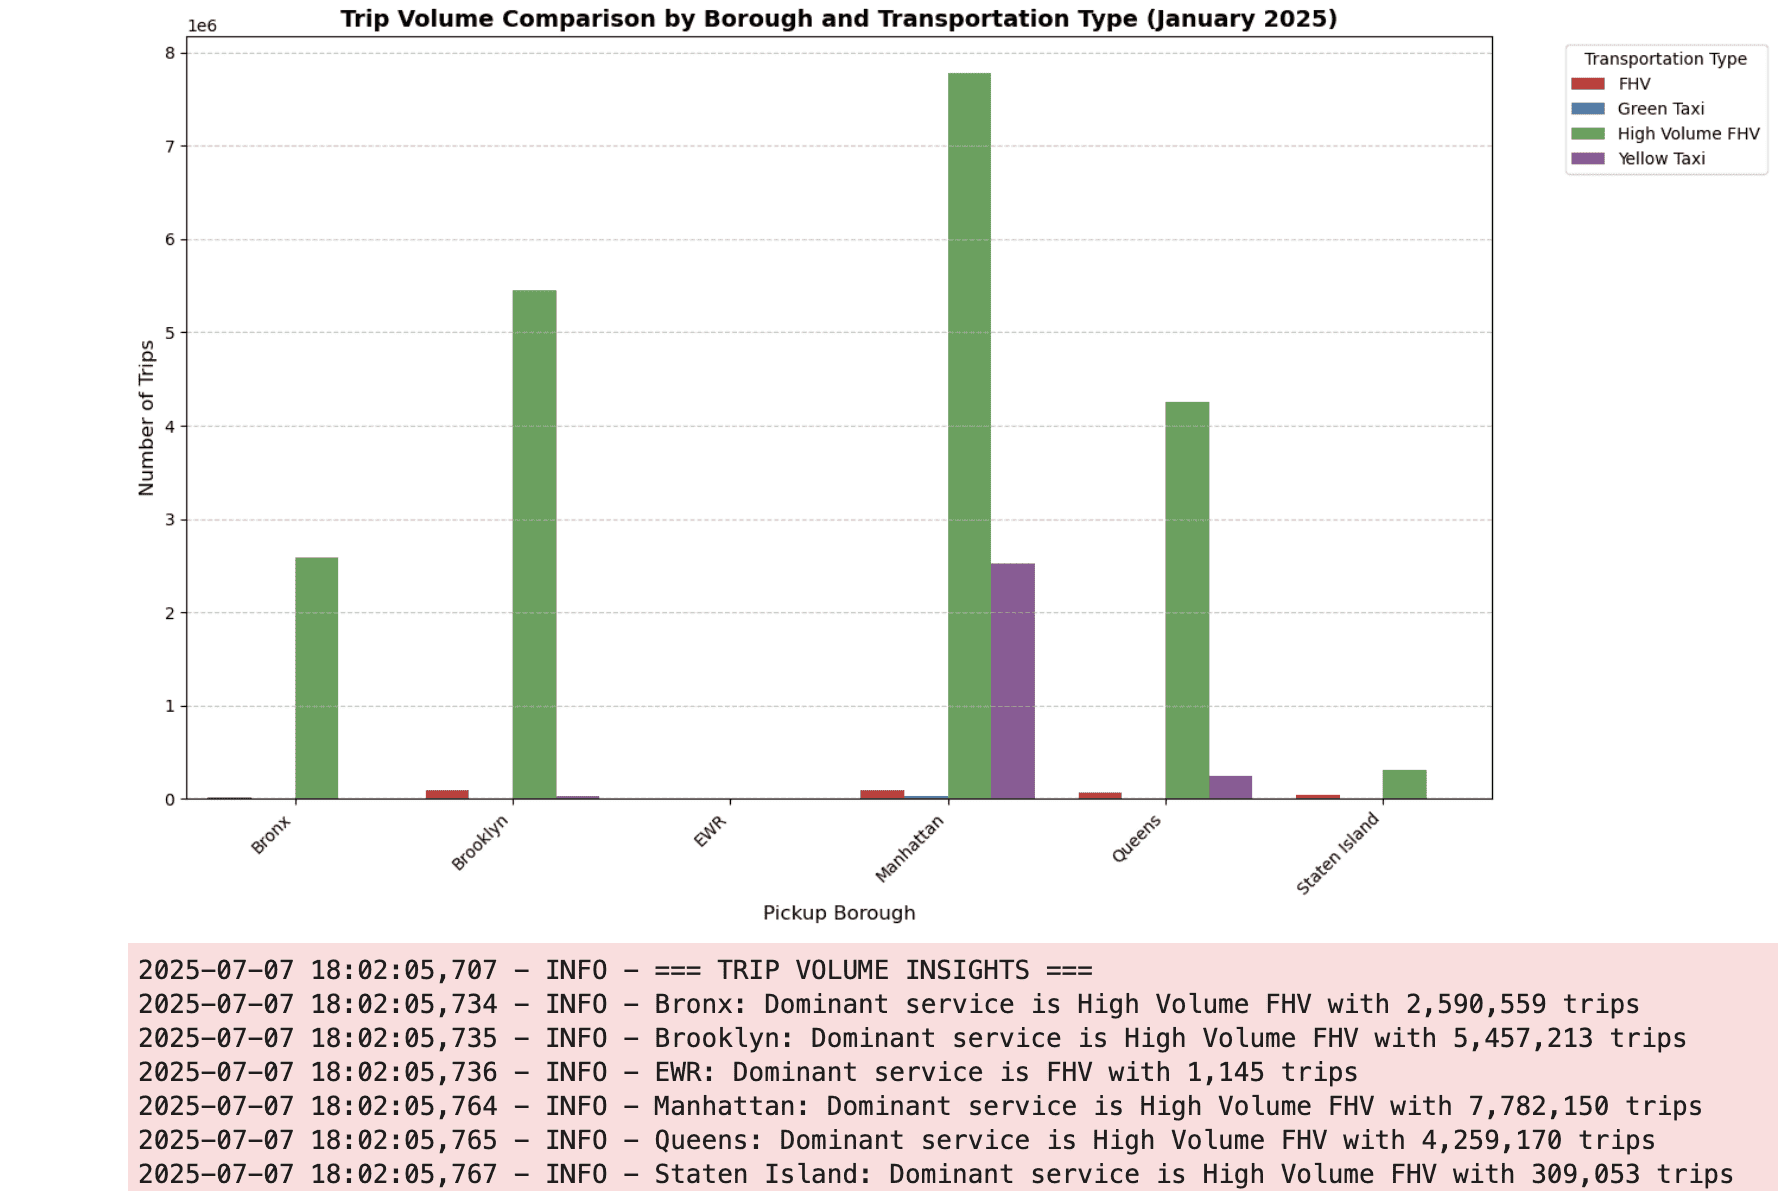
Analyse 1 : comparaison du volume de trajets par arrondissement
# Ajout d'un identifiant trip_type à chaque dataset
yellow_df_clean = yellow_df_clean.withColumn("trip_type", lit("Yellow Taxi"))
green_df_clean = green_df_clean.withColumn("trip_type", lit("Green Taxi"))
fhv_df_clean = fhv_df_clean.withColumn("trip_type", lit("FHV"))
fhvhv_df_clean = fhvhv_df_clean.withColumn("trip_type", lit("High Volume FHV"))

# Création d'un dataset unifié pour l'analyse comparative
# Remarque : trip_distance est exclu car le dataset FHV n'a pas ce champ
combined_df = yellow_df_clean.select("pickup_borough", "trip_duration", "pickup_hour", "day_of_week", "pickup_zone", "trip_type") \
    .union(green_df_clean.select("pickup_borough", "trip_duration", "pickup_hour", "day_of_week", "pickup_zone", "trip_type")) \
    .union(fhv_df_clean.select("pickup_borough", "trip_duration", "pickup_hour", "day_of_week", "pickup_zone", "trip_type")) \
    .union(fhvhv_df_clean.select("pickup_borough", "trip_duration", "pickup_hour", "day_of_week", "pickup_zone", "trip_type"))

# Calcul du volume de trajets par arrondissement et par type de taxi
trip_volume_by_borough = combined_df.groupBy("trip_type", "pickup_borough") \
    .agg(count("*").alias("num_trips")) \
    .orderBy("pickup_borough", "trip_type")

# Conversion en Pandas pour la visualisation
trip_volume_by_bpd = trip_volume_by_borough.toPandas()

# Création d'une visualisation complète
plt.figure(figsize=(14, 8))
sns.barplot(data=trip_volume_by_bpd, x="pickup_borough", y="num_trips", hue="trip_type", palette="Set1")
plt.xlabel("Pickup Borough", fontsize=12)
plt.ylabel("Number of Trips", fontsize=12)
plt.title("Trip Volume Comparison by Borough and Transportation Type (January 2025)", fontsize=14, fontweight='bold')
plt.xticks(rotation=45, ha='right')
plt.legend(title="Transportation Type", bbox_to_anchor=(1.05, 1), loc='upper left')
plt.grid(axis='y', linestyle='--', alpha=0.7)
plt.tight_layout()
plt.show()

# Enregistrement des principaux enseignements
logging.info("=== TRIP VOLUME INSIGHTS ===")
for borough in trip_volume_by_bpd["pickup_borough"].unique():
    borough_data = trip_volume_by_bpd[trip_volume_by_bpd["pickup_borough"] == borough]
    dominant_service = borough_data.loc[borough_data["num_trips"].idxmax()]
    logging.info(f"{borough}: Dominant service is {dominant_service['trip_type']} with {dominant_service['num_trips']:,} trips")
Analyse 2 : comparaison de la durée moyenne des trajets
# Calcul de la durée moyenne des trajets par type de transport
duration_by_type = combined_df.groupBy("trip_type") \
    .agg(avg("trip_duration").alias("avg_duration_seconds")) \
    .orderBy("avg_duration_seconds", ascending=False)

# Conversion en Pandas et ajout de la colonne minutes
duration_by_type_pd = duration_by_type.toPandas()
duration_by_type_pd["avg_duration_minutes"] = duration_by_type_pd["avg_duration_seconds"] / 60

# Création de la visualisation
plt.figure(figsize=(12, 6))
bars = plt.bar(duration_by_type_pd["trip_type"], duration_by_type_pd["avg_duration_minutes"],
               color=['#FF6B6B', '#4ECDC4', '#45B7D1', '#96CEB4'])
plt.xlabel("Transportation Type", fontsize=12)
plt.ylabel("Average Trip Duration (Minutes)", fontsize=12)
plt.title("Average Trip Duration by Transportation Type (January 2025)", fontsize=14, fontweight='bold')
plt.xticks(rotation=45, ha='right')
plt.grid(axis='y', linestyle='--', alpha=0.7)

# Ajout des étiquettes de valeur sur les barres
for bar, value in zip(bars, duration_by_type_pd["avg_duration_minutes"]):
    plt.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 0.2,
             f'{value:.1f}', ha='center', va='bottom', fontweight='bold')

plt.tight_layout()
plt.show()

# Enregistrement des enseignements sur la durée
logging.info("=== TRIP DURATION INSIGHTS ===")
for _, row in duration_by_type_pd.iterrows():
    logging.info(f"{row['trip_type']}: Average duration {row['avg_duration_minutes']:.1f} minutes")
Analyse 3 : principales zones de prise en charge par type de transport
# Calcul des principales zones de prise en charge pour chaque type de transport
zone_trips_by_type = combined_df.groupBy("trip_type", "pickup_zone") \
    .agg(count("*").alias("num_trips")) \
    .orderBy("trip_type", "num_trips", ascending=[True, False])

# Sélection des 5 principales zones par type de transport à l'aide d'une window function
windowSpec = Window.partitionBy("trip_type").orderBy(col("num_trips").desc())
zone_trips_top5 = zone_trips_by_type.withColumn("rank", row_number().over(windowSpec)) \
    .filter(col("rank") <= 5) \
    .drop("rank")

# Conversion en Pandas pour la visualisation
zone_trips_top5_pd = zone_trips_top5.toPandas()

# Création d'une visualisation complète
plt.figure(figsize=(16, 10))
sns.barplot(data=zone_trips_top5_pd, x="num_trips", y="pickup_zone", hue="trip_type", palette="Set3")
plt.xlabel("Number of Trips", fontsize=12)
plt.ylabel("Pickup Zone", fontsize=12)
plt.title("Top 5 Pickup Zones by Transportation Type (January 2025)", fontsize=14, fontweight='bold')
plt.legend(title="Transportation Type", bbox_to_anchor=(1.05, 1), loc='upper left')
plt.grid(axis='x', linestyle='--', alpha=0.7)
plt.tight_layout()
plt.show()

# Enregistrement des principales zones pour chaque service
logging.info("=== TOP PICKUP ZONES ===")
for trip_type in zone_trips_top5_pd["trip_type"].unique():
    top_zones = zone_trips_top5_pd[zone_trips_top5_pd["trip_type"] == trip_type].head(3)
    logging.info(f"\n{trip_type} - Top 3 zones:")
    for _, zone in top_zones.iterrows():
        logging.info(f"  {zone['pickup_zone']}: {zone['num_trips']:,} trips")
Analyse 4 : schémas d'usage horaire
# Analyse des schémas d'usage horaire par type de transport
hourly_usage = combined_df.groupBy("trip_type", "pickup_hour") \
    .agg(count("*").alias("num_trips")) \
    .orderBy("trip_type", "pickup_hour")

# Conversion en Pandas
hourly_usage_pd = hourly_usage.toPandas()

# Création d'un graphique en ligne montrant les schémas horaires
plt.figure(figsize=(14, 8))
for trip_type in hourly_usage_pd["trip_type"].unique():
    data = hourly_usage_pd[hourly_usage_pd["trip_type"] == trip_type]
    plt.plot(data["pickup_hour"], data["num_trips"], marker='o', linewidth=2, label=trip_type)

plt.xlabel("Hour of Day", fontsize=12)
plt.ylabel("Number of Trips", fontsize=12)
plt.title("Hourly Usage Patterns by Transportation Type (January 2025)", fontsize=14, fontweight='bold')
plt.legend(title="Transportation Type")
plt.grid(True, linestyle='--', alpha=0.7)
plt.xticks(range(0, 24))
plt.tight_layout()
plt.show()

# Identification des heures de pointe pour chaque service
logging.info("=== PEAK HOUR ANALYSIS ===")
for trip_type in hourly_usage_pd["trip_type"].unique():
    data = hourly_usage_pd[hourly_usage_pd["trip_type"] == trip_type]
    peak_hour = data.loc[data["num_trips"].idxmax()]
    logging.info(f"{trip_type}: Peak hour is {peak_hour['pickup_hour']}:00 with {peak_hour['num_trips']:,} trips")
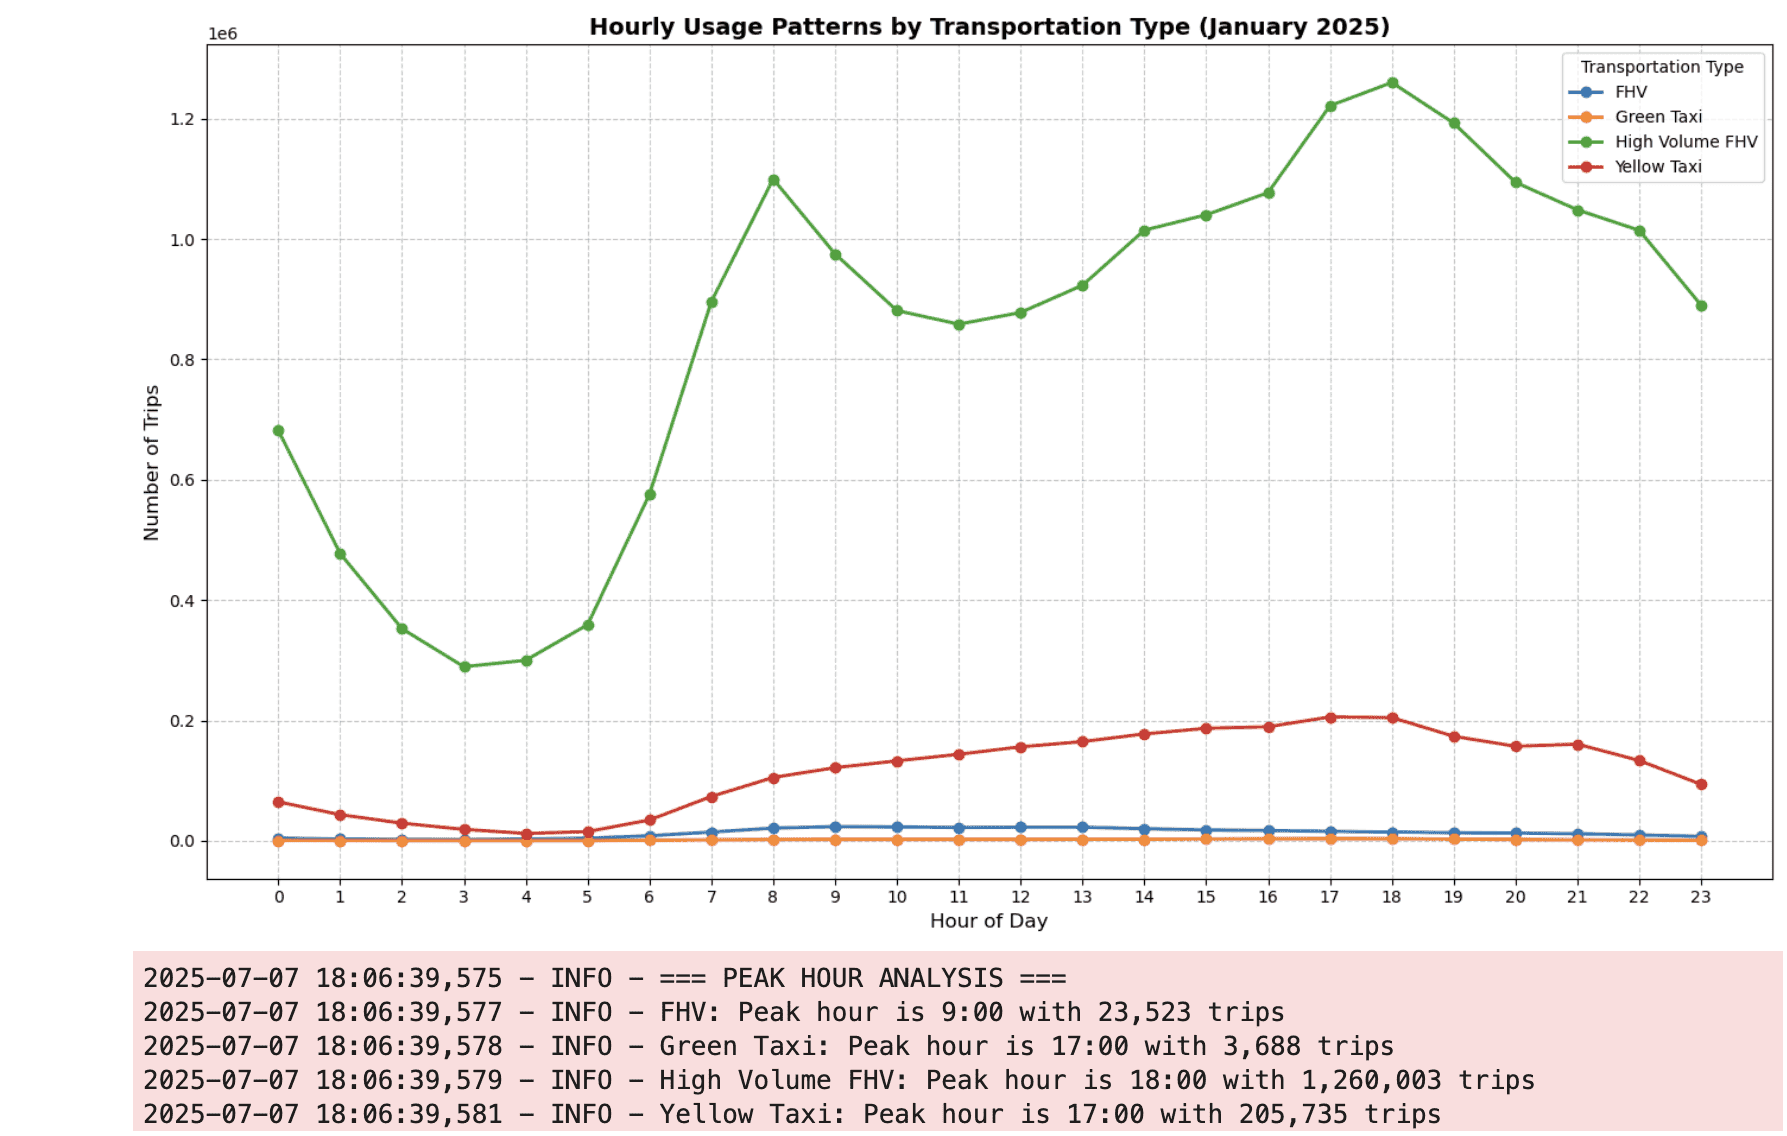
Principaux résultats et enseignements
Analyse des parts de marché
Domination de Manhattan :
- Yellow Taxis : maintiennent une forte présence à Manhattan, en particulier dans les zones de Midtown
- High Volume FHV : pénétration de marché significative dans tous les arrondissements, avec les volumes absolus les plus élevés
Schémas des arrondissements périphériques :
- Green Taxis : concentrés à Brooklyn et Queens comme prévu par la réglementation
- Services FHV : fournissent une connectivité importante vers les zones moins desservies par les taxis traditionnels
Caractéristiques des services
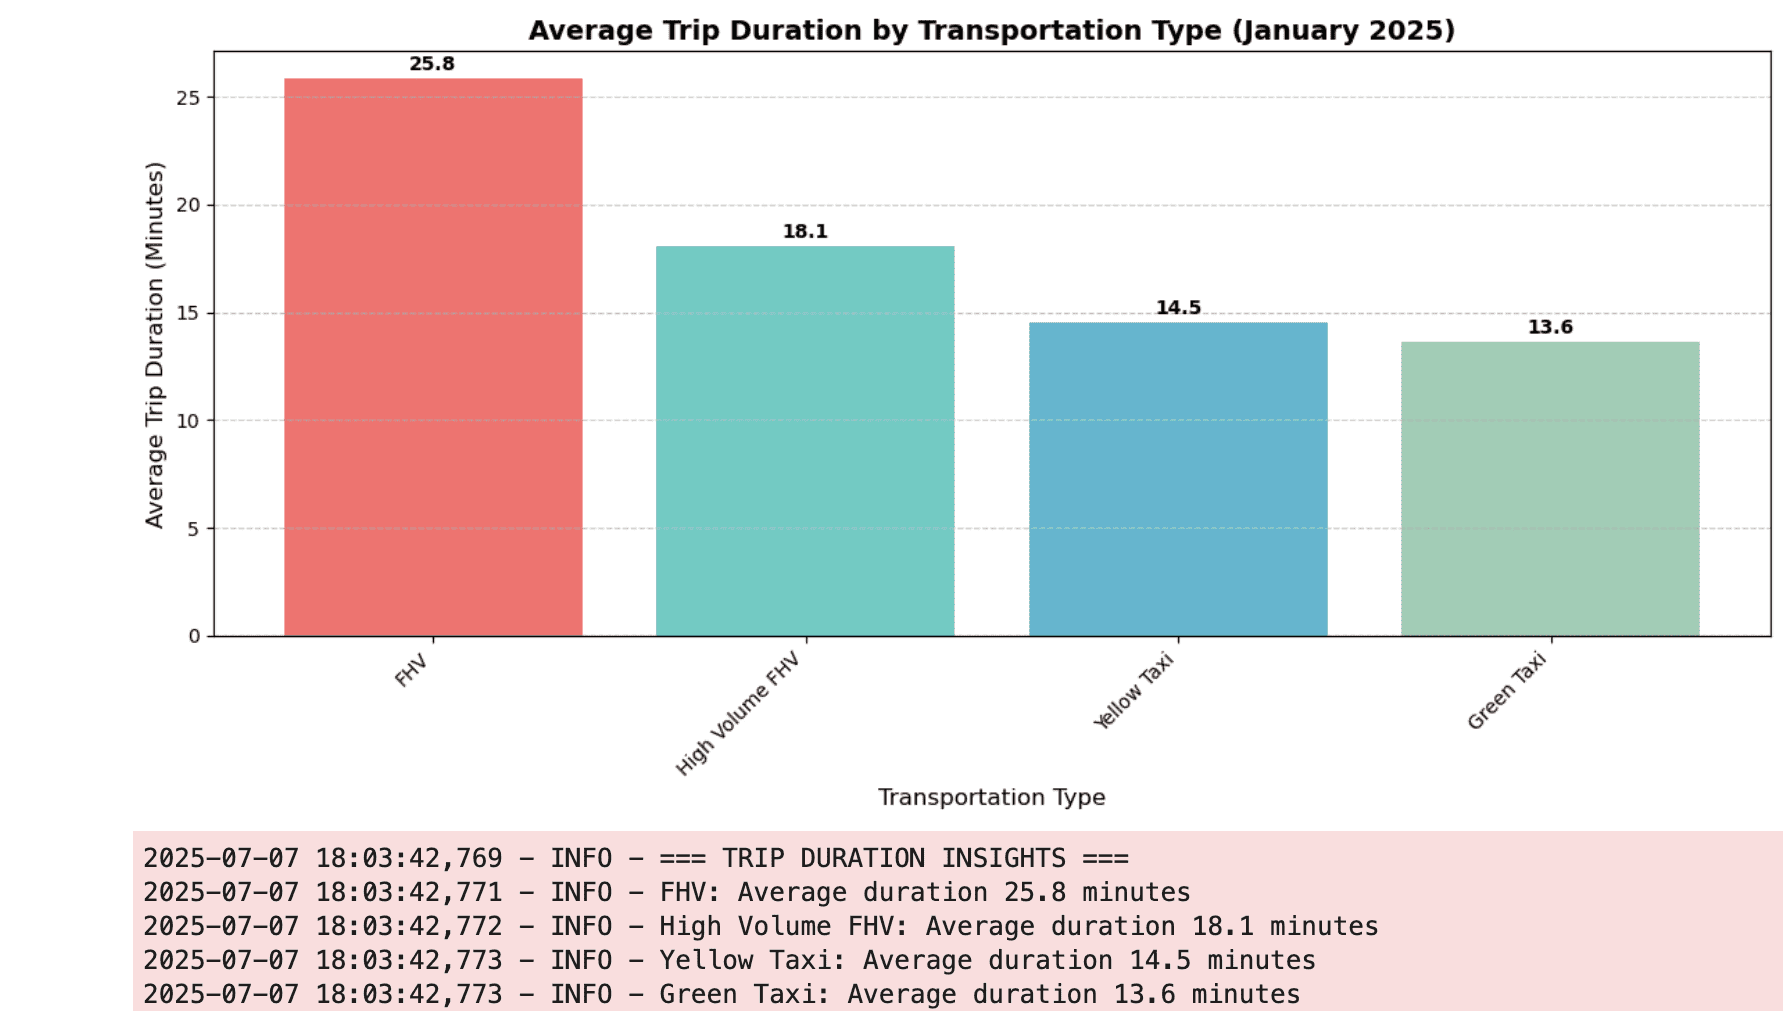
Schémas de durée de trajet :
- Le plus court : les Green Taxis (optimisés pour les trajets locaux dans les arrondissements périphériques)
- Le plus long : les services FHV (incluent souvent des trajets vers l'aéroport et des trajets longue distance)
- Moyen : les Yellow Taxis et High Volume FHV (mix équilibré de types de trajets)
Heures de pointe d'usage :
- Pointe du matin : 8h-9h pour tous les services
- Pointe du soir : 18h-19h avec des variations selon le type de service
- Nuit tardive : High Volume FHV maintient une présence plus forte que les taxis traditionnels
Enseignements géographiques
Zones à forte demande :
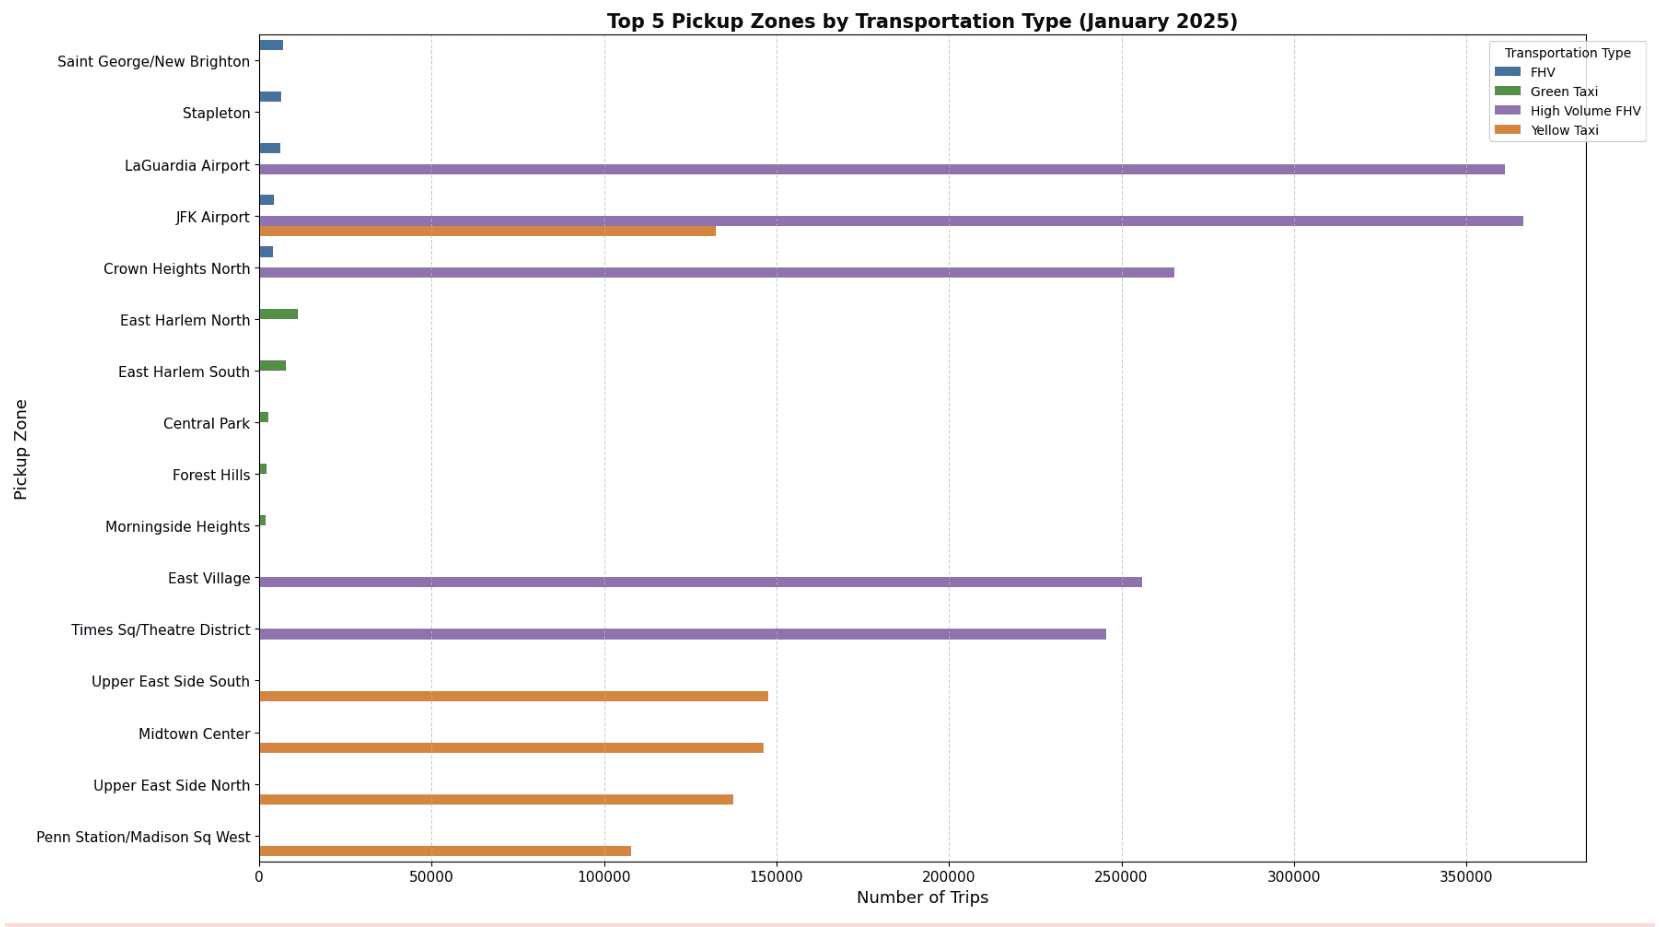
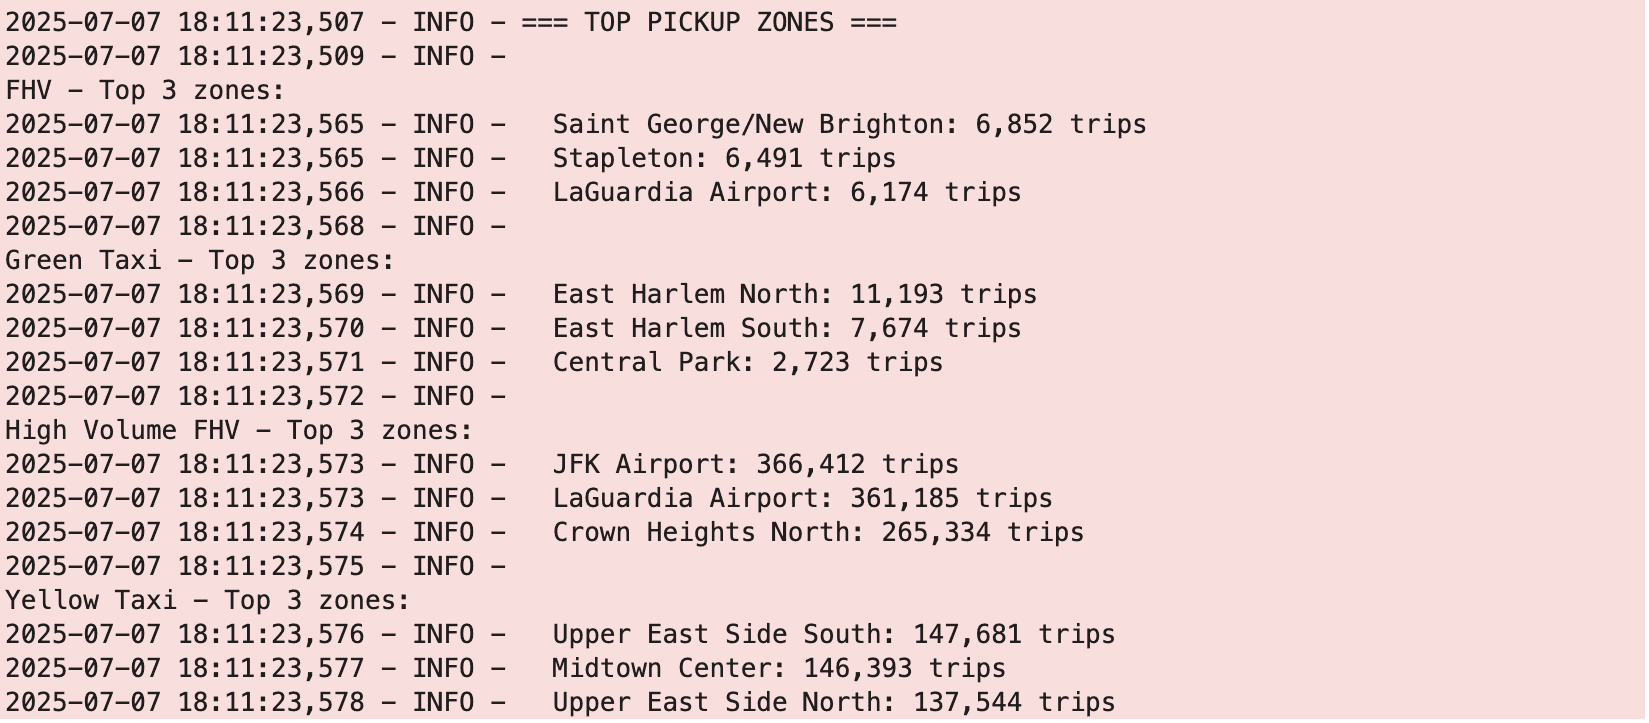
- Accès aéroport : JFK et LaGuardia dominent les zones de prise en charge FHV
- Pôles de transit : Penn Station, Grand Central sont proéminents pour tous les services
- Quartiers d'affaires : Midtown Manhattan reste essentiel pour les Yellow Taxis
Conclusion
Cette analyse comparative révèle des schémas d'usage et un positionnement de marché distincts au sein de l'écosystème de transport de New York. Les services High Volume FHV dominent en volume pur, tandis que les Yellow Taxis conservent leur bastion traditionnel à Manhattan. Les Green Taxis desservent avec succès les marchés des arrondissements périphériques, et les services FHV assurent une connectivité essentielle pour les trajets plus longs et l'accès aux aéroports.
Cette analyse démontre comment les différents modes de transport se complètent, en desservant des zones géographiques, des motifs de trajet, et des schémas temporels distincts. Ces enseignements sont précieux pour :
- Les urbanistes : comprendre les schémas de demande de transport
- Les opérateurs de service : optimiser le déploiement de la flotte et les stratégies tarifaires
- Les décideurs publics : évaluer l'efficacité des réglementations de transport
- Les chercheurs : analyser l'évolution de la mobilité urbaine
L'approche basée sur PySpark montre comment des données de transport à grande échelle peuvent être traitées et analysées efficacement pour extraire des enseignements pertinents pour une prise de décision fondée sur les données dans la planification du transport urbain.
Étapes suivantes
Pour approfondir cette analyse, envisagez :
- Analyse temporelle : comparer les schémas selon différents mois ou saisons
- Prévision de la demande : construire des modèles prédictifs pour le volume de trajets par zone et par heure
- Analyse de réseau : examiner les schémas origine-destination et les dynamiques de flux
- Analyse économique : intégrer les données de tarifs et de revenus pour des enseignements financiers
- Impact météo : analyser comment les conditions météorologiques affectent les différents modes de transport
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.
