
AI Deploy - Tutoriel - Déployer LLaMA 2 dans une application Streamlit
Comment construire et déployer un chatbot avec LLaMA 2 et Streamlit
Le 18 juillet 2023, Meta a publié LLaMA 2, la dernière version de son grand modèle de langage (LLM) open source.
Entraîné entre janvier 2023 et juillet 2023 sur 2 000 milliards de tokens, LLaMA 2 surpasse d’autres LLM sur de nombreux benchmarks, notamment en matière de raisonnement, de codage, de maîtrise linguistique et de tests de connaissances. Cette version se décline en plusieurs formats, avec des tailles de paramètres de 7B, 13B, et un impressionnant 70B. Les modèles sont destinés à un usage gratuit, à la fois commercial et de recherche, en anglais.
Objectif
L’objectif de ce tutoriel est de vous montrer comment déployer LLaMA 2 dans une application, permettant d’interagir avec le modèle depuis une interface, telle que ChatGPT. Déployer votre app vous permettra de bénéficier de ressources très puissantes qui rendront votre application de chatbot extrêmement rapide. Elle peut également être facilement partagée, contrairement à une application locale.
Pour cela, nous utiliserons Streamlit, un framework Python qui transforme des scripts en application web partageable. Vous apprendrez également à construire et utiliser une image Docker personnalisée pour une application Streamlit.
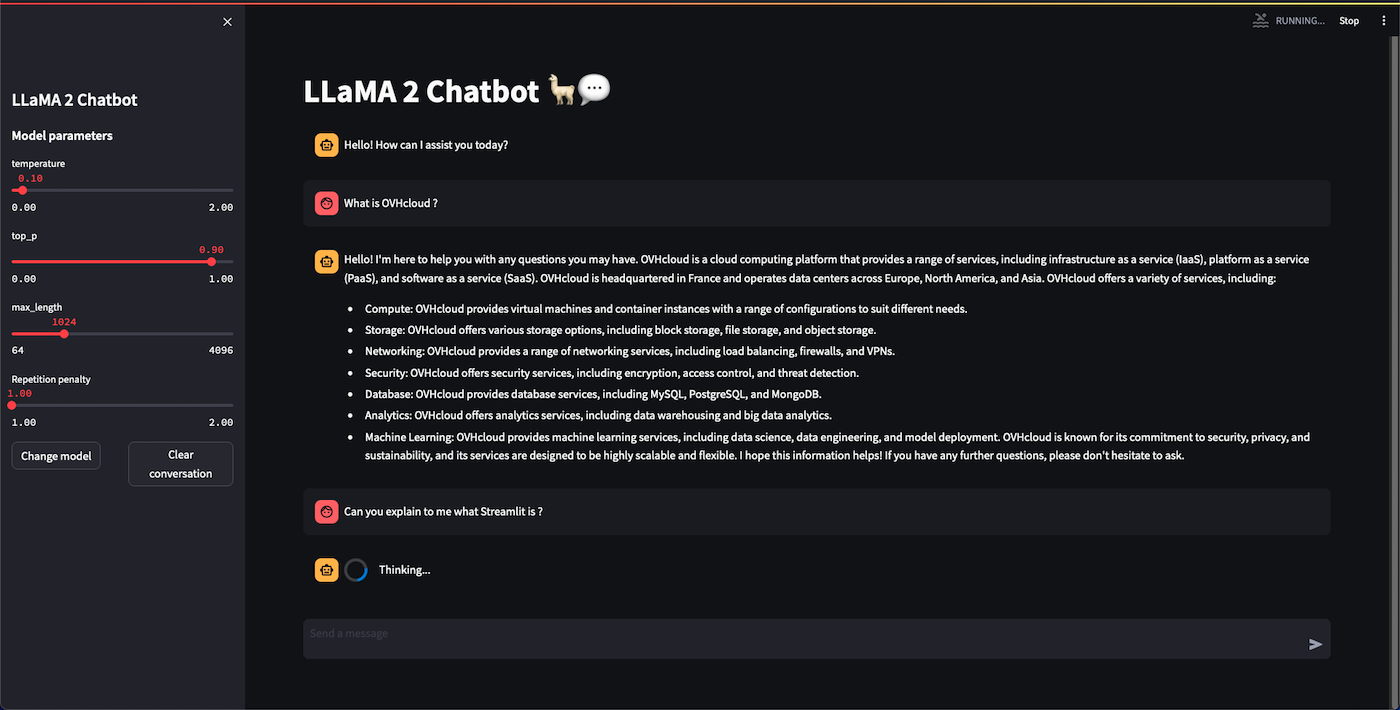
Voici un aperçu de notre app de segmentation d’image :
Prérequis
Pour déployer votre app, vous avez besoin de :
- Un projet AI Deploy créé au sein d’un projet Public Cloud dans votre compte OVHcloud
- Un utilisateur pour AI Deploy
- La CLI AI d’OVHcloud installée sur votre ordinateur local
- Docker installé sur votre ordinateur local, ou un accès à une instance Docker Debian, disponible sur le .
- Quelques connaissances sur la construction d’image et de Dockerfile
- Le code complet de l’application, disponible sur ce dépôt GitHub, que nous vous conseillons de cloner.
- Un accès aux modèles Llama 2. Pour obtenir Llama 2, vous devrez :
- Remplir le formulaire de Meta pour demander l’accès à la dernière version de Llama. En effet, l’utilisation de Llama 2 est régie par la licence Meta, que vous devez accepter pour pouvoir télécharger les poids du modèle et le tokenizer.
- Disposer d’un compte Hugging Face (avec la même adresse e-mail que celle renseignée dans le formulaire de Meta).
- Disposer d’un token Hugging Face.
- Visiter la page de l’un des modèles LLaMA 2 disponibles (version 7B, 13B ou 70B), et accepter les conditions de licence et la politique d’utilisation acceptable de Hugging Face. Une fois acceptées, vous recevrez le message suivant : Your request to access this repo has been successfully submitted, and is pending a review from the repo's authors, qui devrait, quelques heures plus tard, devenir : You have been granted access to this model.
En pratique
Nous allons suivre différentes étapes pour déployer notre application de chatbot LLaMA 2 :
- Écrire le requirements.txt contenant les librairies requises devant être installées pour que notre application puisse fonctionner.
- Écrire le
Dockerfilecontenant toutes les commandes permettant de lancer notre application Streamlit LLaMA 2. - Construire l’image Docker à partir du Dockerfile.
- Envoyer l’image vers un registre.
- Déployer l’app.
Si vous avez cloné le dépôt de l’app, vous n’aurez pas besoin de réécrire les fichiers (requirements.txt et Dockerfile) puisque vous les avez déjà. Dans ce cas, vous pouvez passer directement à l’étape « Construire l’image Docker », même s’il est préférable de comprendre le processus global.
Écrire le fichier requirements.txt de l’application
Le fichier requirements.txt nous permettra d’indiquer tous les modules nécessaires au fonctionnement de notre application. Ce fichier sera utile lors de l’écriture du Dockerfile.
Placez ce fichier (ainsi que les suivants) dans le même répertoire que vos scripts python.
Écrire le Dockerfile de l’application
Un Dockerfile est un document texte contenant toutes les commandes qu’un utilisateur pourrait exécuter en ligne de commande pour construire une image.
Ce fichier doit commencer par l’instruction FROM, qui indique l’image parente à utiliser. Dans notre cas, nous choisissons de partir de l’image officielle python:3.10-slim :
Ensuite, définissez le répertoire d’accueil et ajoutez-y tous vos fichiers (scripts python, requirements.txt et le Dockerfile) grâce aux commandes suivantes :
Avec AI Deploy, workspace sera votre répertoire d’accueil.
Indiquons maintenant que nous devons installer le fichier requirements.txt qui contient nos modules Python nécessaires, à l’aide d’une commande pip install :
Donnez les droits d’accès corrects à l’utilisateur OVHcloud (42420:42420).
Enfin, définissez la commande permettant d’exécuter l’application Streamlit au lancement du container :
Construire l’image Docker depuis le Dockerfile
Depuis le répertoire contenant votre Dockerfile, exécutez l’une des commandes suivantes pour construire l’image de votre application :
-
La première commande construit l’image en utilisant l’architecture par défaut de votre système. Cela peut fonctionner si votre machine utilise déjà l’architecture
linux/amd64, requise pour exécuter des containers avec nos produits AI. Cependant, sur des systèmes avec une architecture différente (par exempleARM64surApple Silicon), l’image résultante ne sera pas compatible et ne pourra pas être déployée. -
La seconde commande cible explicitement l’architecture
linux/amd64afin de garantir la compatibilité avec nos services AI. Elle nécessitebuildx, qui n’est pas installé par défaut. Si vous n’avez jamais utilisébuildx, vous pouvez l’installer en exécutant :docker buildx install
L’argument point . indique que votre contexte de build (emplacement du Dockerfile et des autres fichiers nécessaires) est le répertoire courant.
L’argument -t vous permet de choisir l’identifiant à donner à votre image. Généralement, les identifiants d’image sont composés d’un nom et d’un tag de version <name>:<version>. Pour cet exemple, nous avons choisi llama_app:latest.
Tester en local (optionnel)
Lancez la commande Docker suivante pour exécuter l’application localement sur votre ordinateur :
Remarques
-
L’argument
-p 8501:8501indique que vous souhaitez rediriger le port 8501 de votre machine locale vers le port 8501 du container Docker. Le port 8501 est le port par défaut utilisé par les applications Streamlit. -
N’oubliez pas l’argument
--user=42420:42420si vous souhaitez simuler exactement le même comportement que celui qui se produira sur les apps AI Deploy. Il exécute le container Docker en tant qu’utilisateur OVHcloud spécifique (utilisateur 42420:42420).
Une fois démarrée, votre application devrait être disponible sur http://localhost:8501.
Envoyer l’image vers le registre partagé
Avertissement Le registre partagé ne doit être utilisé qu’à des fins de test. Pensez à créer et à rattacher votre propre registre. Plus d’informations à ce sujet sont disponibles ici. Les images envoyées vers ce registre sont réservées aux charges de travail AI Tools et ne seront pas accessibles pour des usages externes.
Trouvez l’adresse de votre registre partagé en lançant cette commande :
Connectez-vous à votre registre partagé avec vos identifiants habituels d’utilisateur de la plateforme AI :
Taguez l’image compilée et envoyez-la vers votre registre partagé :
Lancer l’app AI Deploy
La commande suivante démarre une nouvelle app exécutant votre application Streamlit LLaMA 2 :
Remarques
-
--default-http-port 8501indique que le port à atteindre sur l’URL de l’app est le8501. -
--gpu 1indique que nous demandons 1 GPU pour cette app. Nous recommandons d’utiliser au moins 1 GPU pour des performances correctes lors de l’utilisation de LLM. Gardez à l’esprit que plus votre modèle a de paramètres, plus il nécessitera de mémoire. Selon le modèle que vous souhaitez utiliser, l’utilisation de plusieurs GPU peut être essentielle. -
Pensez à ajouter l’attribut
--unsecure-httpsi vous souhaitez que votre application soit accessible sans authentification.
Aller plus loin
- Découvrez comment affiner LLaMA 2 sur votre propre jeu de données
- Créez un chatbot vocal avec Speech-to-Text
Pour une formation ou une assistance technique sur la mise en œuvre de nos solutions, contactez votre commercial ou consultez la page Professional Services pour obtenir un devis et faire analyser votre projet par nos experts.
Votre avis nous intéresse !
N’hésitez pas à nous faire part de vos questions, retours et suggestions pour améliorer le service :
- Sur le serveur Discord OVHcloud