
Action Load to Bucket
Vous pouvez choisir le format de fichier. Pour créer une nouvelle action, accédez à l'onglet Action du Data Processing Engine (DPE)
Objectif
L'action Load to Bucket extrait les données brutes des sources et les place dans un fichier dans le bucket de votre Projet. Vous pouvez choisir le format de fichier.
Note: Cette action prend en charge la fonctionnalité permettant d'avoir une date personnalisée dans le nom du dossier. Vous pouvez trouver le tutoriel ici.
Configurer une action Load to Bucket
Pour créer une nouvelle action, accédez à l'onglet Action du Data Processing Engine (DPE), cliquez sur Nouvelle action et sélectionnez l'action Load to Bucket.
Choisir une source et une destination
Pour configurer l'action, commencez par sélectionner une source dans la liste que vous avez déjà configurée dans l'onglet Sources des Connectors.
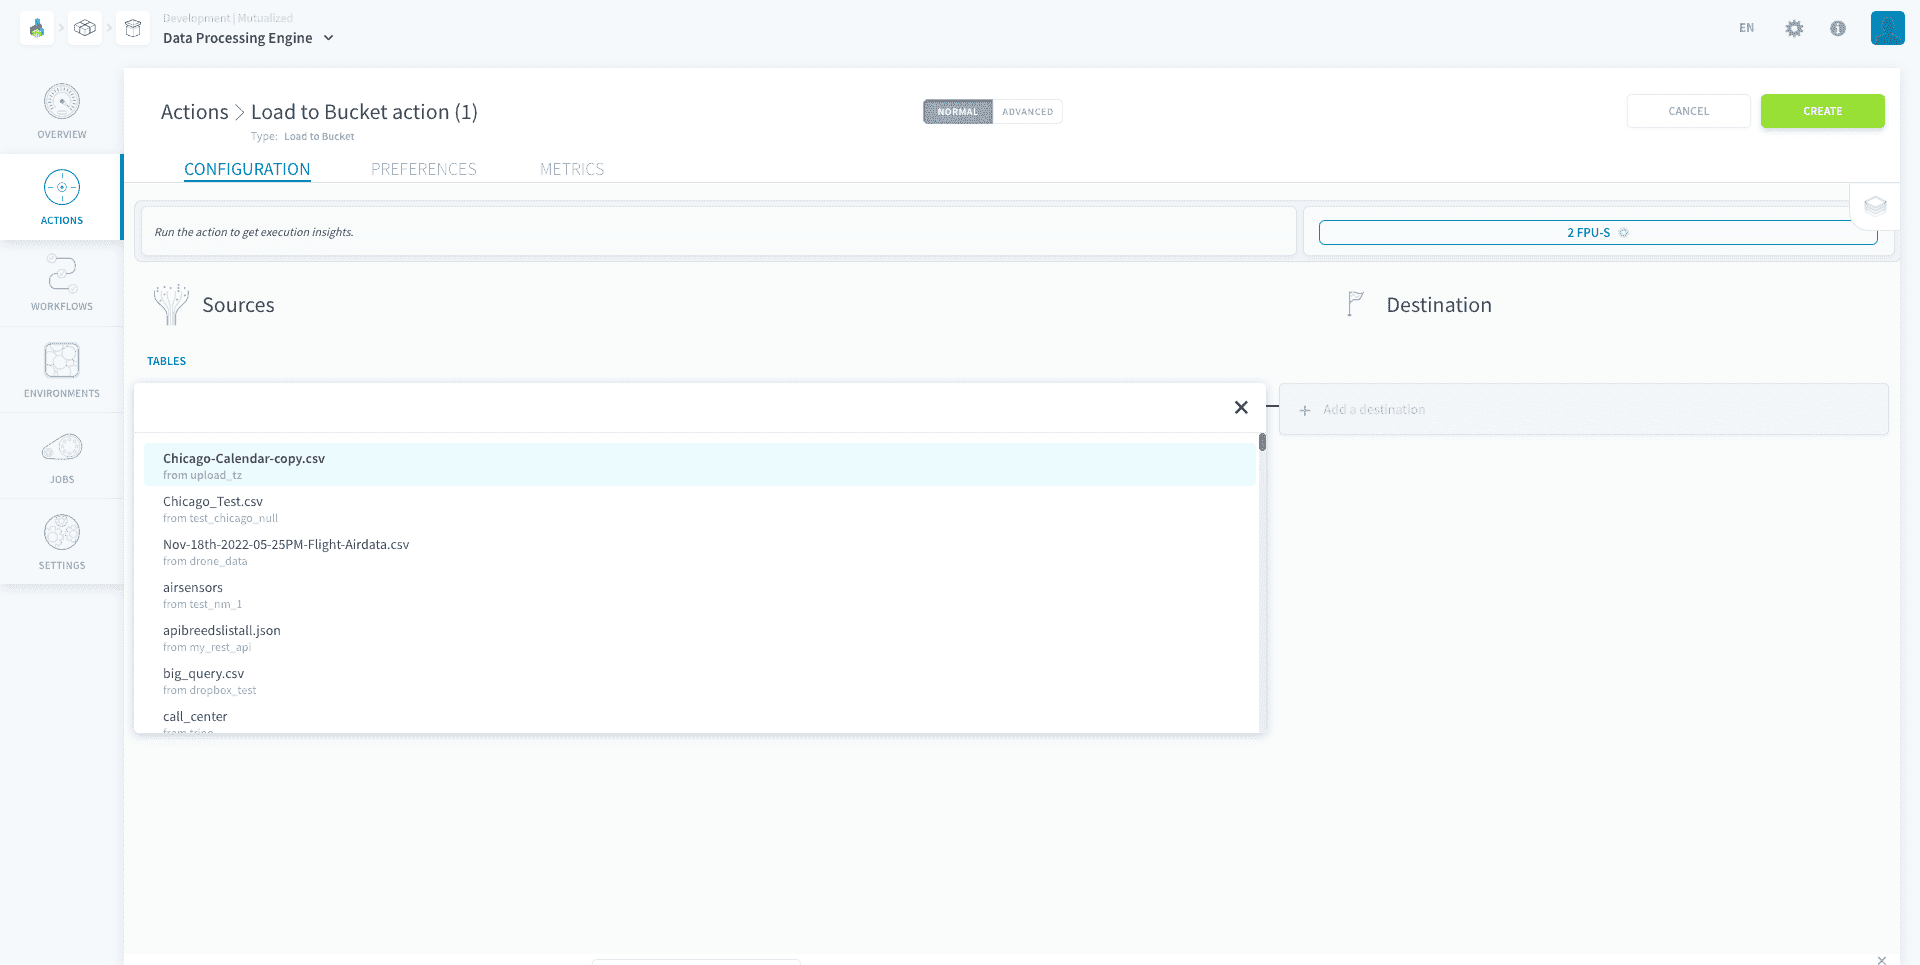
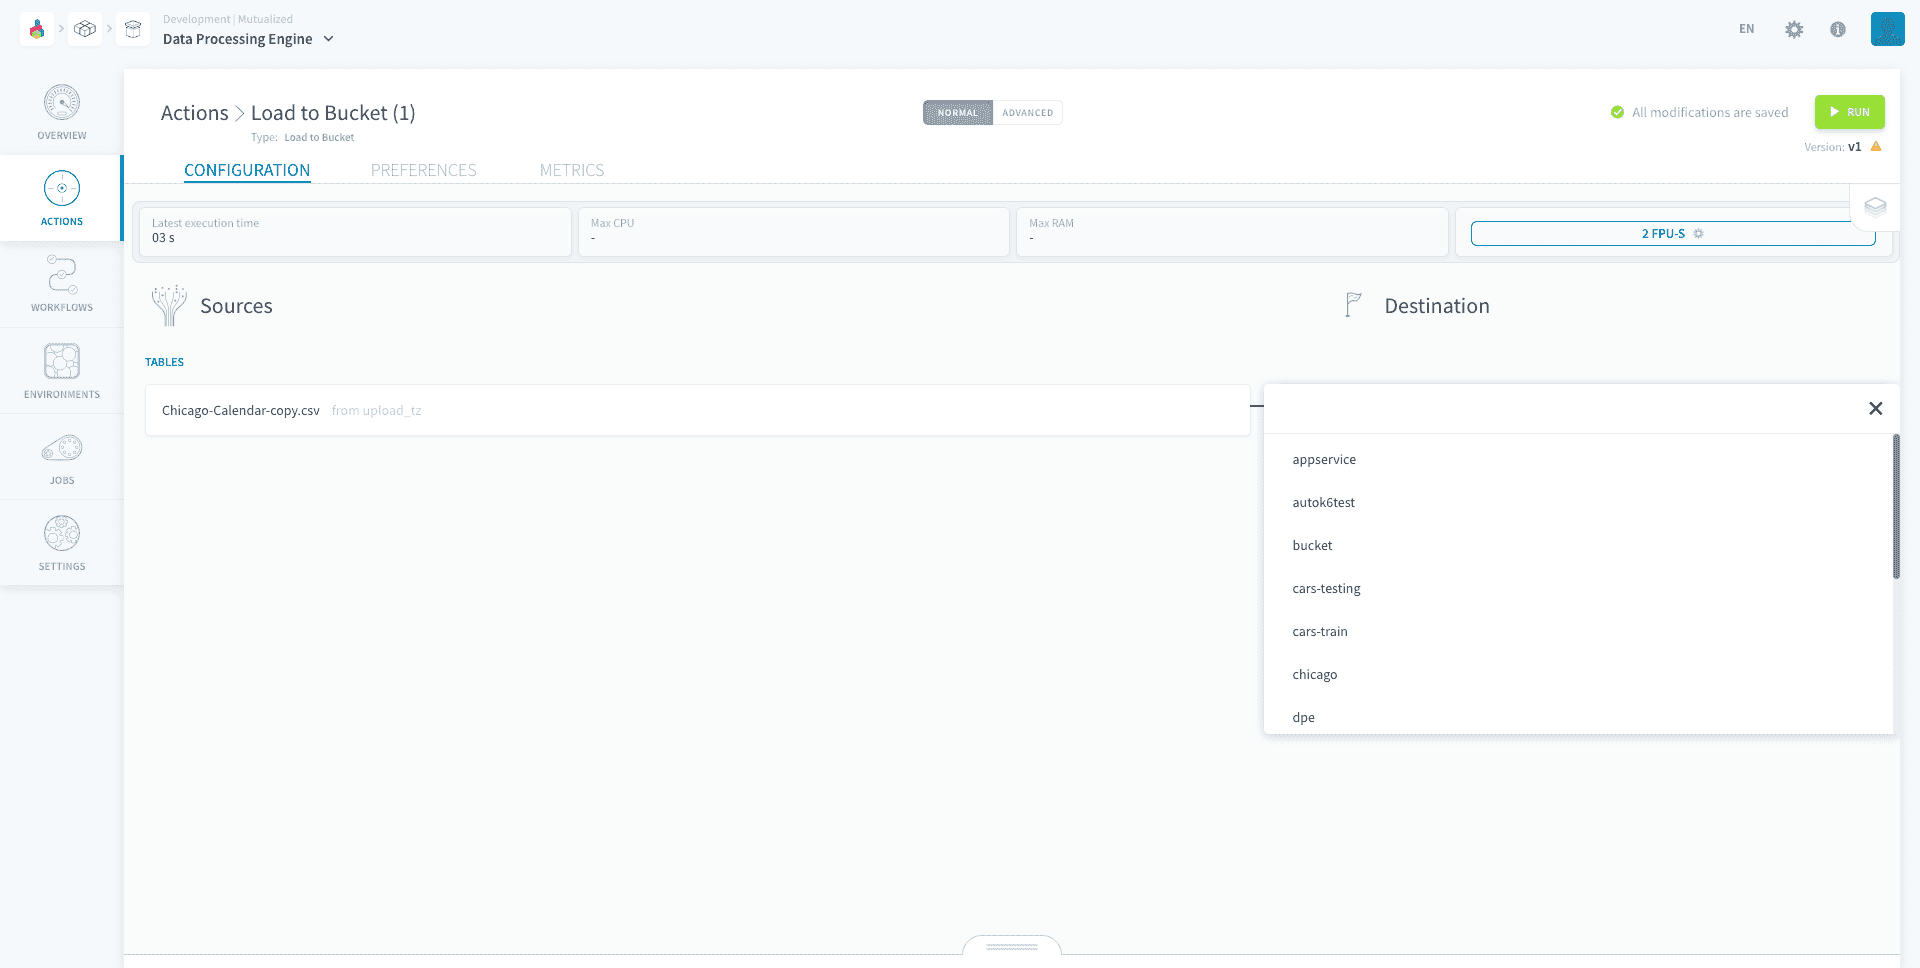
Ensuite, choisissez le bucket de destination dans la liste des buckets du Projet.
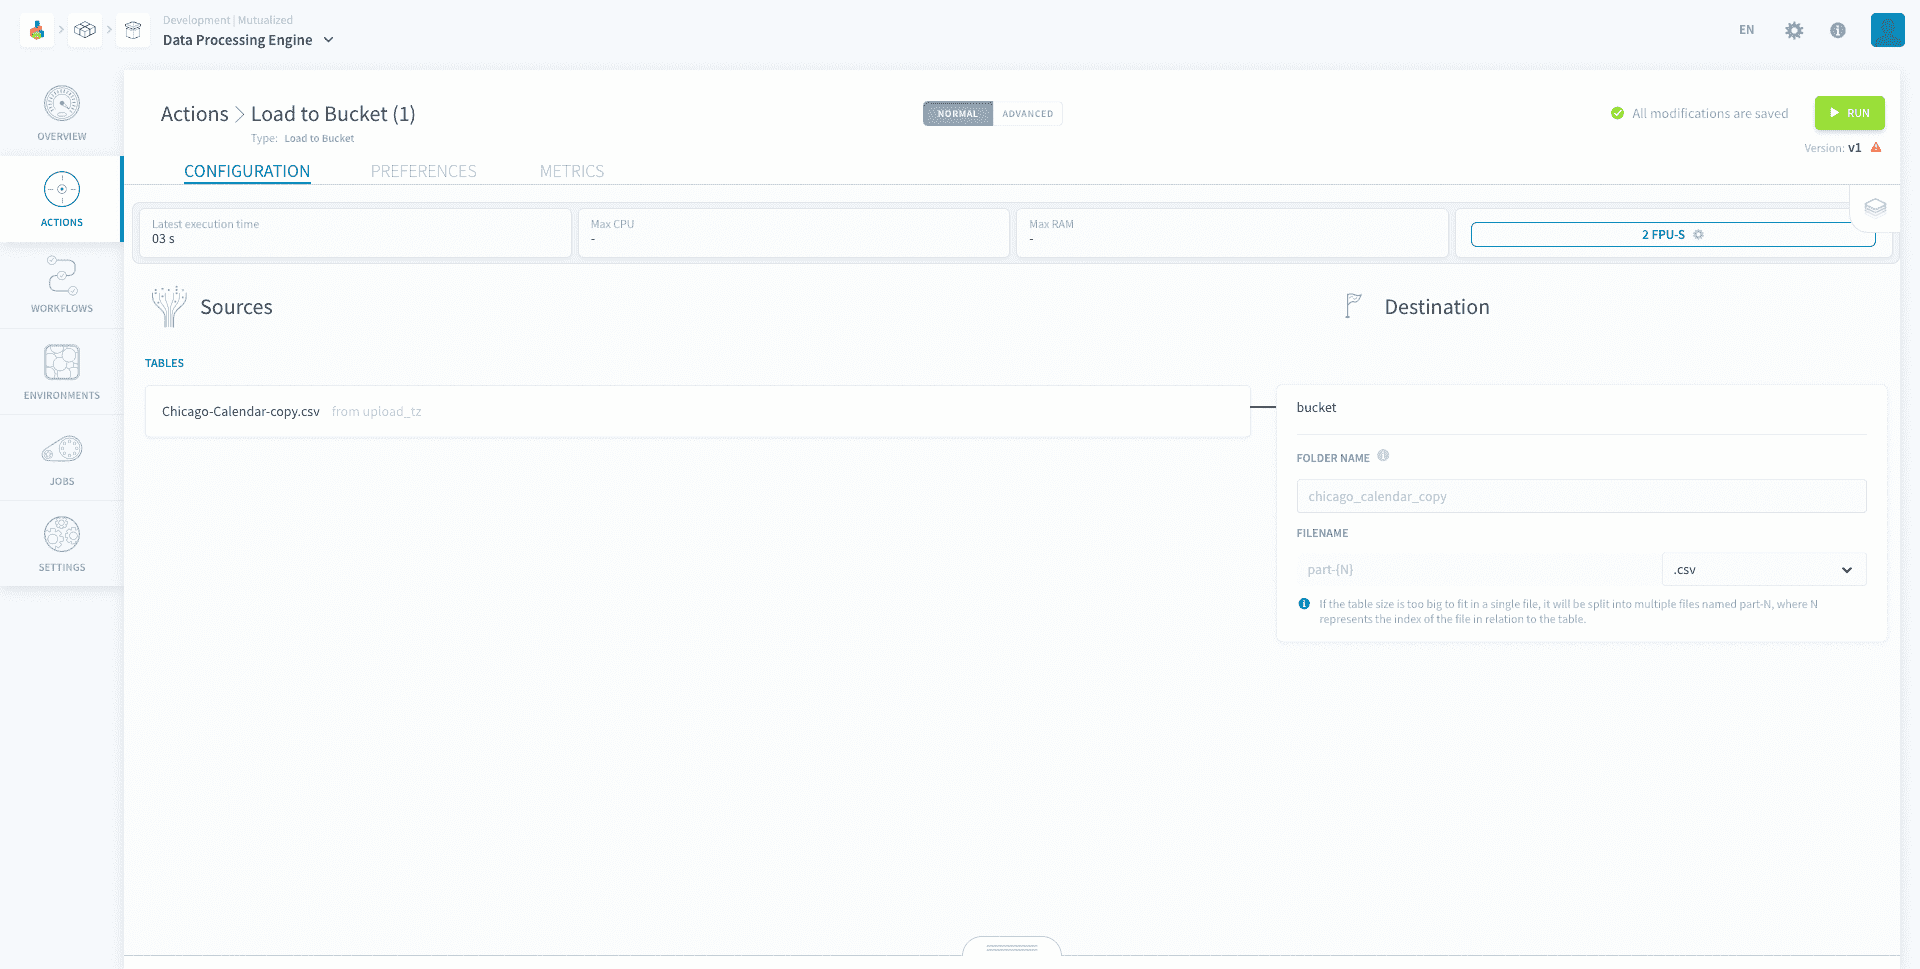
Il vous sera ensuite demandé de choisir le format de fichier et le dossier de destination. Si vous laissez le nom du dossier vide, il sera automatiquement nommé d'après le nom de la source.
Notez que les sources suivantes ne sont PAS prises en charge dans cette action : Azure Blob Storage, Data Store, Dropbox, FTP, Google Drive, HTTP Files, HTTP REST, One Drive, S31-compatible-storage, Amazon S3 et SFTP.
Si vous choisissez une source PostgreSQL, votre action bénéficiera de performances optimisées, à l'image de l'action PostgreSQL to Parquet.
Fichier de destination
Vos données seront placées dans le dossier de destination dans un fichier nommé part-1 avec le format que vous avez spécifié. Si votre fichier est trop volumineux, il sera divisé en plusieurs fichiers nommés part-1, part-2, part-3, et ainsi de suite.
L'ordre de vos lignes sera préservé au cours de ce processus. Ainsi, les premières lignes se trouveront dans le fichier part-1 et les lignes suivantes se trouveront dans le fichier part-2.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.
1 : S3 est une marque déposée appartenant à Amazon Technologies, Inc. Les services de OVHcloud ne sont pas sponsorisés, approuvés, ou affiliés de quelque manière que ce soit.