
Action Custom PySpark
Utiliser notre Software Development Kit (SDK) pour interagir facilement avec les différents composants de la platform
Objectif
Une action Custom PySpark vous permet d'exécuter des scripts PySpark personnalisés dans un environnement de cluster cloud évolutif à l'aide d'Apache Spark™.
En utilisant notre Software Development Kit (SDK) pour interagir facilement avec les différents composants de la platform, les actions Custom PySpark peuvent être utilisées pour mettre en œuvre une variété de cas d'usage tels que :
- Exécuter un algorithme de manipulation ou une tâche ETL sur votre entrepôt de données
- Exécuter une analyse de données simple ou un algorithme de machine learning
- Extraire des données depuis des sources de données non disponibles sur la marketplace de la Data Platform sans avoir à créer de connecteurs pour cela
- Extraire des données en temps réel (comme MQTT, Kafka, etc.)
Les actions Custom PySpark peuvent être orchestrées au sein de workflows et déclenchées immédiatement ou selon une planification. À l'heure actuelle, un même workflow ne peut pas contenir à la fois des actions PySpark et des actions normales.
Configurer une action Custom PySpark
Dans le Data Processing Engine de votre Projet, allez dans l'onglet Actions et cliquez sur le bouton New Action. Choisissez le type d'action Custom PySpark.
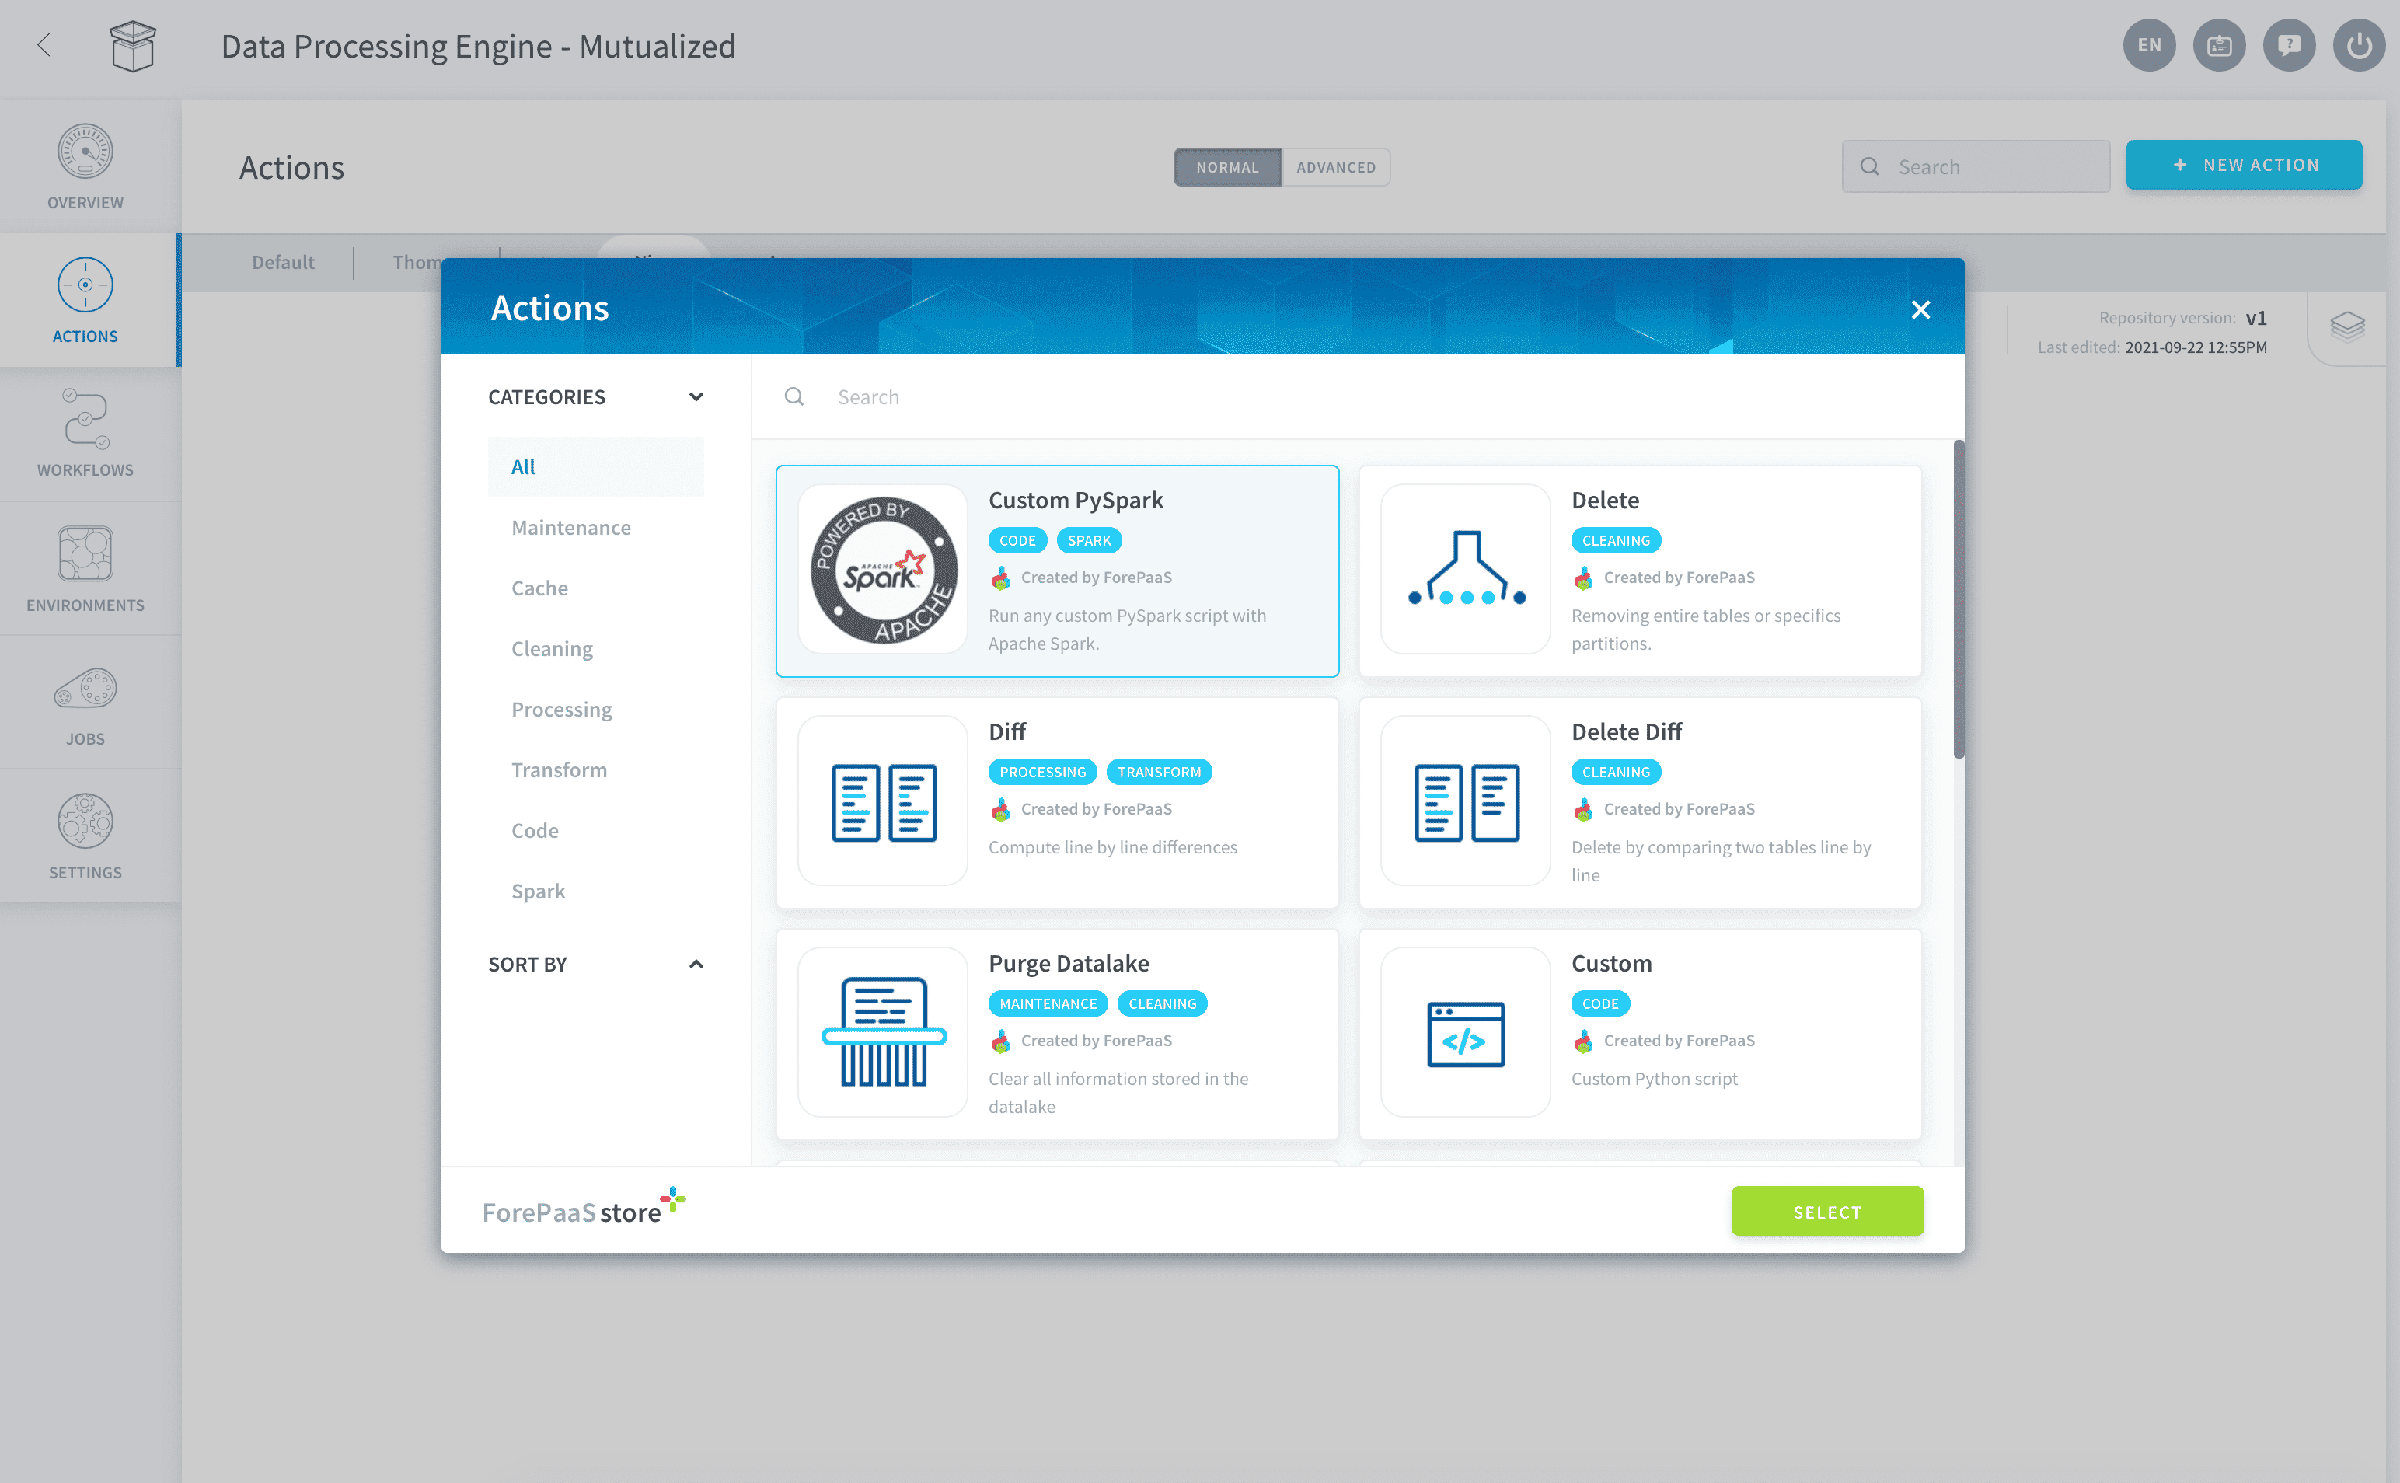
Glissez-déposez votre script PySpark .py dans la section « Drag and drop ».
Sinon, sélectionnez l'option Start with a boilerplate pour démarrer directement sur l'interface Python de la Platform avec des exemples de snippets de code.
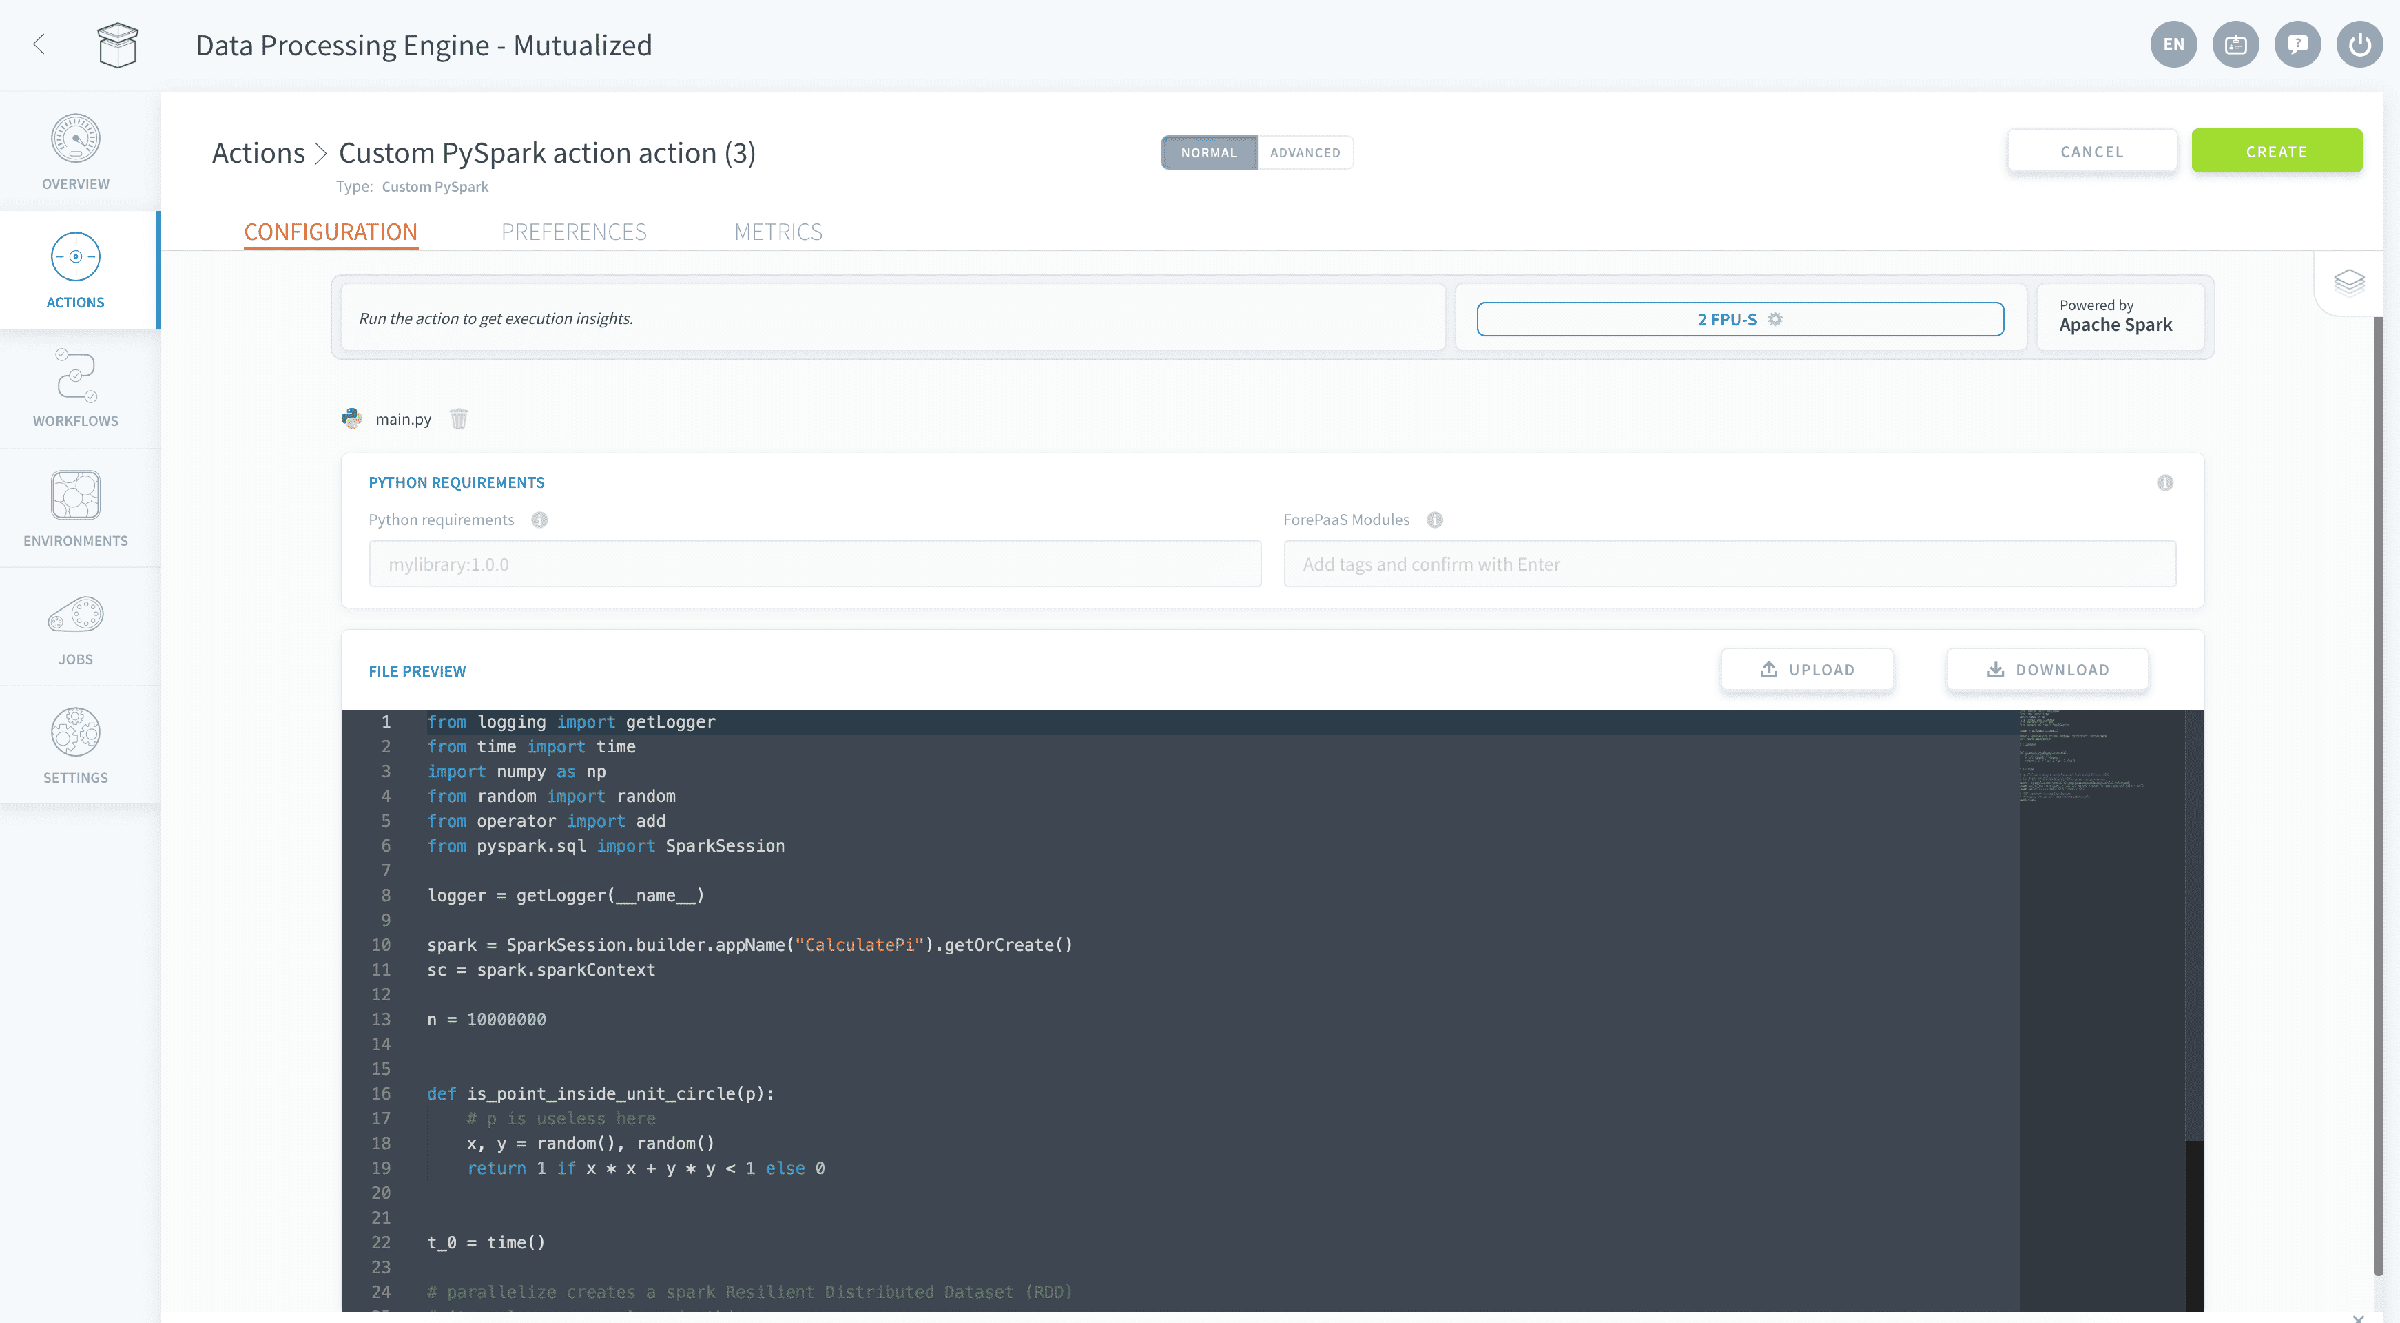
Vous pourrez modifier votre fichier source directement dans l'interface d'édition (ou déposer un nouveau fichier si nécessaire). Consultez la documentation PySpark ci-dessous :
Portail de documentation PySpark
Notez que vous pouvez également utiliser n'importe quelle fonction fournie dans le Software Development Kit (SDK) pour interagir facilement avec les autres composants de la platform. Pour en savoir plus sur toutes les fonctions du SDK disponibles, consultez l'article ci-dessous :
Découvrir toutes les méthodes du SDK
Utiliser le panneau d'aide
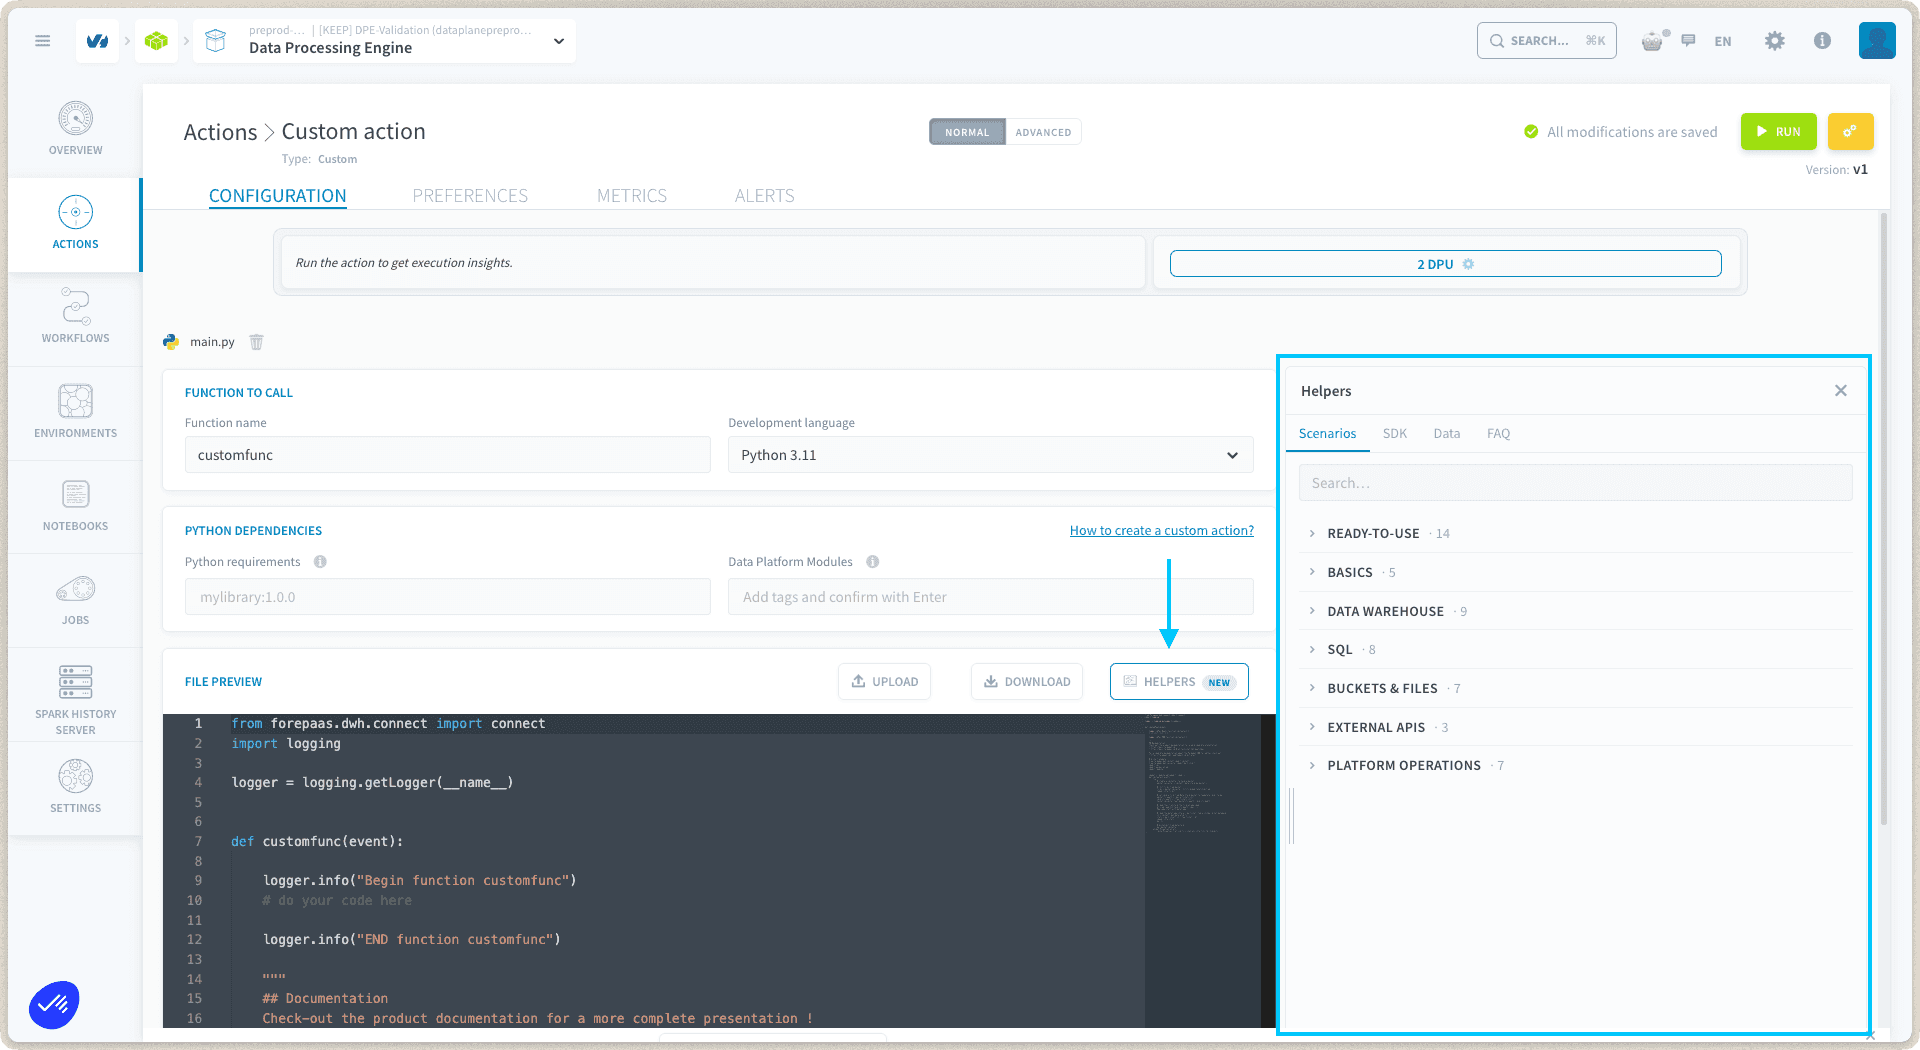
L'éditeur de l'action Custom PySpark inclut un panneau d'aide, vous permettant de trouver de l'assistance sans quitter votre script :
- Scenarios : scripts d'action prêts à l'emploi organisés par catégorie, à copier et adapter à votre cas d'usage.
- SDK guides : documentation des méthodes du SDK que vous pouvez appeler depuis votre script.
- Data : parcourez les données de votre projet directement depuis l'éditeur, pour vérifier les noms et les structures pendant que vous écrivez votre code.
- FAQ : réponses aux questions fréquentes sur les actions.
Le contenu d'aide est le même catalogue en direct qui alimente la Data Platform Extension dans les notebooks, il est donc toujours à jour.
Gérer la parallélisation
Faites évoluer votre tâche en ajoutant davantage d'instances de worker parallèles dans les préférences de l'action.
Saisissez simplement le nombre souhaité d'instances, qui correspond au nombre d'exécuteurs Spark. La taille CPU et RAM de chaque instance peut être gérée en modifiant le nombre de DPU alloués à chacune.
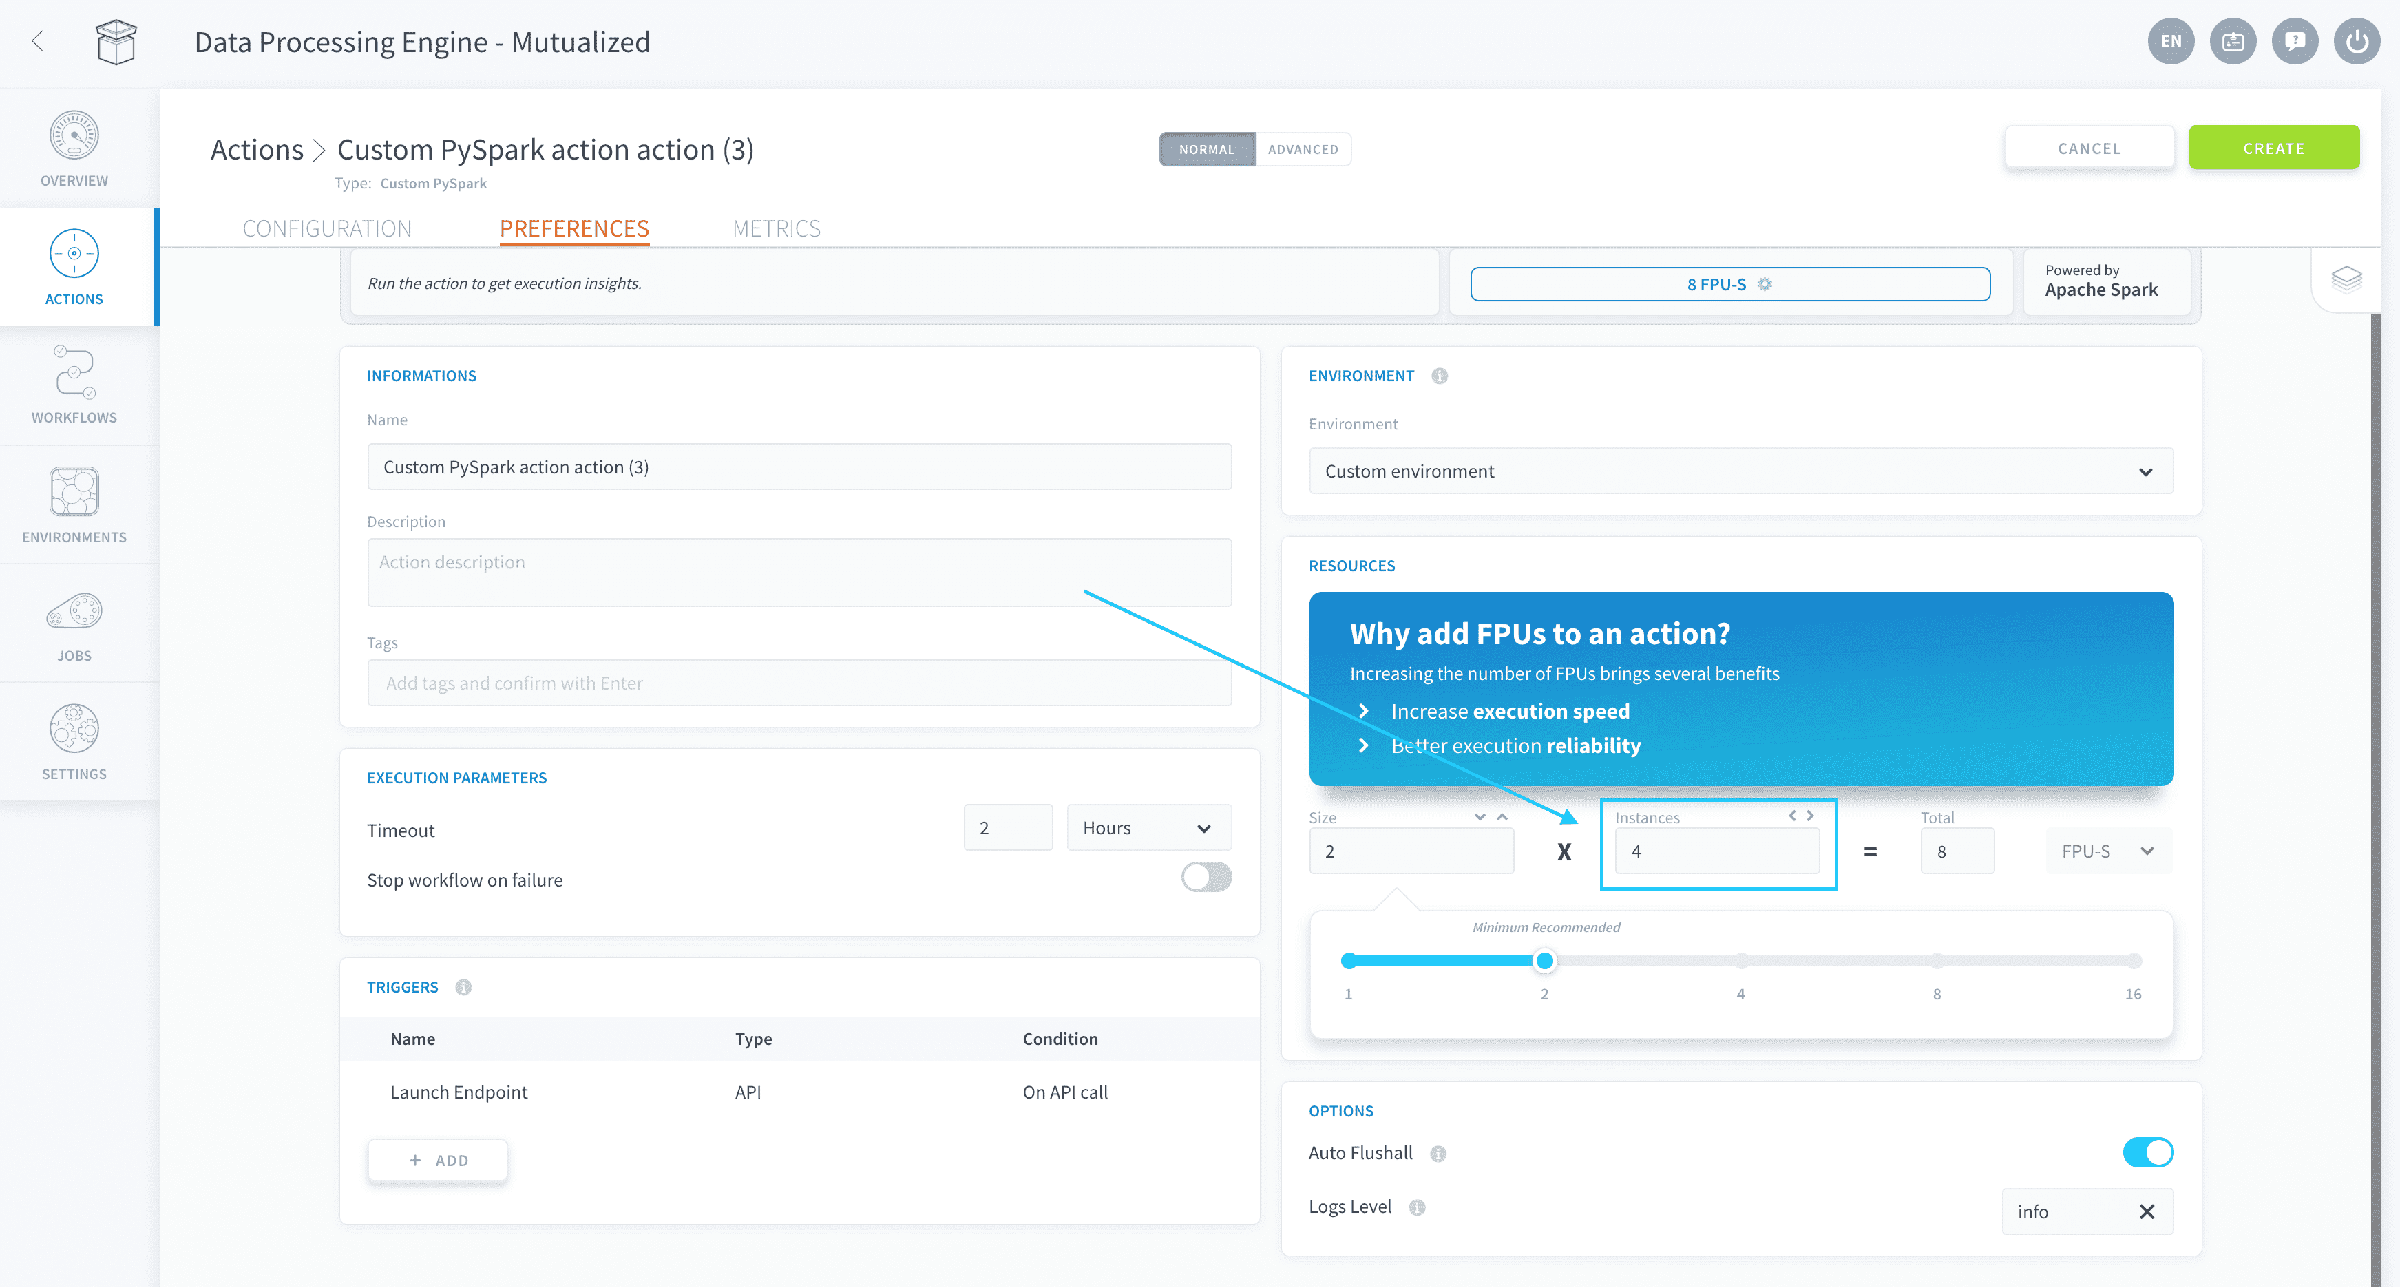
Spécifiez comment répartir la charge de travail de votre tâche sur ces différents workers au sein de votre script PySpark.
Contrairement aux actions qui utilisent le moteur de traitement de données propriétaire de la Platform, les actions PySpark ne disposent pas de paramètres pour la segmentation et le périmètre dans les préférences de l'action. Ceux-ci doivent être gérés directement dans votre code PySpark.
Gérer les dépendances
Installer des packages Python
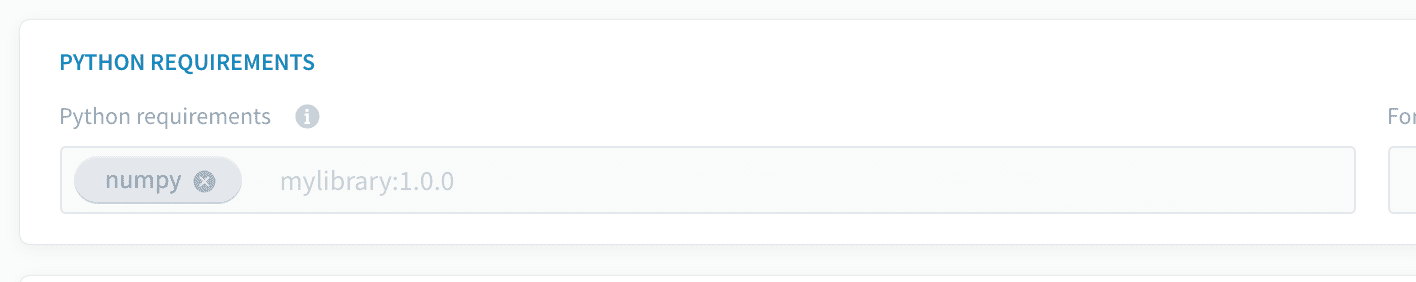
Vous pourriez avoir besoin d'installer des packages spécifiques non inclus par défaut. Vous pouvez les ajouter dans le champ « Python Requirements » en respectant le format utilisé dans un fichier requirements basique pour « pip » (gestionnaire de packages Python), puis appuyer sur « ENTER » sur votre clavier.
Voici à quoi cela devrait ressembler une fois que vous avez appuyé sur « ENTER » :
Installer des packages depuis un dépôt Git
Vous pouvez installer des packages Python directement depuis un dépôt GitHub ou GitLab en utilisant le préfixe git+ dans vos requirements :
Pour figer une version spécifique, ajoutez un tag ou un hash de commit :
Installer automatiquement la dernière version
Pour toujours installer la dernière version publiée sans suivre manuellement les tags de version, utilisez @latest :
La platform détecte le préfixe git+ et le suffixe @latest, puis résout et substitue automatiquement le dernier tag de version avant l'installation.
Après avoir ajouté ou modifié une dépendance Git, cliquez sur Force Build pour réinstaller. Vous n'avez plus besoin de mettre à jour manuellement le tag ou le hash de commit à chaque publication d'une nouvelle version de votre module, mais notez que la dernière version n'est pas prise en compte automatiquement à l'exécution, un Force Build manuel est toujours requis.
Liste par défaut des dépendances
La Data Platform bloque les versions mineures, ce qui permet l'installation des correctifs de bugs. Si vous avez besoin d'une version plus récente d'une bibliothèque, vous pouvez la surcharger manuellement en ajoutant le même package avec la nouvelle version dans le champ « Requirements ».
Voici la liste de tous les packages et de leur version (tels que vous pourriez les trouver dans un fichier requirements pour pip) livrés avec les workers du Data Processing Engine :
Découvrir tous les packages Python par défaut
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.