
Créer et construire vos modèles de données
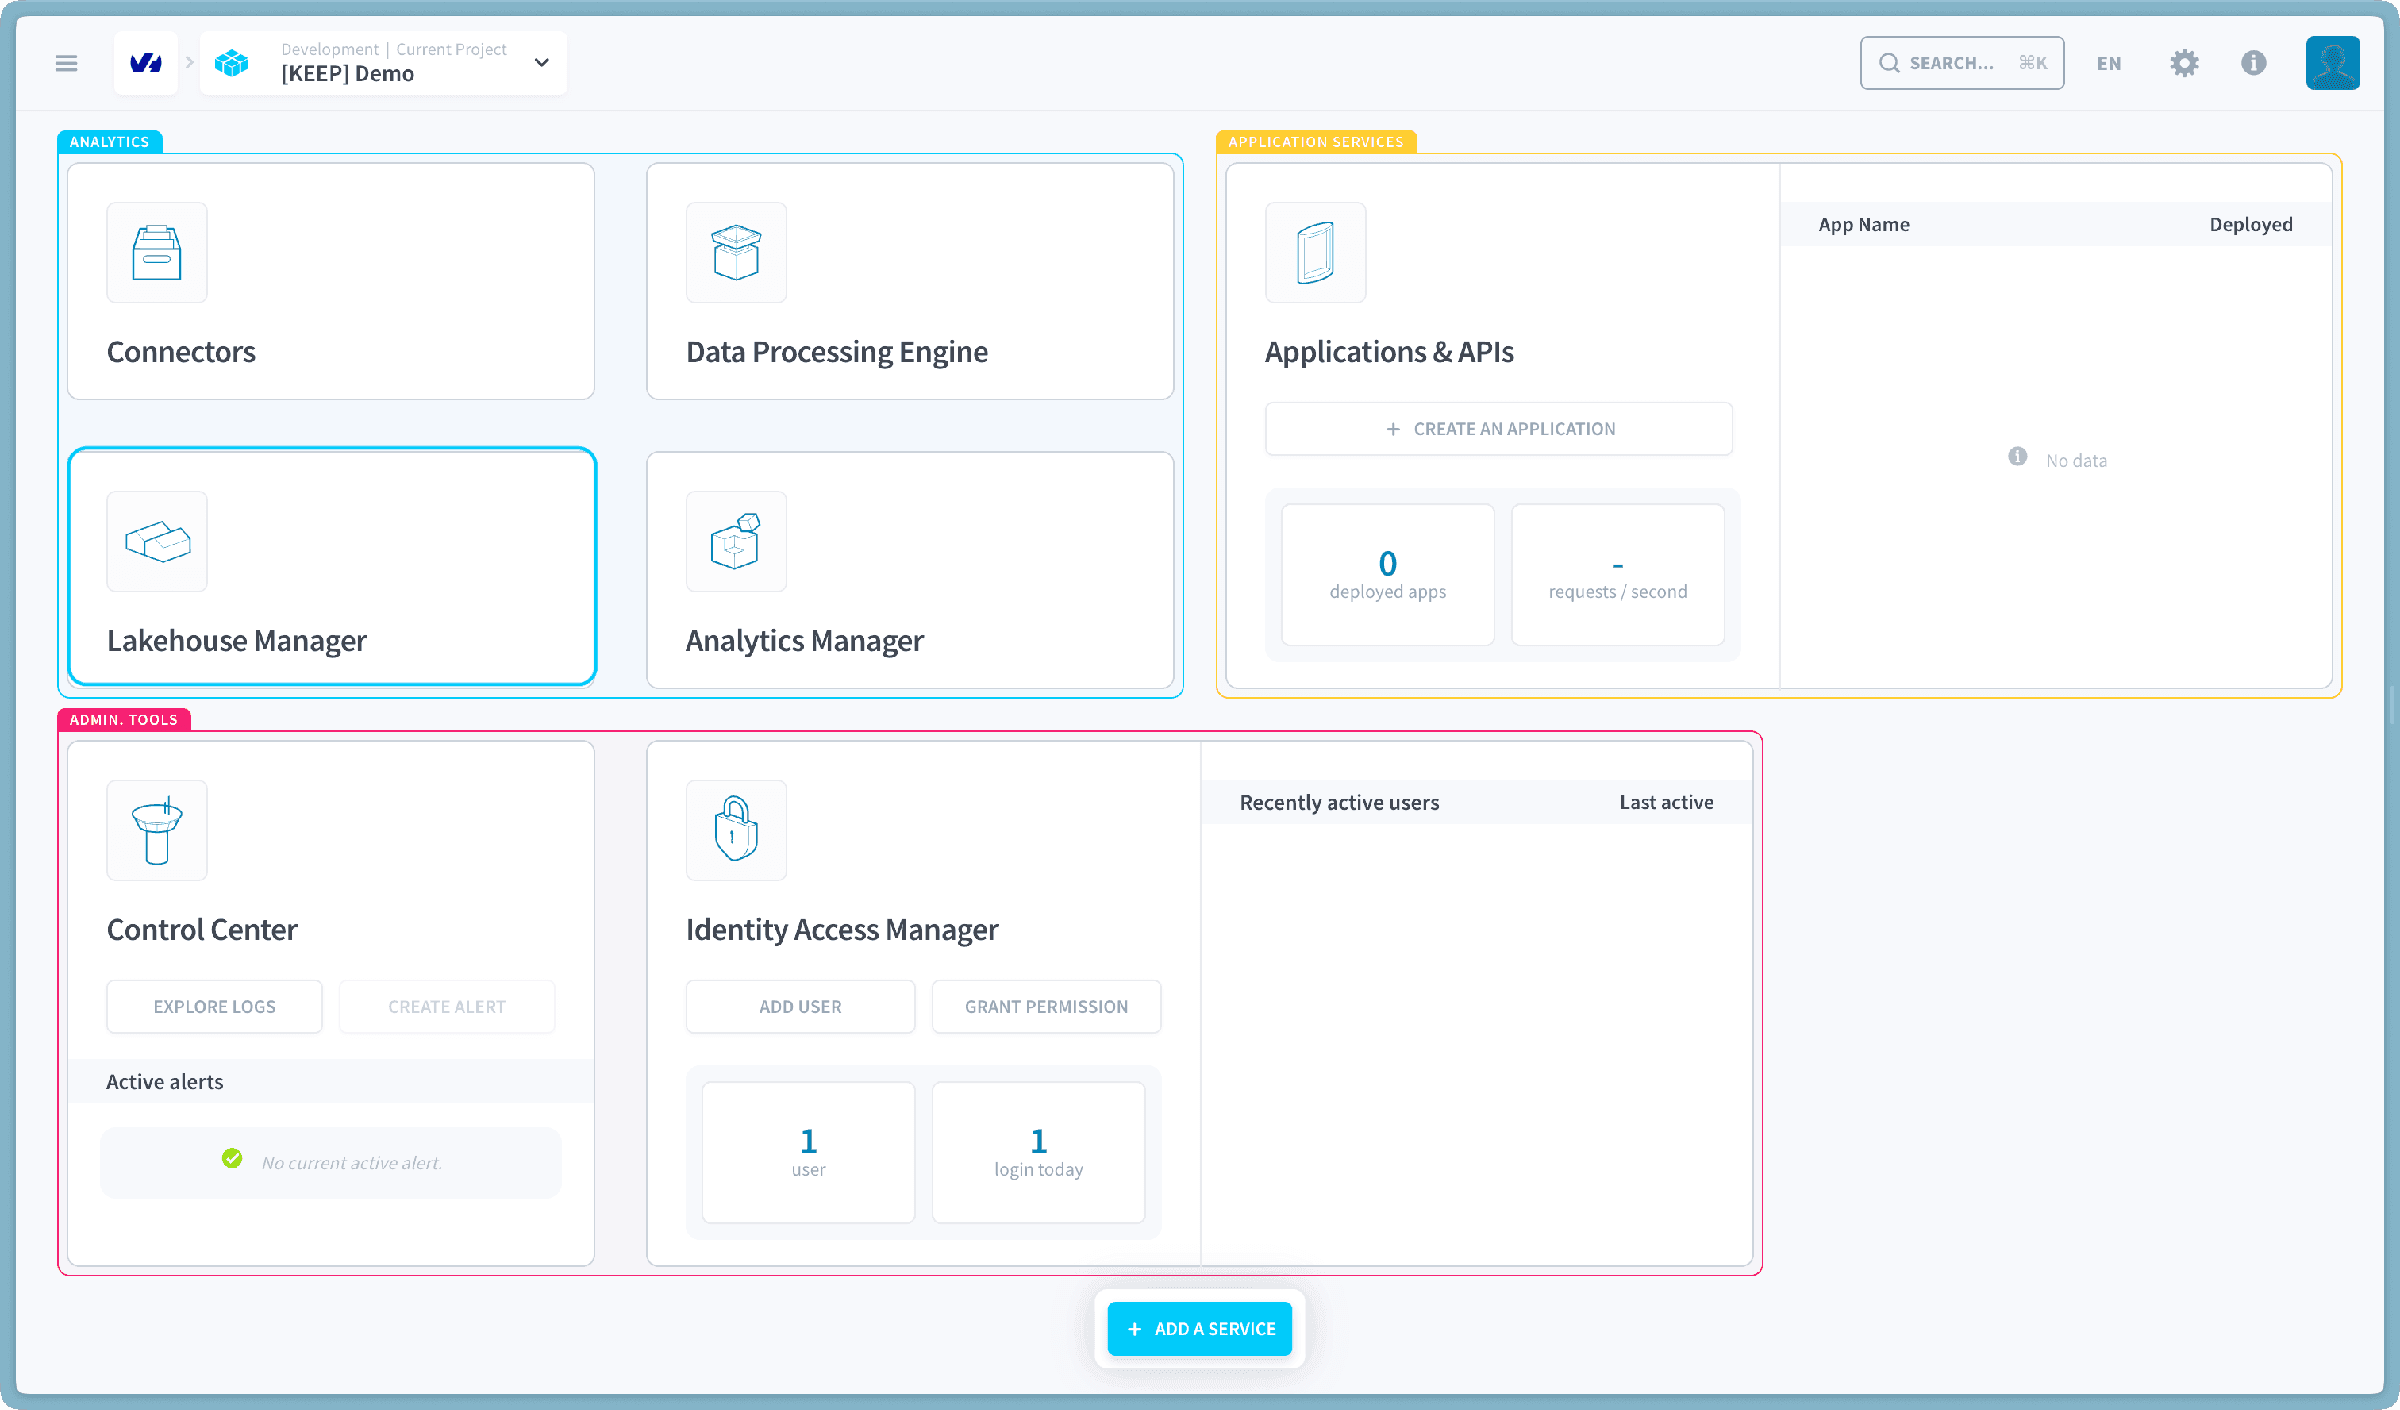
Le Lakehouse Manager est le prochain composant que vous allez utiliser. L'utilisation du Lakehouse Manager permet de planifier votre structure de données au niveau conceptuel
Objectif
Le Lakehouse Manager est le prochain composant que vous allez utiliser. C'est le composant qui contrôle :
- L'entreposage des données
- La gestion des Policy Tags
L'utilisation du Lakehouse Manager permet de planifier votre structure de données au niveau conceptuel. Cela se fera à l'aide de la fonctionnalité Tables.
Ce tutoriel est destiné aux Standard Datasets utilisant le Lakehouse Manager Engine. Pour savoir comment suivre cette même étape avec des External Datasets, cliquez ici.
Organiser vos données en tables
Créer votre schéma principal
Ajouter des tables au modèle de données
Une fois vos métadonnées extraites, il est temps de vous rendre sur le tableau de bord Tables. C'est ici que vous allez construire une vue unifiée et interrogeable de toutes vos données.
La page Tables vide devrait ressembler à ceci.
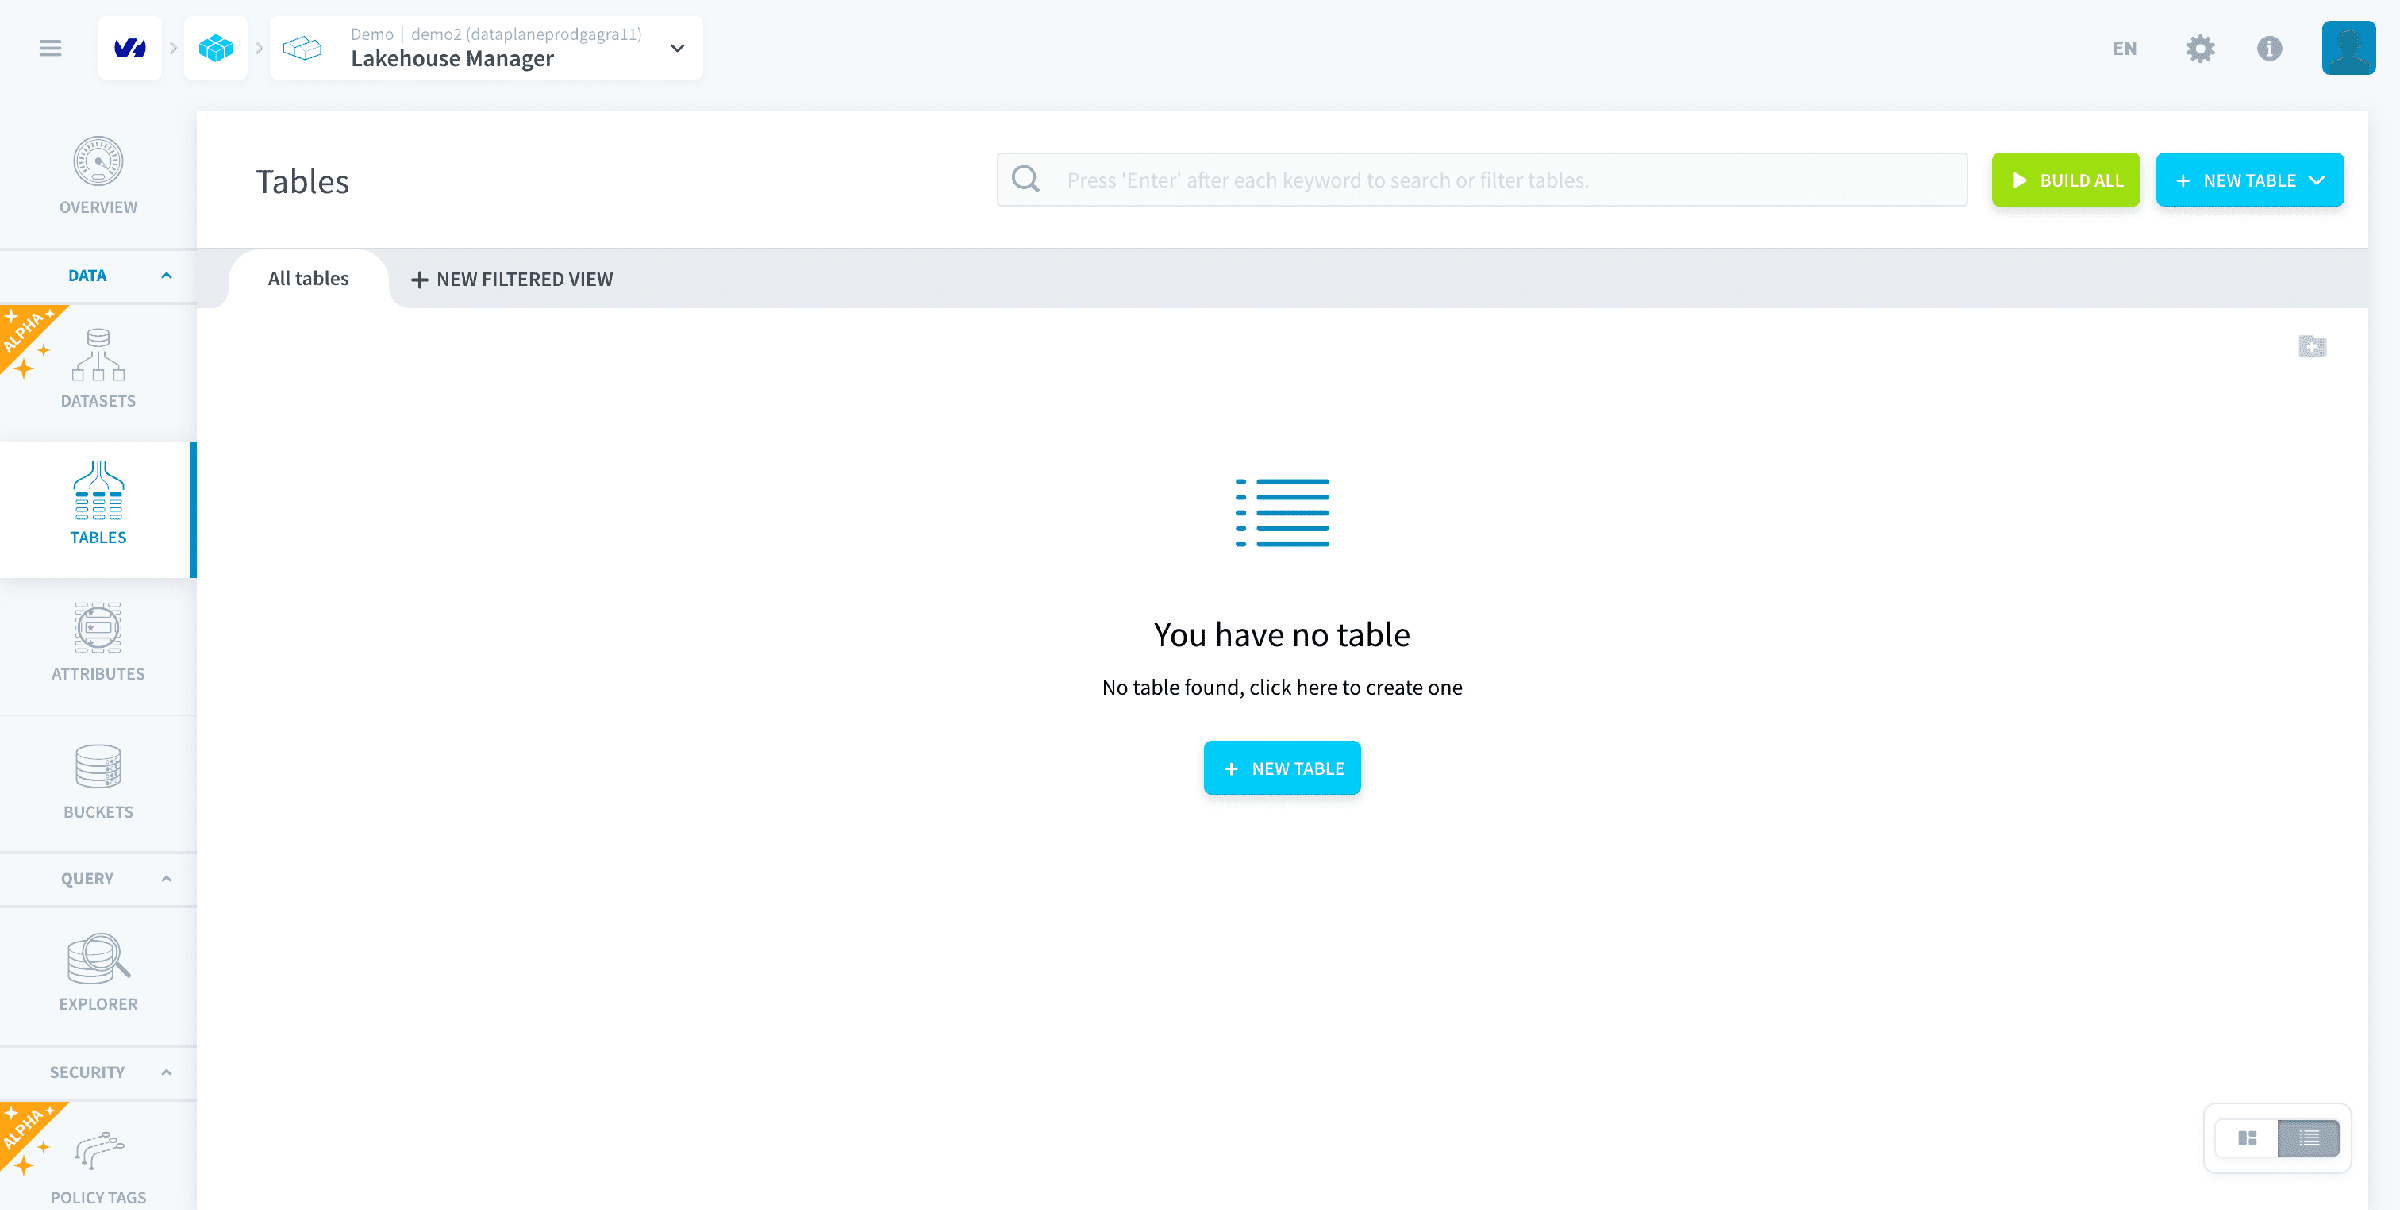
L'onglet All tables vous donne accès à l'intégralité de vos données. L'onglet New View vous permet de créer des vues d'une partie seulement de vos données afin de mieux collaborer au sein de grandes équipes. Comme il s'agit d'un tutoriel simple, vous devriez travailler dans l'onglet All tables.
Concentrons-nous maintenant sur la création de vos tables principales et de leurs attributs.
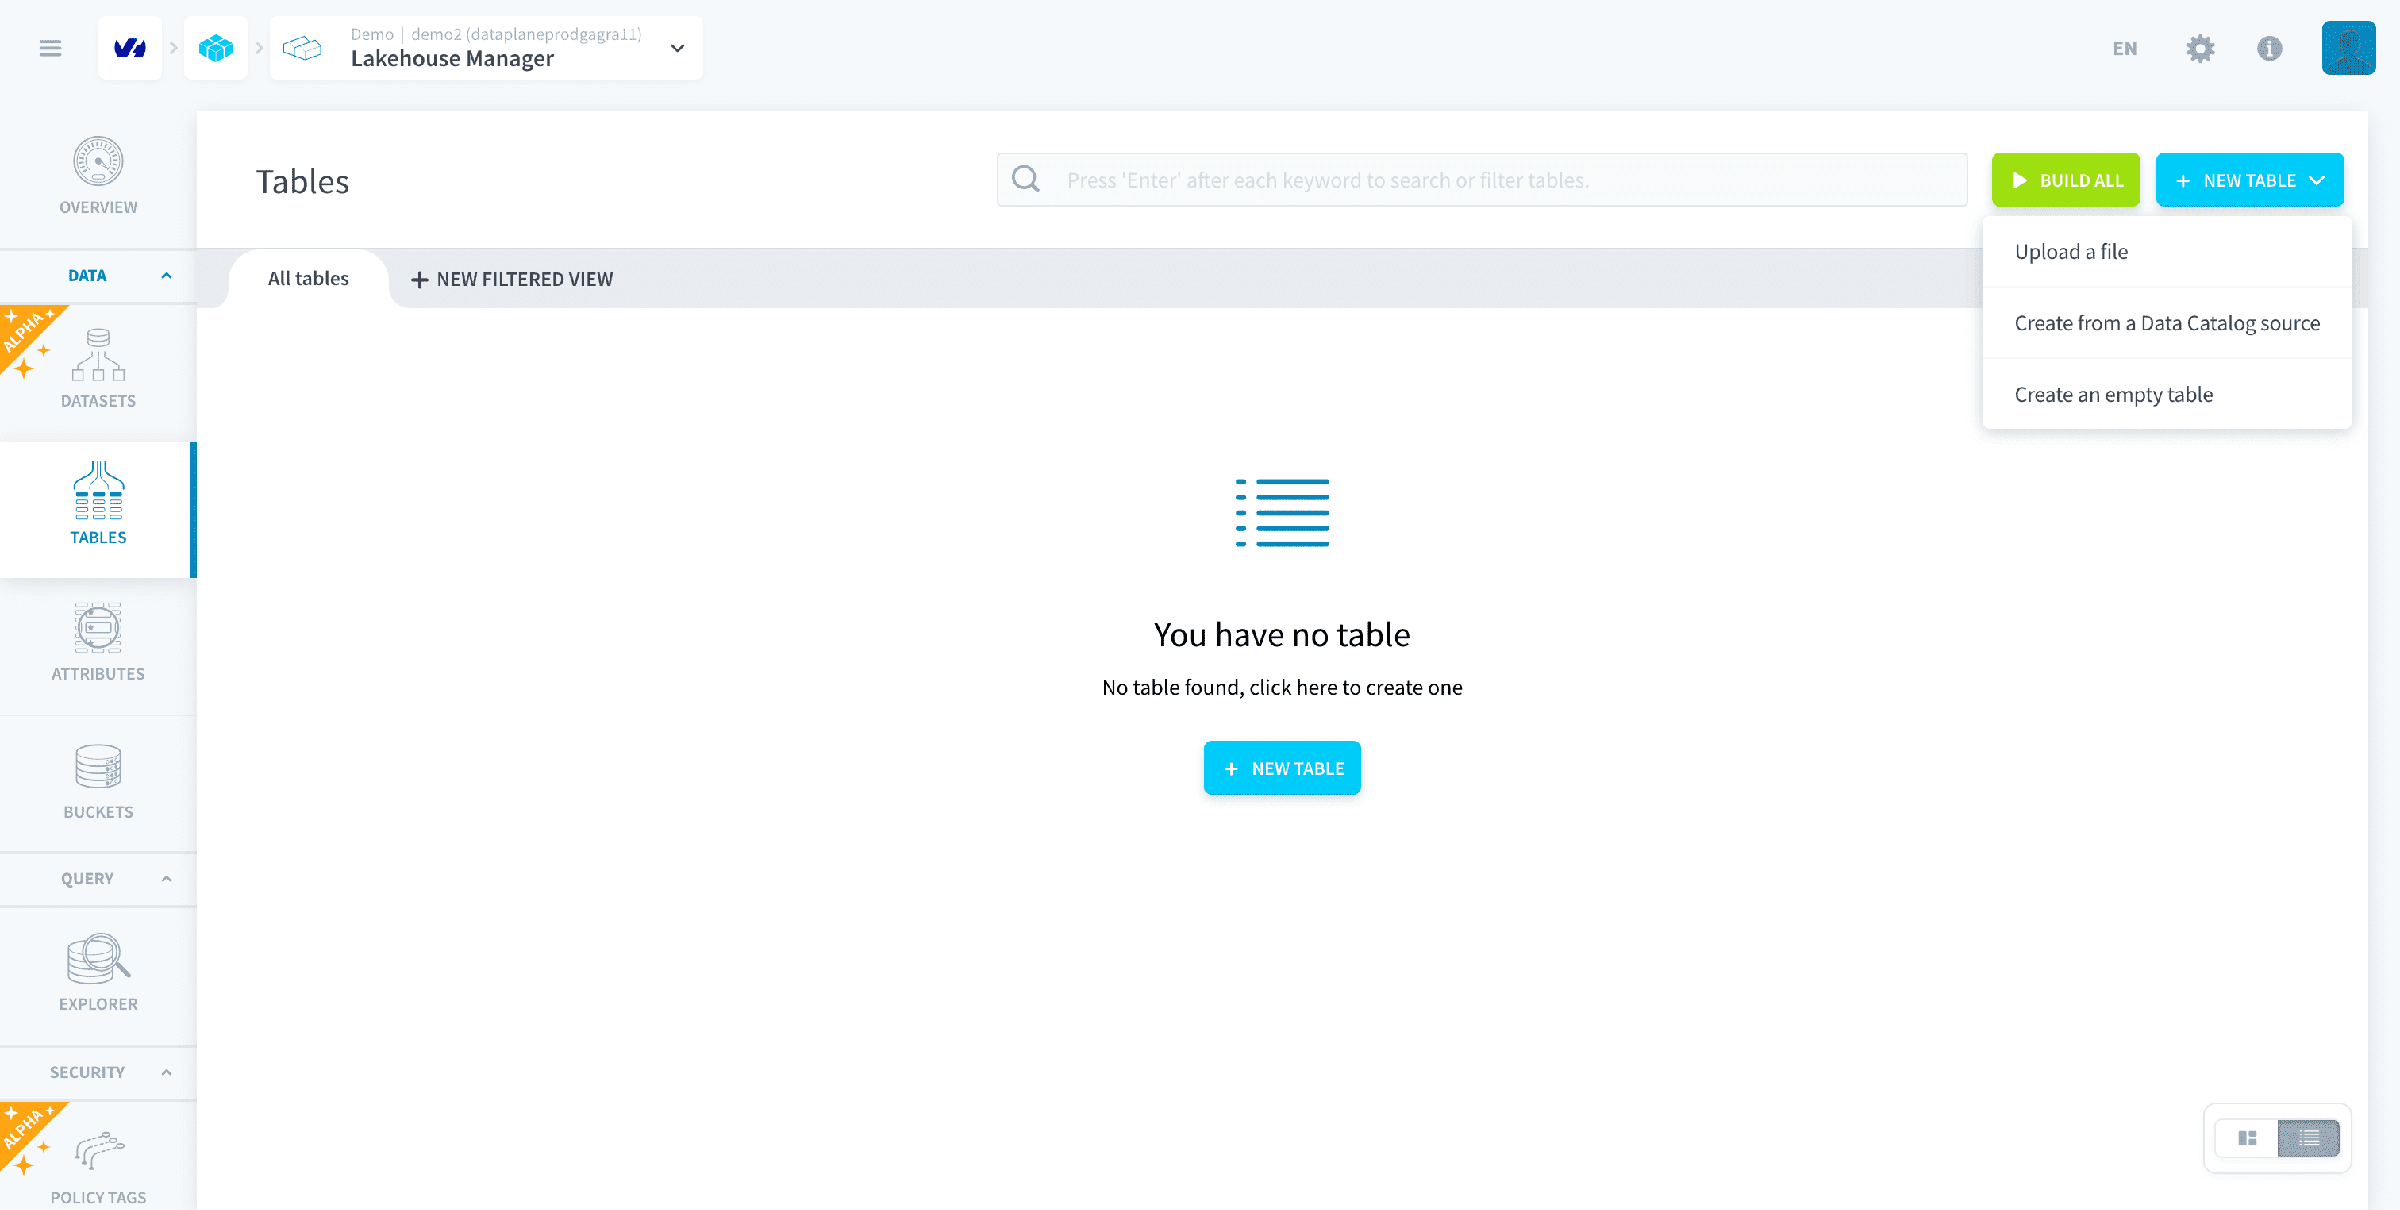
Tout d'abord, survolez avec votre curseur le bouton bleu ➕ NOUVELLE TABLE sur le côté droit de l'écran. Cela affichera les options de création :
- Importer un fichier
- Créer à partir d'une source Connectors
- Créer une table vide
Pour les besoins de ce tutoriel, nous allons procéder avec Créer à partir d'une source Connectors. Pour créer une table en important un fichier, reportez-vous à la documentation Gérer une table.
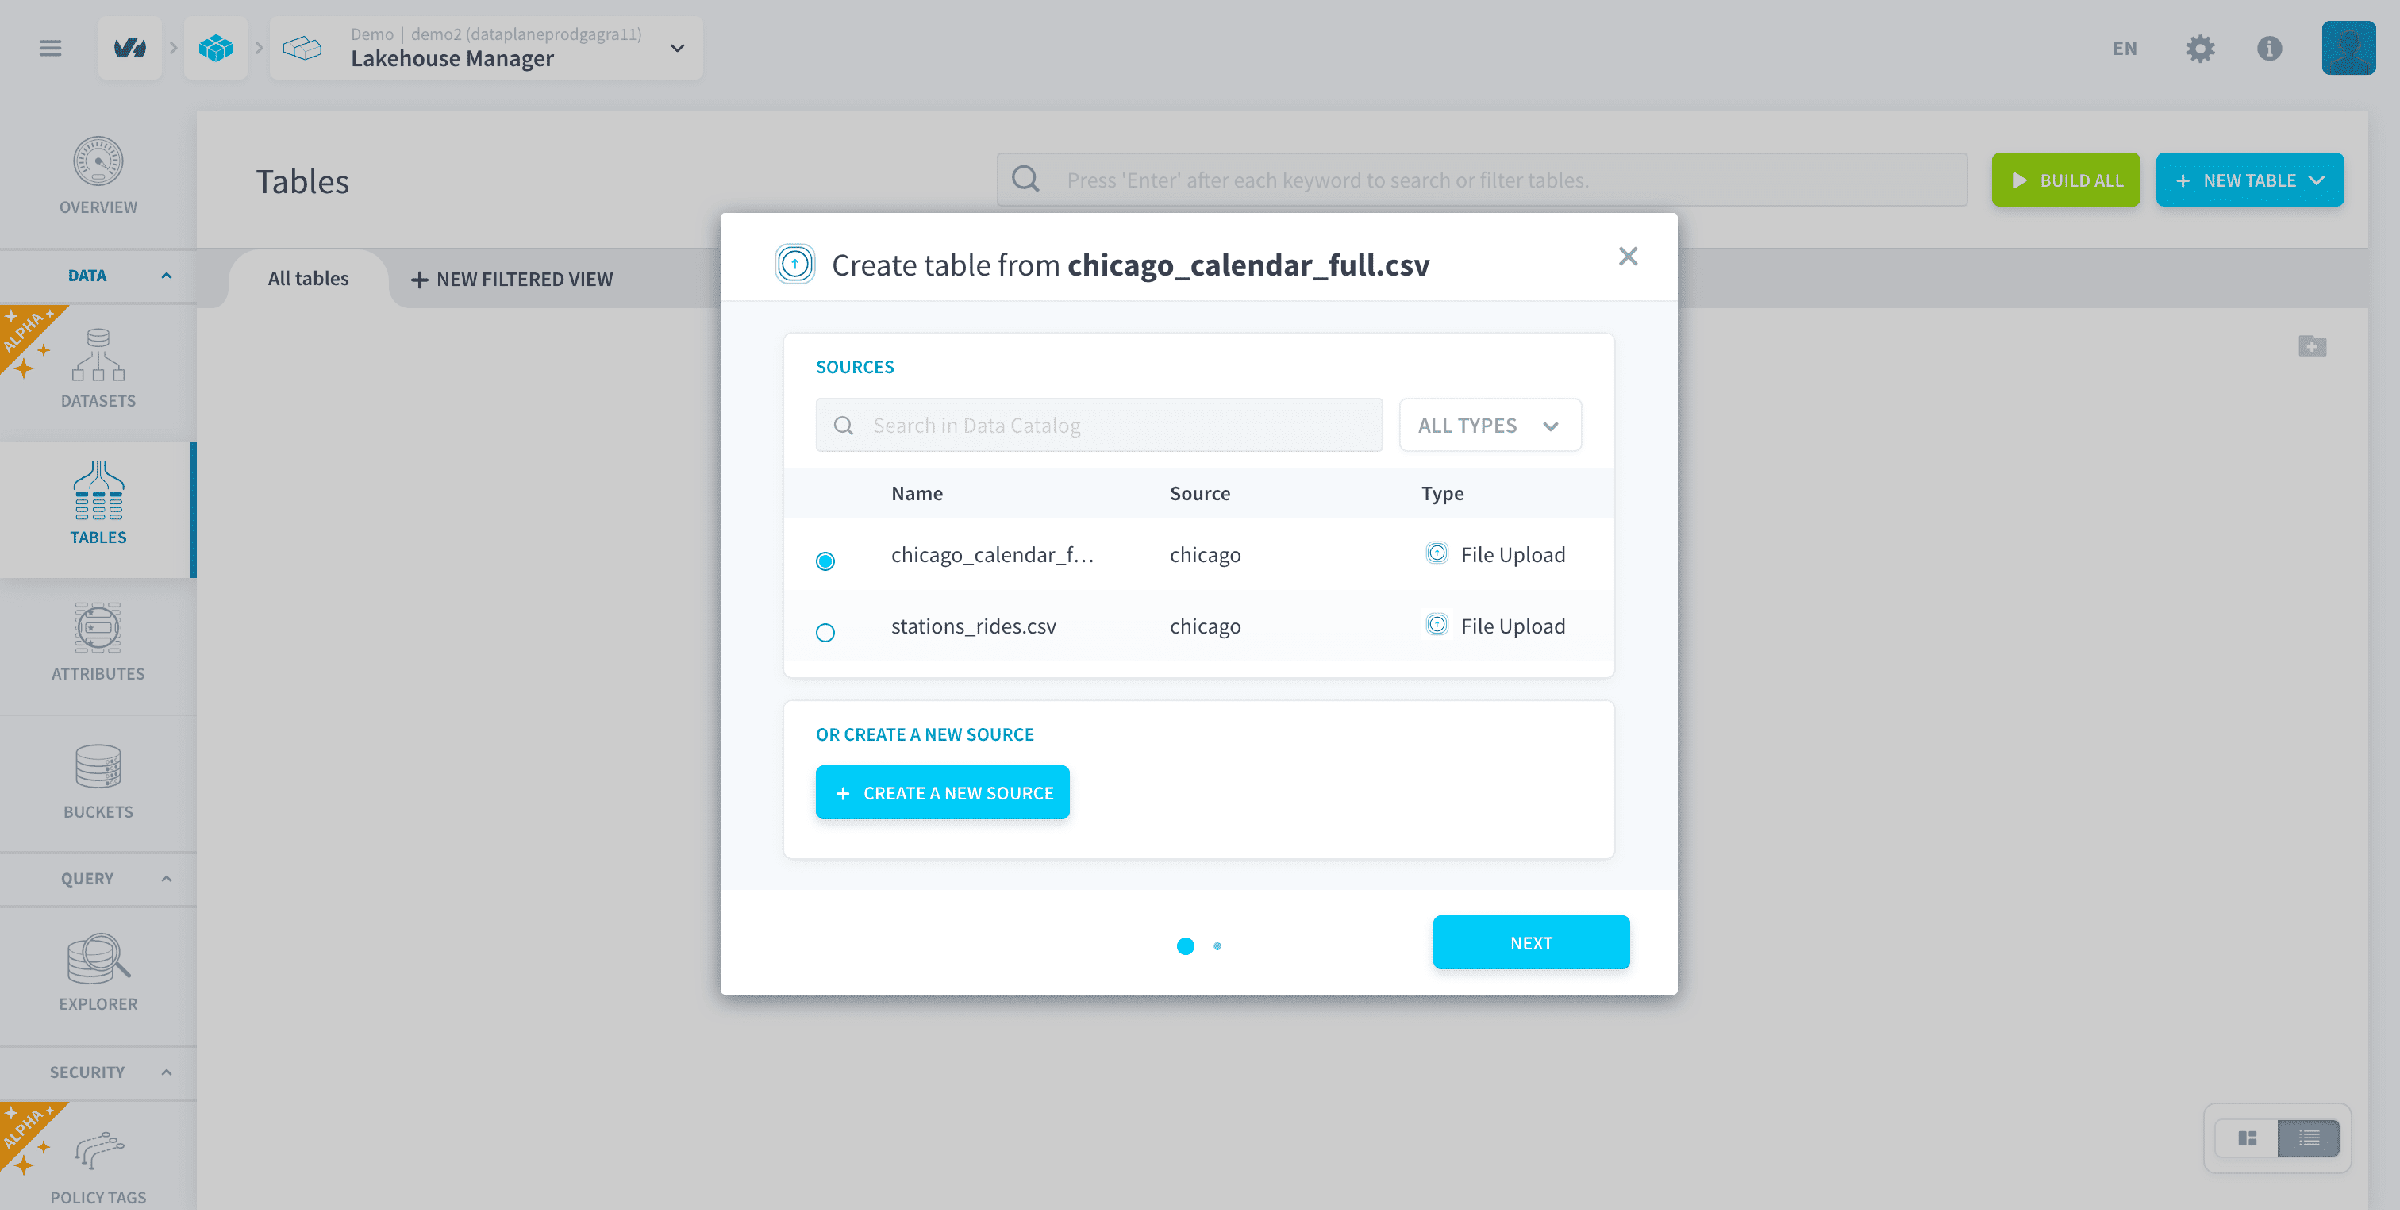
Une fois que vous cliquez sur create from a connectors source, une liste des sources de l'étape précédente s'affichera. Cliquez sur la source que vous souhaitez ajouter et poursuivez en cliquant sur Next. Aucun changement des paramètres par défaut n'est nécessaire ici.
Les options Build the table, load the table once, and generate Load action for later peuvent être désactivées et chaque étape peut également être effectuée individuellement. Ceci peut être exploré en détail ici
Appuyez sur Create et répétez la même opération pour la seconde table.
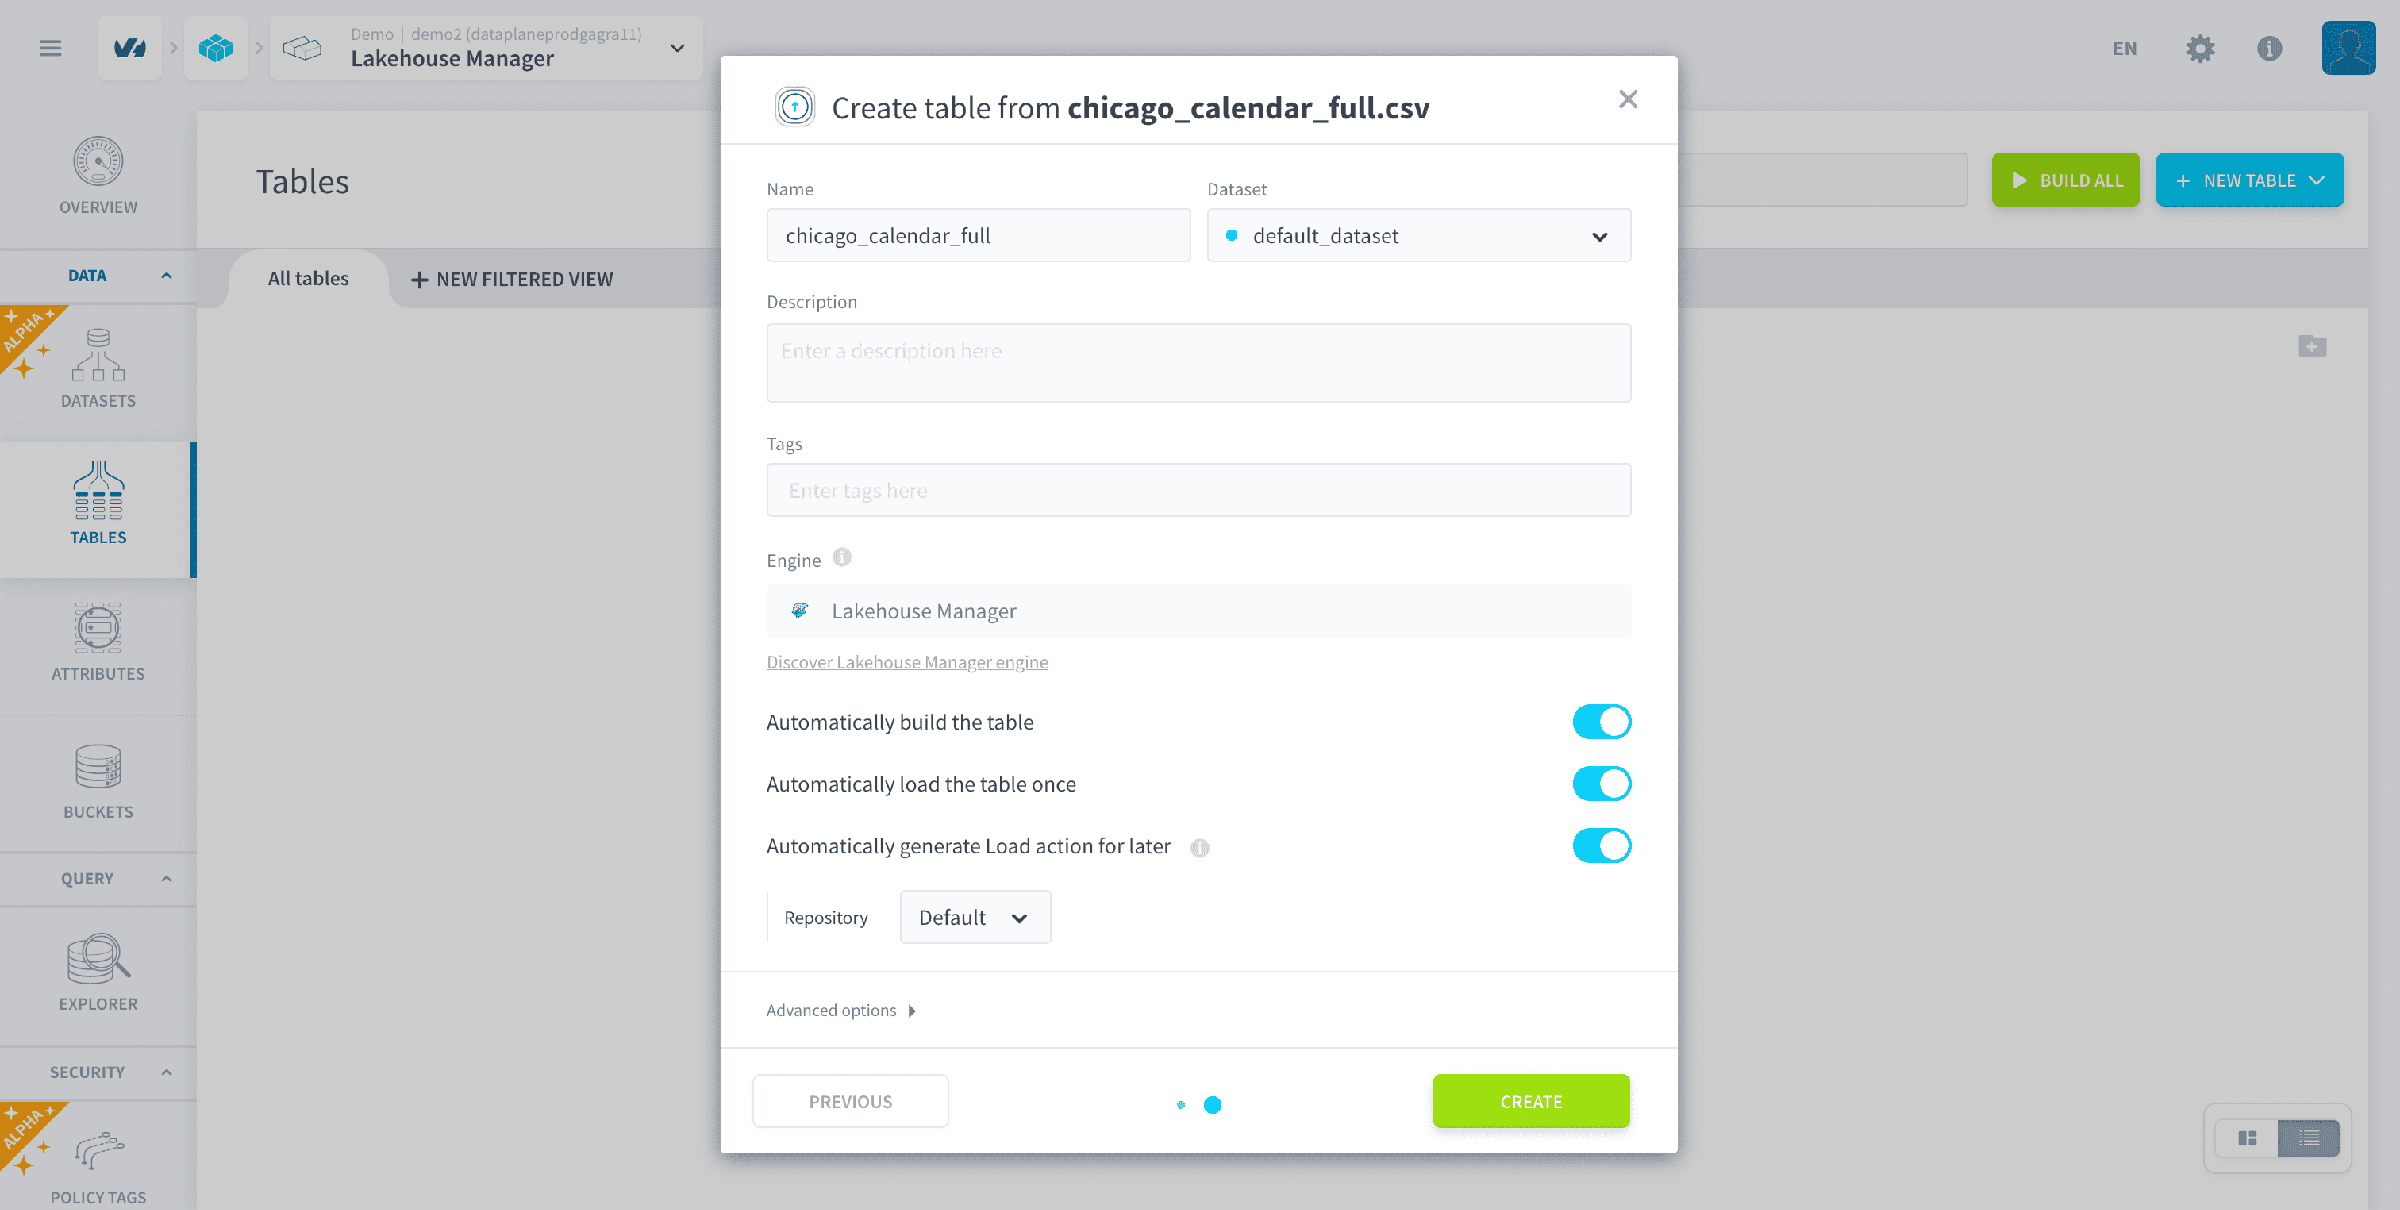
Notez qu'à chaque modification effectuée sur la page Tables, votre configuration visuelle est automatiquement sauvegardée.
À ce stade, votre page Tables devrait ressembler à ceci.
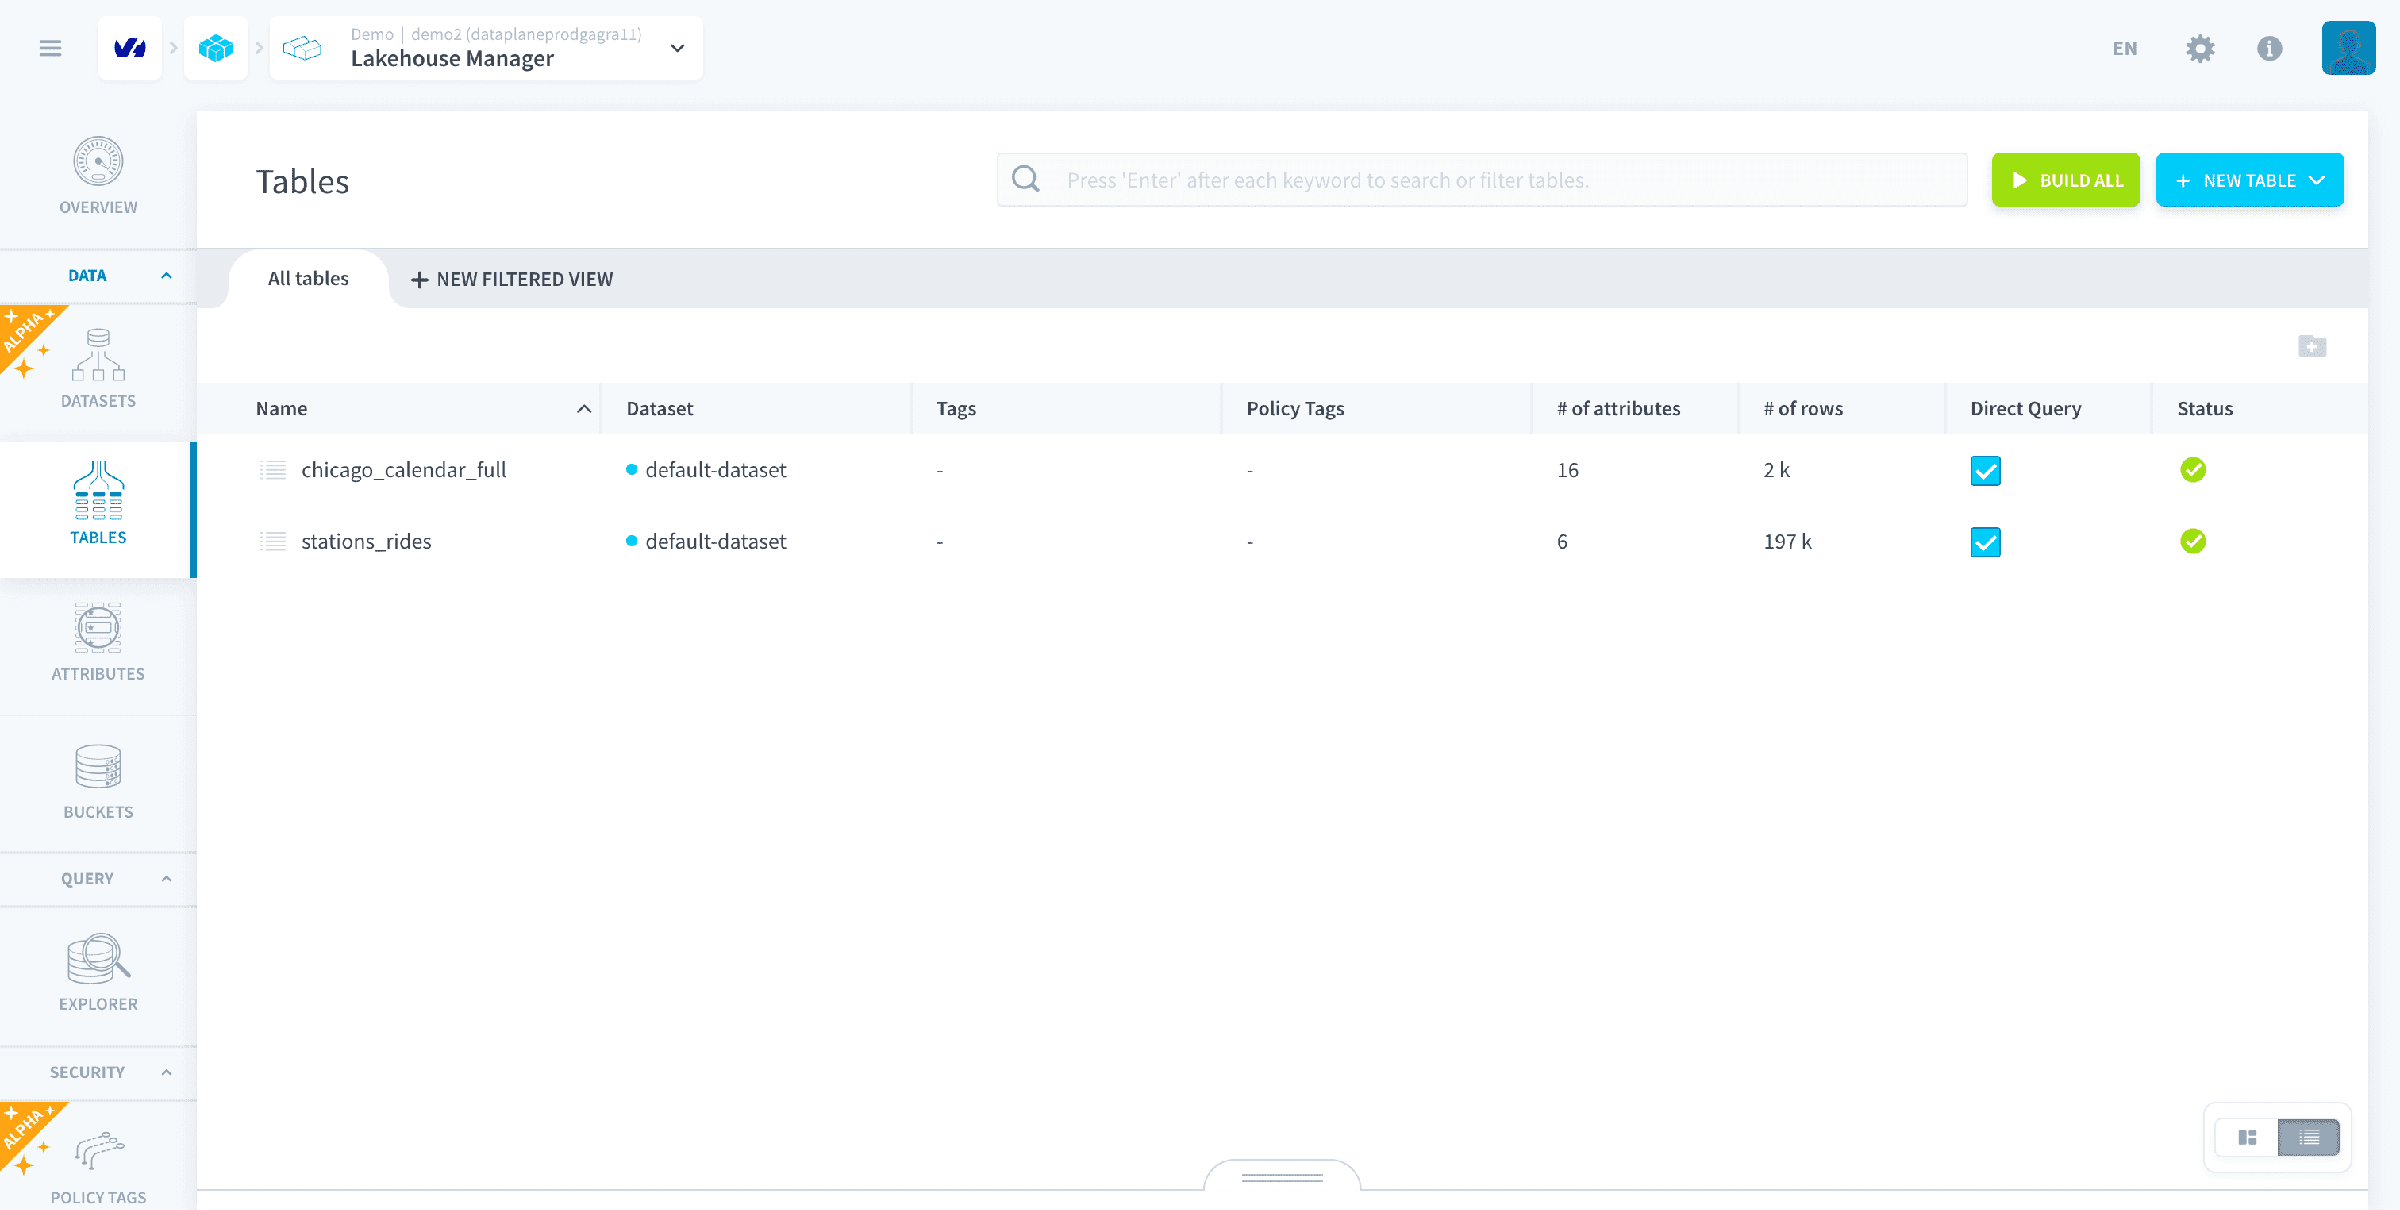
Notez que la Platform utilise les informations de métadonnées capturées lors de l'étape Analyzer pour créer automatiquement les tables et attribuer les noms & types des attributs. Les fichiers source fournis sont prêts à l'emploi, cependant dans un Projet réel vous devriez utiliser l'Analyzer pour vérifier les sources de données, avant de les glisser-déposer dans la page Tables.
Créer votre table d'agrégation
Vous allez maintenant agréger toutes les données importantes des sources (à savoir les trajets, les dates et les températures) dans une seule table qui sera utilisée dans l'application finale. Pour créer votre première table Aggregate, cliquez sur l'icône bleue ➕. Sélectionnez Create an empty table, et une nouvelle configuration de table s'affichera. Définissez un nom (dataset_history par exemple) et sauvegardez-le.
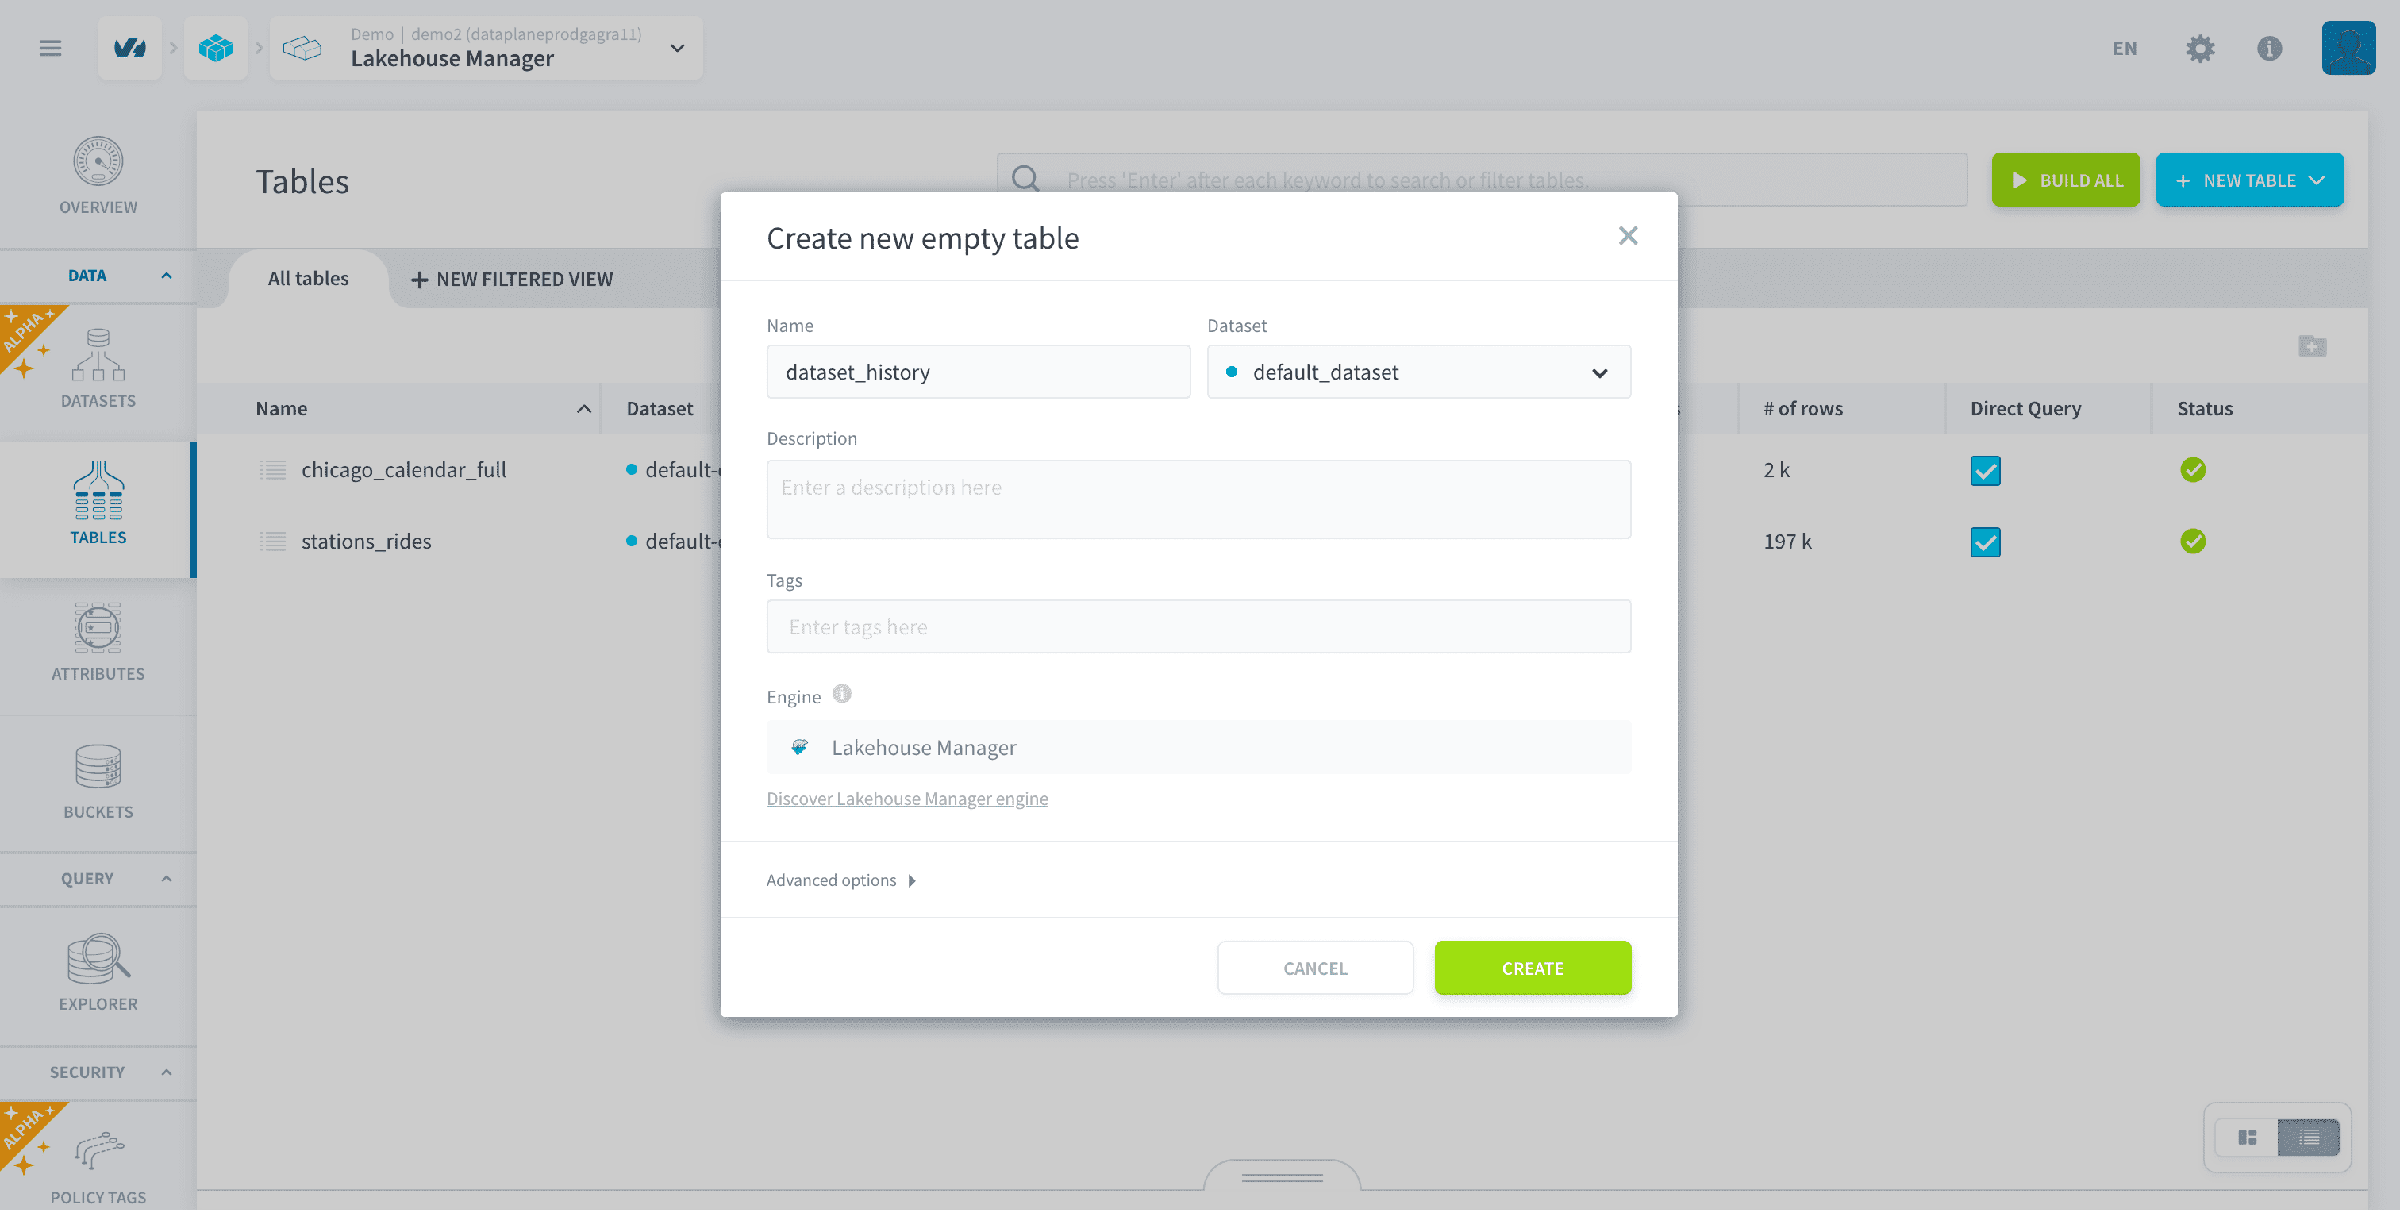
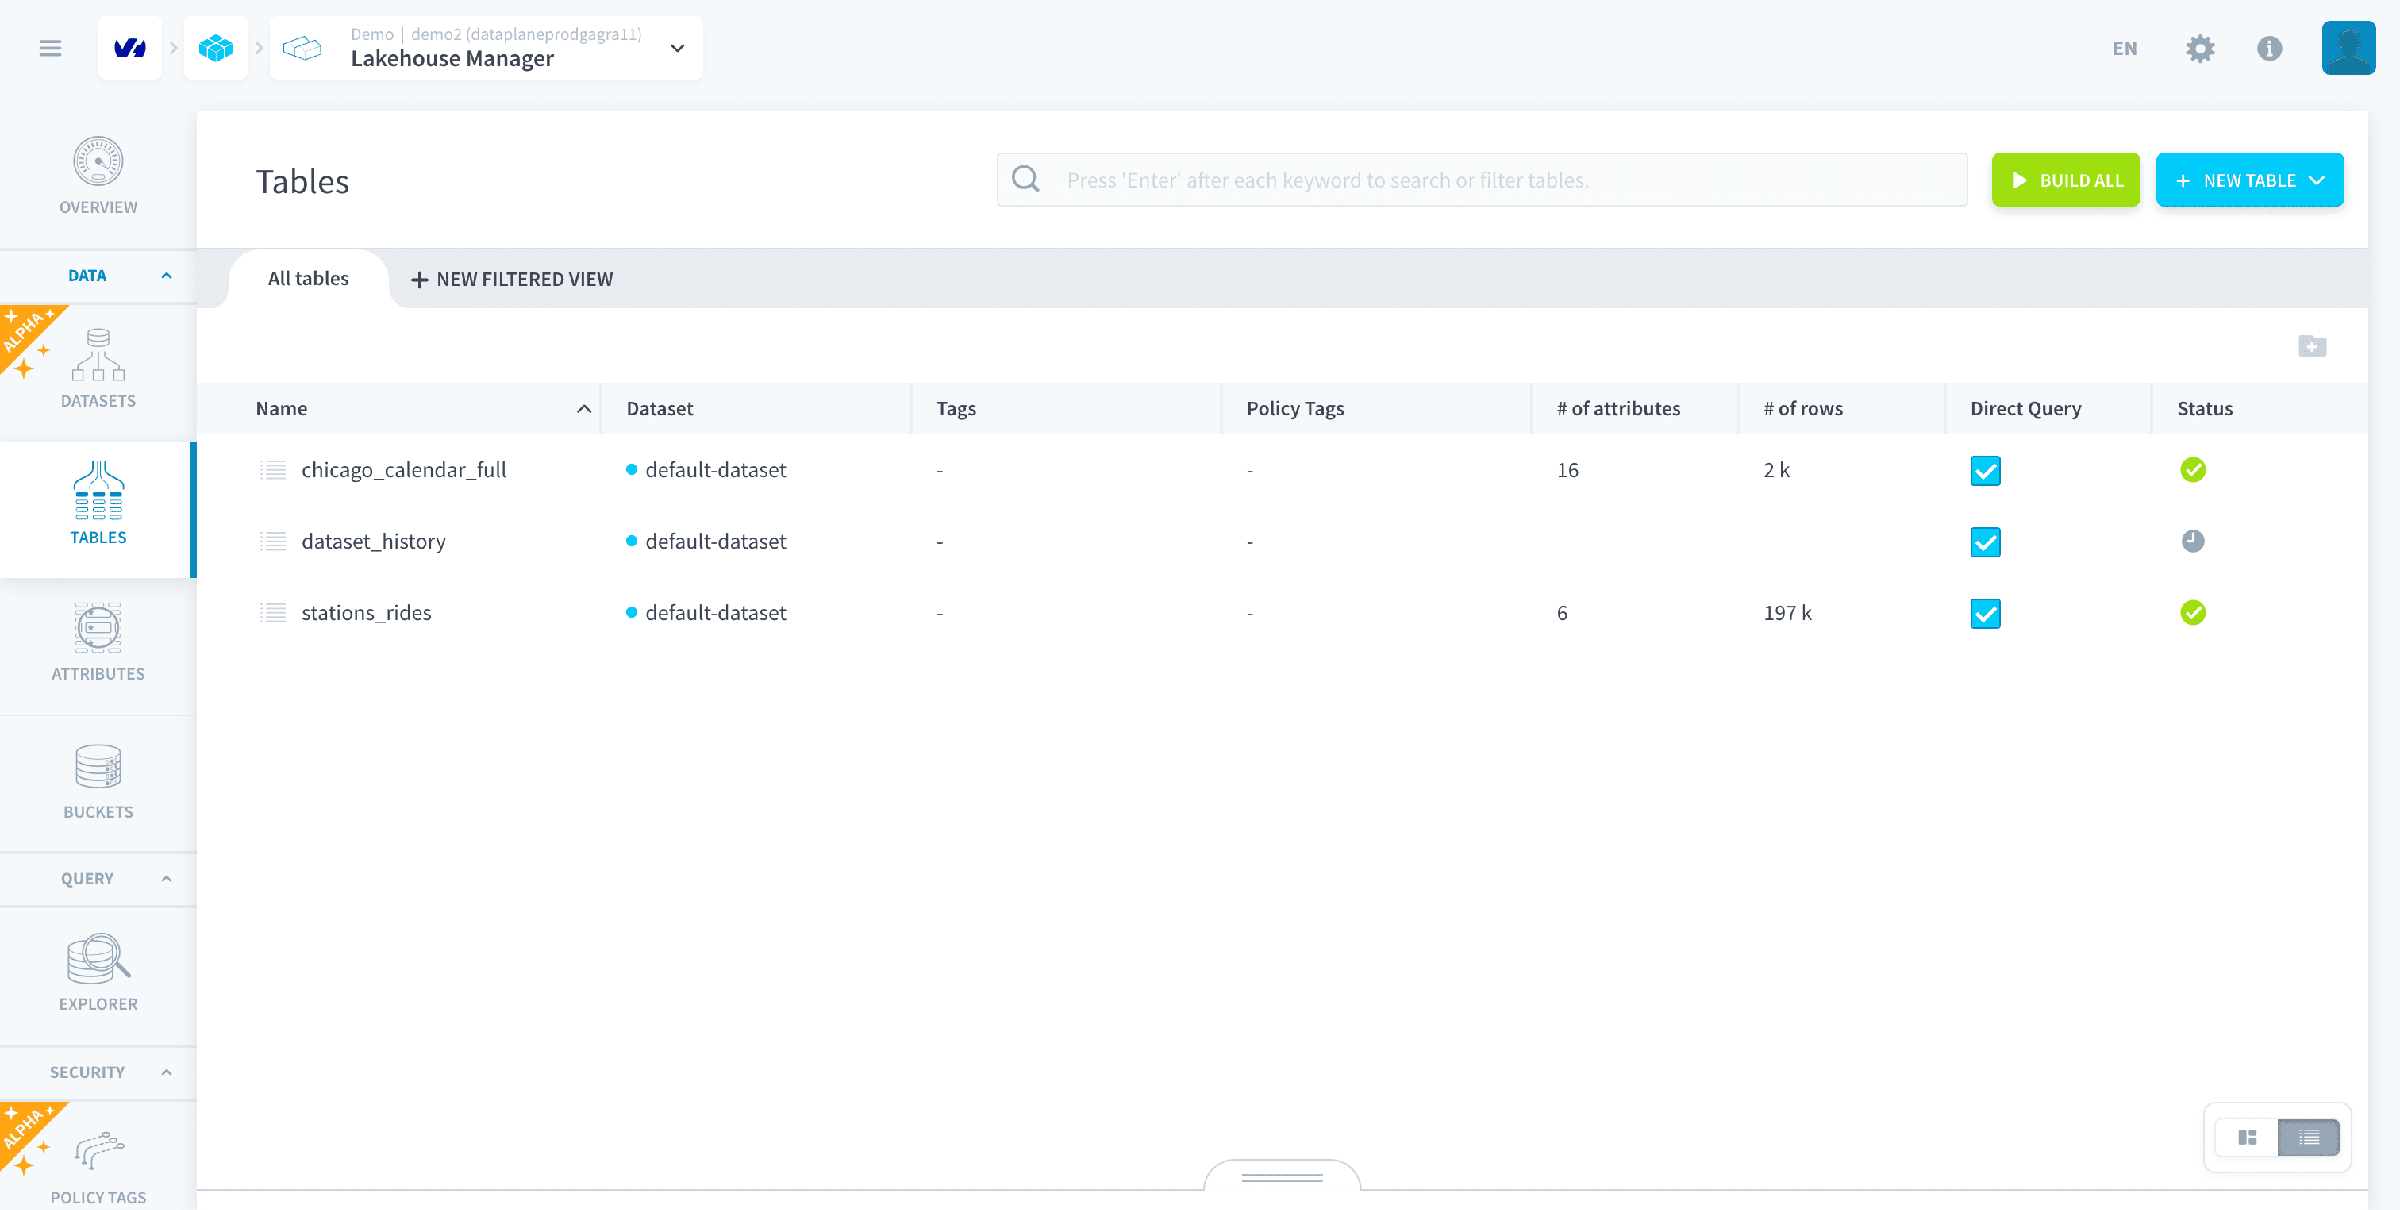
Maintenant, avant de commencer à ajouter des attributs à la nouvelle table vide que vous avez créée, vous devrez changer la vue de liste à canvas en bas à droite de l'écran pour faciliter les étapes suivantes.
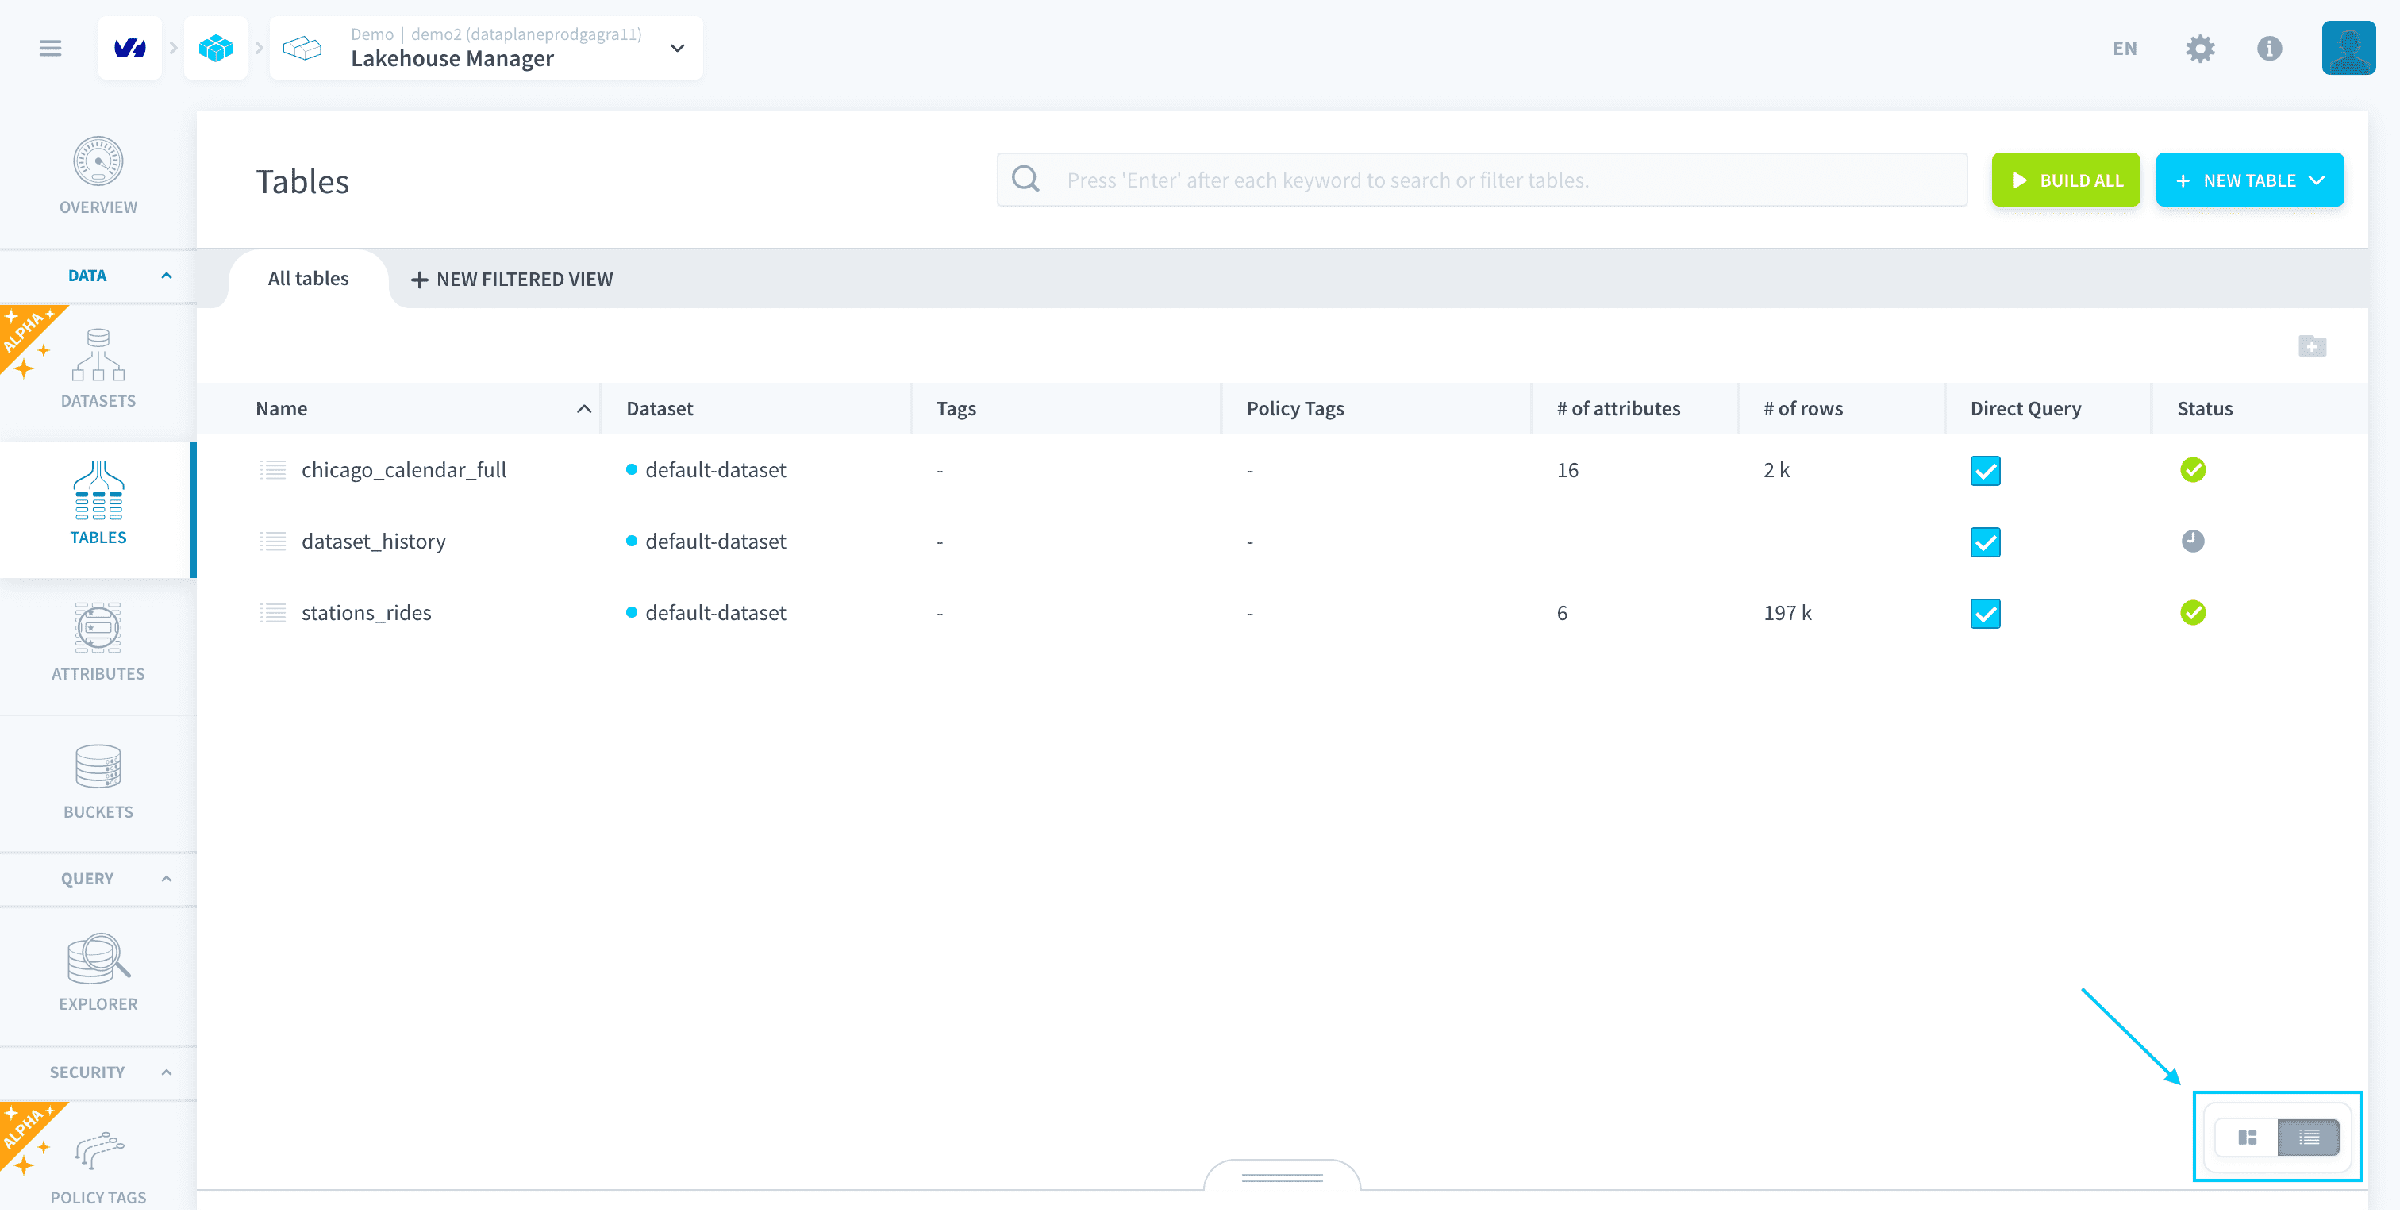
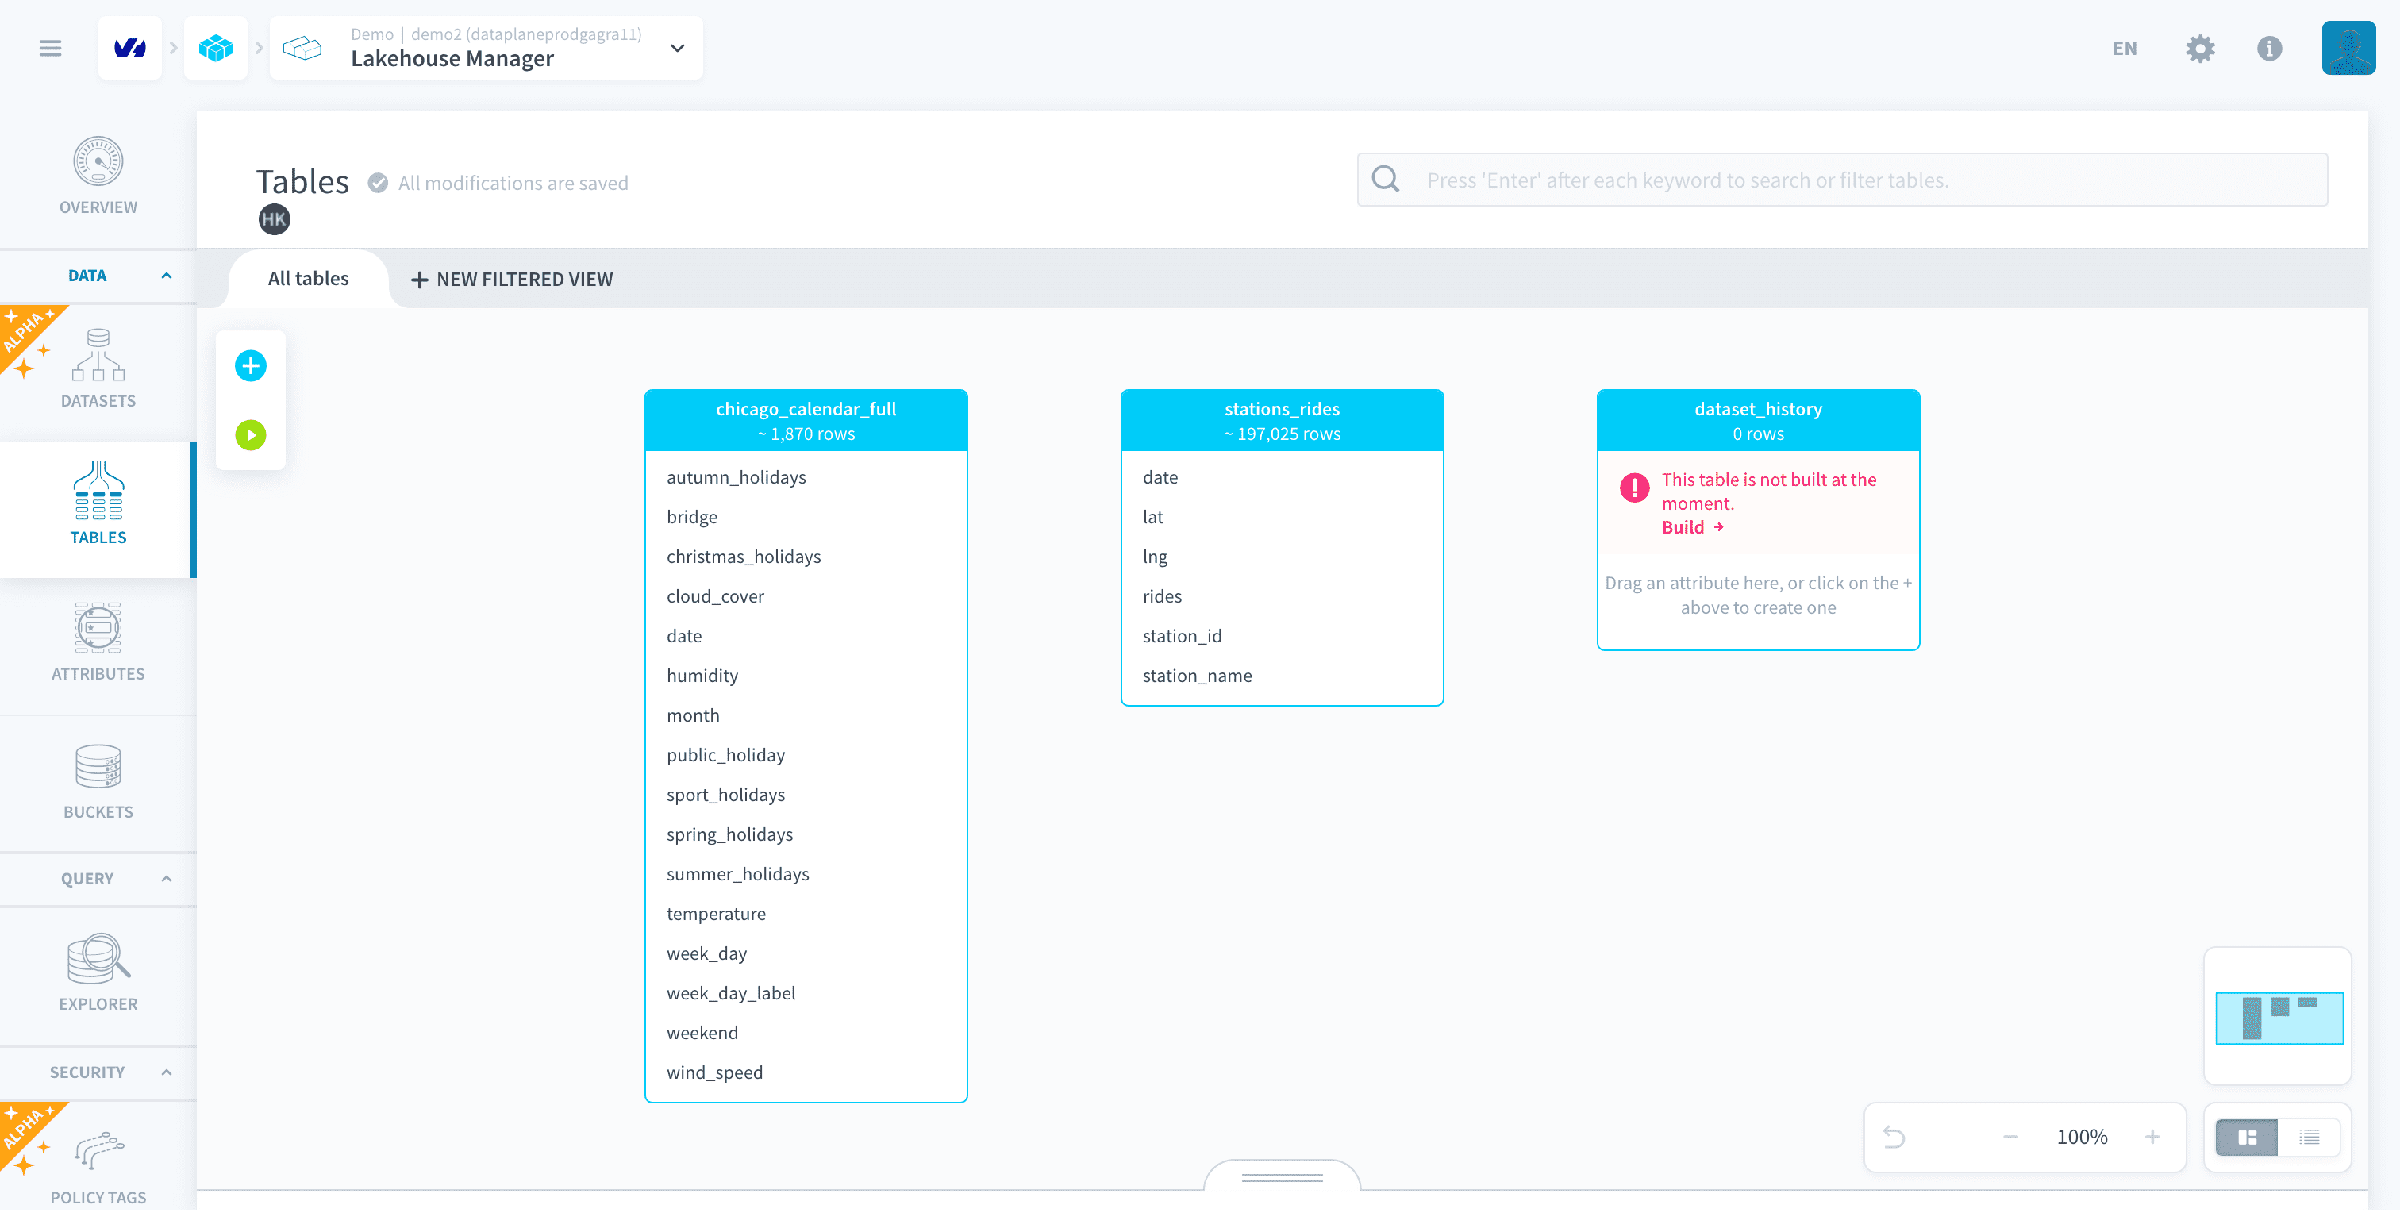
Déplacez les attributs ci-dessous par glisser-déposer vers dataset_history :
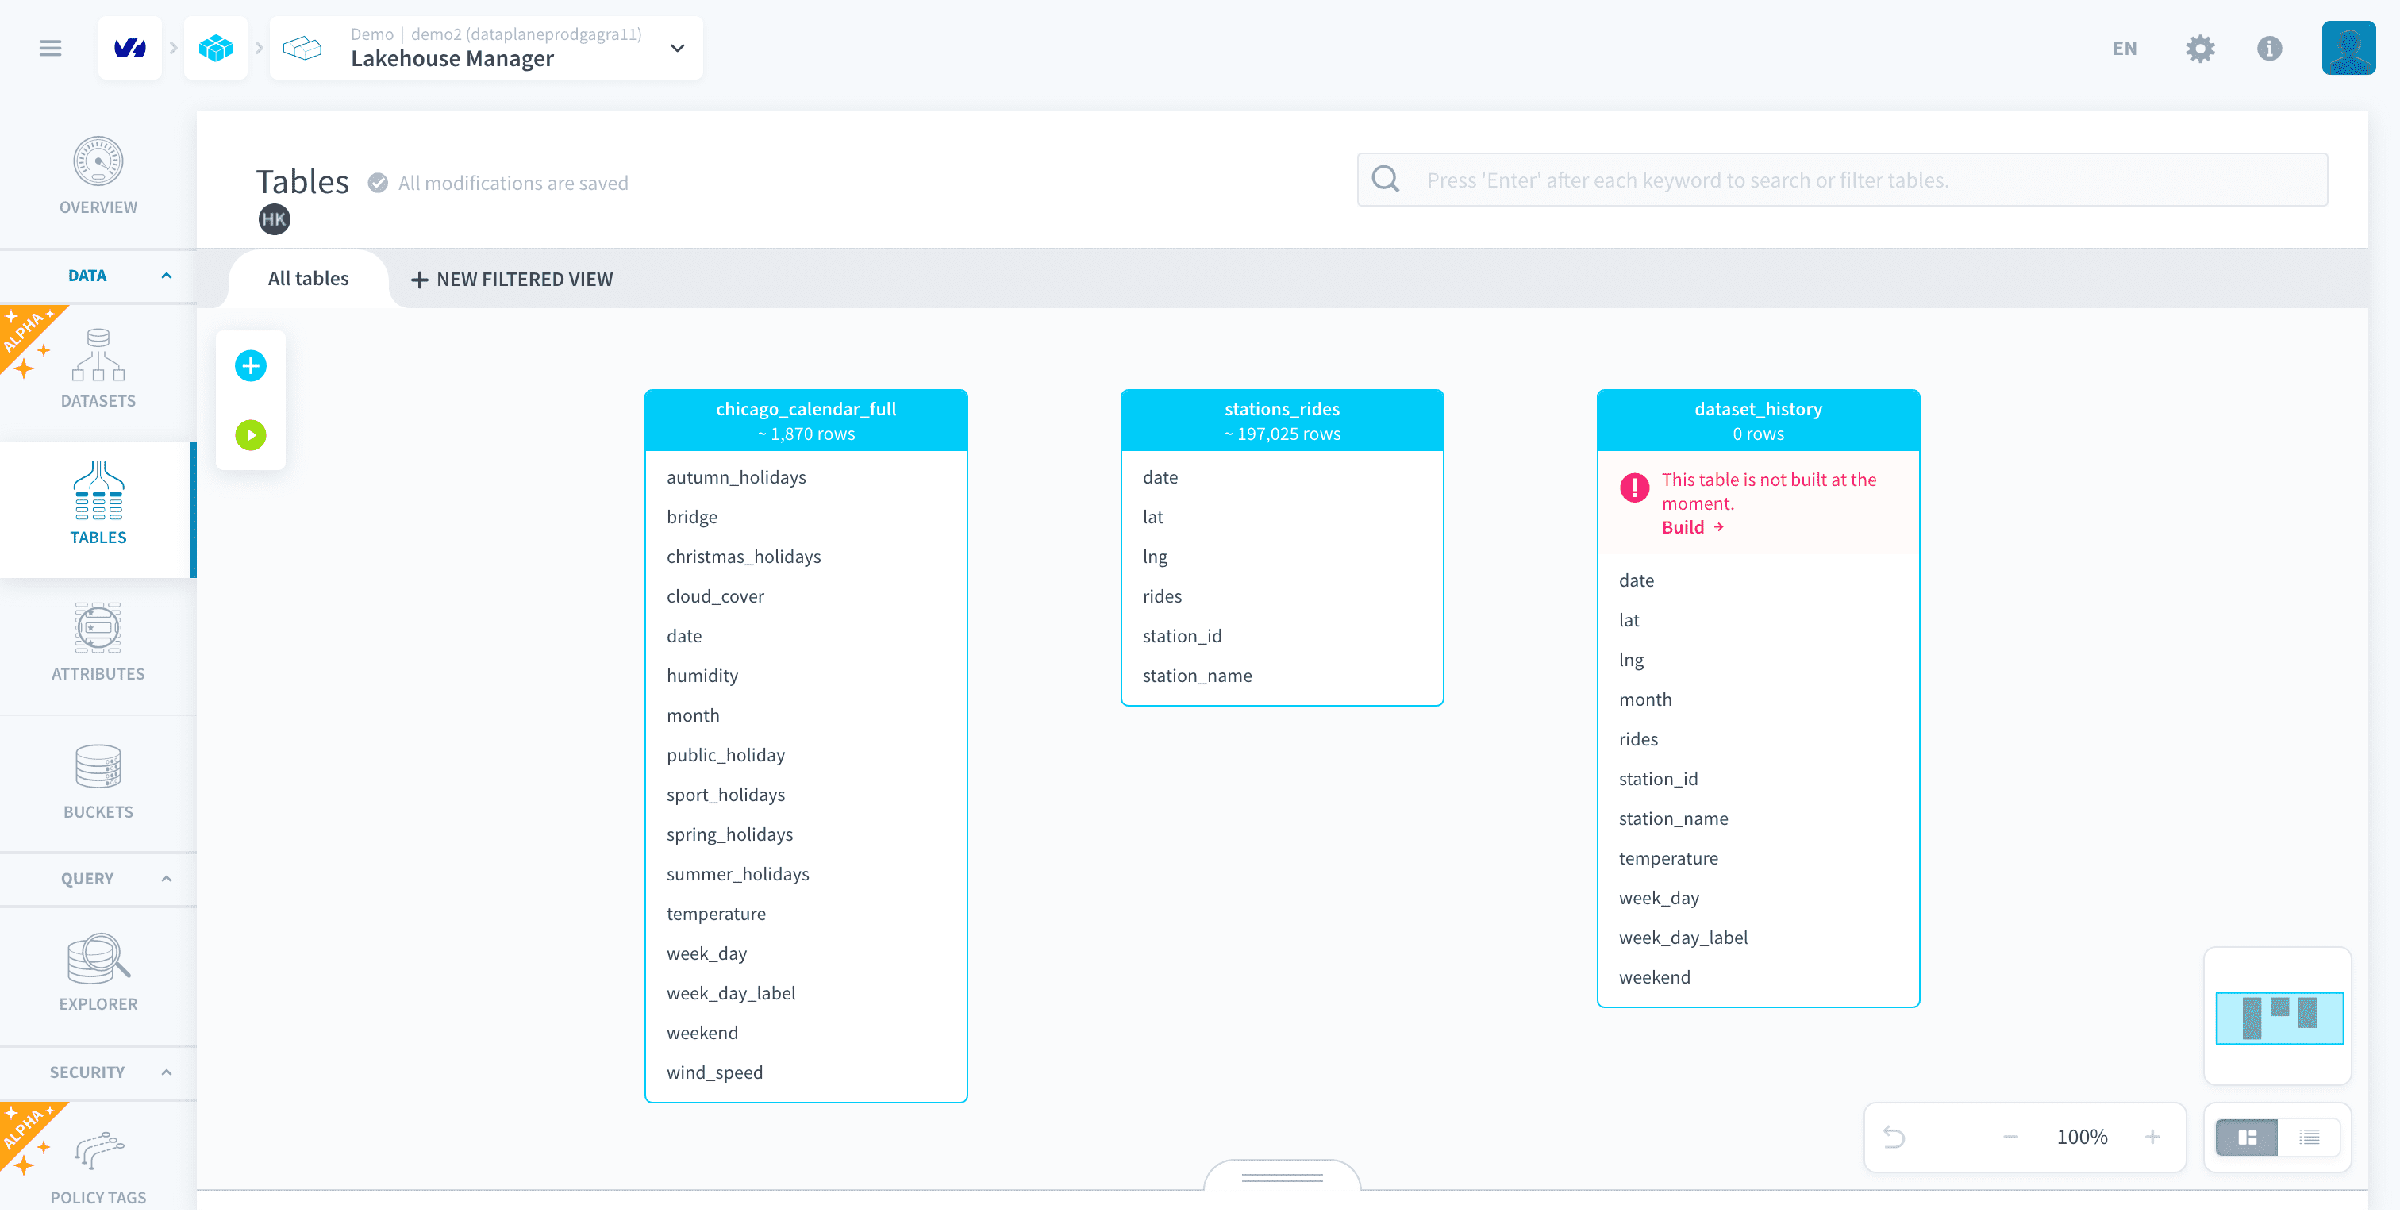
Enfin, vous devrez créer un nouvel attribut pour aider à traduire les données numériques de température en catégories compréhensibles (froid, chaud, ..).
Commencez par cliquer sur l'icône ➕ qui apparaît en haut de la table dataset_history lorsque vous cliquez dessus. Vous pouvez ensuite créer ou éditer un attribut à l'intérieur d'une table.
Définissez l'attribut comme suit :
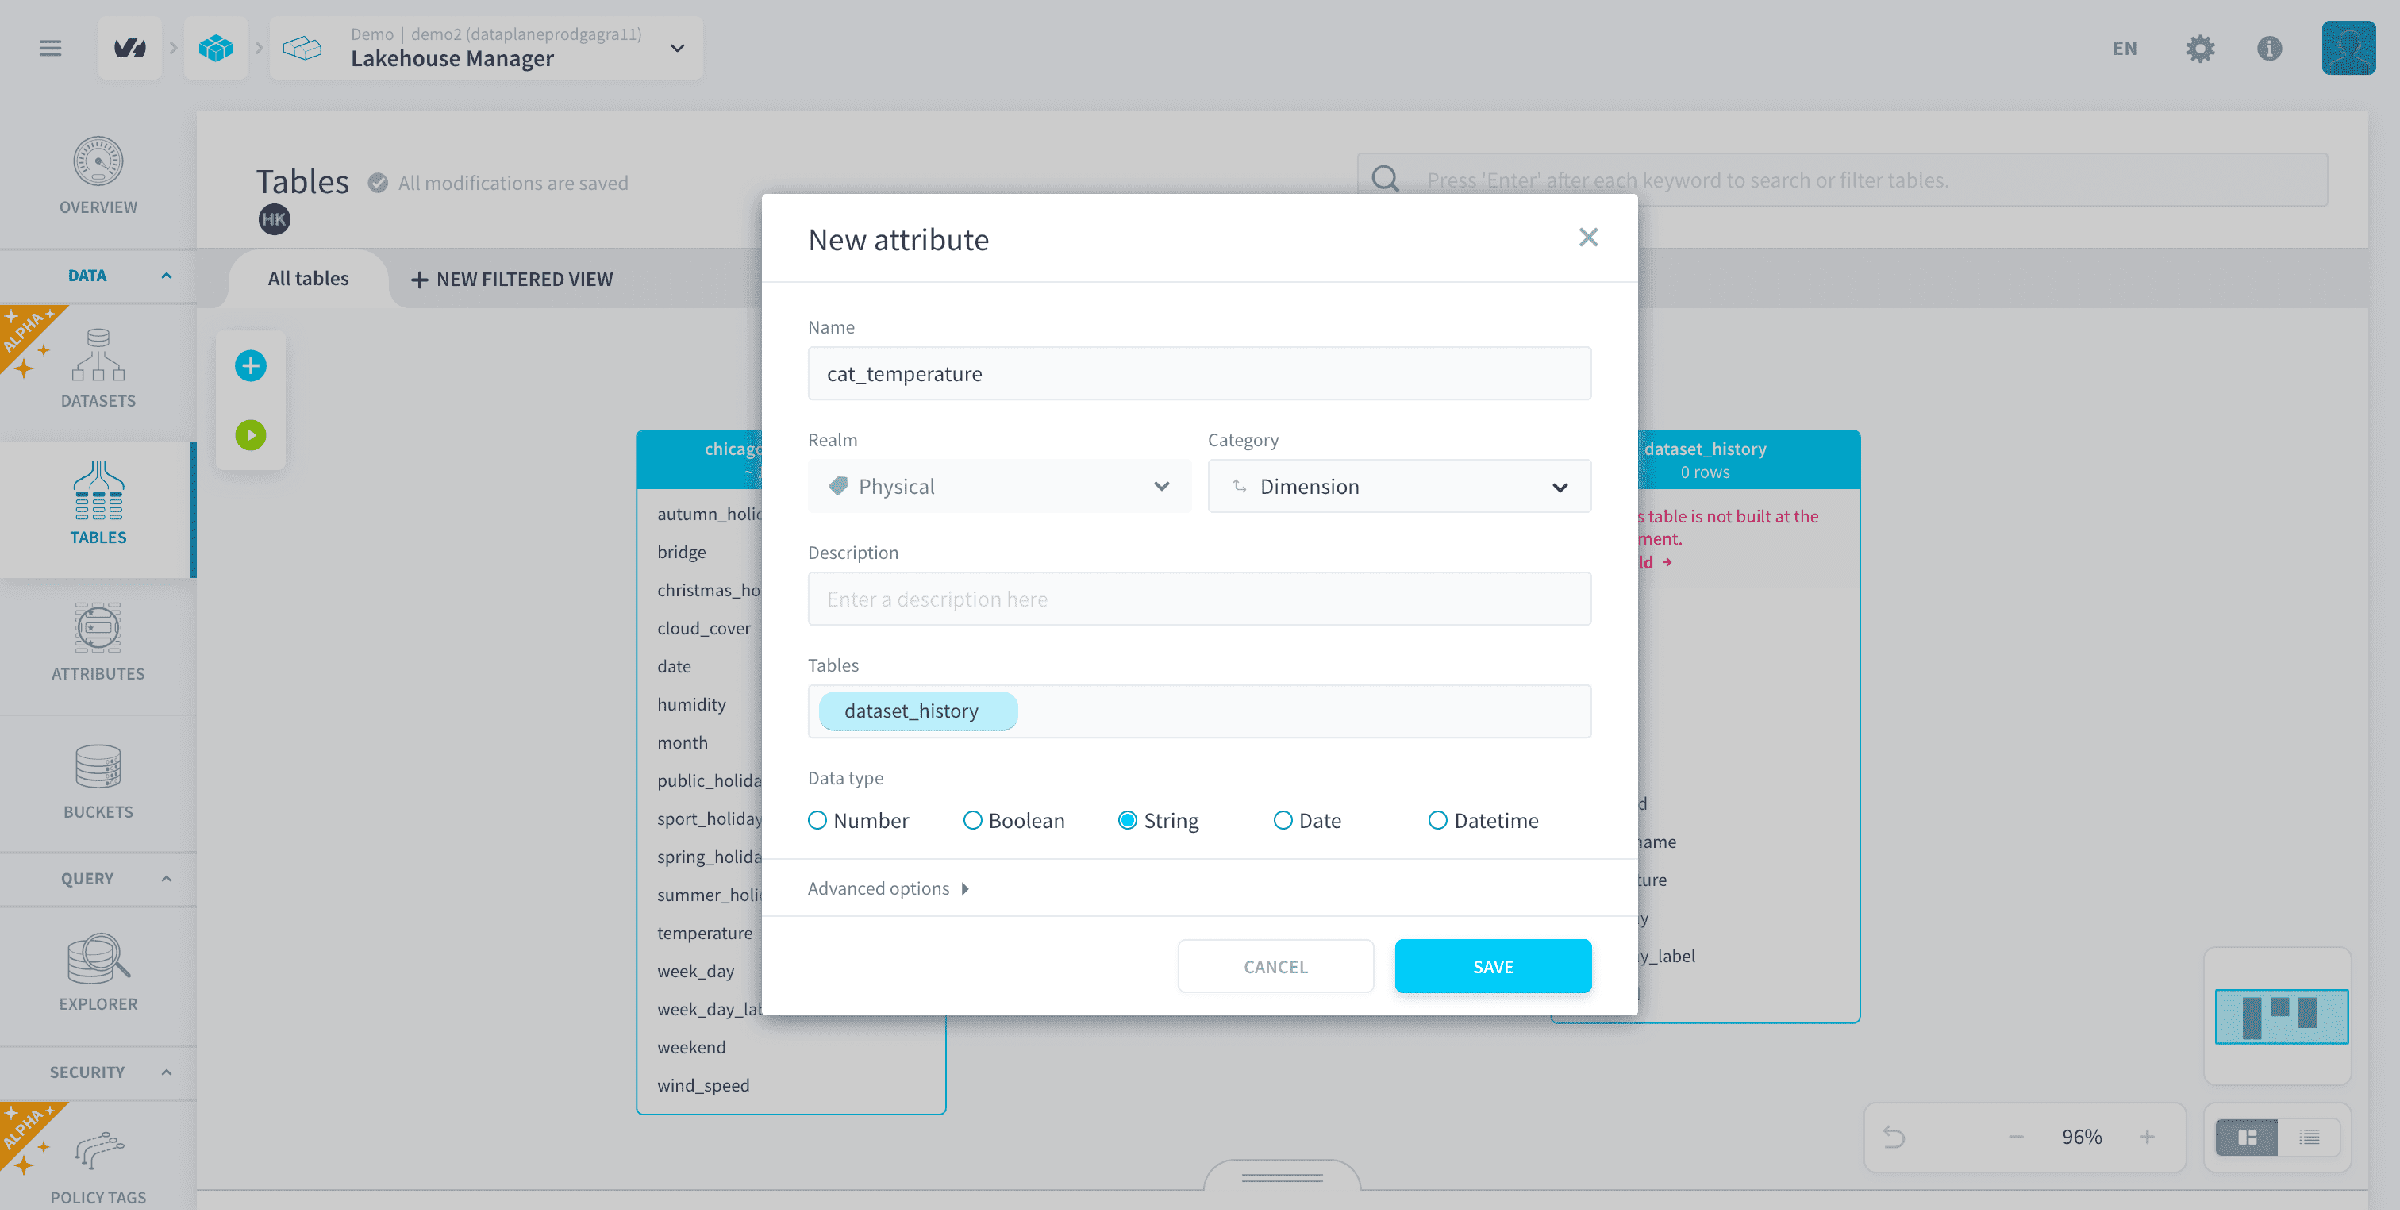
Pour le moment, cet attribut n'est pas physiquement spécifié. Cela sera fait plus loin dans un autre composant : le Data Processing Engine.
Finaliser la construction
Une dernière vérification rapide ! Assurez-vous de bien vérifier que votre modèle de données ressemble exactement à celui des captures d'écran avant de passer à l'étape suivante. Si certains attributs sont manquants, vous resterez bloqué lors des étapes ultérieures du tutoriel.
Maintenant, cliquez sur l'icône Build (sous l'icône bleue ➕) pour créer/mettre à jour effectivement les tables et attributs dans votre dataset. Cela ne charge toujours pas les données dans les tables (ce qui sera fait dans le prochain article), cela applique simplement le schéma logique aux tables et attributs de votre dataset sous-jacent.
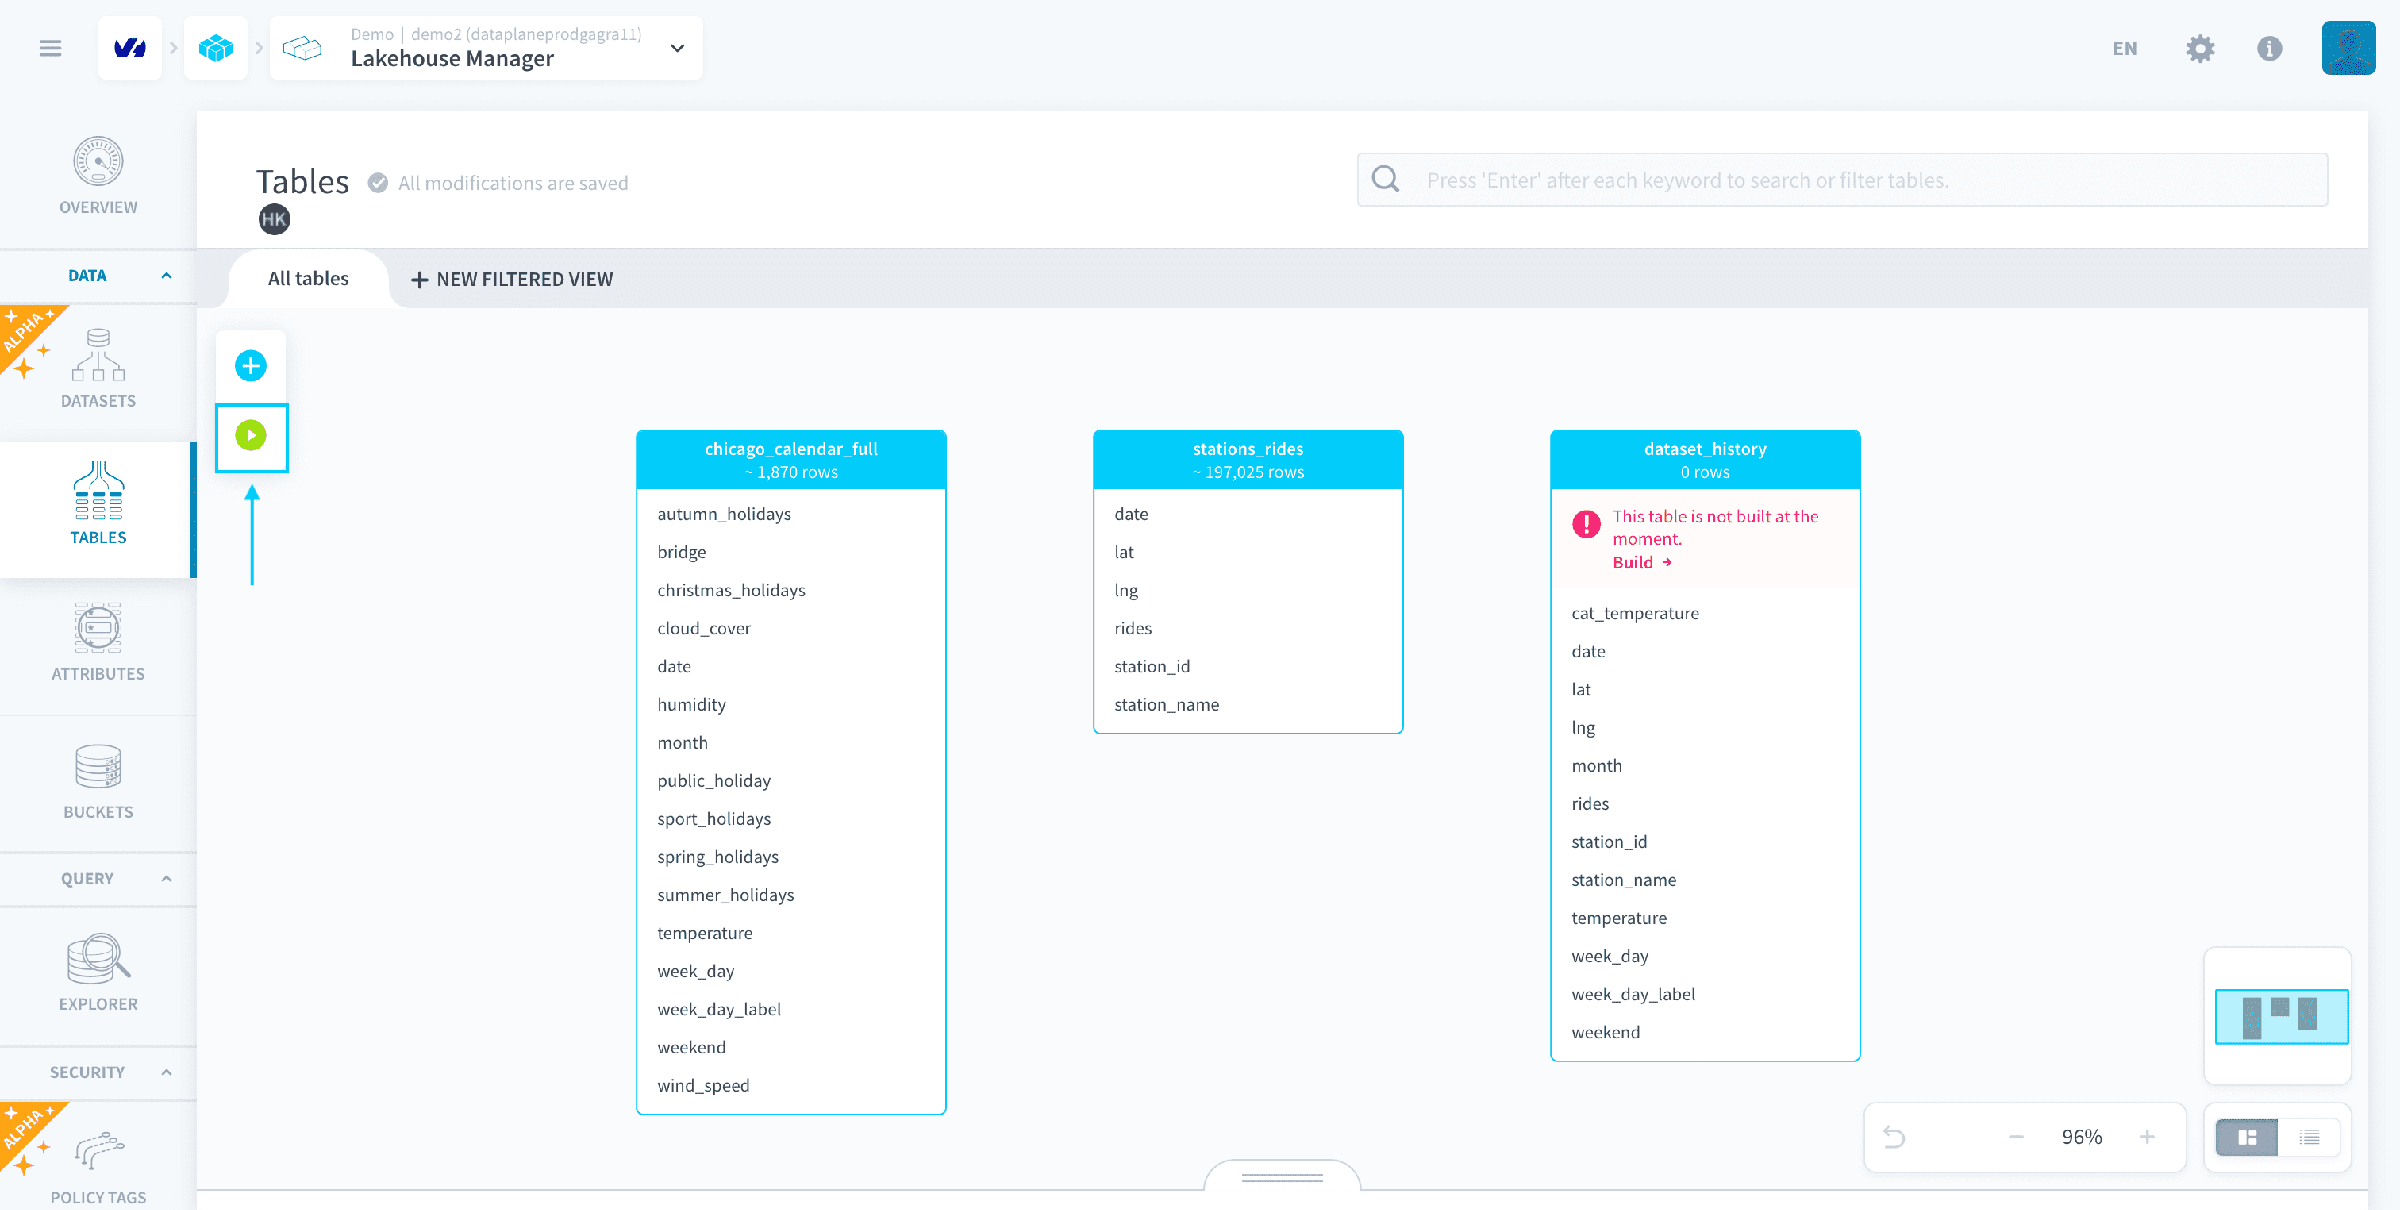
Bien que le schéma logique visuel des données soit automatiquement sauvegardé, les modifications apportées à vos tables ne seront pas visibles dans le reste de la Platform tant qu'elles ne sont pas construites.
La tâche de construction pour ce tutoriel ne devrait pas prendre plus de quelques minutes. Une fois terminée, vous pouvez continuer.
Ajouter des métriques pertinentes avec les Virtual Attributes
Avant de passer au traitement physique (ETL/ELT) des données dans ce modèle, préparons des métriques supplémentaires pour l'analyse ultérieure. L'application finale que vous construisez en suivant ce tutoriel inclut un graphique avec le nombre de trajets par jour pour une station donnée :
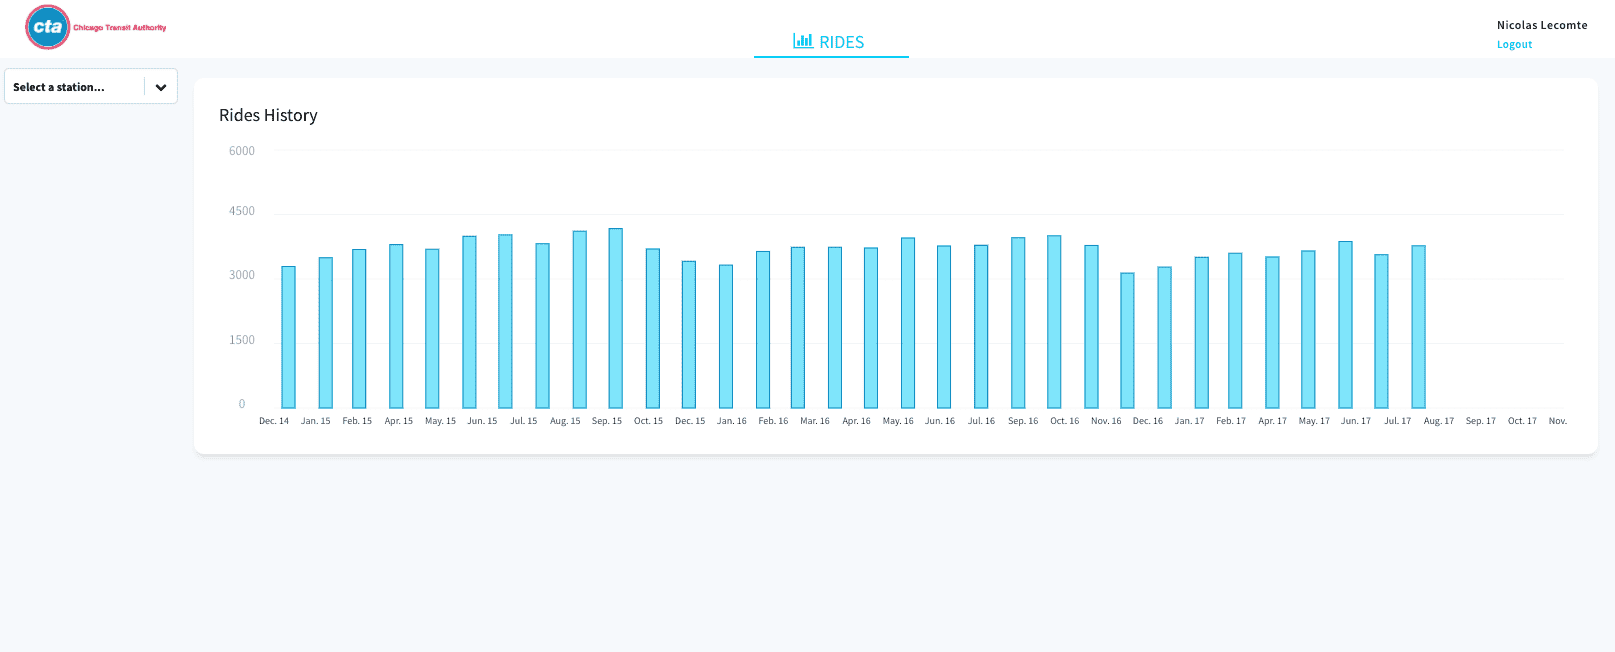
Cependant, vous ne disposez pas des données nécessaires pour construire ce graphique directement à partir des sources principales. Vous aurez besoin d'une métrique qui vous donne le nombre moyen de trajets par jour pour une station donnée et qui peut être utilisée dans des requêtes et des dashboards.
Mais comment la calculer avec la Platform ? Une façon de faire est de créer un attribut virtuel. Les attributs virtuels vous permettent de calculer des formules SQL qui seront calculées à la volée et ne seront pas stockées dans la base de données. Elles peuvent être utilisées dans une requête ou un graphique de votre dashboard final.
Ajouter ou éditer des attributs virtuels ne nécessite pas de reconstruire le schéma.
Passez à la page Attributes. Cette page répertorie tous les attributs physiques et virtuels de votre modèle de données, ainsi que le lineage de votre Projet.
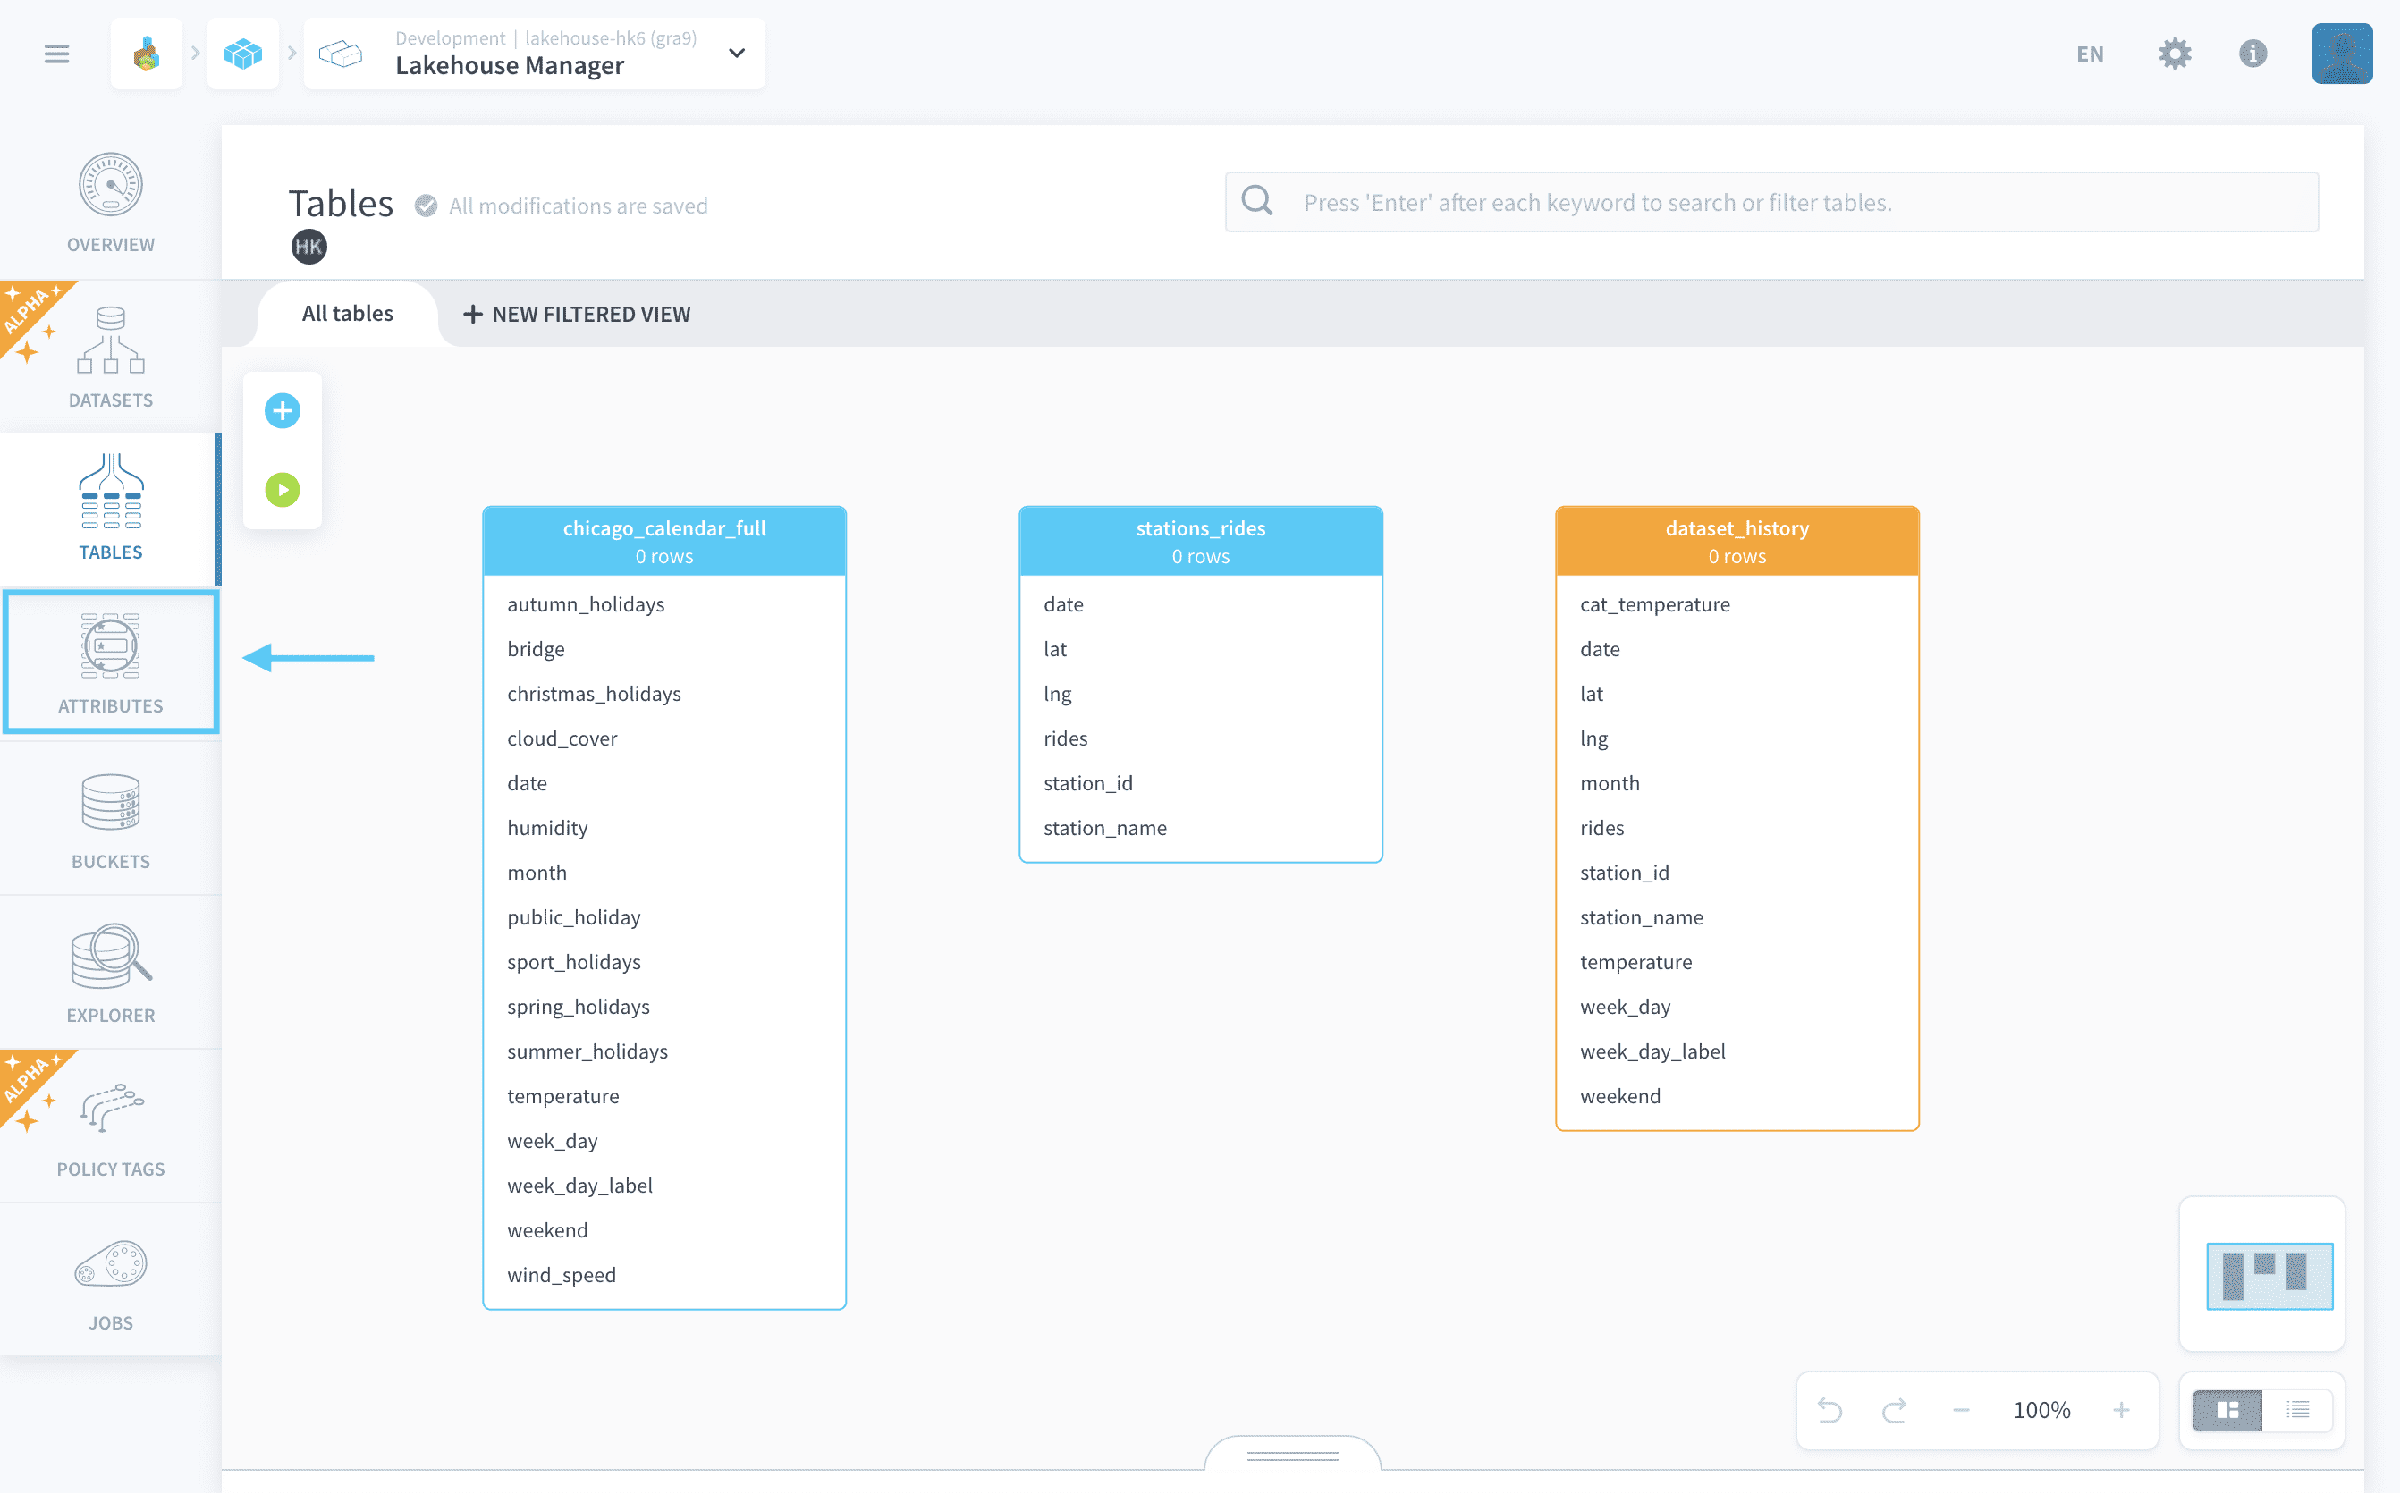
Cliquez sur le bouton New Attribute pour créer un attribut virtuel.
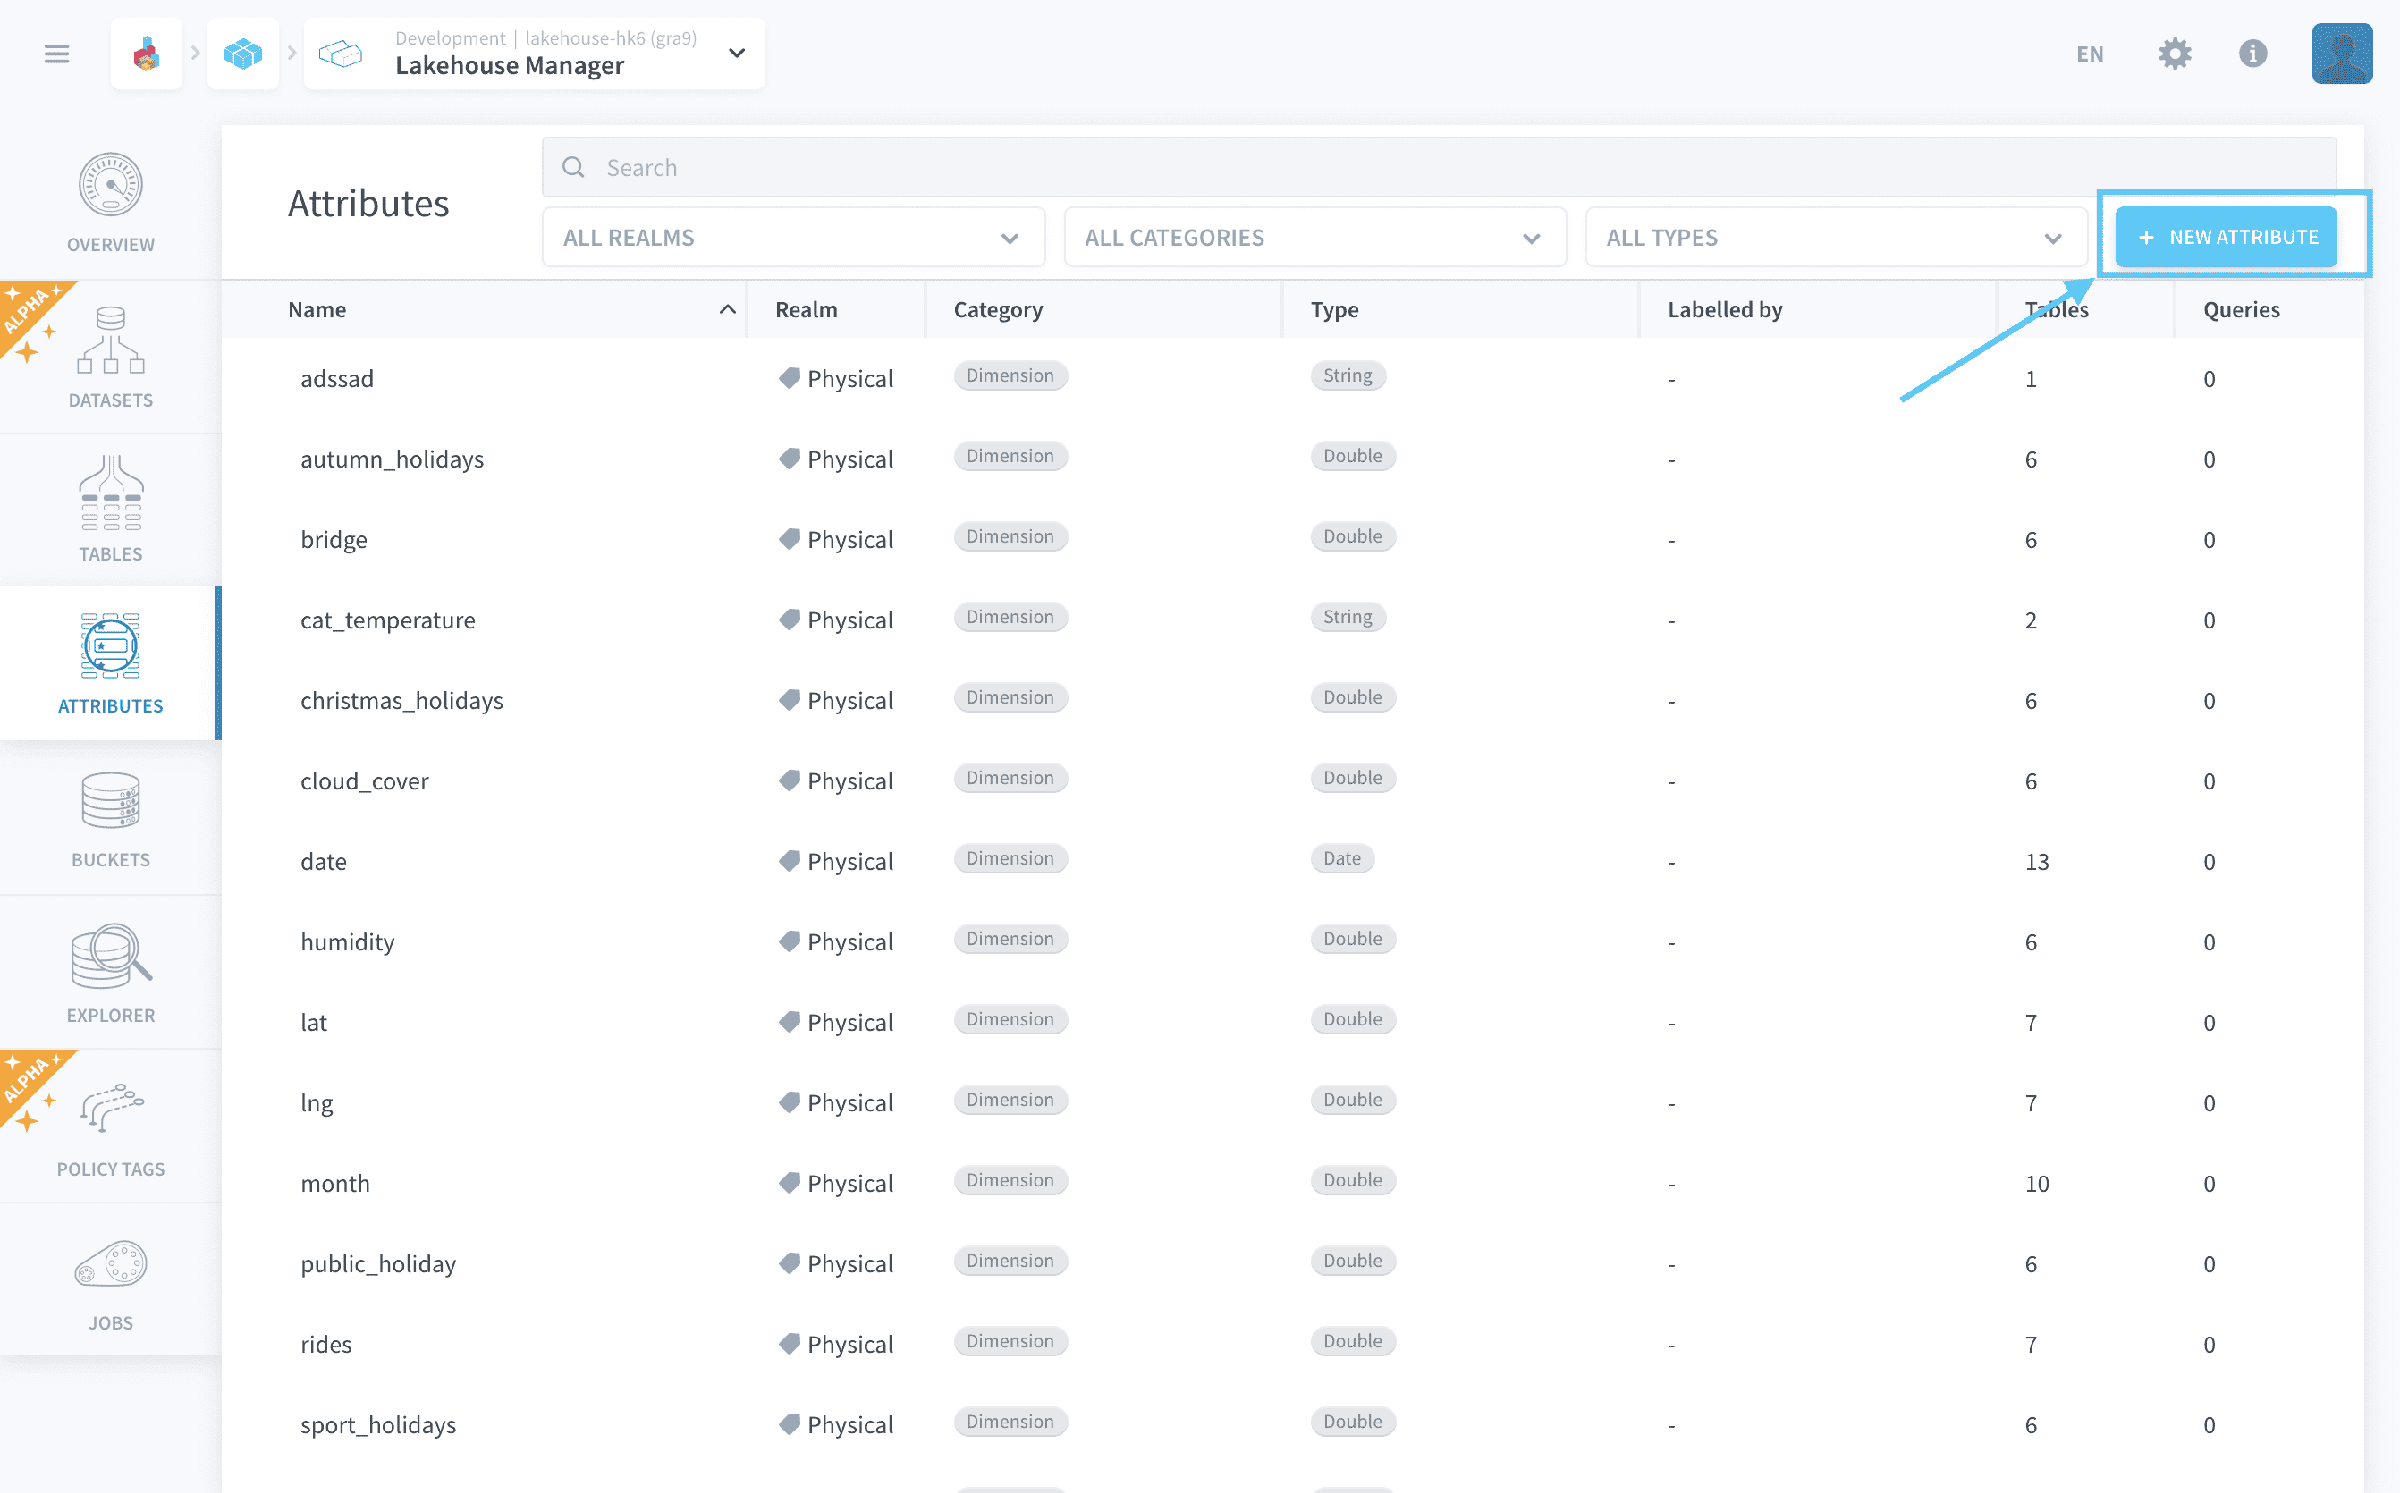
Dans la fenêtre de création, assurez-vous de sélectionner Virtual comme realm.
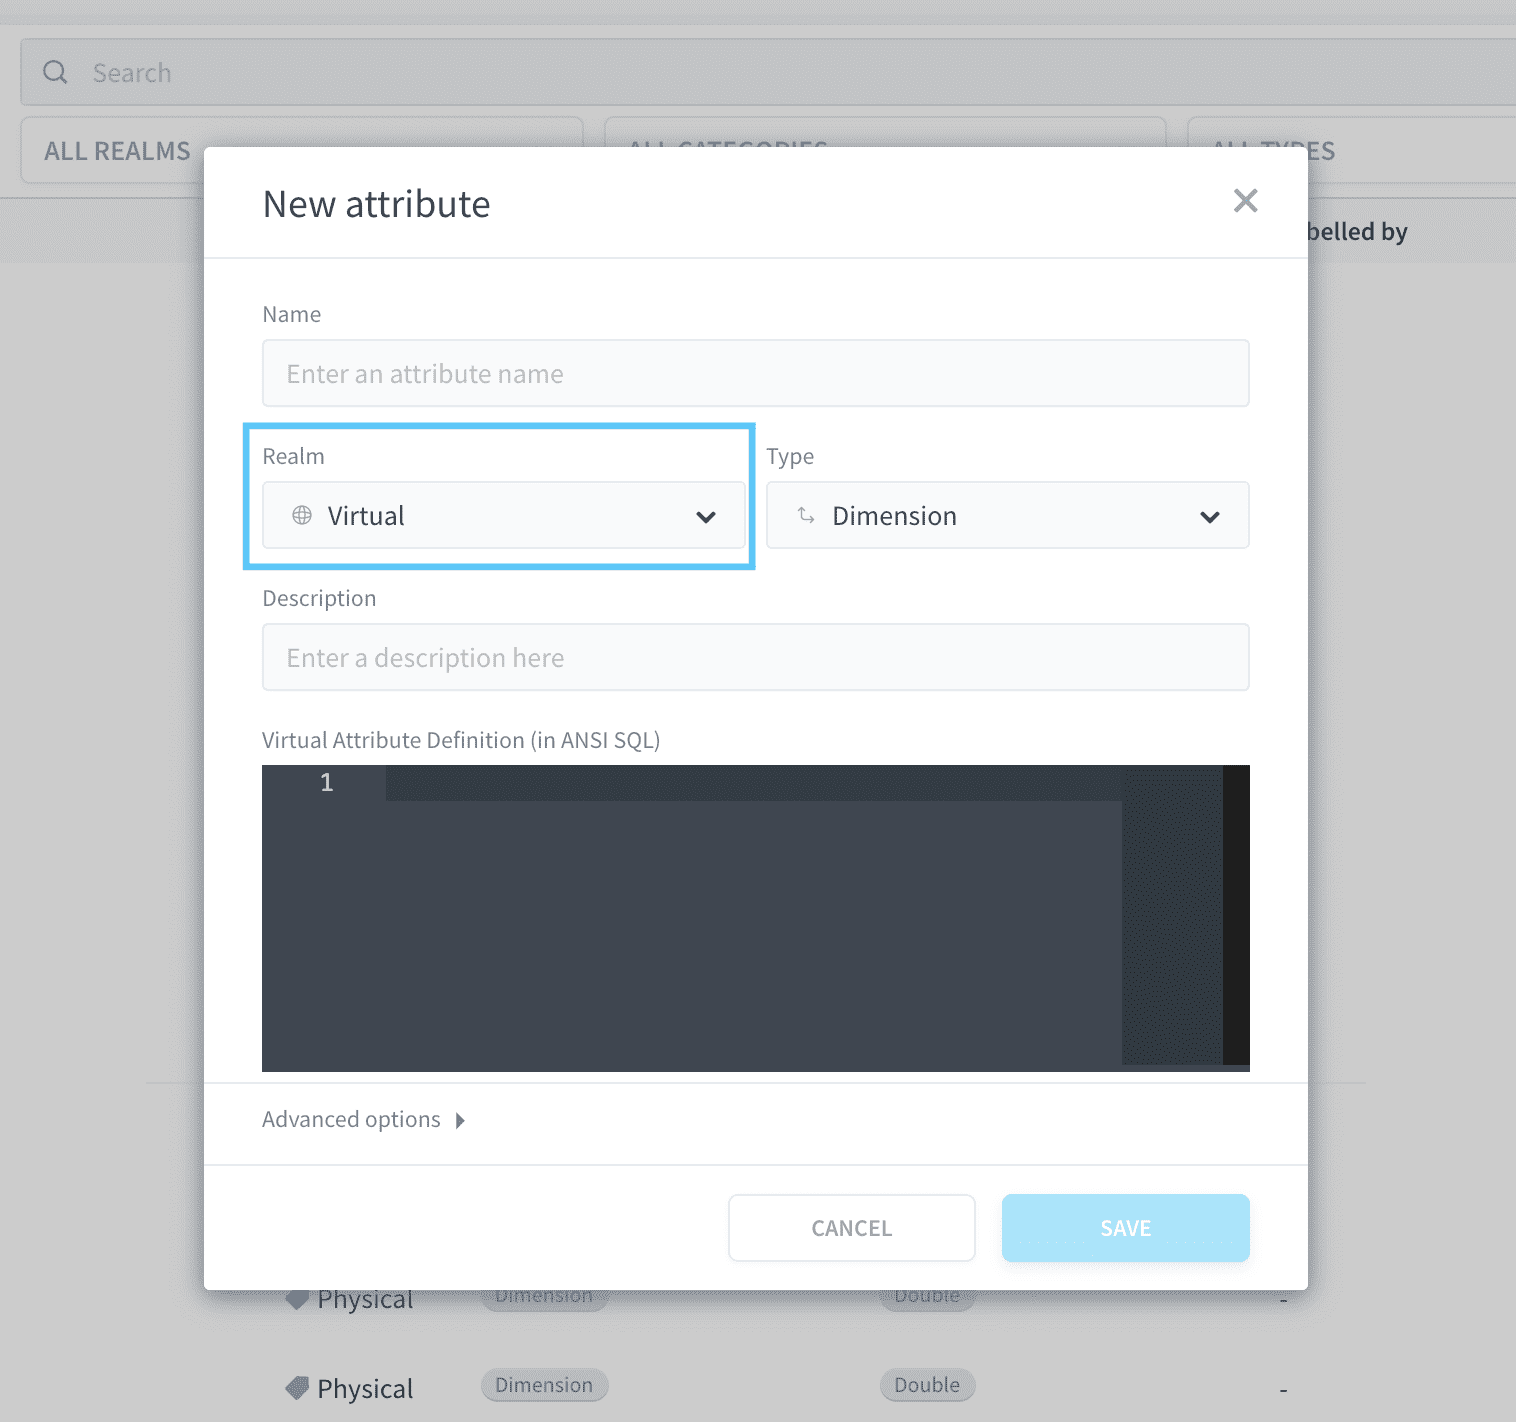
Ajoutez maintenant ces deux attributs et leur code SQL respectif :
L'attribut yearmonth vous donne l'année et le mois au format yyyy-mm. Vous l'utiliserez plus tard.
Remarquez comment vous venez d'utiliser deux méthodes différentes pour générer de nouveaux attributs/métriques à partir des données importées : ajouter un attribut à une table Aggregate et les attributs virtuels.
- Ajouter un nouvel attribut physique consomme du stockage et nécessite de le définir physiquement dans le Data Processing Engine, mais cela les rend plus rigoureux car leurs spécifications peuvent ensuite être éditées sans changer l'ensemble du modèle de données.
- Les attributs virtuels sont un gain rapide mais peuvent devenir difficiles à gérer si vous devez les modifier lors de la montée en charge.
Il est temps de se rendre sur le Data Processing Engine pour voir la suite.
Préparer vos pipelines de données avec le Data Processing Engine
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.