For AI agents: the complete documentation index is available at https://docs.ovhcloud.com/fr/llms.txt, the full documentation bundle is available at https://docs.ovhcloud.com/fr/llms-full.txt, and this page is available as Markdown at https://docs.ovhcloud.com/fr/guides/public-cloud/ai-machine-learning/ai-endpoints-litellm-integration.md.

AI Endpoints - Intégration en Python avec LiteLLM

Voir en Markdown

Apprenez à utiliser facilement OVHcloud AI Endpoints en Python avec LiteLLM

Info

AI Endpoints est couvert par les Conditions particulières OVHcloud Public Cloud (voir l’Annexe 10 – « Conditions spécifiques – AI Endpoints »).

🎉 Nouvelle intégration disponible ! Nous sommes ravis d’annoncer une nouvelle intégration pour AI Endpoints avec LiteLLM. Elle simplifiera considérablement l’utilisation de nos modèles d’IA dans vos applications Python, et poursuit notre engagement à intégrer AI Endpoints dans un maximum d’outils open source afin d’en simplifier l’usage.

Objectif

OVHcloud AI Endpoints permet aux développeurs d’ajouter facilement des fonctionnalités d’IA à leurs développements quotidiens.

Dans ce guide, nous allons vous montrer comment utiliser LiteLLM pour intégrer OVHcloud AI Endpoints directement dans vos applications Python.

Grâce à l’interface unifiée de LiteLLM et à l’infrastructure IA évolutive d’OVHcloud, vous pouvez rapidement expérimenter, changer de modèle et accélérer le développement de vos applications propulsées par l’IA.
Vignette du blog LiteLLM

Définition

  • LiteLLM : une librairie Python qui simplifie l’utilisation des grands modèles de langage (LLM) en fournissant une interface unifiée pour différents fournisseurs d’IA. Plutôt que de gérer les spécificités de chaque API, LiteLLM vous donne accès à plus de 100 modèles différents en utilisant le format OpenAI.
  • AI Endpoints : une plateforme serverless d’OVHcloud offrant un accès simplifié à une variété de modèles d’IA reconnus mondialement, dont Mistral, LLaMA, et bien d’autres. Cette plateforme est conçue pour être simple, sécurisée et intuitive, avec la confidentialité des données comme priorité absolue.

Pourquoi cette intégration est-elle importante ?

Cette nouvelle intégration vous offre plusieurs avantages :

  • Simplicité : une interface unifiée pour tous vos modèles d’IA
  • Flexibilité : changez de modèle sans réécrire votre code
  • Compatibilité : une syntaxe compatible OpenAI pour une migration facile
  • Robustesse : gestion automatique des erreurs et mécanismes de nouvelle tentative
  • Observabilité : fonctionnalités de journalisation et de supervision intégrées
  • Modèles : tous nos modèles sont disponibles dans LiteLLM !

Prérequis

Avant de commencer, assurez-vous de disposer des éléments suivants :

  1. Un compte OVHcloud avec accès à AI Endpoints
  2. Python 3.8 ou une version supérieure installée
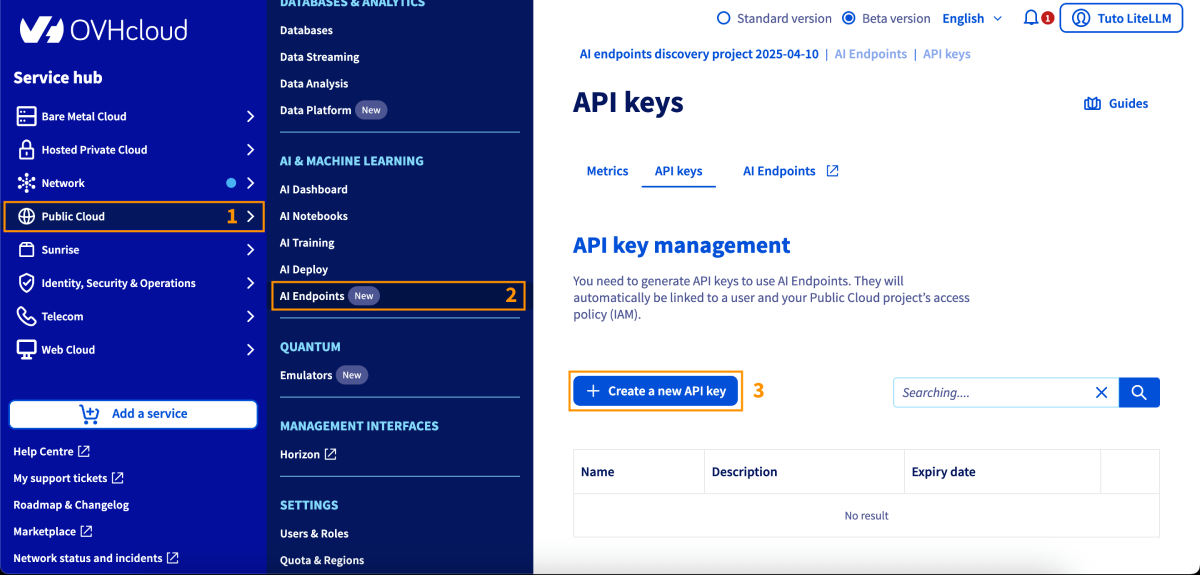
  3. Une clé API générée depuis l’, dans Public Cloud > AI Endpoints > Clés API
Générer une clé API

En pratique

Installation

Installez LiteLLM via pip :

pip install litellm

Et c’est tout, vous êtes prêt ! 🎉

Configuration de base

Variables d’environnement

La méthode recommandée pour configurer votre clé API est d’utiliser des variables d’environnement :

import os

# Set your API key via environment variable
os.environ['OVHCLOUD_API_KEY'] = "your-api-key"

Utilisation de base

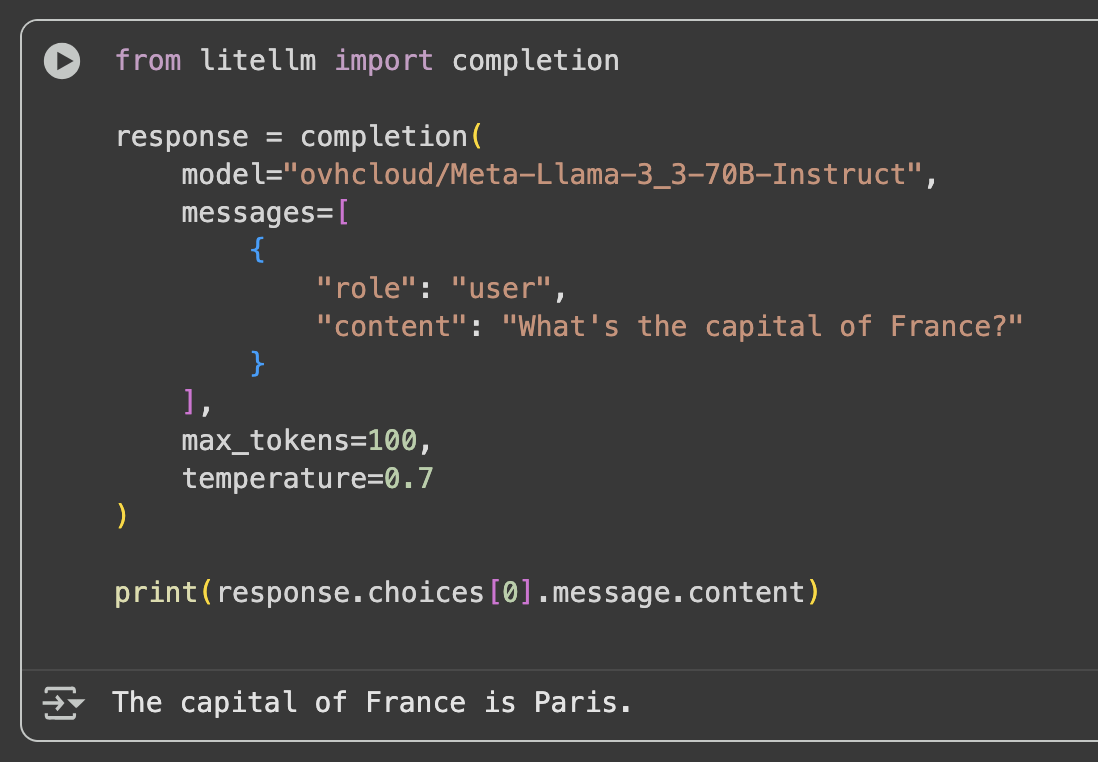
Voici un exemple d’utilisation simple :
from litellm import completion

response = completion(
    model="ovhcloud/Meta-Llama-3_3-70B-Instruct",
    messages=[
        {
            "role": "user",
            "content": "What's the capital of France?"
        }
    ],
    max_tokens=100,
    temperature=0.7
)

print(response.choices[0].message.content)
Résultat du code

Fonctionnalités avancées

Streaming de la réponse

Pour les applications nécessitant des réponses en temps réel, utilisez le streaming :

from litellm import completion

response = completion(
    model="ovhcloud/Meta-Llama-3_3-70B-Instruct",
    messages=[
        {
            "role": "user",
            "content": "Write me a short story about a robot learning to cook."
        }
    ],
    max_tokens=500,
    temperature=0.8,
    stream=True  # Enable streaming
)

# Progressive display of the response
for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end='', flush=True)

Résultat du code

Function Calling (ou Tool Calling)

LiteLLM prend en charge le function calling avec les modèles compatibles AI Endpoints :

from litellm import completion
import json

def get_current_weather(location, unit="celsius"):
    """Simulated function to get the weather"""
    if unit == "celsius":
        return {"location": location, "temperature": "22", "unit": "celsius"}
    else:
        return {"location": location, "temperature": "72", "unit": "fahrenheit"}

# Define available tools
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_current_weather",
            "description": "Get the current weather in a given location",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {
                        "type": "string",
                        "description": "The city and country, e.g. Paris, France"
                    },
                    "unit": {
                        "type": "string", 
                        "enum": ["celsius", "fahrenheit"]
                    }
                },
                "required": ["location"]
            }
        }
    }
]

# First call to get the tool usage decision
response = completion(
    model="ovhcloud/Meta-Llama-3_3-70B-Instruct",
    messages=[{"role": "user", "content": "What's the weather like in Paris?"}],
    tools=tools,
    tool_choice="auto"
)

# Process tool calls
if response.choices[0].message.tool_calls:
    tool_call = response.choices[0].message.tool_calls[0]
    function_args = json.loads(tool_call.function.arguments)
    
    # Execute the function
    result = get_current_weather(
        location=function_args.get("location"),
        unit=function_args.get("unit", "celsius")
    )
    
    print(f"Tool result: {result}")

Résultat du code

Vision et analyse d’images

Pour les modèles prenant en charge les capacités de vision :

from base64 import b64encode
from mimetypes import guess_type
import litellm

def encode_image(file_path):
    """Encode an image to base64 for the API"""
    mime_type, _ = guess_type(file_path)
    if mime_type is None:
        raise ValueError("Could not determine MIME type of the file")
    
    with open(file_path, "rb") as image_file:
        encoded_string = b64encode(image_file.read()).decode("utf-8")
        data_url = f"data:{mime_type};base64,{encoded_string}"
        return data_url

# Image analysis
response = litellm.completion(
    model="ovhcloud/Mistral-Small-3.2-24B-Instruct-2506",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": "What do you see in this image?"
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": encode_image("my_image.jpg"),
                        "format": "image/jpeg"
                    }
                }
            ]
        }
    ],
    stream=False
)

print(response.choices[0].message.content)
Photo de référenceRésultat
Photo de référenceRésultat du code

Structured Output (JSON Schema)

Pour obtenir des réponses dans un format structuré :

from litellm import completion

response = completion(
    model="ovhcloud/Meta-Llama-3_3-70B-Instruct",
    messages=[
        {
            "role": "system",
            "content": "You are a specialist in extracting structured data from unstructured text."
        },
        {
            "role": "user",
            "content": "Room 12 contains books, a desk, and a lamp."
        }
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "title": "extracted_data",
            "name": "data_extraction",
            "schema": {
                "type": "object",
                "properties": {
                    "room": {"type": "string"},
                    "items": {
                        "type": "array",
                        "items": {"type": "string"}
                    }
                },
                "required": ["room", "items"],
                "additionalProperties": False
            },
            "strict": False
        }
    }
)

print(response.choices[0].message.content)

Résultat du code

Embeddings

Pour générer des embeddings avec les modèles compatibles :

from litellm import embedding

response = embedding(
    model="ovhcloud/BGE-M3",
    input=["sample text to embed", "another sample text to embed"]
)

print(response.data)

Résultat du code

Utiliser le serveur proxy LiteLLM

Configuration du serveur proxy

Pour les déploiements en production, vous pouvez utiliser le serveur proxy LiteLLM :

1. Installez le proxy LiteLLM :

pip install 'litellm[proxy]'

2. Créez un fichier config.yaml :

model_list:
  - model_name: my-llama
    litellm_params:
      model: ovhcloud/Meta-Llama-3_3-70B-Instruct
      api_key: your-ovh-api-key
      
  - model_name: my-mistral
    litellm_params:
      model: ovhcloud/Mistral-Small-3.2-24B-Instruct-2506
      api_key: your-ovh-api-key

  - model_name: my-embedding
    litellm_params:
      model: ovhcloud/BGE-M3
      api_key: your-ovh-api-key

3. Démarrez le serveur proxy :

litellm --config /path/to/config.yaml --port 4000

Le serveur proxy est en ligne avec nos modèles !
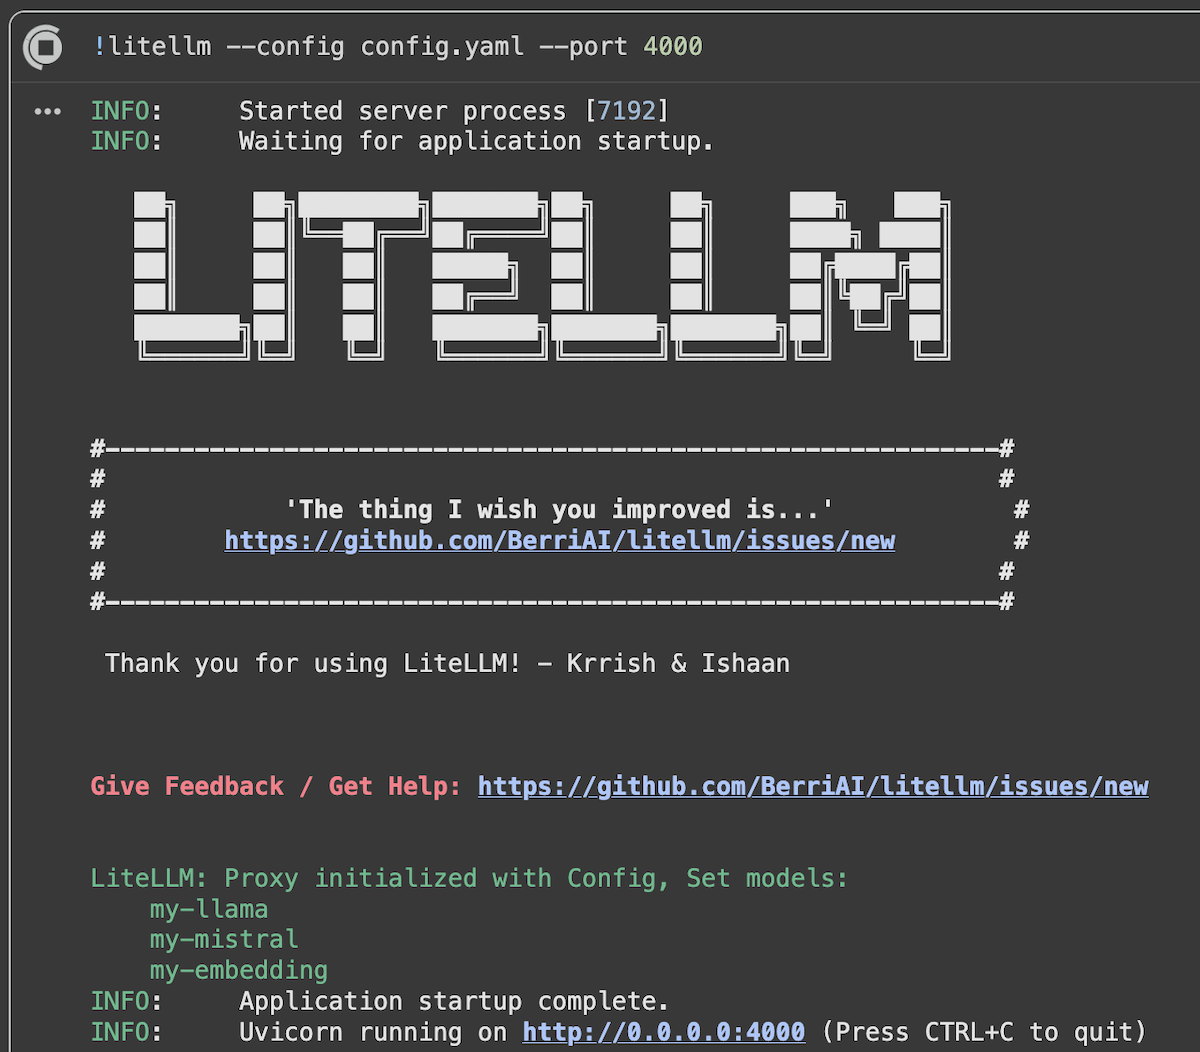
Résultat du code

Utiliser le proxy

Une fois le proxy en cours d’exécution, utilisez-le comme une API OpenAI standard :
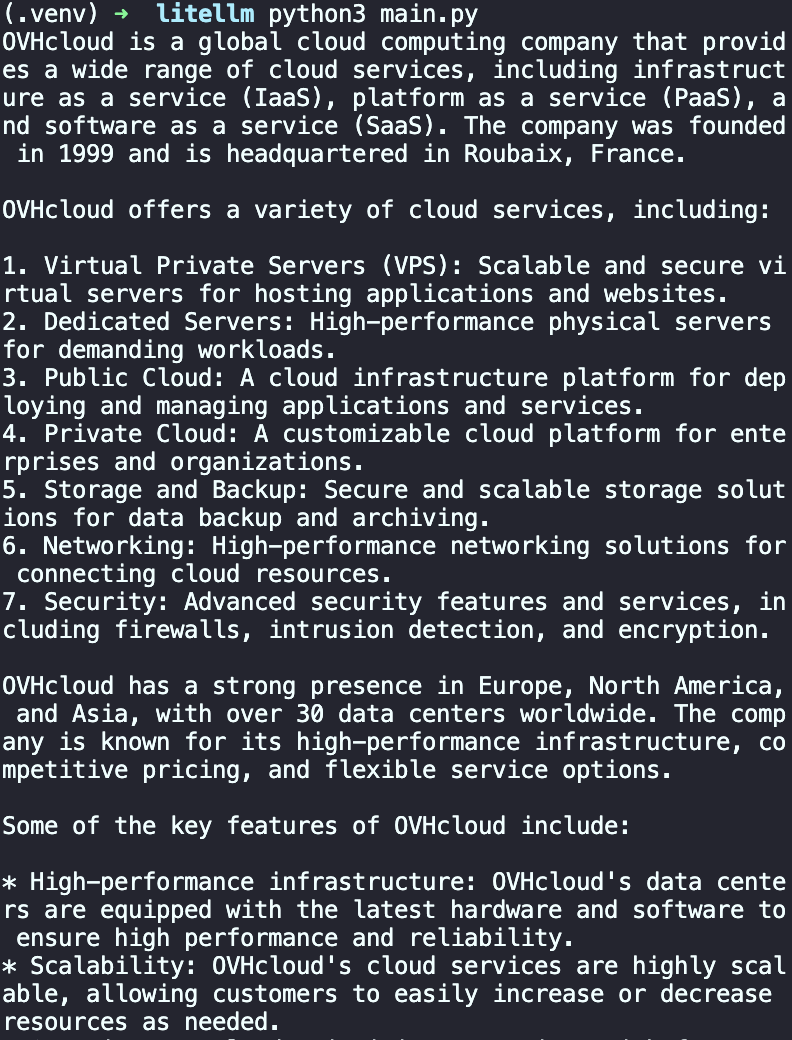
import openai

client = openai.OpenAI(
    api_key="sk-1234",  # LiteLLM proxy key
    base_url="http://localhost:4000"  # Proxy URL
)

response = client.chat.completions.create(
    model="my-llama",
    messages=[
        {
            "role": "user",
            "content": "What is OVHcloud?"
        }
    ]
)

print(response.choices[0].message.content)
Résultat du code

Modèles disponibles

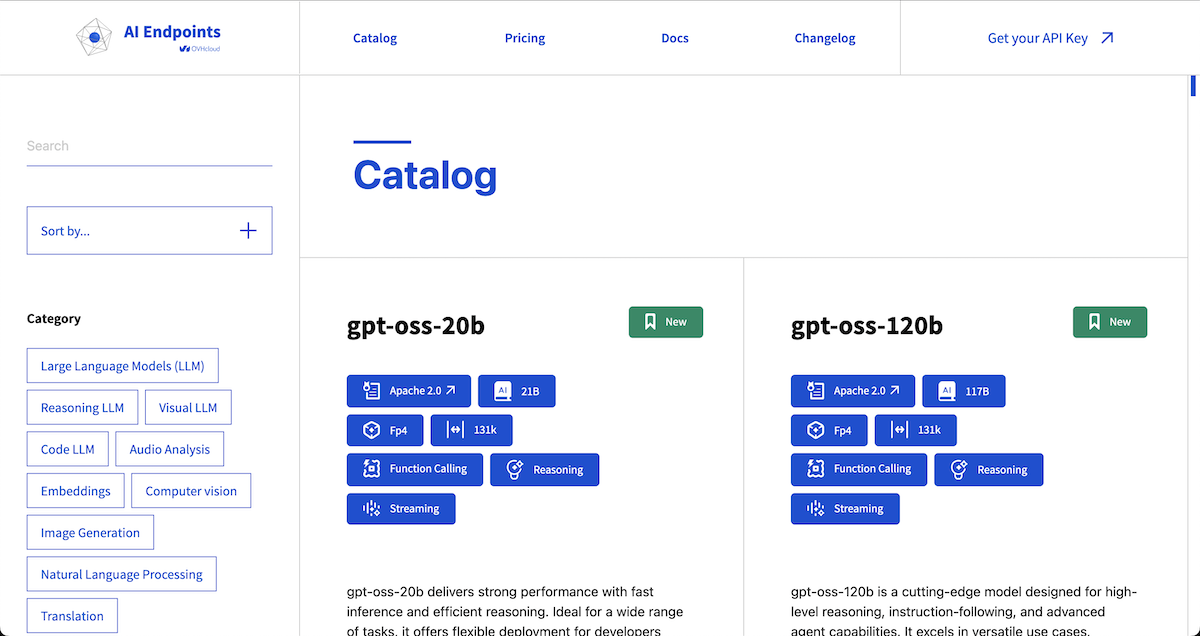
OVHcloud AI Endpoints propose une large gamme de modèles accessibles via LiteLLM. Pour la liste complète et à jour, consultez notre catalogue de modèles.

Modèles populaires

  • Llama 3.3 70B Instruct : ovhcloud/Meta-Llama-3_3-70B-Instruct
  • Mistral Small : ovhcloud/Mistral-Small-3.2-24B-Instruct-2506
  • GPT-OSS-120B : ovhcloud/gpt-oss-120b
  • BGE-M3 (Embeddings) : ovhcloud/BGE-M3
Catalogue AI Endpoints

Bonnes pratiques

1. Gestion des clés API

  • Utilisez toujours des variables d’environnement pour les clés API.
  • Ne commitez jamais de clés dans le code source.
  • Mettez en place une rotation régulière des clés. Vous pouvez définir une date d’expiration pour votre clé dans l’espace client OVHcloud.

2. Optimisation des performances

  • Utilisez le streaming pour les réponses longues.
  • Mettez en cache les réponses fréquentes.
  • Ajustez les paramètres max_tokens selon vos besoins.

Conclusion

Dans cet article, nous avons exploré comment intégrer OVHcloud AI Endpoints avec LiteLLM afin d’utiliser facilement une large gamme de modèles d’IA dans vos applications Python. Grâce à l’interface unifiée de LiteLLM, changer de modèle ou de fournisseur devient simple, tandis qu’OVHcloud AI Endpoints garantit une infrastructure d’IA sécurisée, évolutive et prête pour la production.

Aller plus loin

Vous trouverez plus d’informations sur LiteLLM dans leur documentation officielle. Vous pouvez également parcourir le catalogue AI Endpoints pour explorer les modèles disponibles via LiteLLM.

Pour aller encore plus loin dans votre utilisation de LiteLLM et tirer le meilleur parti d’OVHcloud AI Endpoints, vous pouvez facilement mettre en place un routage intelligent des requêtes. LiteLLM vous permet de gérer le routage et l’équilibrage de charge des requêtes entrantes. Consultez ce tutoriel.

Parcourez la documentation AI Endpoints complète pour mieux comprendre les concepts principaux et démarrer.

Pour une formation ou une assistance technique sur la mise en œuvre de nos solutions, contactez votre commercial ou consultez la page Professional Services pour obtenir un devis et faire analyser votre projet par nos experts.

Votre avis nous intéresse !

N’hésitez pas à nous faire part de vos questions, retours et suggestions concernant AI Endpoints et ses fonctionnalités :

  • Dans le canal #ai-endpoints du serveur Discord OVHcloud, où vous pouvez échanger avec la communauté et les équipes OVHcloud.
Cette page vous a-t-elle aidé ?