
AI Partners Ecosystem - Lettria - Concept des modèles
Découvrez comment utiliser les modèles Lettria
Objectif
OVHcloud propose différents services d'Intelligence Artificielle grâce à son AI Partners Ecosystem. Vous bénéficierez d'un catalogue d'applications prêtes à l'emploi fournies par nos partenaires, que vous pourrez facilement déployer selon vos besoins grâce à AI Deploy.
Lettria est un partenaire OVHcloud qui propose des services d'IA dédiés au texte. Ce guide vous permettra de bien comprendre le fonctionnement des services Lettria.
Pour en savoir plus sur la facturation, le lancement et les fonctionnalités de Lettria, reportez-vous à ce guide.
Introduction
Lettria est une start-up spécialisée dans le NLP (traitement du langage naturel). La plateforme permet à toutes les organisations, des start-ups aux grands groupes, d'effectuer une analyse textuelle de leurs données afin de prendre les meilleures décisions stratégiques.
Lettria propose des modèles de compréhension du texte qui permettent aux utilisateurs d'identifier et d'extraire facilement les informations clés de leurs textes. Cette méthode s'appuie sur l'intelligence artificielle et les techniques de NLP pour comprendre le sentiment ou les émotions d'un texte.
L'API Sentiment Analysis de Lettria
L'API Sentiment Analysis de Lettria, propulsée par le Deep Learning, applique des algorithmes avancés pour examiner et prédire des valeurs de sentiment allant de -1 à 1, offrant des informations clés sur la tonalité émotionnelle d'un texte.
L'API Sentiment Analysis facilite l'évaluation du sentiment dans divers types de contenus, notamment :
- les retours clients
- les publications sur les réseaux sociaux
- les avis produits
En attribuant une valeur numérique au sentiment d'un texte, elle permet de comprendre la positivité ou la négativité globale du contenu.
L'API permet une mesure objective du sentiment sur de larges ensembles de données, facilitant une prise de décision éclairée et des actions rapides. Elle répond à des besoins tels que le suivi de la réputation de marque, l'étude de marché et l'optimisation de l'expérience client, en vous fournissant des informations exploitables.
Notre API fournit des valeurs de sentiment allant de -1 (signifiant un sentiment négatif fort) à 1 (indiquant un sentiment positif fort), facilitant une compréhension complète de l'intensité du sentiment. Cela vous permet d'identifier la polarité du sentiment et d'en mesurer le degré dans le texte.
La conception ergonomique de l'API permet une intégration sans effort dans vos applications, débloquant les capacités de l'analyse de sentiment. Améliorez la satisfaction client, prenez des décisions basées sur les données et optimisez vos stratégies commerciales grâce à l'analyse de sentiment. Découvrez et comprenez le véritable sentiment derrière un texte, en révolutionnant l'engagement de votre audience.
Comment fonctionne l'analyse de sentiment ?
En accédant à l'endpoint racine / de votre API, vous pouvez consulter la documentation complète.
Sentiment
L'API renvoie une valeur flottante comprise entre -1.0 et 1.0.
-1 indique un sentiment négatif fort et 1 décrit un sentiment positif fort.
Une valeur comprise entre -0.33 et 0.33 peut être considérée comme neutre.
Prédiction
Cette fonction prédit le sentiment dans une liste de documents. Elle prend une chaîne de caractères en entrée et fournit un JSON en sortie.
-
URL :
/api/predict/ -
Méthode :
POST -
Payload :
- Exemple de payload :
Réponse en cas de succès
-
Code :
200 OK -
Contenu de la réponse :
- Exemple de réponse :
Pour l'entrée The headphones broke after two weeks, not worth their price.
Démo
Un Gradio est disponible sur /demo ou /gradio.
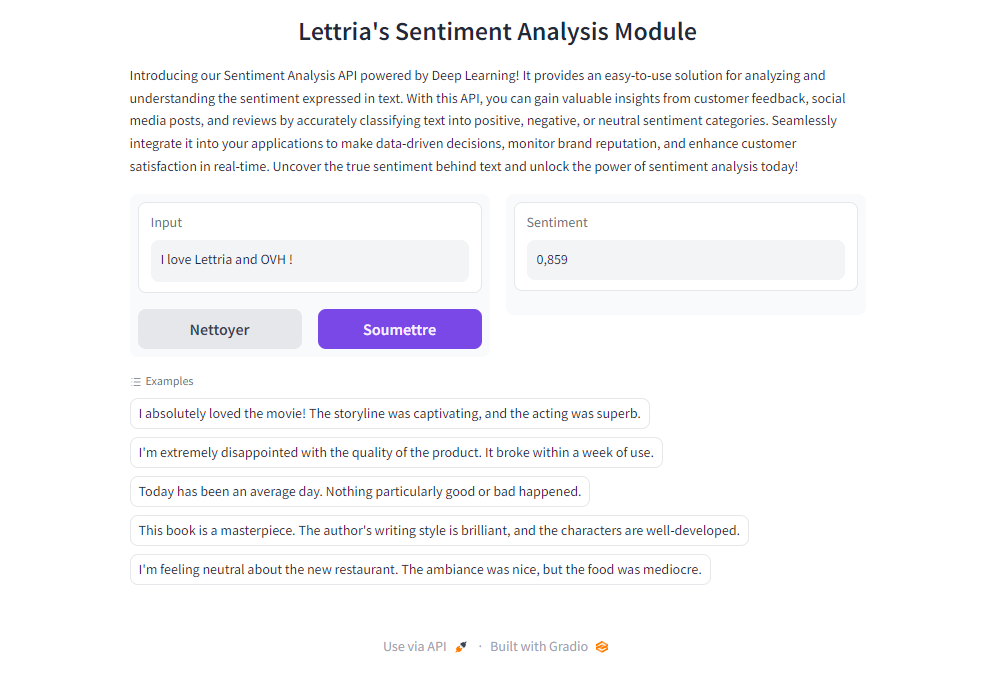
Appeler l'API en Python
- Prérequis :
Installez le package requests :
- Code :
L'API Emotion Analysis de Lettria
L'API Emotion Analysis de Lettria permet une détection efficace des émotions à partir de différents types de texte, notamment :
- les retours clients
- le contenu des réseaux sociaux
- les emails
- les conversations de chat
En s'appuyant sur la technologie Deep Learning, l'API identifie et catégorise avec précision de nombreuses émotions telles que la joie, la tristesse, la colère, la peur, la surprise, et bien d'autres.
L'API utilise des algorithmes pour interpréter les émotions humaines à partir du texte, permettant l'extraction d'informations précieuses pour enrichir vos applications. Elle prend en charge l'analyse de sentiment des avis clients et du contenu des réseaux sociaux, le suivi de la réputation de marque, l'analyse de sentiment pour l'étude de marché, et l'optimisation des interactions avec les chatbots.
La conception ergonomique de l'API simplifie son intégration dans vos applications, la rendant compatible avec les logiciels existants, les systèmes CRM et diverses plateformes. Cela permet l'extraction d'informations émotionnelles en temps réel pour une prise de décision basée sur les données.
L'API Emotion Analysis est une solution efficace pour les entreprises souhaitant améliorer la satisfaction client, pour les social media managers cherchant à comprendre le sentiment du public, ou pour les développeurs souhaitant améliorer l'expérience utilisateur.
Comment fonctionne l'analyse d'émotion ?
Remarque
En accédant à l'endpoint racine / de votre API, vous pouvez consulter la documentation complète de l'API.
Le modèle est entraîné pour détecter les émotions suivantes
Prédiction
Cette fonction prédit les émotions dans une liste de documents. Elle prend une chaîne de caractères en entrée et fournit un JSON en sortie.
-
URL :
/api/predict/ -
Méthode :
POST -
Payload :
- Exemple de payload :
Réponse en cas de succès
-
Code :
200 OK -
Contenu de la réponse :
- Exemple de réponse :
Pour l'entrée I love pizzas and I hate apples.
Démo
Un Gradio est disponible sur /demo ou /gradio.
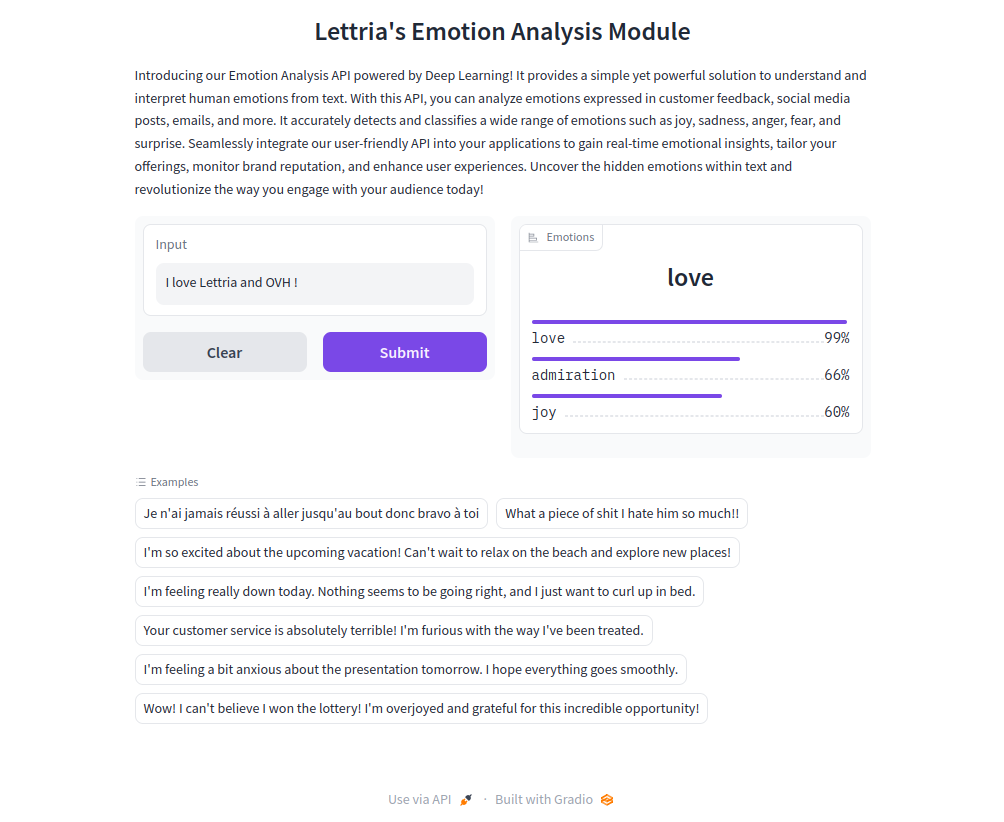
Appeler l'API en Python
- Prérequis :
Installez le package requests :
- Code :
L'API Name Entity Recognition de Lettria
L'API NER de Lettria est un outil d'analyse textuelle propulsé par le deep learning. Le modèle NER prédit et extrait avec précision les informations essentielles de vos données.
L'API est spécifiquement conçue pour identifier et classer les entités clés telles que les lieux (LOC), les personnes (PER), les organisations (ORG), et les entités diverses (MISC) dans votre texte, offrant des informations inégalées et améliorant votre compréhension des données textuelles.
L'API NER fournit des résultats précis et fiables, vous permettant de rationaliser vos workflows, d'améliorer la prise de décision basée sur les données et d'atteindre un nouveau niveau d'efficacité.
Découvrez et comprenez les véritables entités derrière un texte pour améliorer la satisfaction client, prendre des décisions basées sur les données et optimiser vos stratégies commerciales grâce à l'analyse d'entités.
Comment fonctionne le NER ?
Remarque
En accédant à l'endpoint racine / de votre API, vous pouvez consulter la documentation complète.
Entités
L'API renvoie une liste des entités détectées pour chaque phrase en entrée.
Entités :
Logits
En définissant return_logits=true, l'API renverra les scores bruts de chaque classe d'entité pour chaque mot de la phrase.
Cela peut être utile pour obtenir un contrôle plus fin sur la prédiction.
Exemple d'ajustement post-traitement :
Si un mot est prédit comme MISC avec un score de 0.6 et comme LOC avec un score de 0.5, dans certains cas d'usage, nous pourrions vouloir le considérer comme une Location plutôt que comme une entité Miscellaneous.
En mode logit, les tags NER sont préfixés par B ou I. B signifie Beginning (le mot est le début d'une entité) et I signifie Inside (le mot est à l'intérieur d'une entité).
Exemple : dans Alan Turing invented AI.
Alan | B-PER
Turing | I-PER
invented AI | B-MISC
Langues prises en charge
Le modèle prend en charge les langues suivantes :
- anglais
- français
- espagnol
- portugais
- italien
Prédiction
Cette fonction prédit le sentiment dans une liste de documents. Elle prend une chaîne de caractères en entrée et fournit un JSON en sortie.
URL : /api/predict/
Méthode : POST
Payload
Exemple de payload
Réponse en cas de succès
Code : 200 OK
Contenu de la réponse
Exemple de réponse
Pour l'entrée I bought an Apple yesterday.
Démo
Un Gradio est disponible sur /demo ou /gradio.
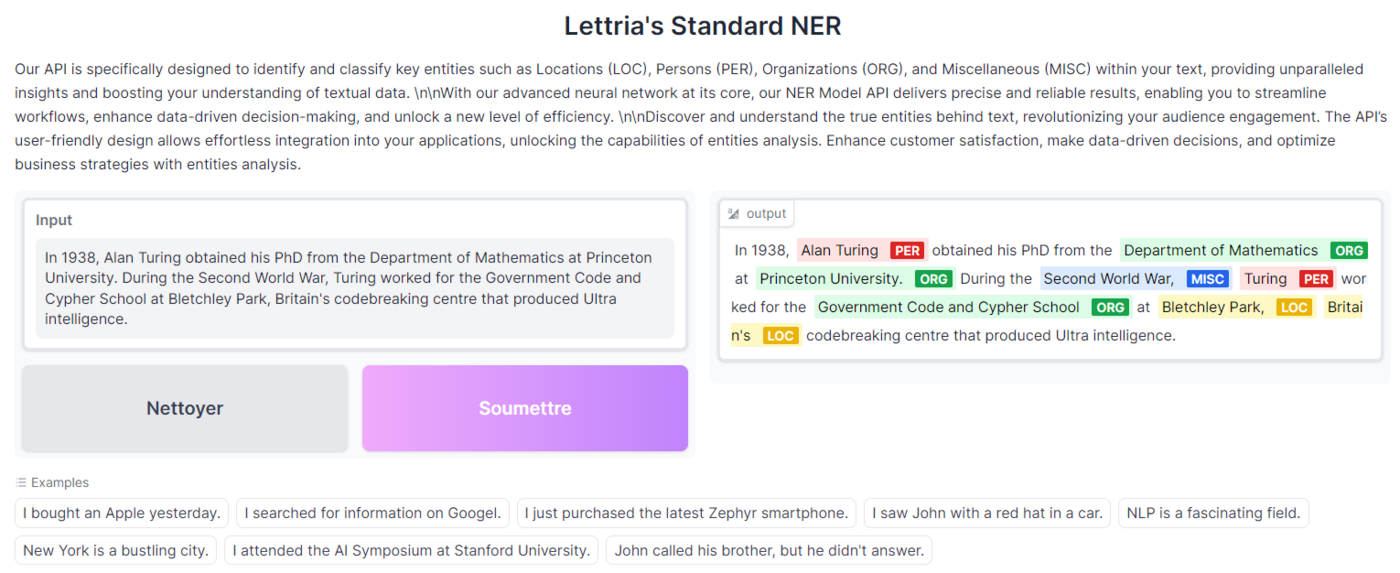
Appeler l'API en Python
Prérequis
Installez le package requests :
Code
Votre avis nous intéresse !
N’hésitez pas à nous faire part de vos questions, retours et suggestions pour améliorer le service :
- Sur le serveur Discord OVHcloud