
Analyse du NYC Yellow Taxi Dataset avec un notebook PySpark
Ce tutoriel montre comment utiliser efficacement un notebook PySpark sur la Data Platform OVHcloud pour analyser les Yellow Taxi Trip Records
Objectif
Ce tutoriel montre comment utiliser efficacement un notebook PySpark sur la Data Platform OVHcloud pour analyser les Yellow Taxi Trip Records, stockés sous forme de fichier Parquet, ainsi que la Taxi Zone Lookup Table stockée sous forme de fichier CSV. Nous allons réaliser une analyse exploratoire des données (EDA) pour mettre au jour des schémas dans l'usage des taxis, créer des visualisations pour interpréter ces schémas, et construire un modèle de machine learning pour prédire la durée du trajet à partir de features comme la distance du trajet et le lieu de prise en charge.
Ce tutoriel est conçu pour les débutants, avec des explications détaillées à chaque étape pour vous aider à comprendre comment utiliser PySpark dans un notebook Jupyter sur la Data Platform d'OVHcloud. Il suppose que vous avez terminé le guide Démarrer, qui inclut la configuration de votre environnement, l'accès aux Connectors, et la configuration d'un notebook Jupyter avec PySpark activé.
À la fin de ce tutoriel, vous saurez :
- Charger et nettoyer de grands datasets avec PySpark.
- Joindre des datasets pour ajouter un contexte géographique.
- Réaliser une EDA pour identifier des tendances dans les données de trajets de taxi.
- Visualiser les résultats avec Matplotlib et Seaborn.
- Construire un modèle de machine learning simple pour prédire la durée du trajet.
Configurer les sources de données et les tables pour le tutoriel PySpark
Avant d'analyser les Yellow Taxi Trip Records et la Taxi Zone Lookup Table avec PySpark sur la Data Platform OVHcloud, vous devez préparer l'environnement de données. Cela implique :
- Créer des sources de données dans les Connectors pour enregistrer les fichiers Parquet et CSV.
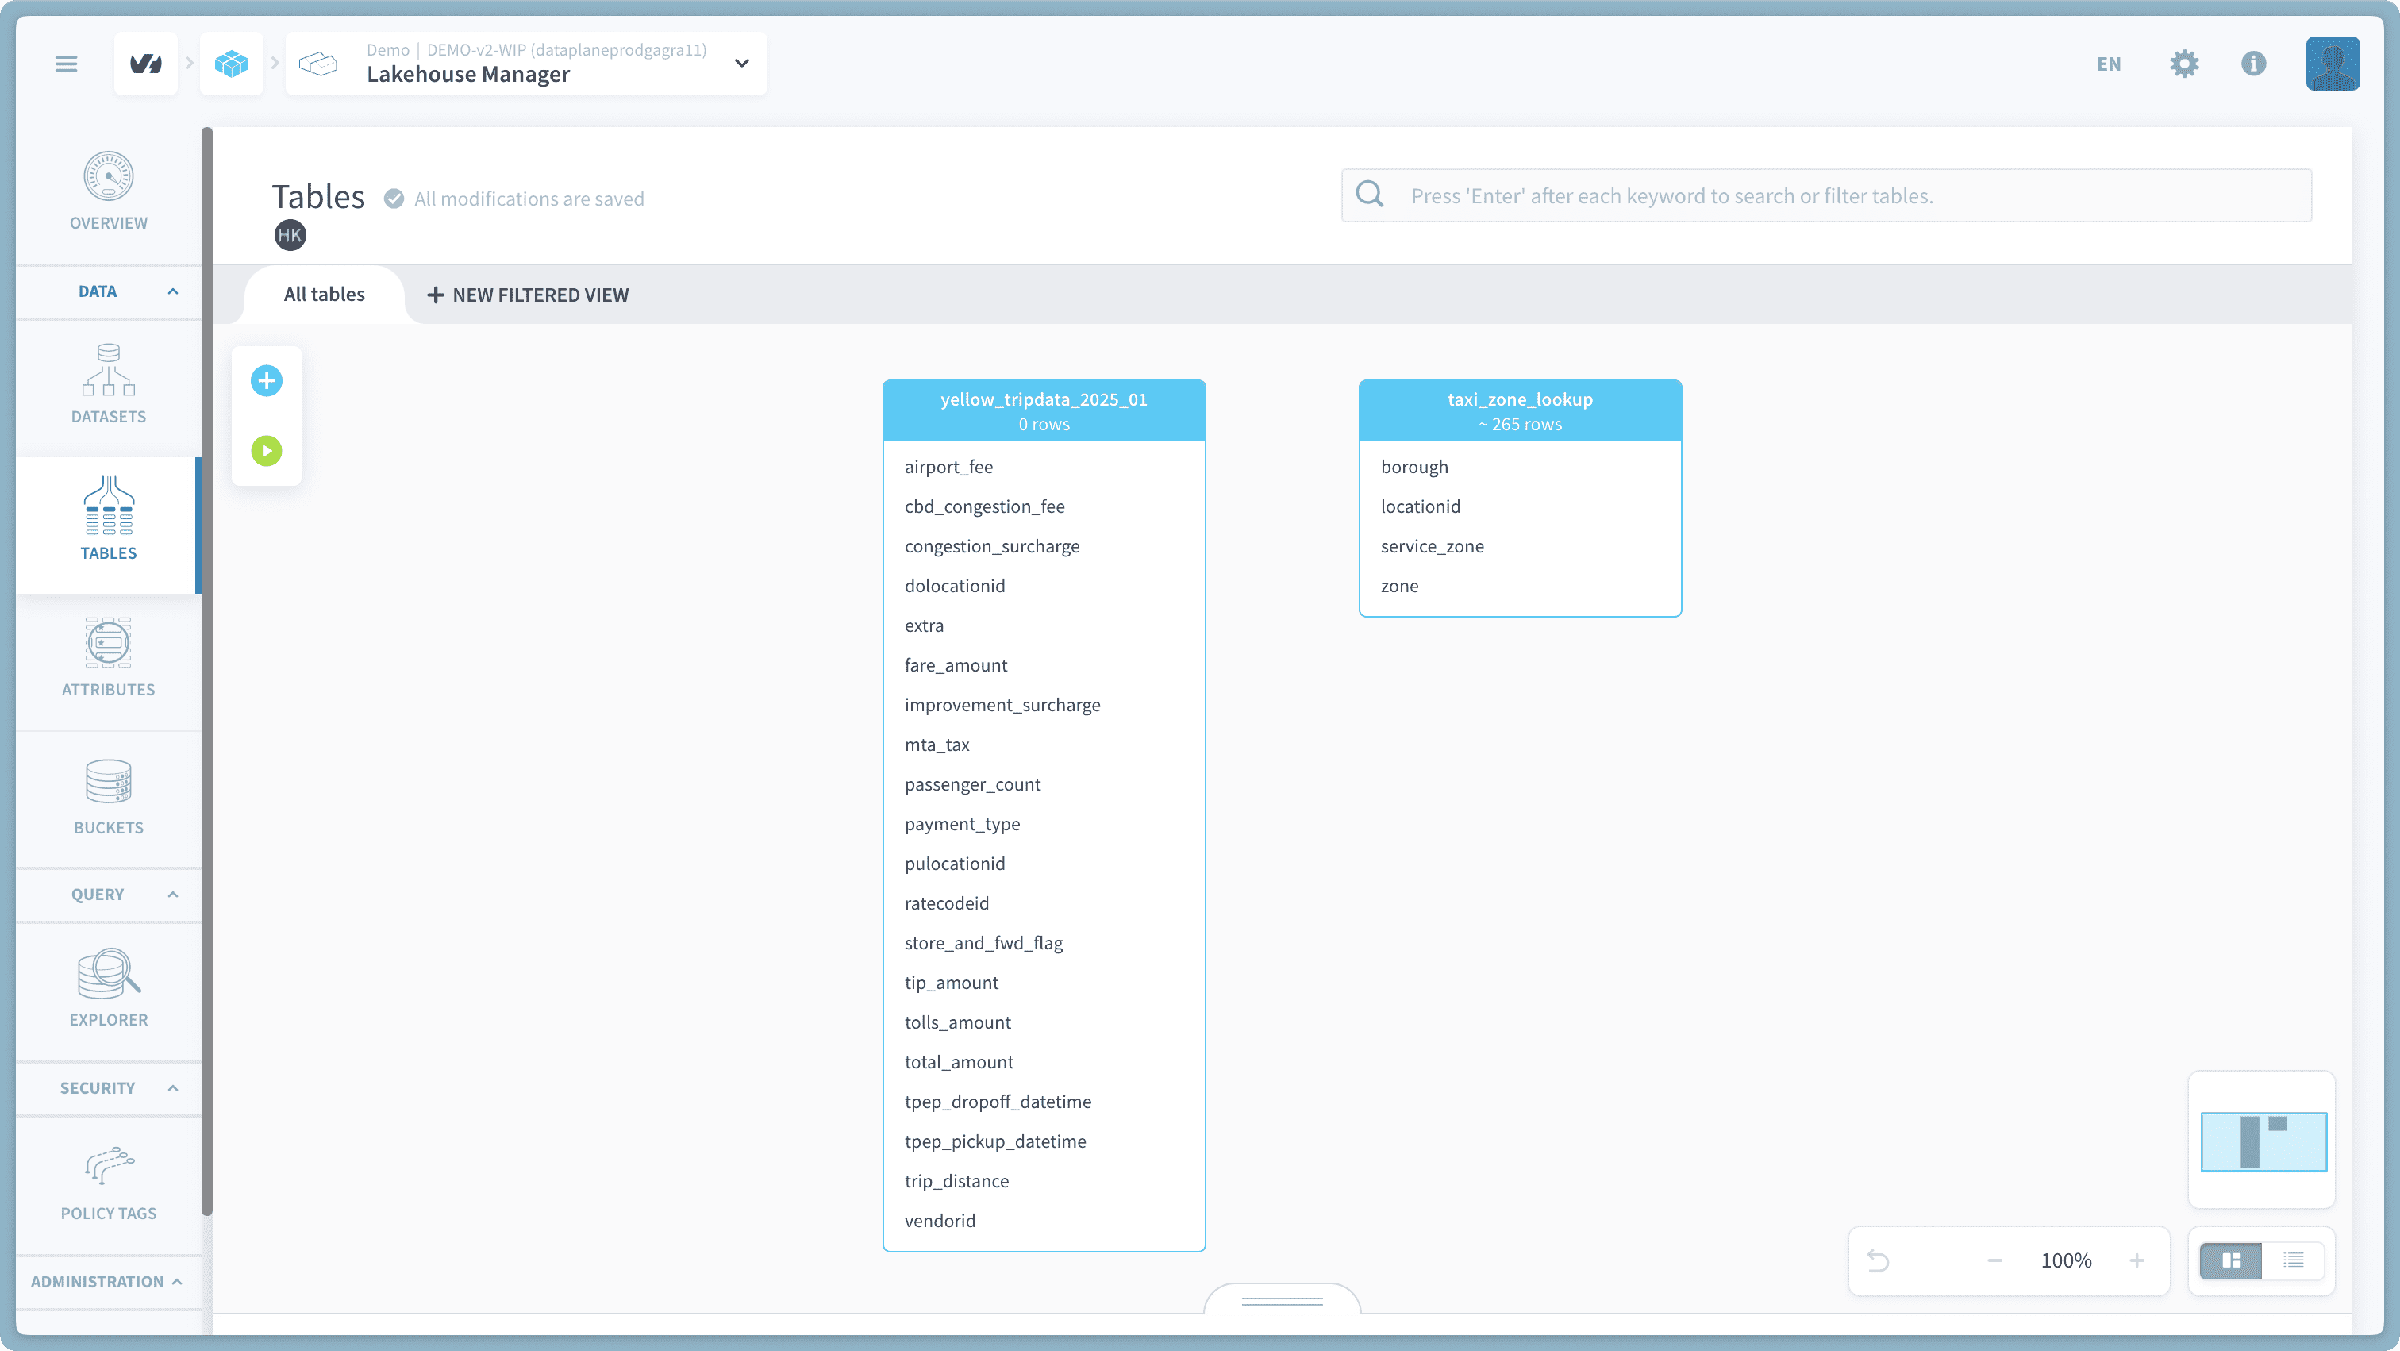
- Créer des tables dans le Lakehouse Manager pour stocker les données dans un format structuré.
- Configurer une Load Action dans le Data Processing Engine (DPE) pour alimenter la table Yellow Taxi avec les données.
Ces étapes garantissent que les données sont accessibles dans le Lakehouse Manager pour l'analyse dans un notebook Jupyter avec PySpark.
Prérequis :
- Accès à la Data Platform OVHcloud avec les permissions pour gérer les Connectors, le Lakehouse Manager, et le DPE.
- Avoir terminé le guide de démarrage de la Data Platform OVHcloud.
- Les fichiers
yellow_tripdata_YEAR-MONTH.parquetettaxi_zone_lookup.csvdisponibles depuis les données NYC TLC Trip Record.
Étape 1 : créer une nouvelle source dans Connectors
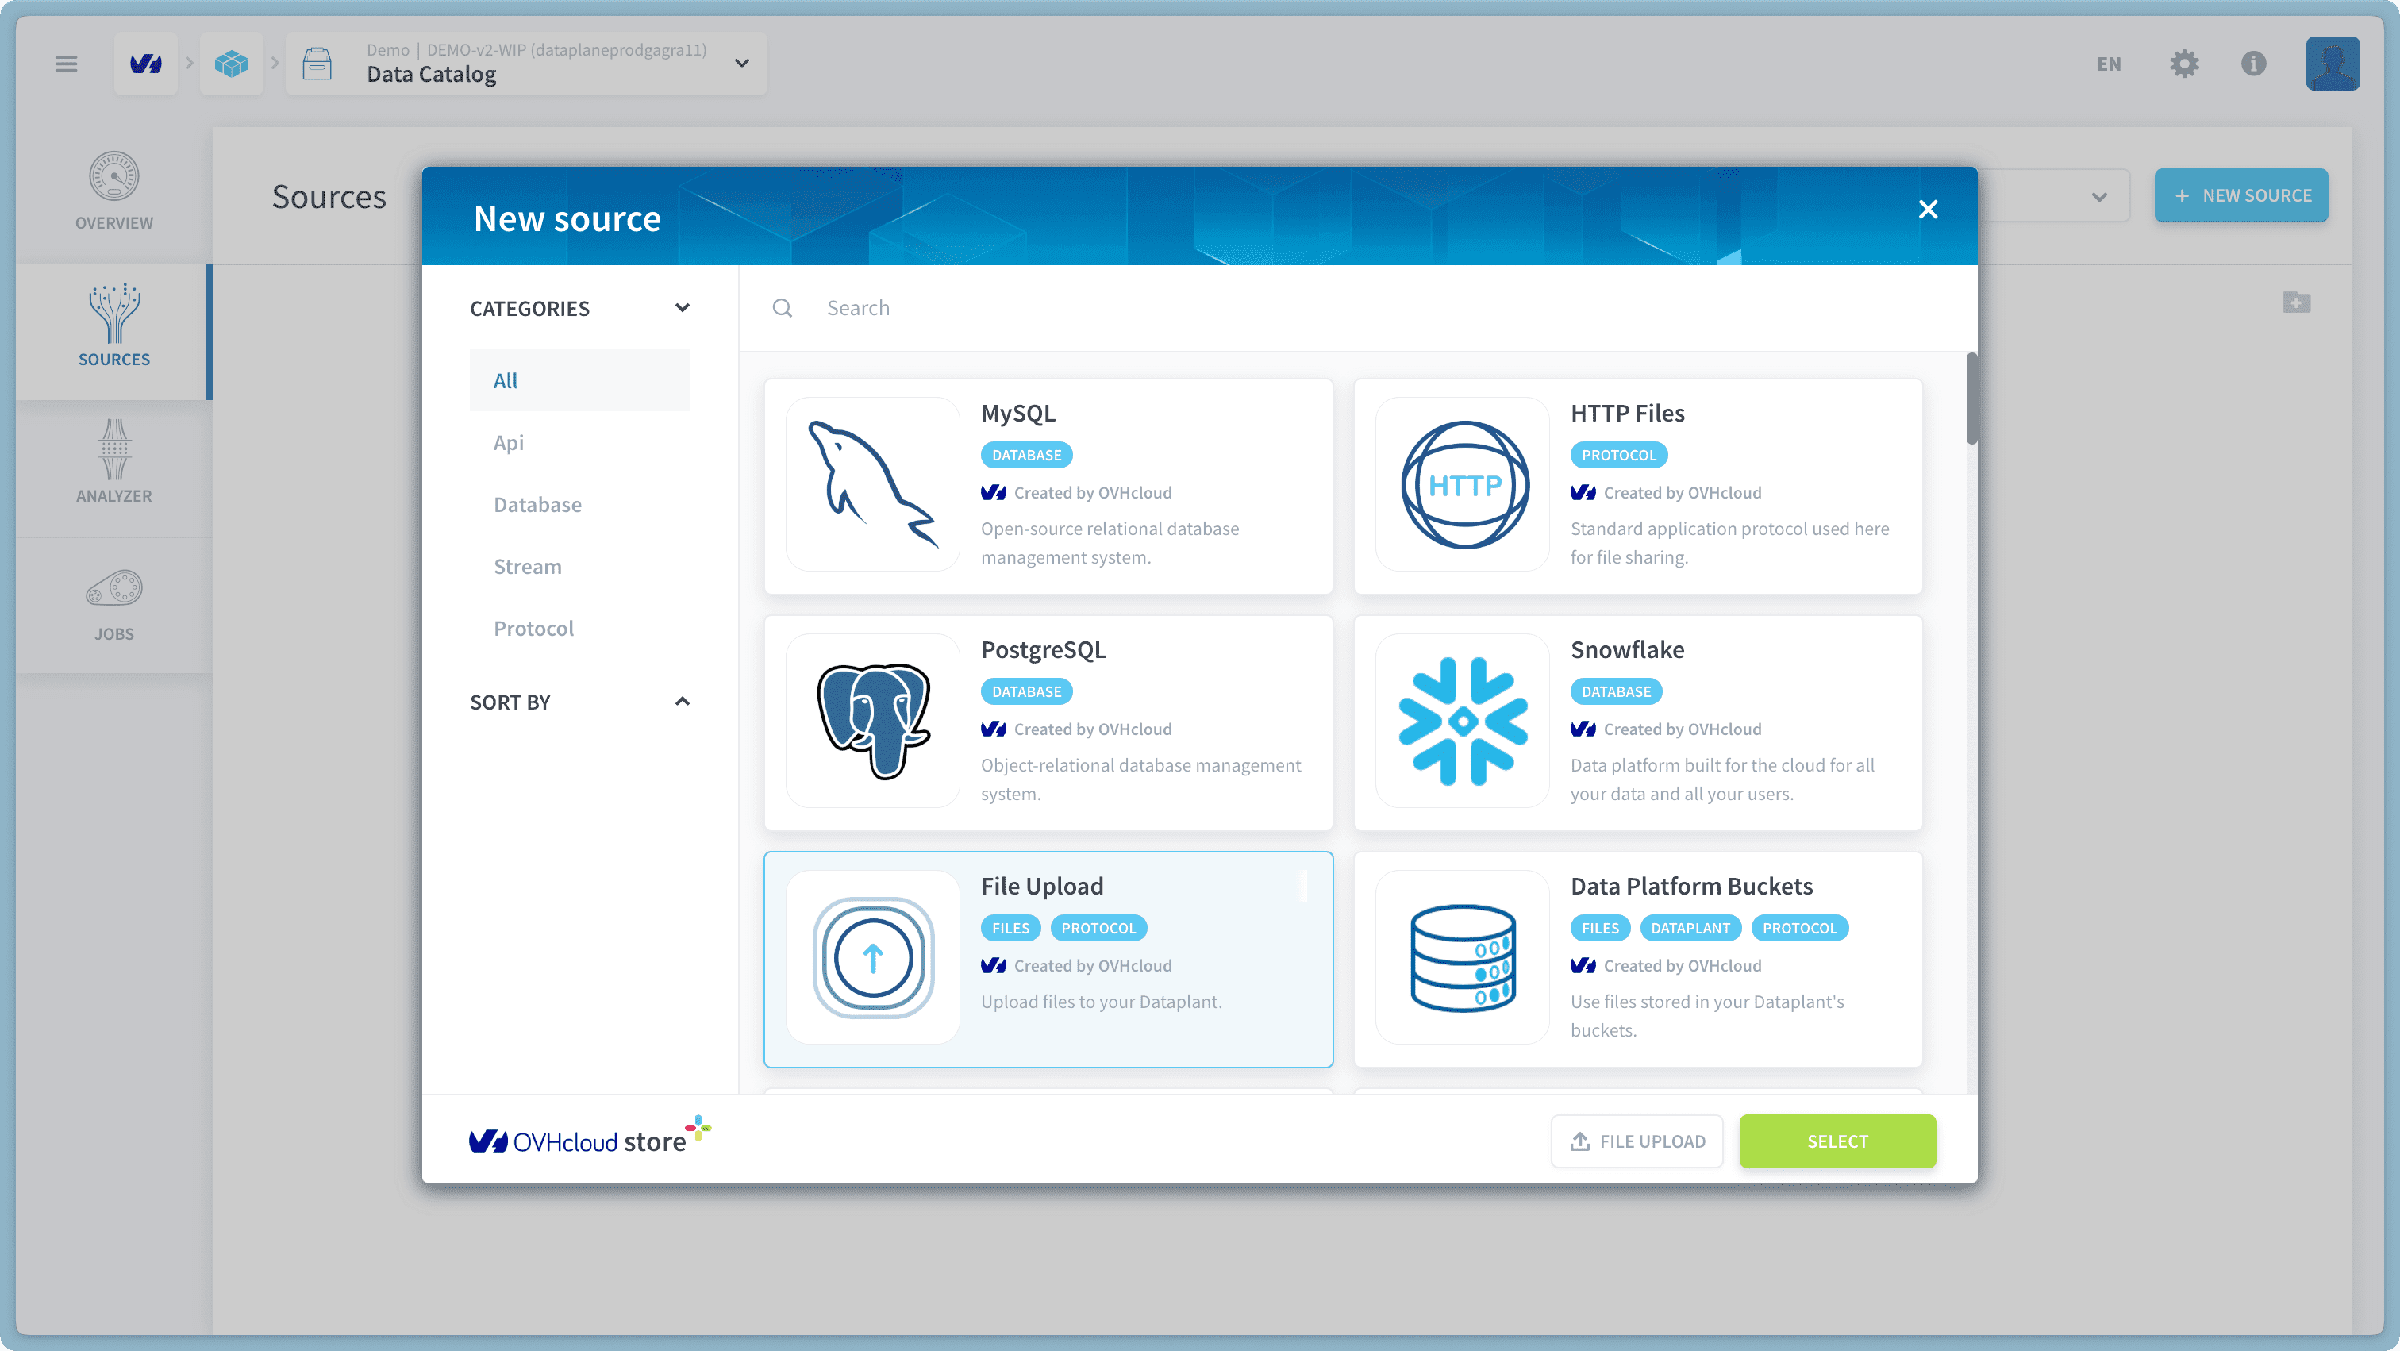
- Créez une nouvelle source File Upload et nommez-la « NYC-taxi ».
- Chargez les fichiers
yellow_tripdata_YEAR_MONTH.parquetettaxi_zone_lookup.csv, puis cliquez sur create.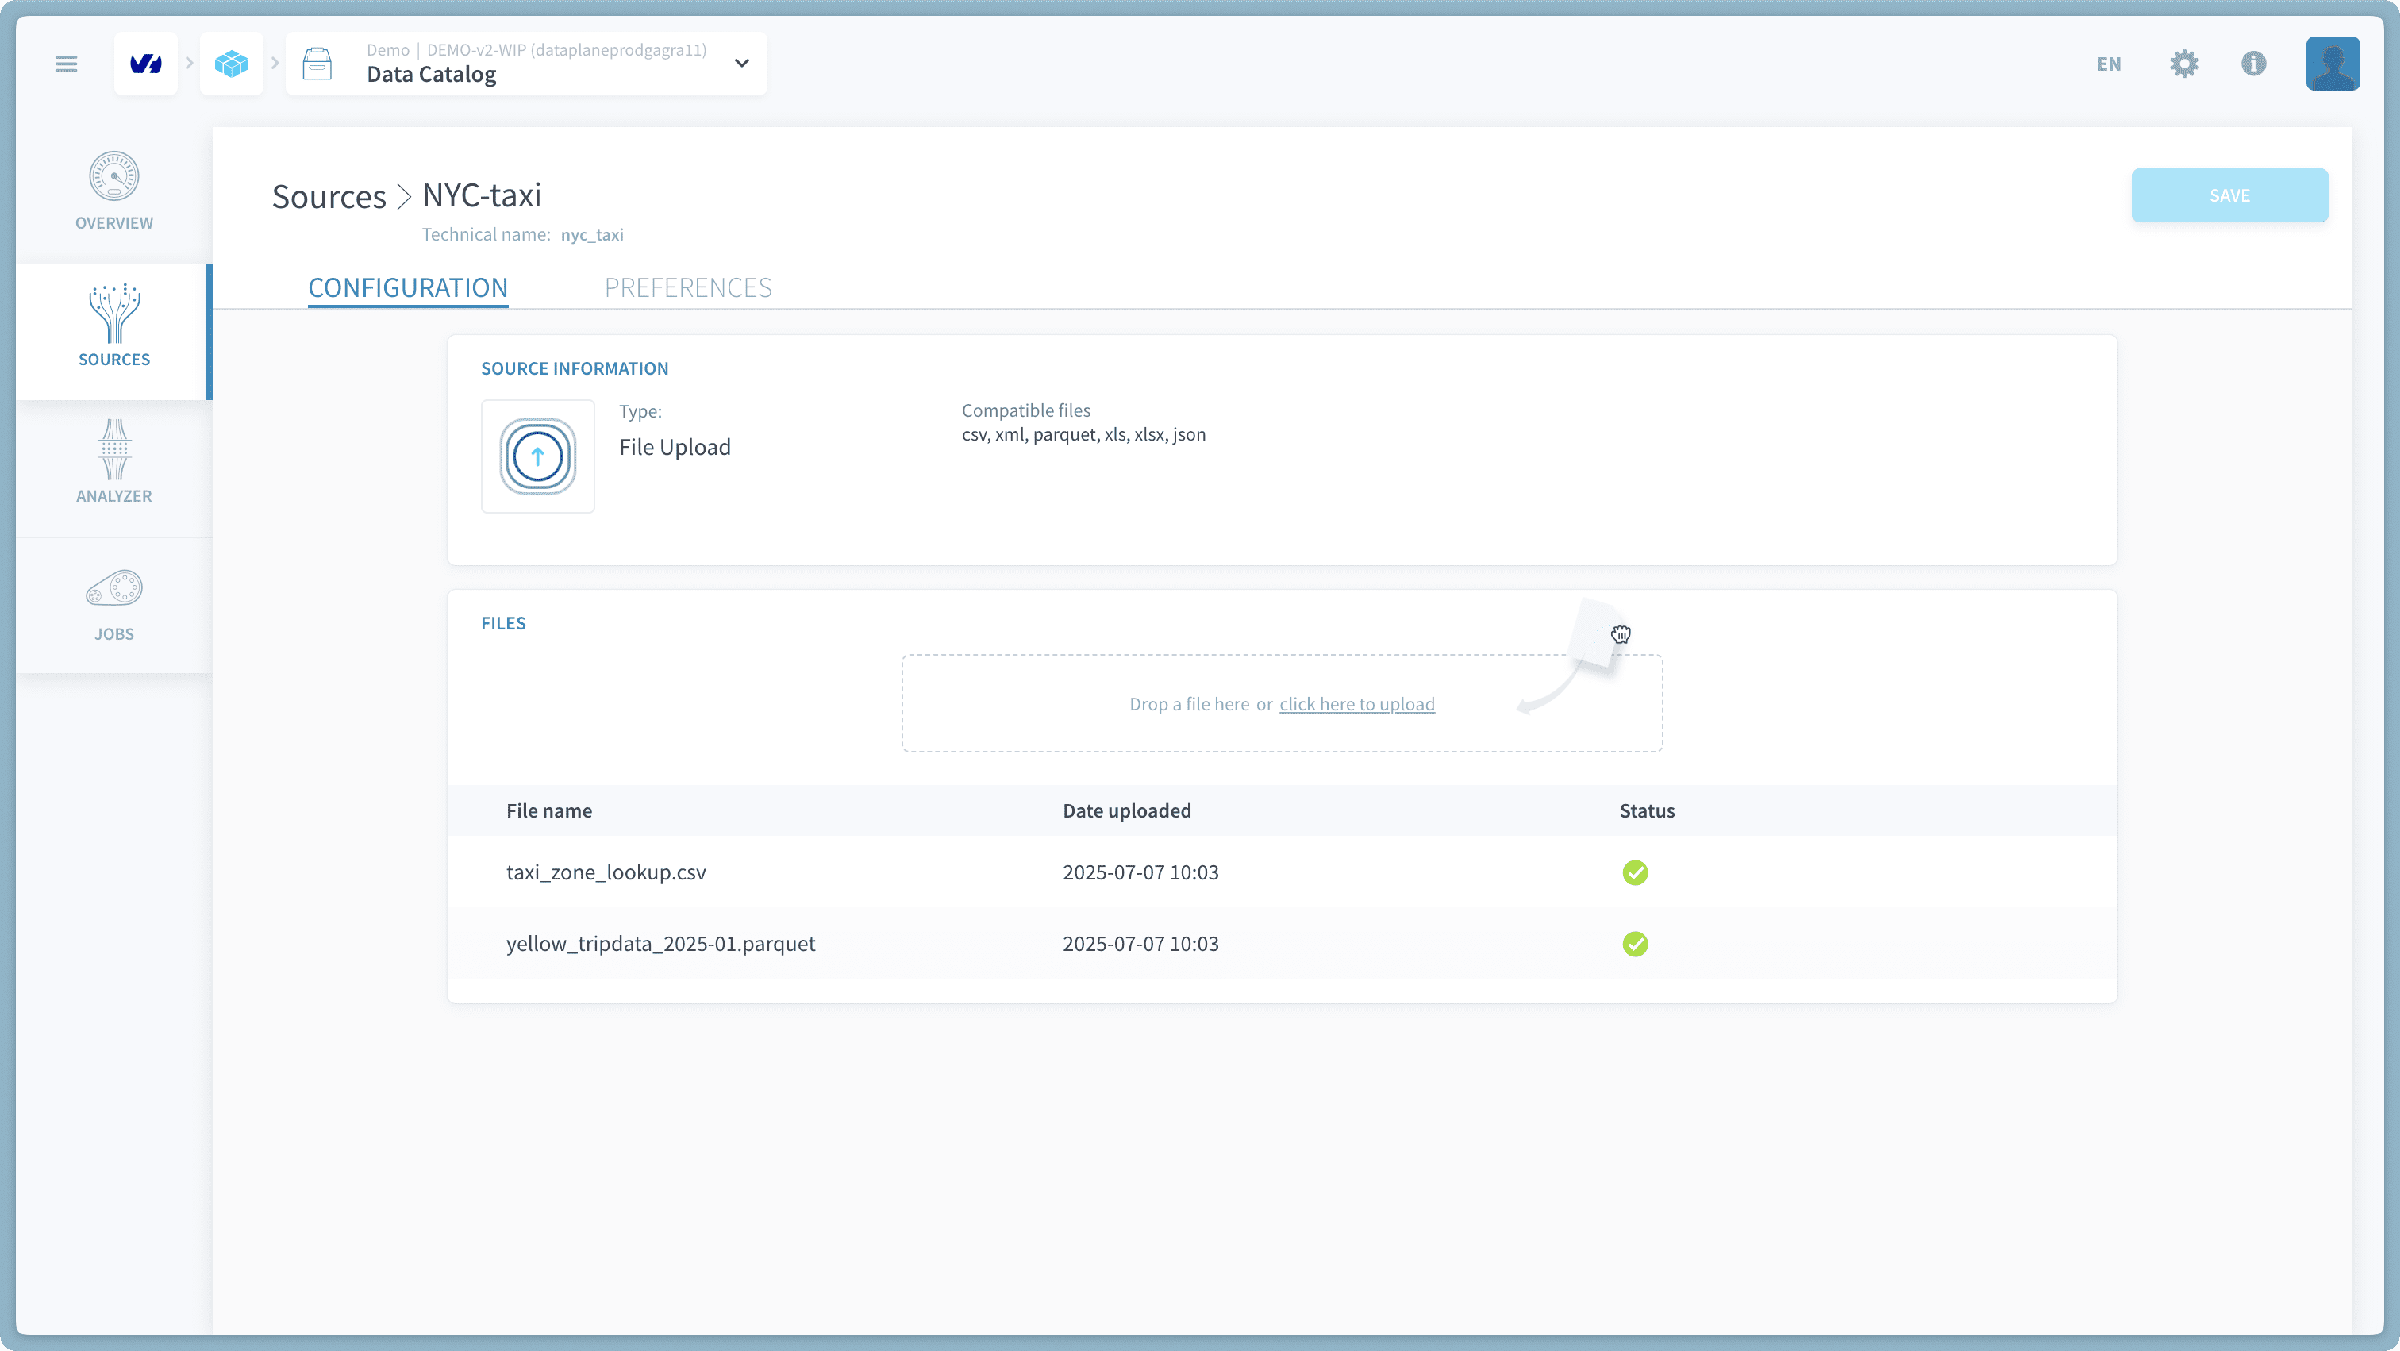
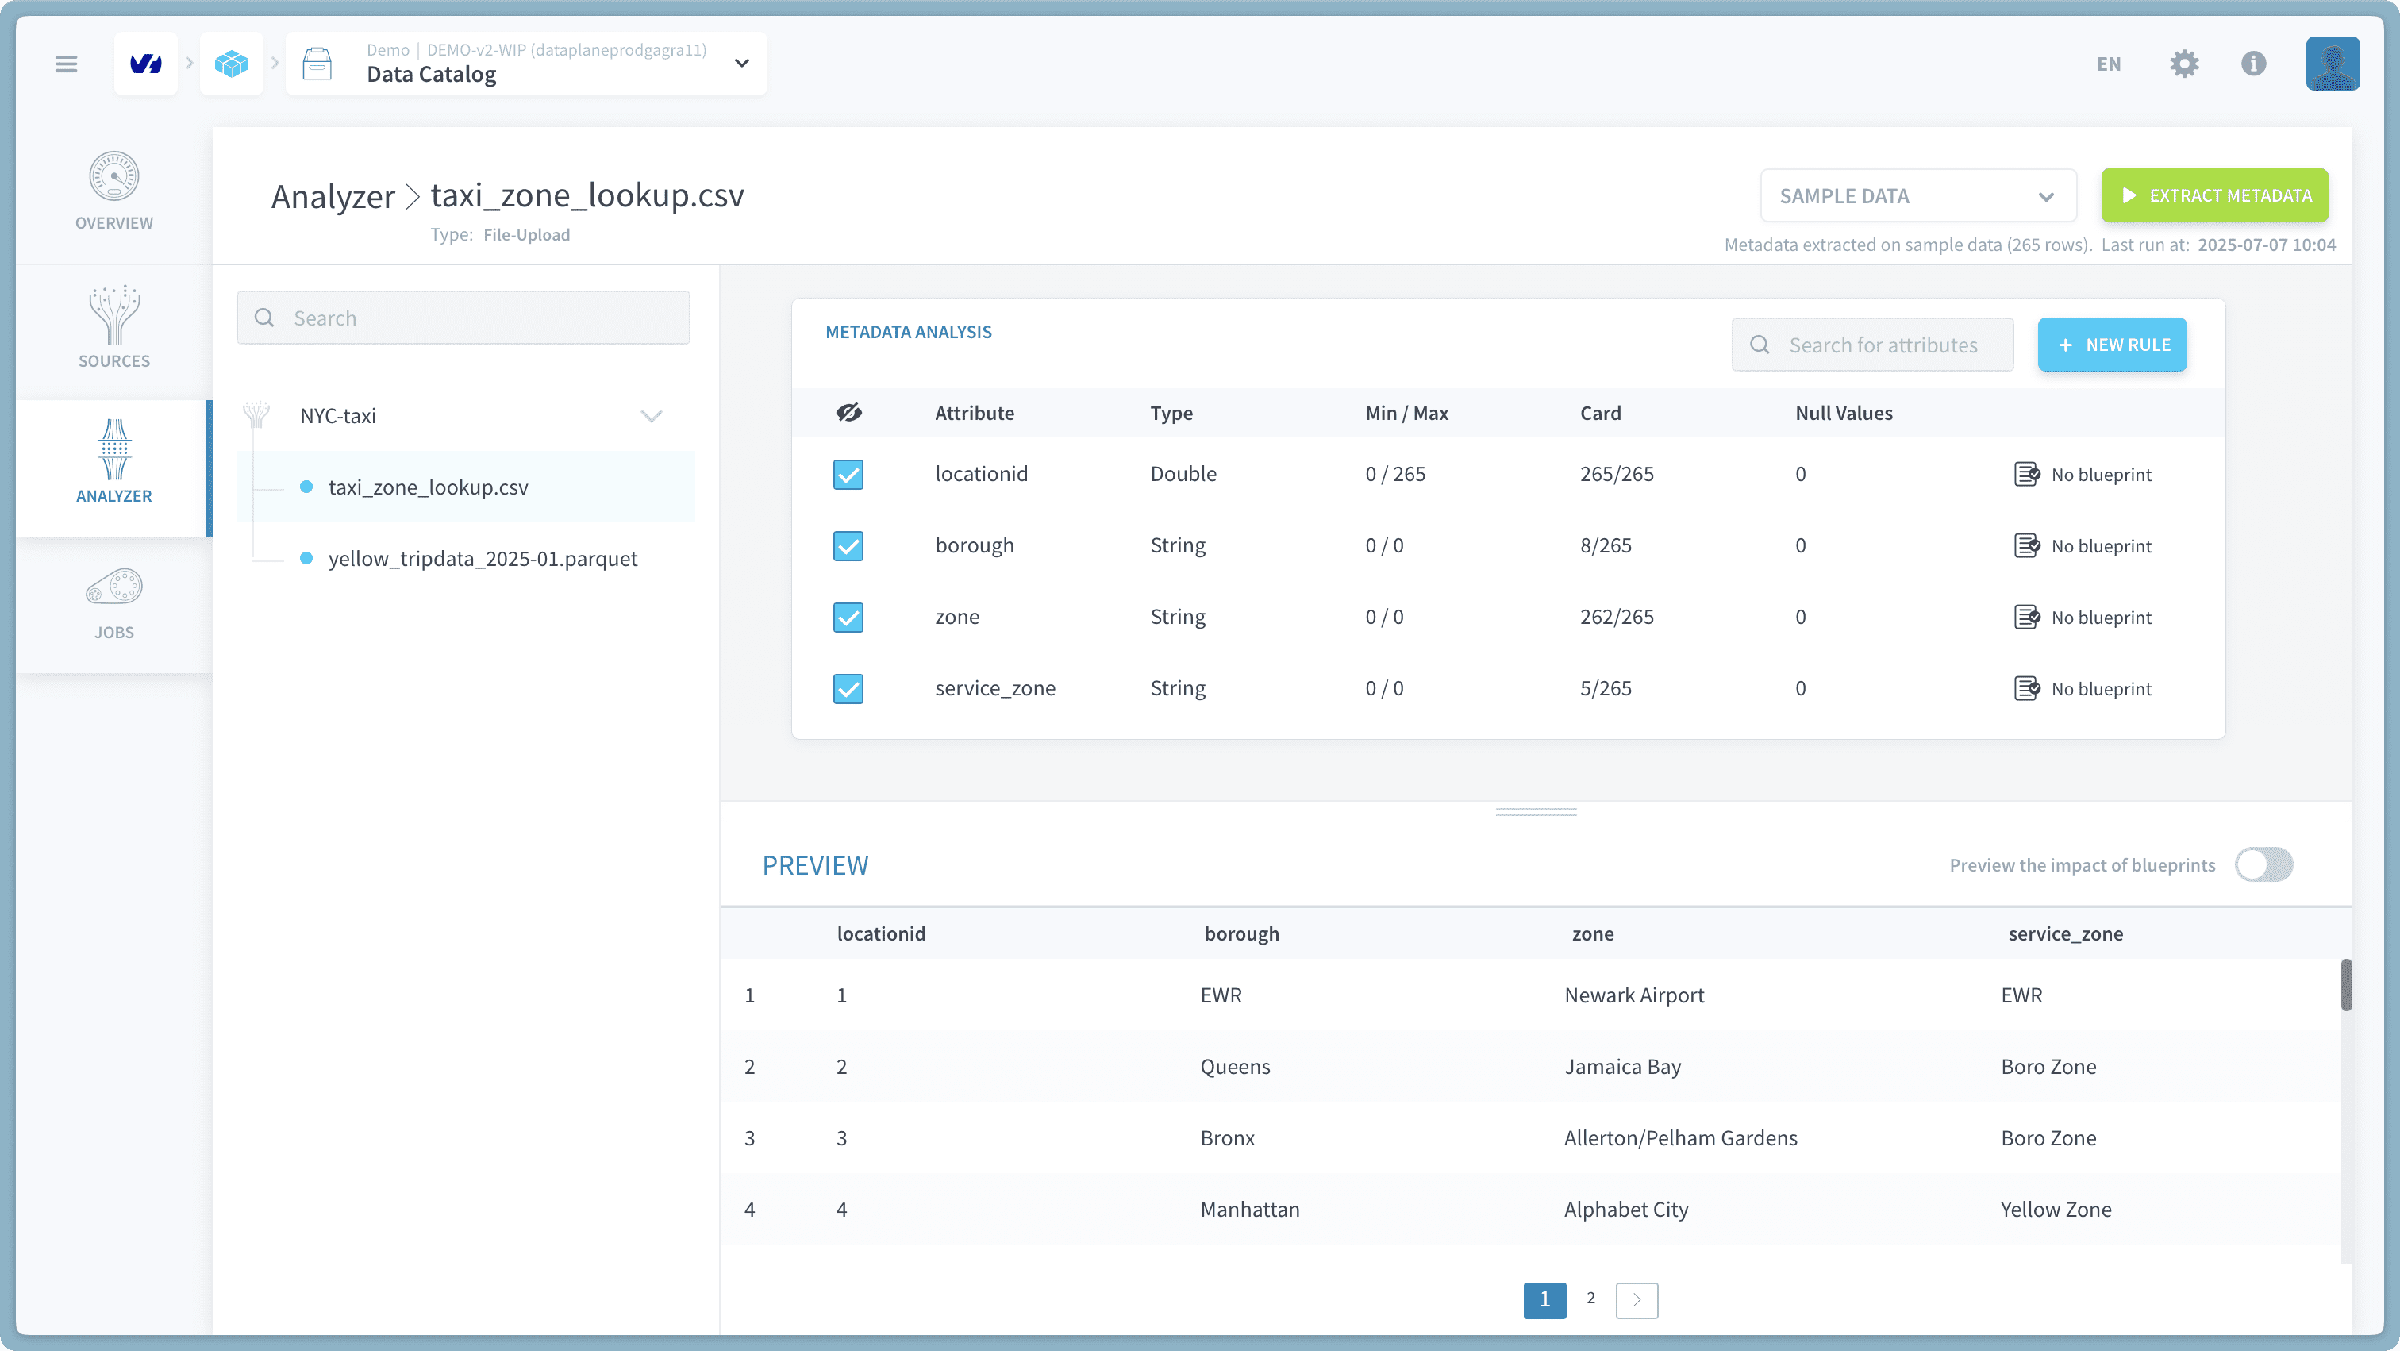
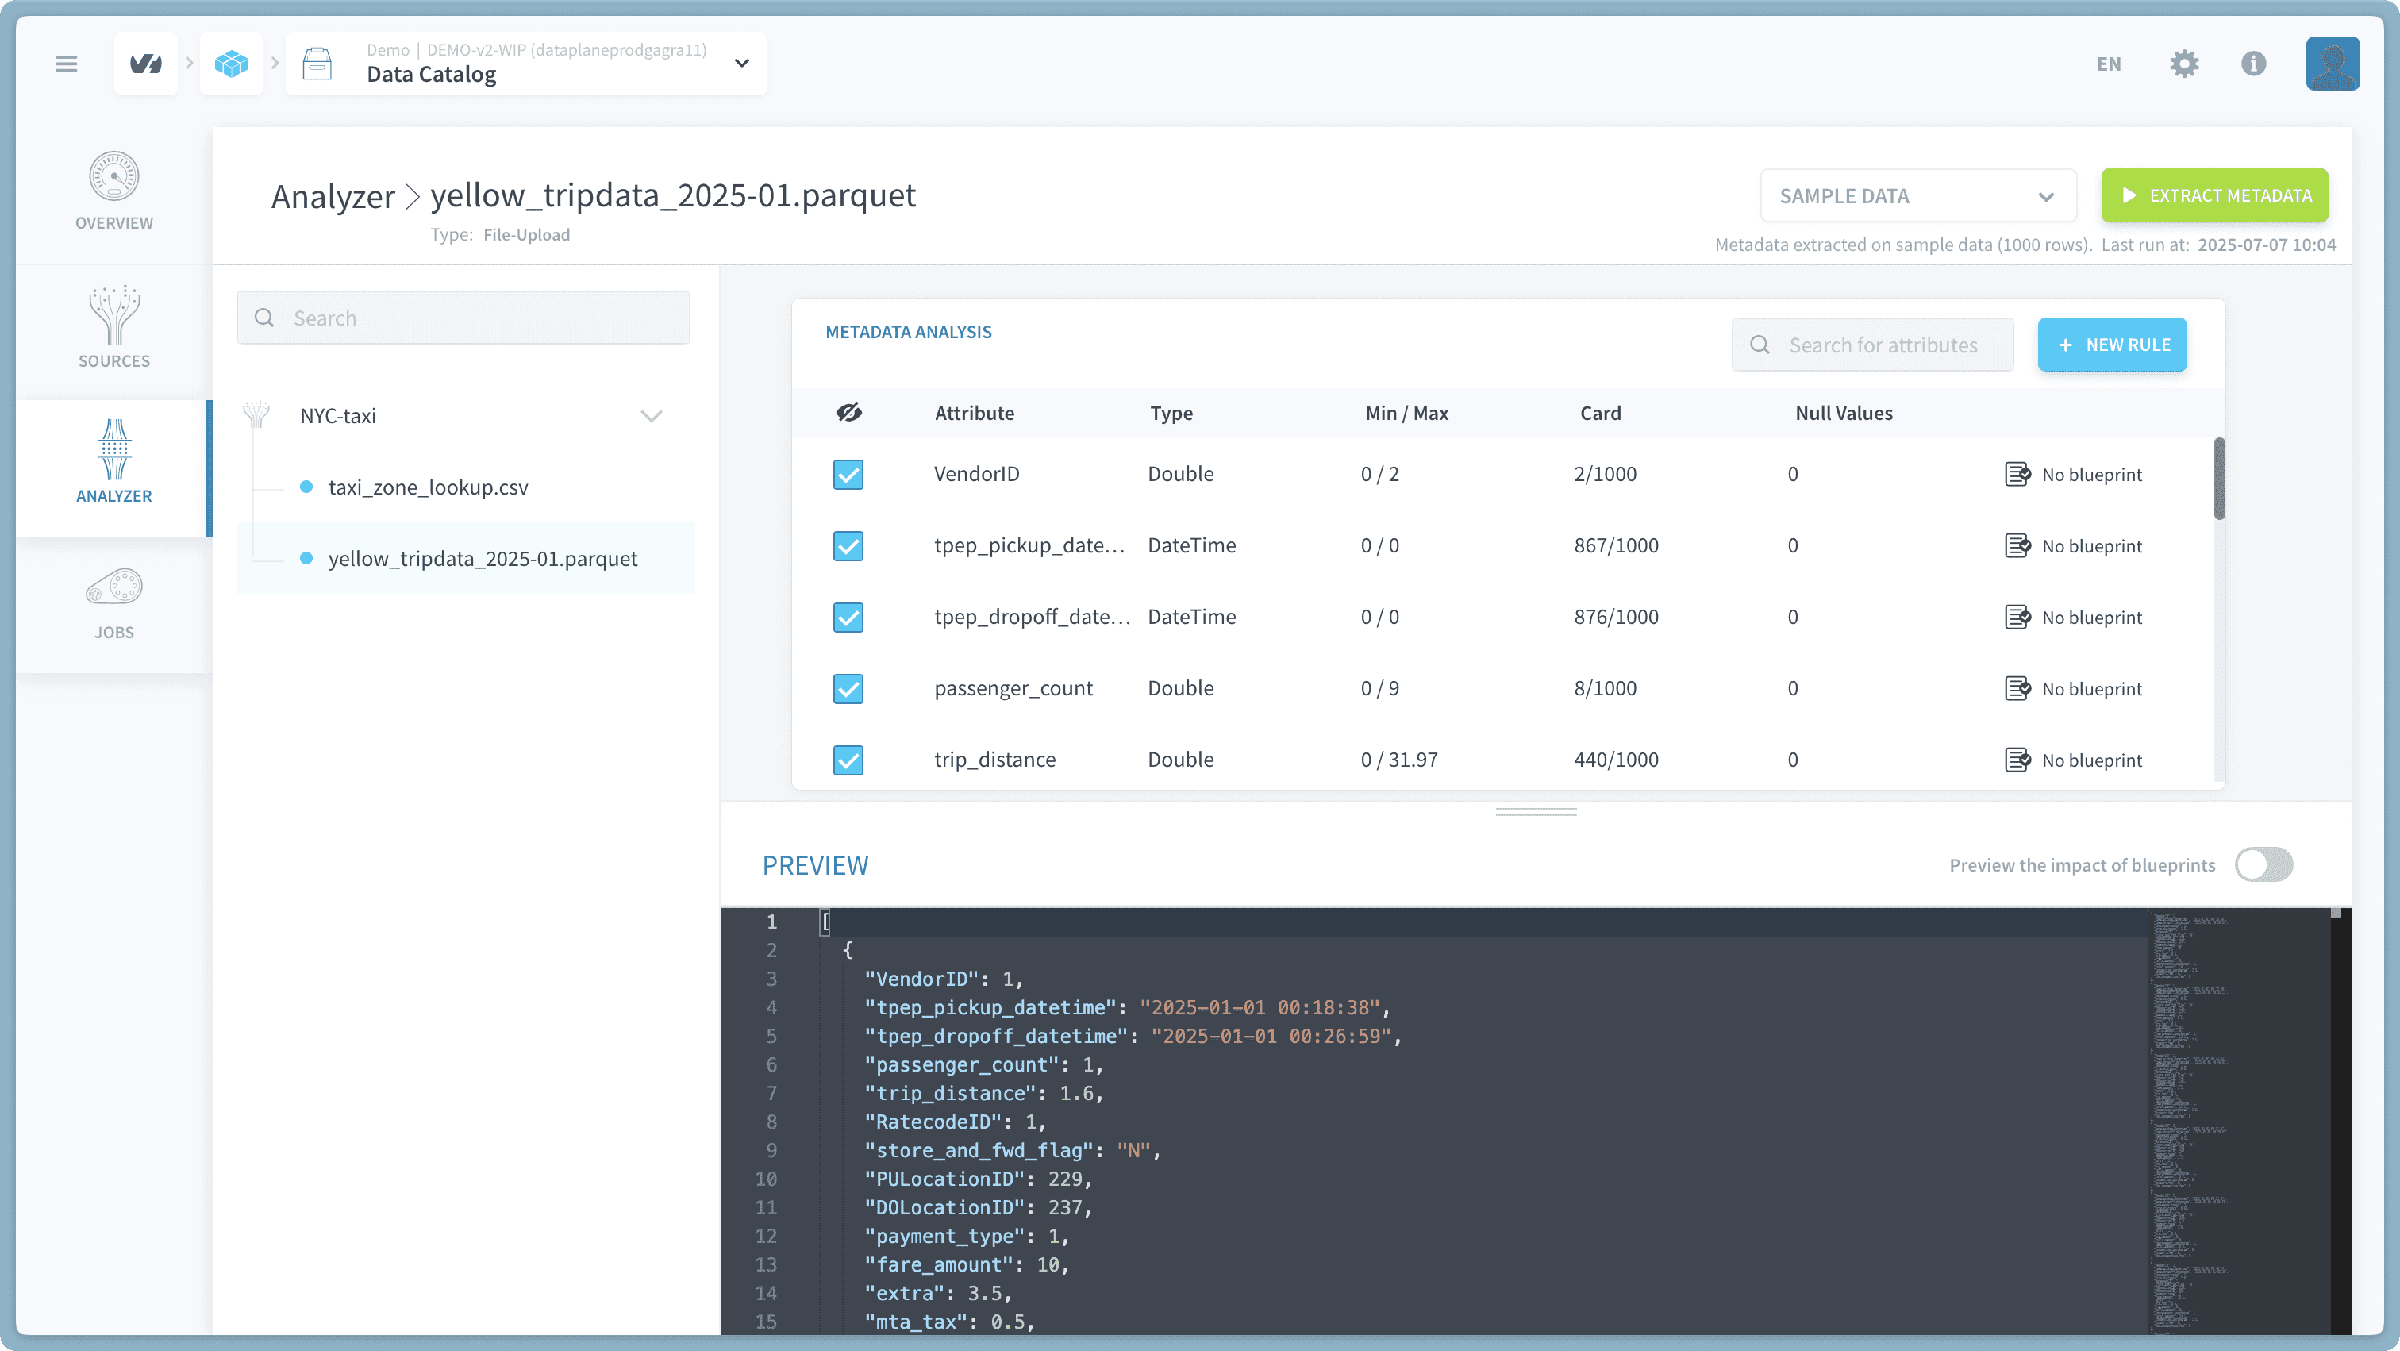
- Allez dans l'onglet Analyzer et effectuez une méta-extraction pour inférer les schémas des fichiers chargés.
Étape 2 : créer des tables dans le Lakehouse Manager
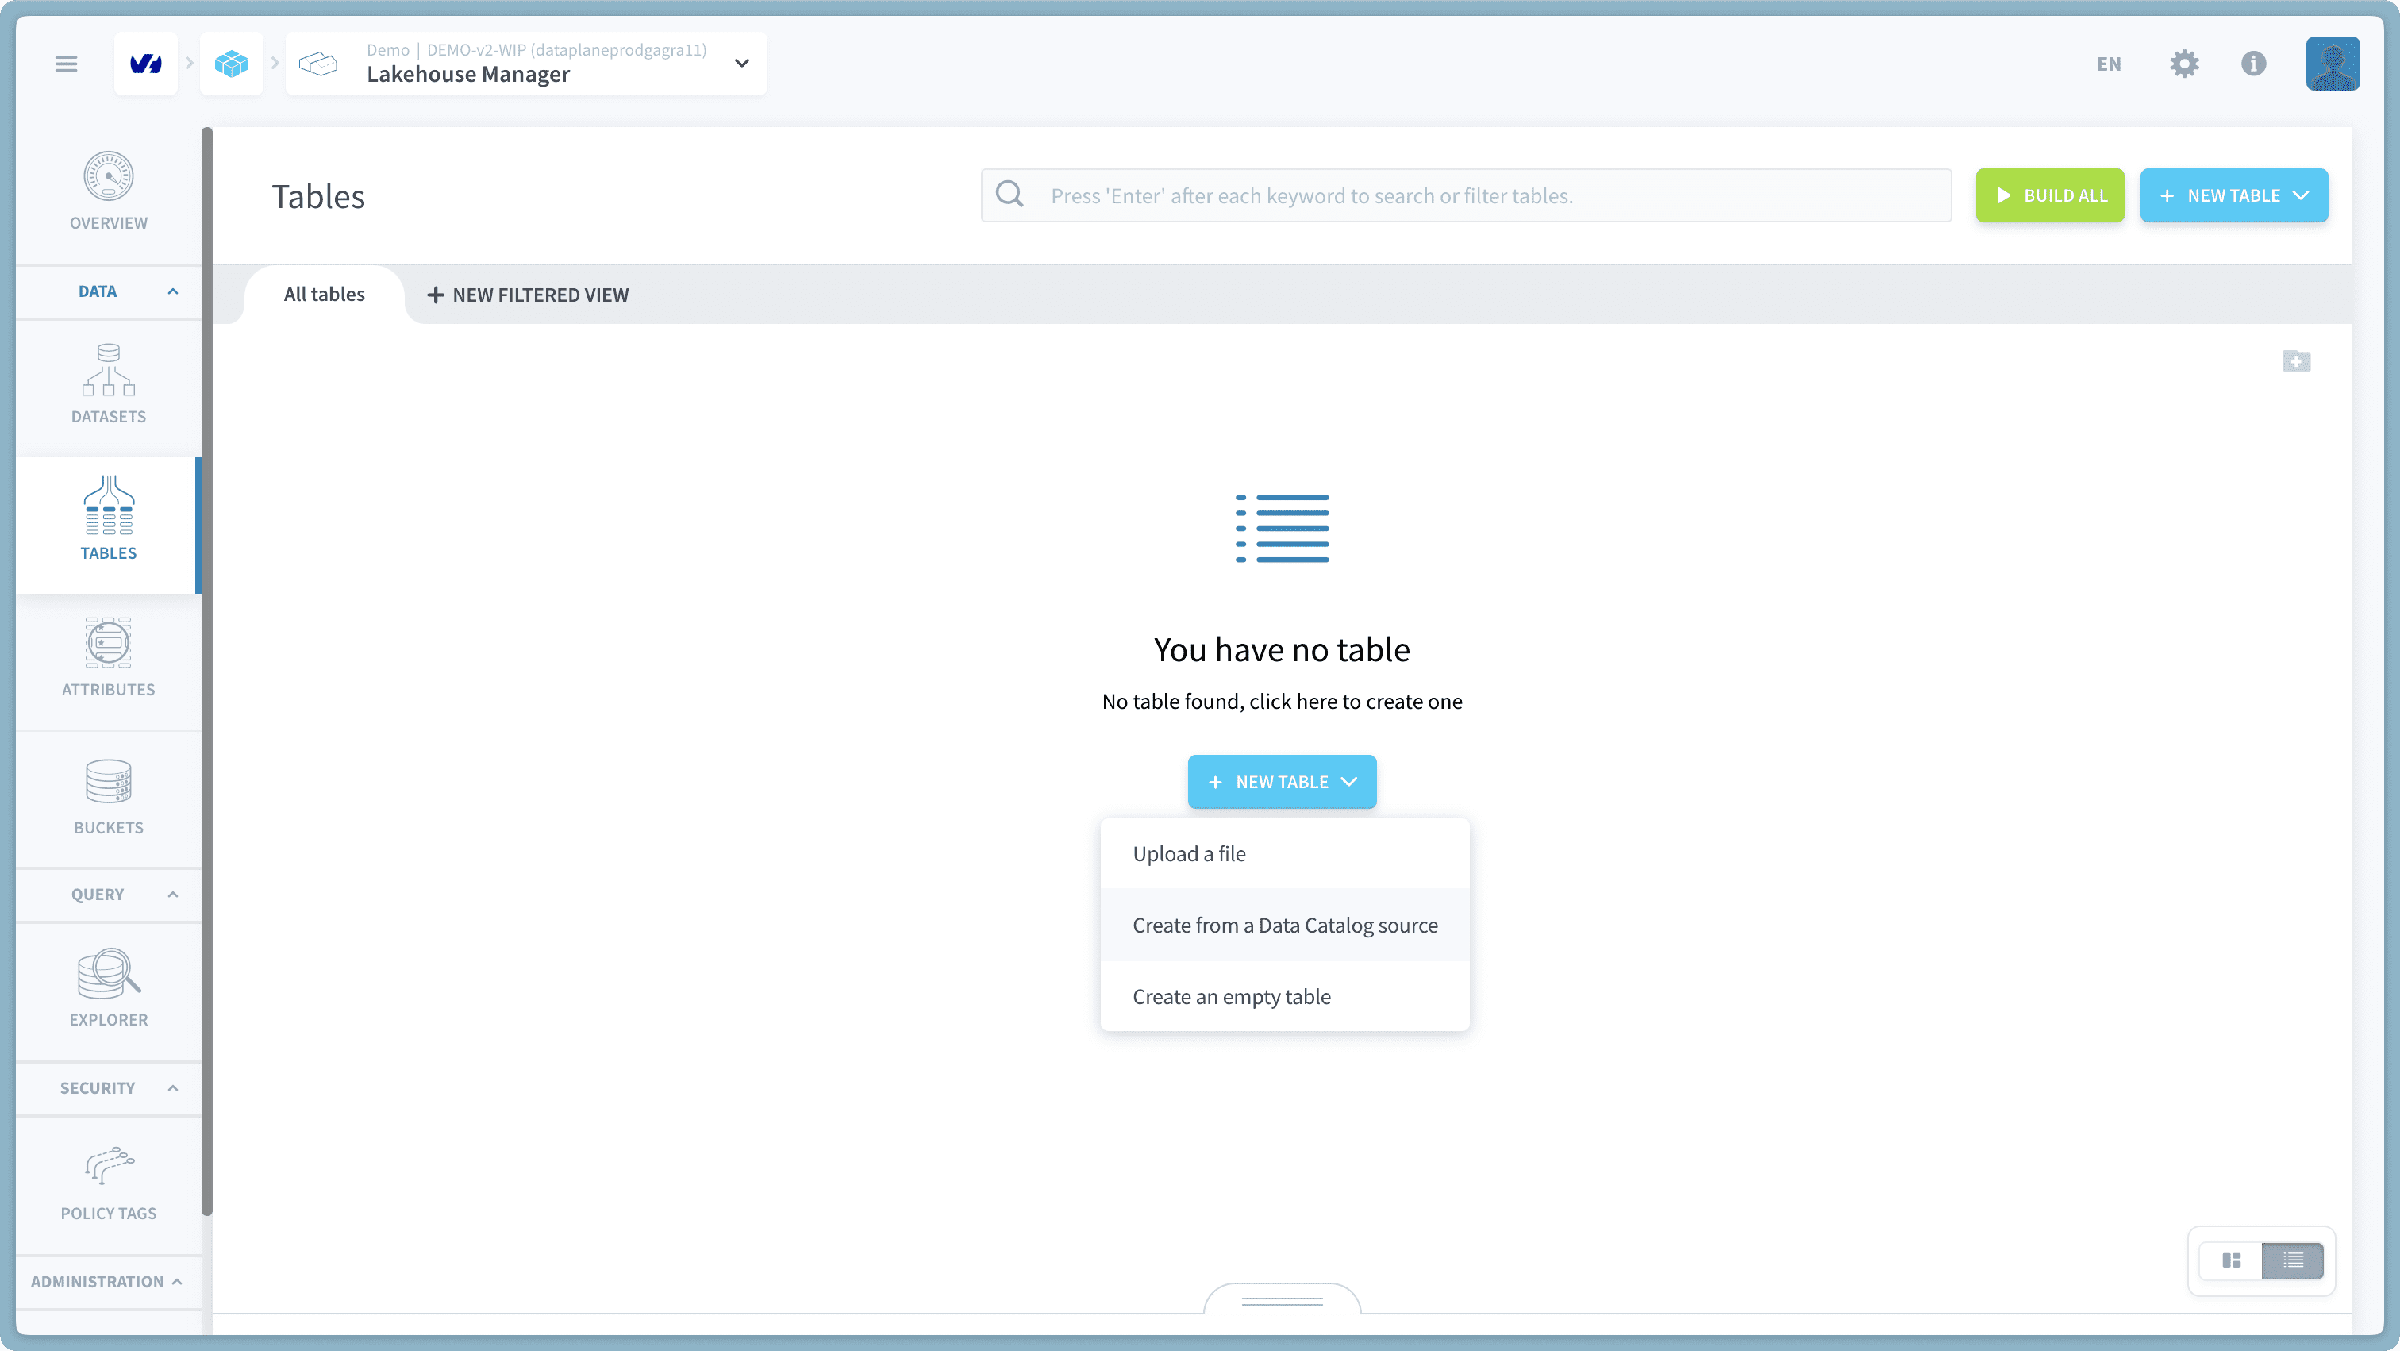
- Allez dans l'onglet Tables → cliquez sur Create from a Connectors source.
- Sélectionnez le fichier
yellow_tripdata_YEAR_MONTH.parquet→ et sélectionnez uniquement l'option « Automatically build the table ».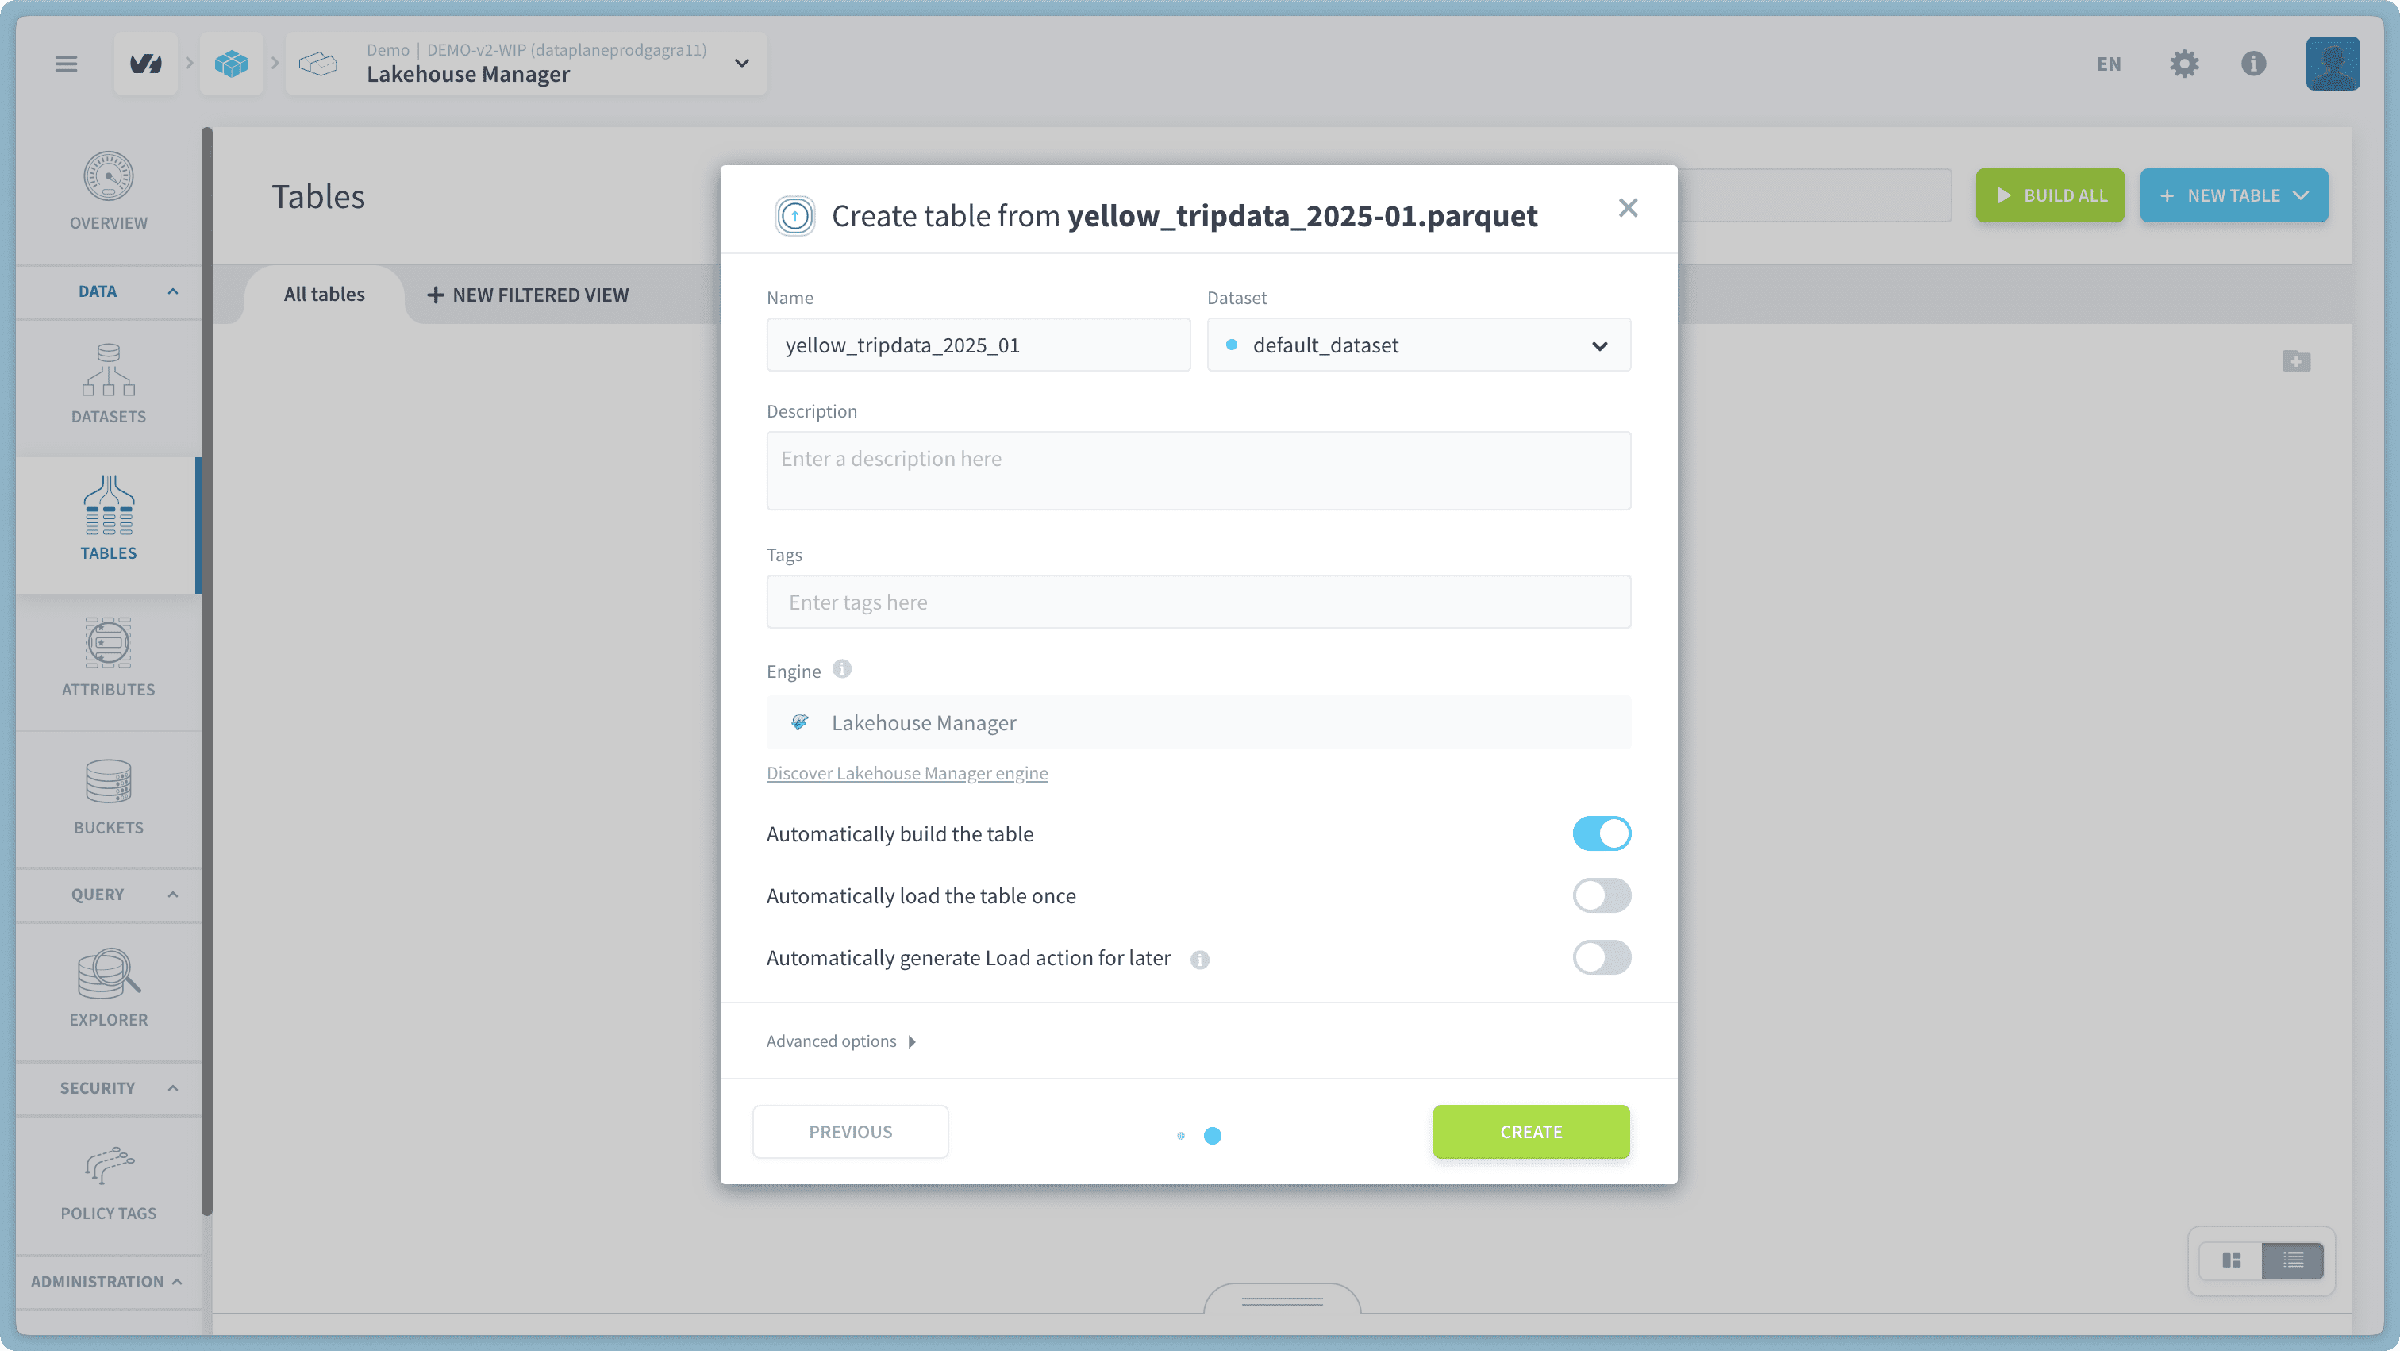
- Répétez l'opération pour le fichier
taxi_zone_lookup.csv, en sélectionnant toutes les options puisque cette table est plus petite et peut être entièrement chargée rapidement par Iceberg.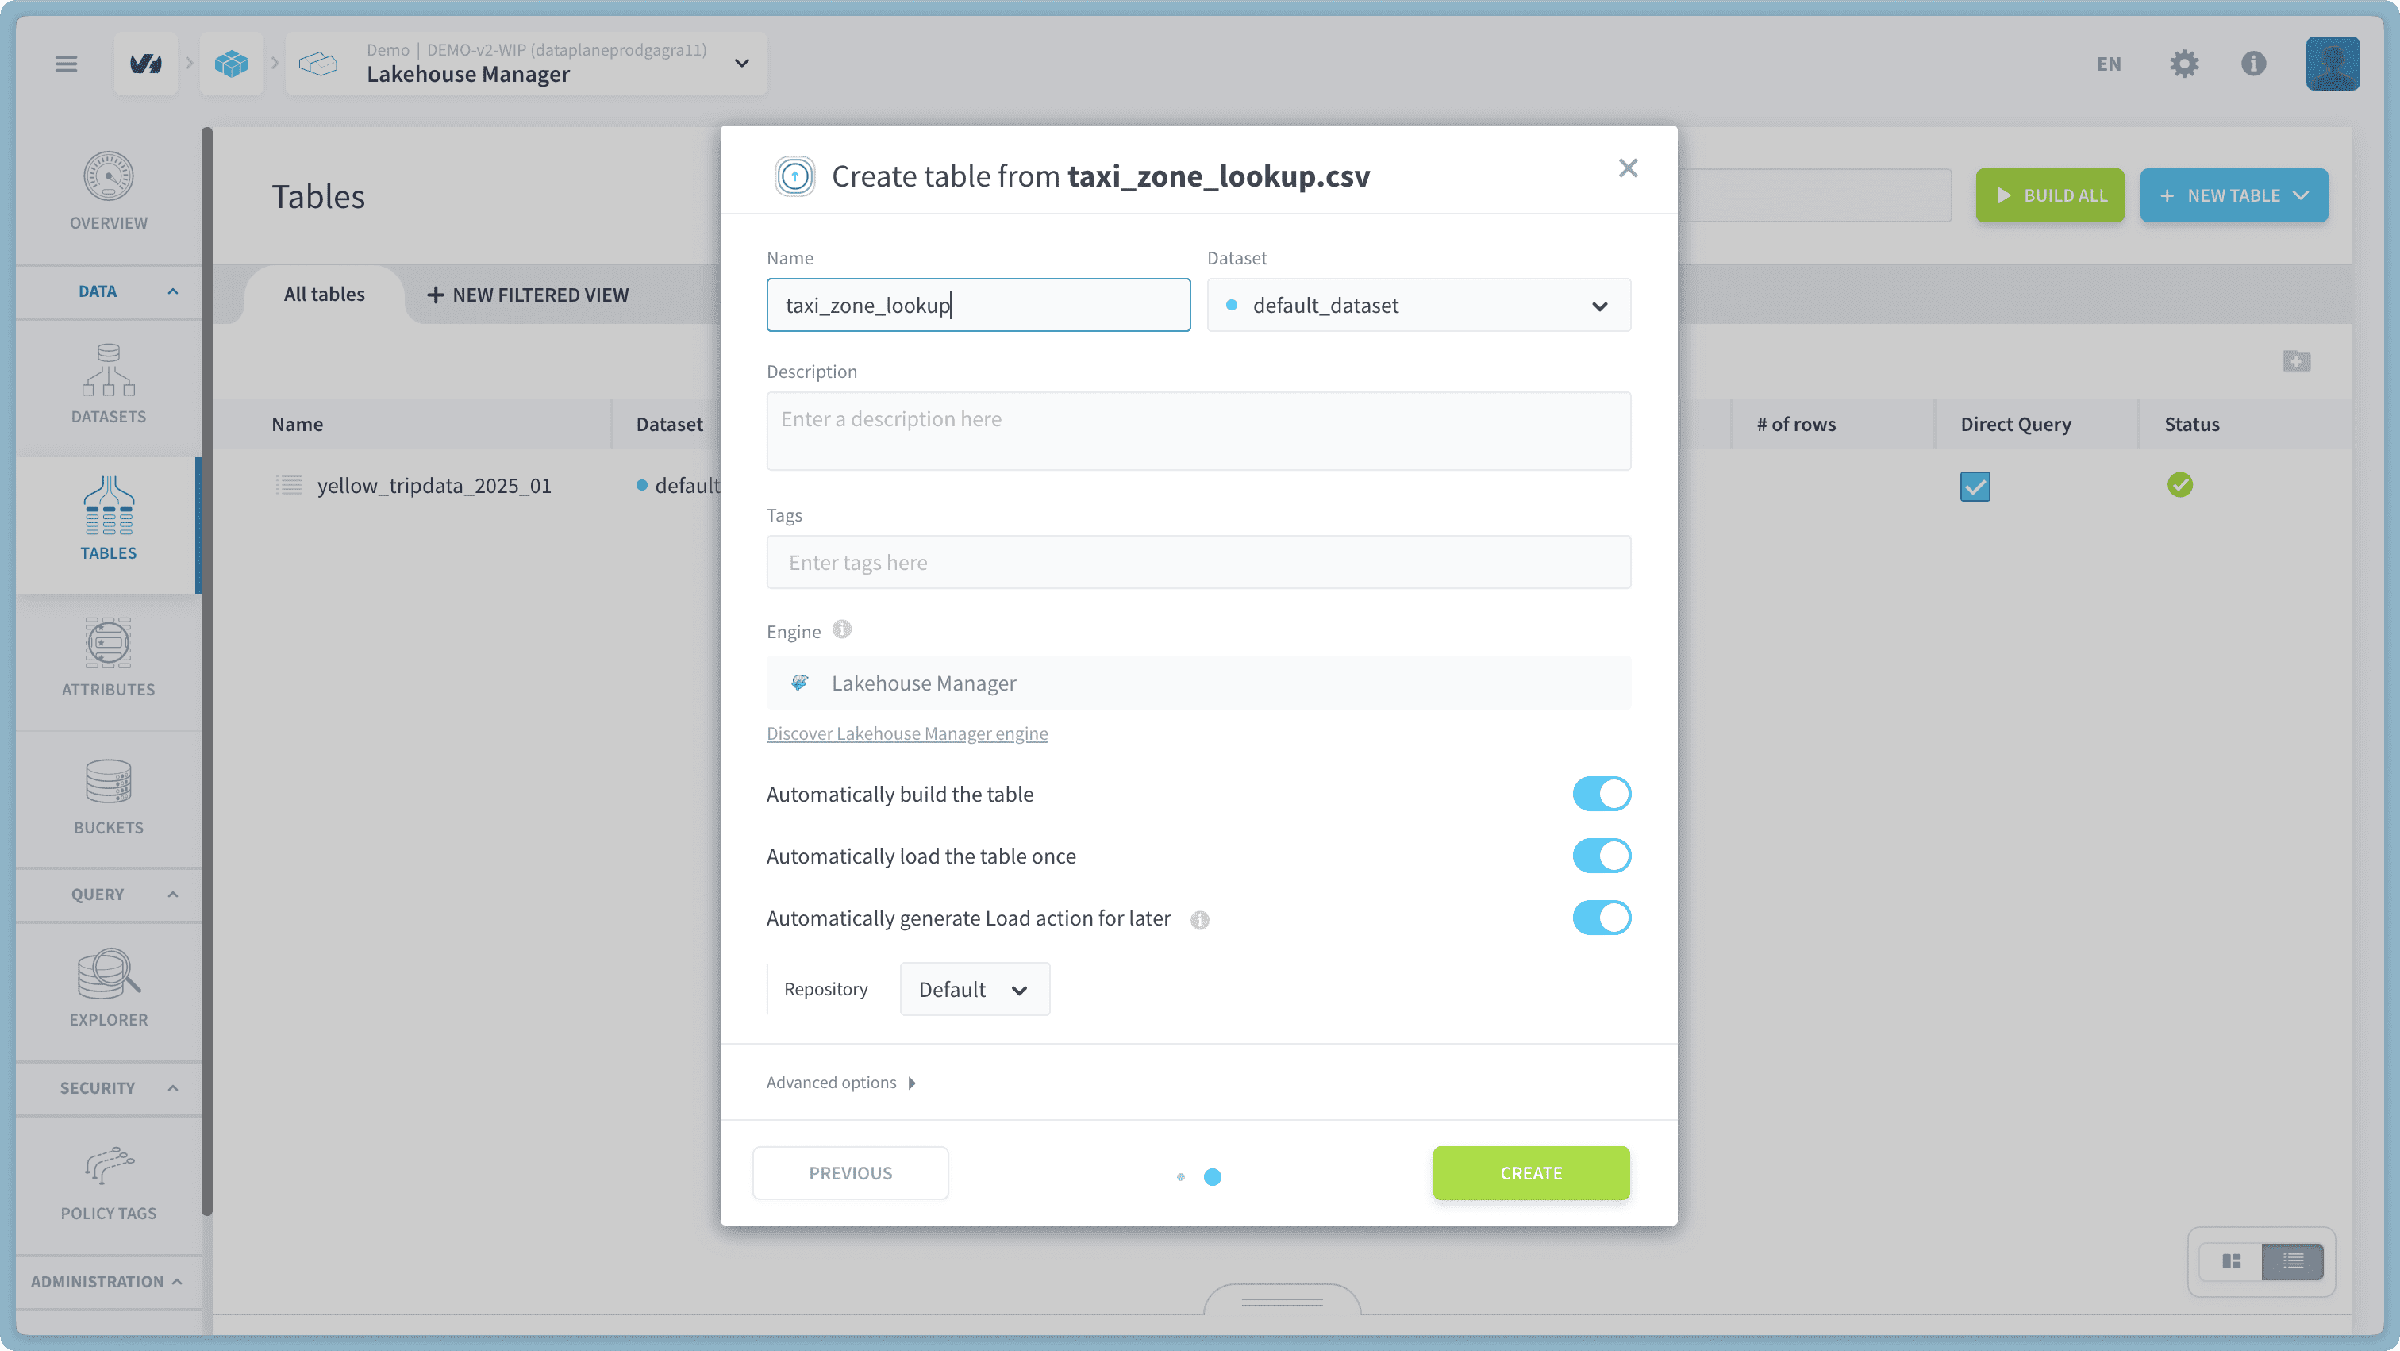
Étape 3 : utiliser l'action Load PySpark dans le DPE
- Allez dans l'onglet Actions → Create new action → utilisez Load PySpark.
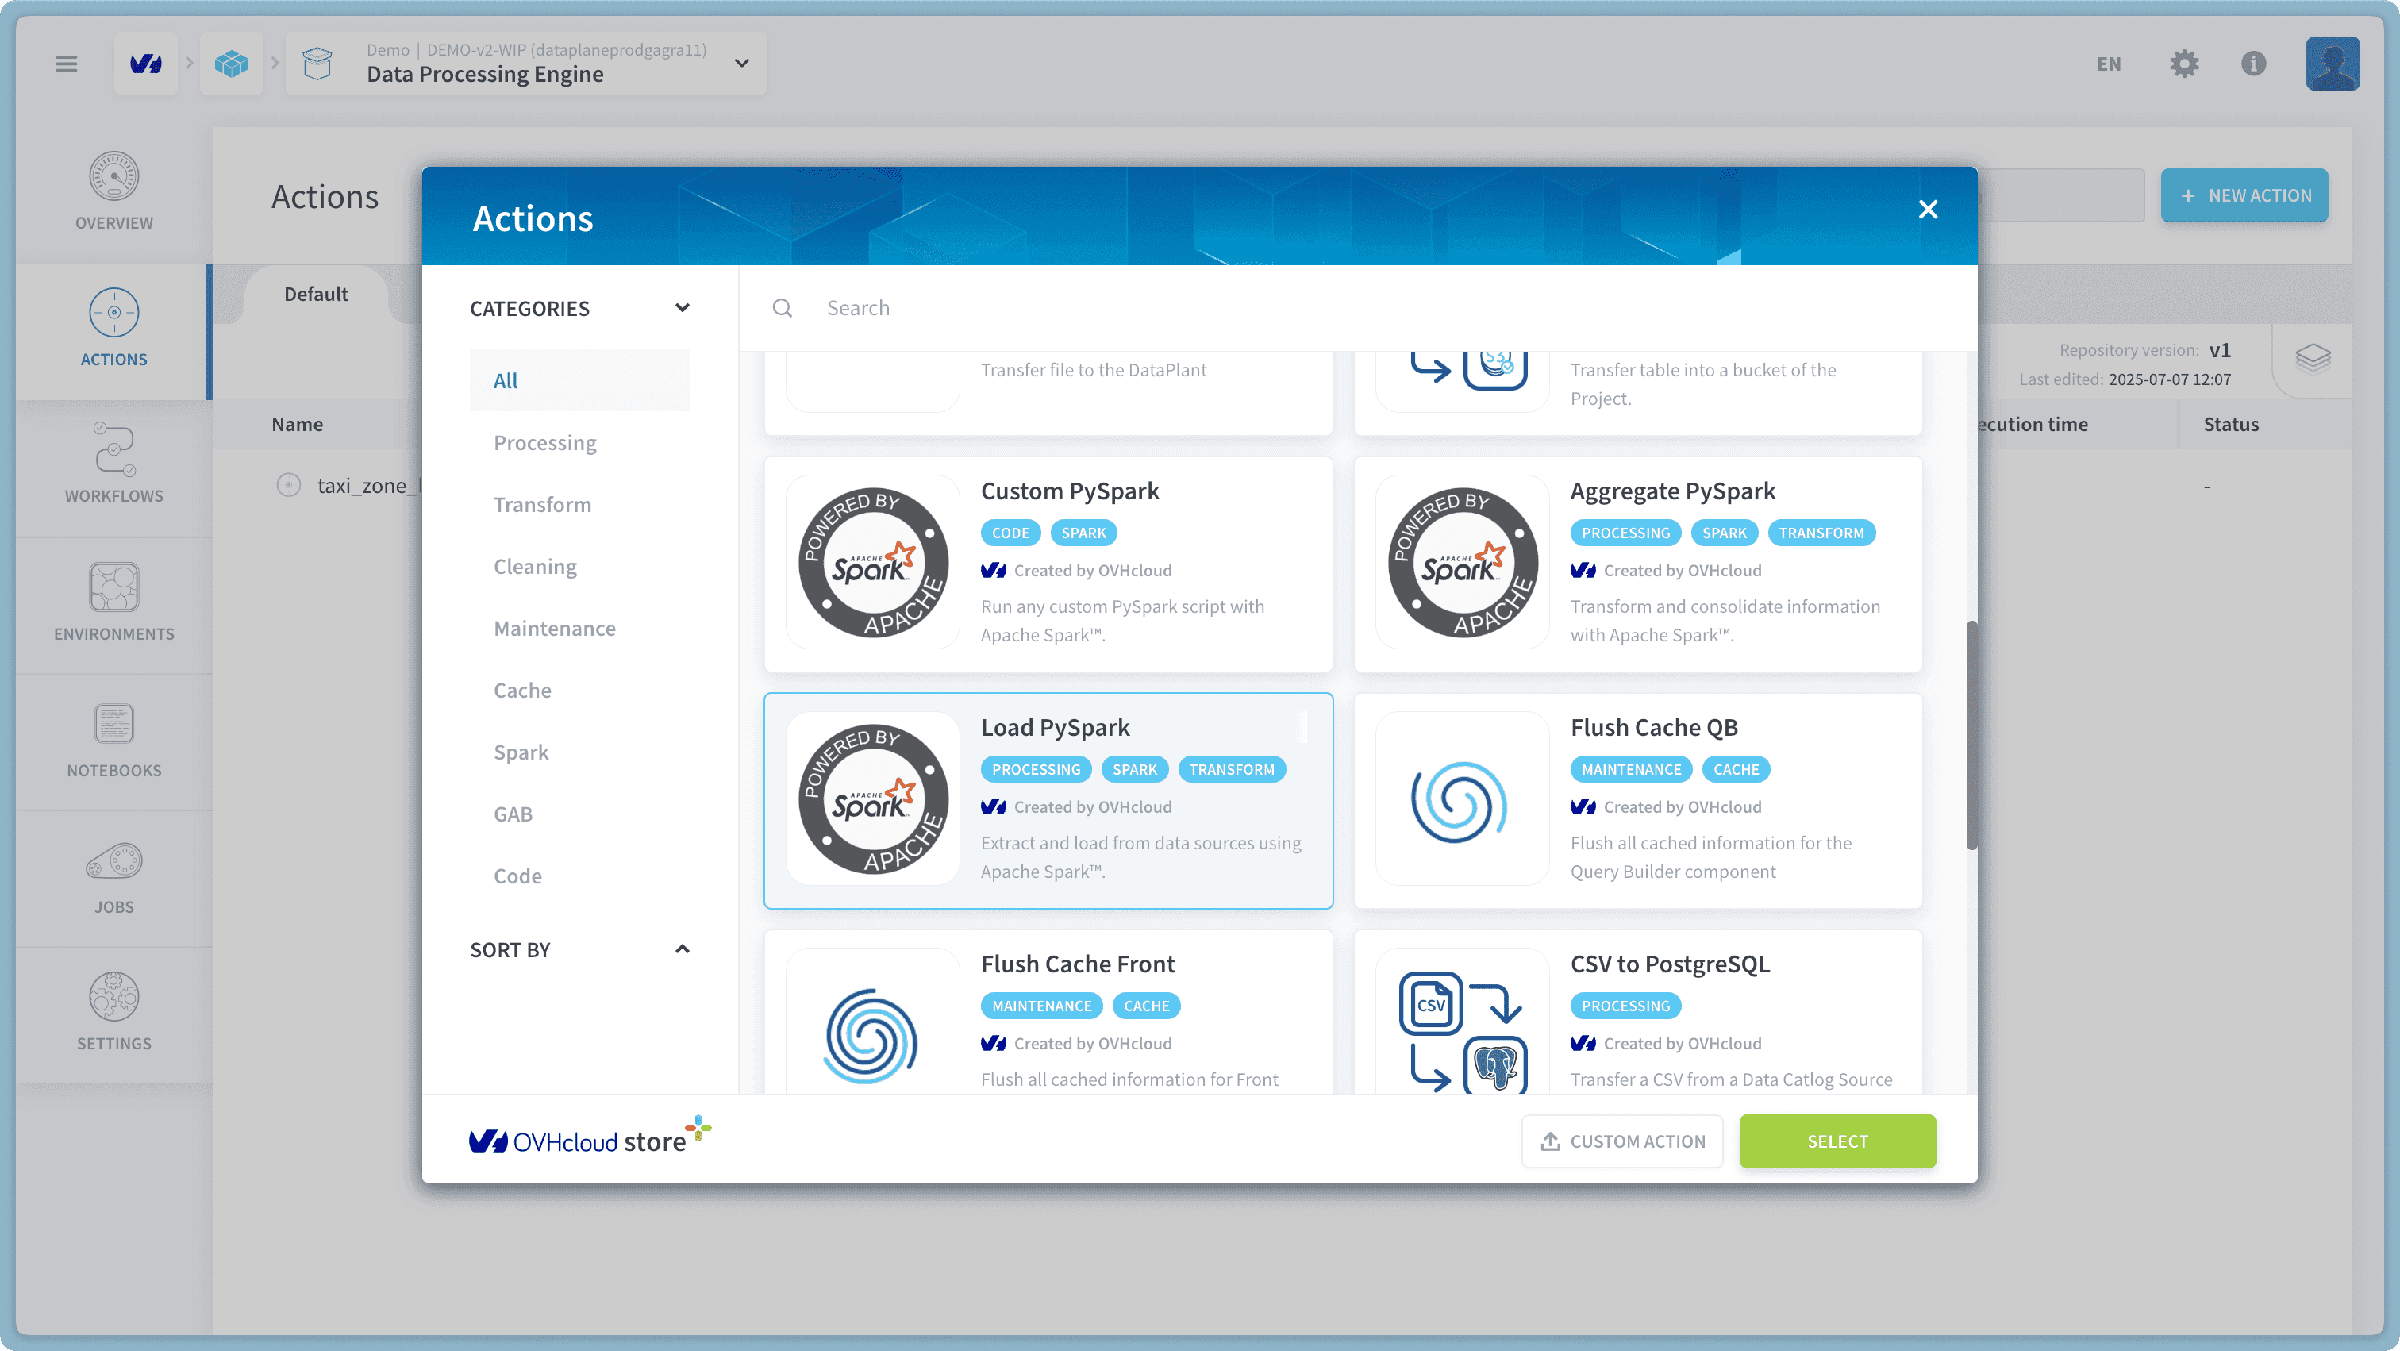
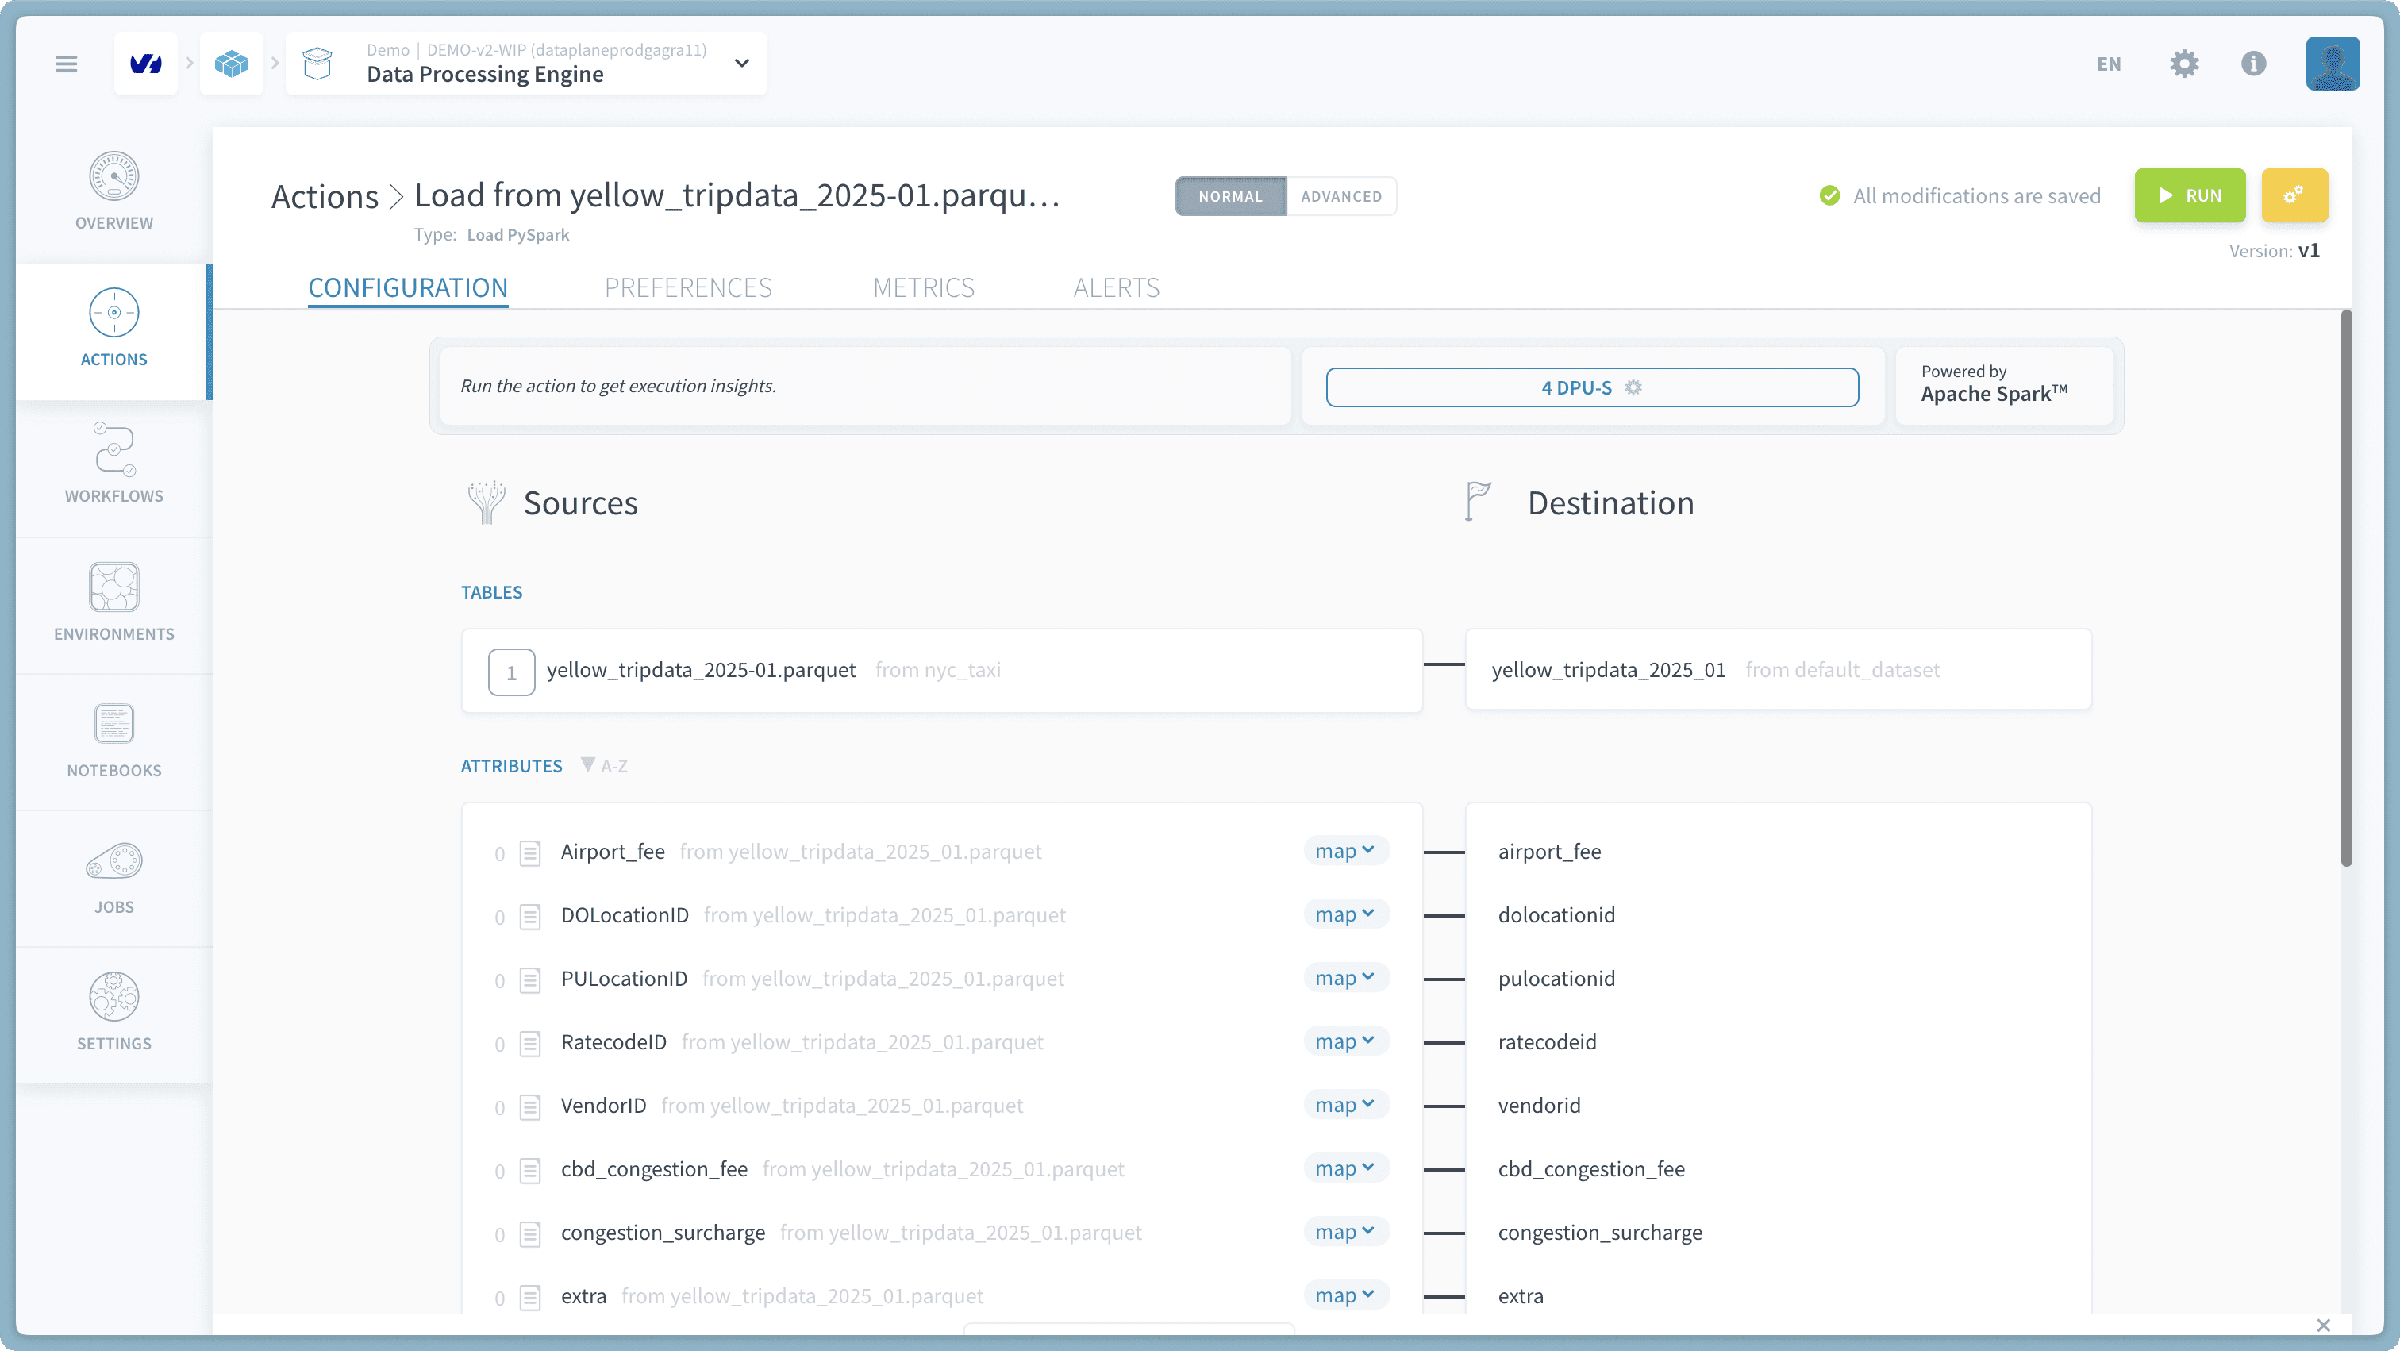
- Définissez :
- Source :
yellow_tripdata_YEAR_MONTH - Destination : la table
yellow_tripdata_YEAR_MONTHdans le Lakehouse Manager.
- Source :
- Assurez-vous que le mapping du schéma est correct (les colonnes source doivent correspondre au schéma de la table)
- Sauvegardez et lancez l'action.
Étape 4 : créer un notebook Jupyter dans le DPE
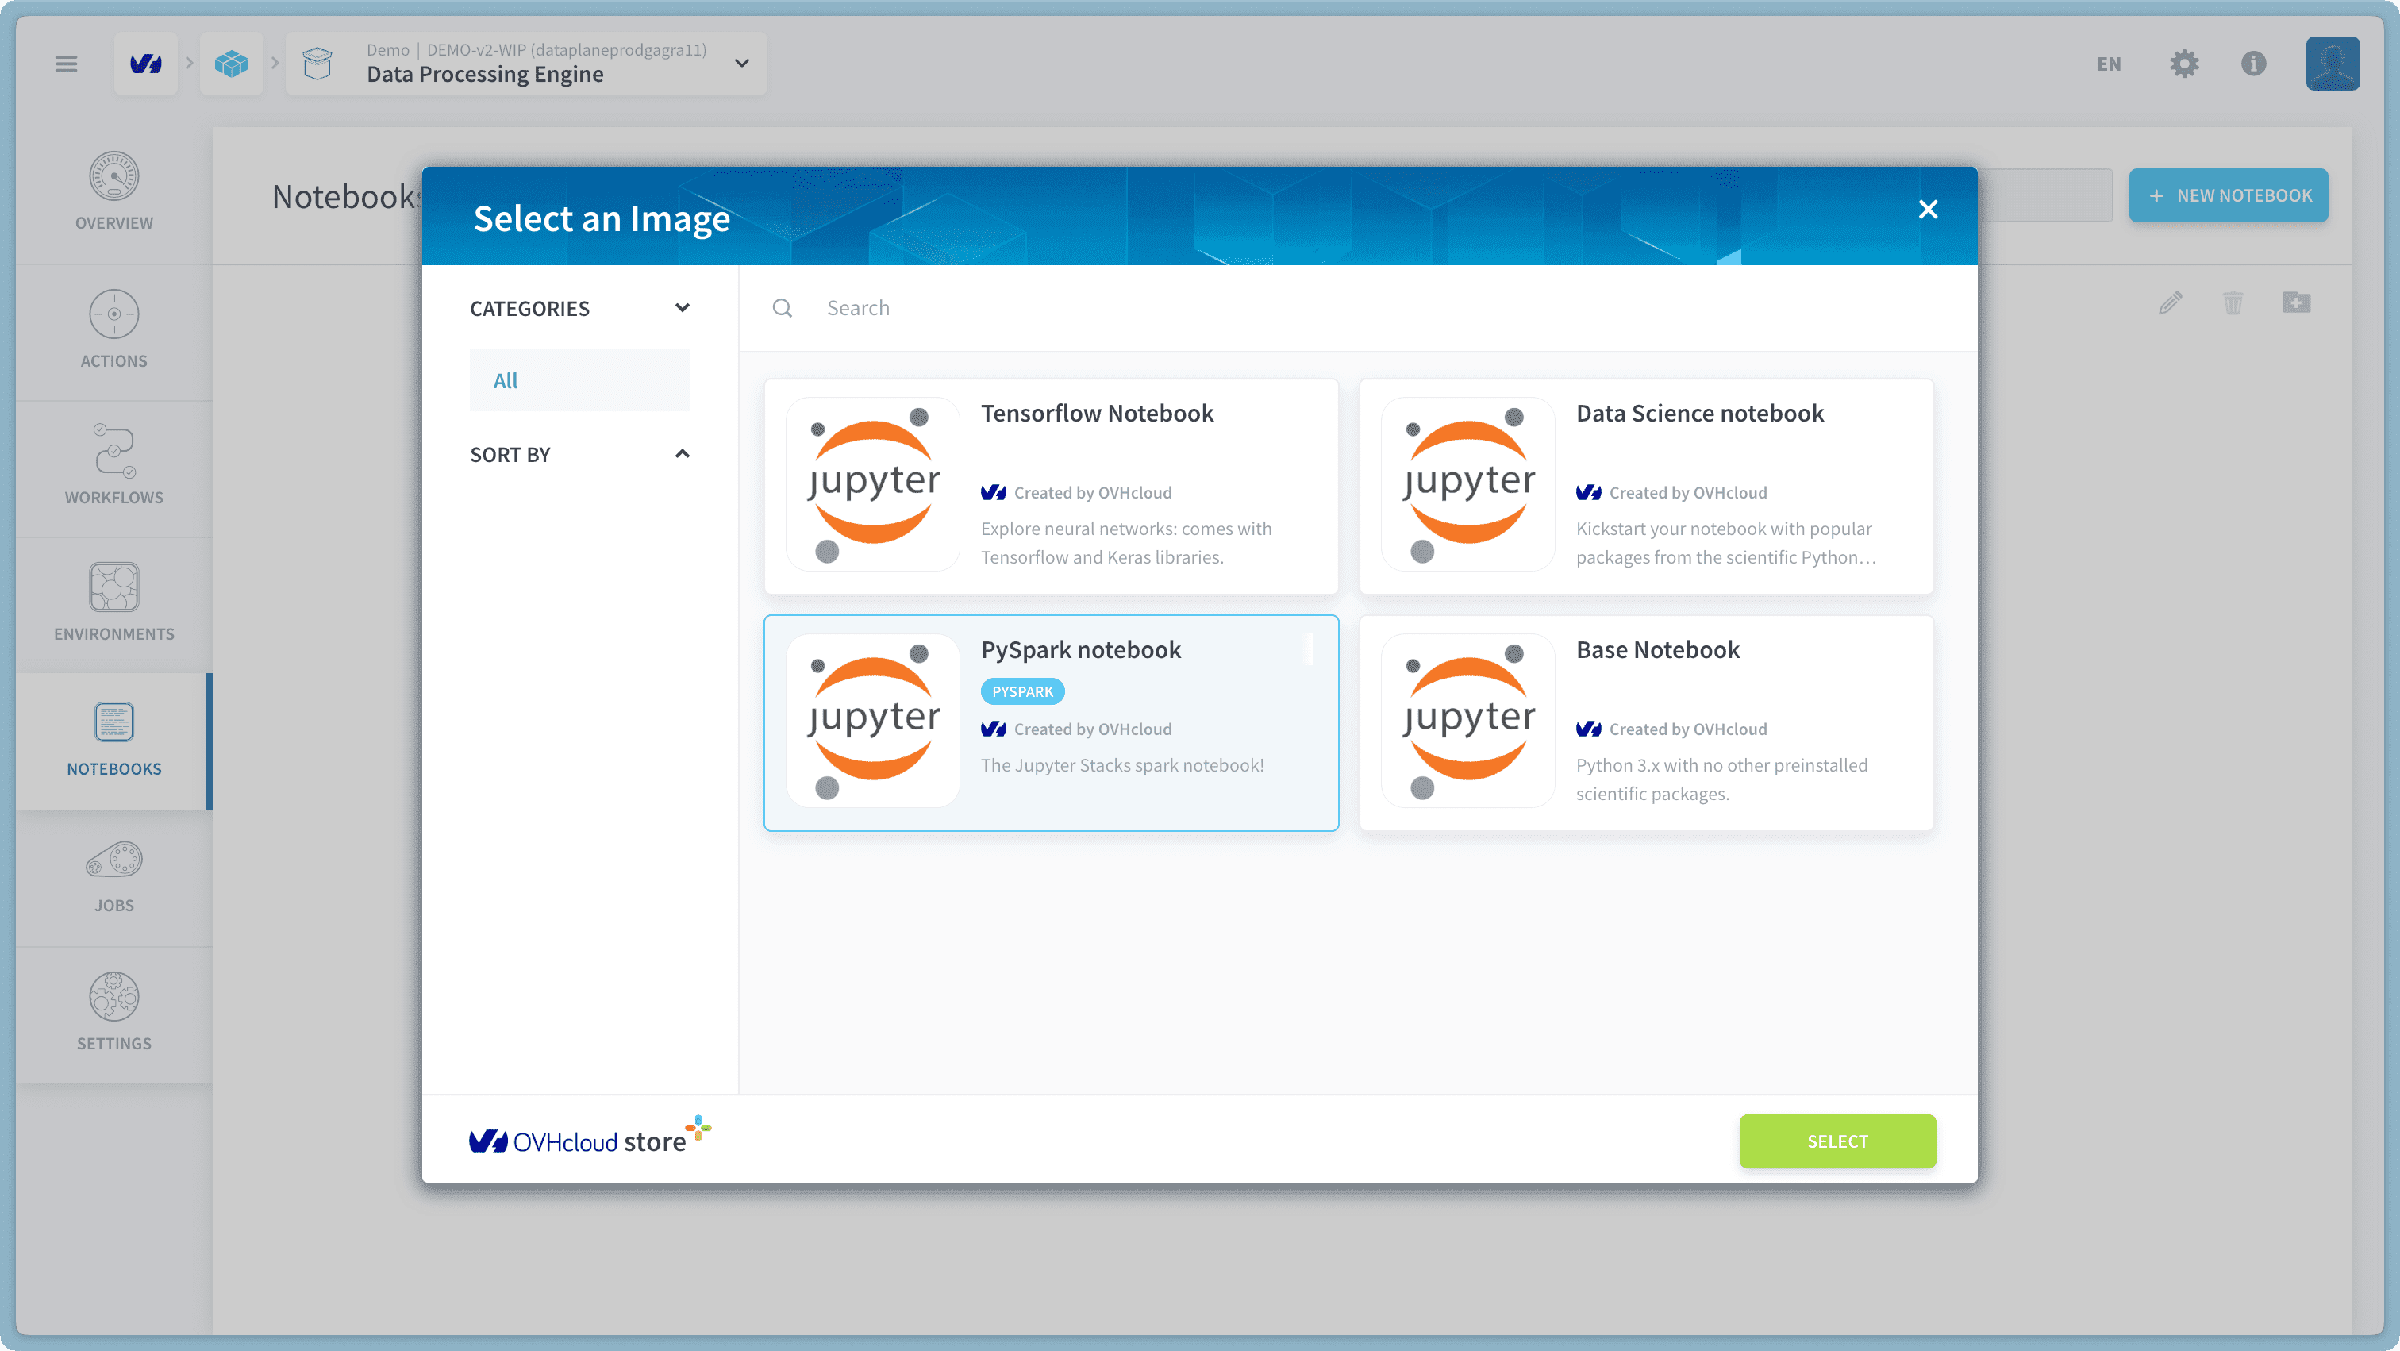
- Allez dans l'onglet « Notebooks » → New notebook → sélectionnez PySpark Notebook.
- Nommez-le
NYC yellow taxi notebook.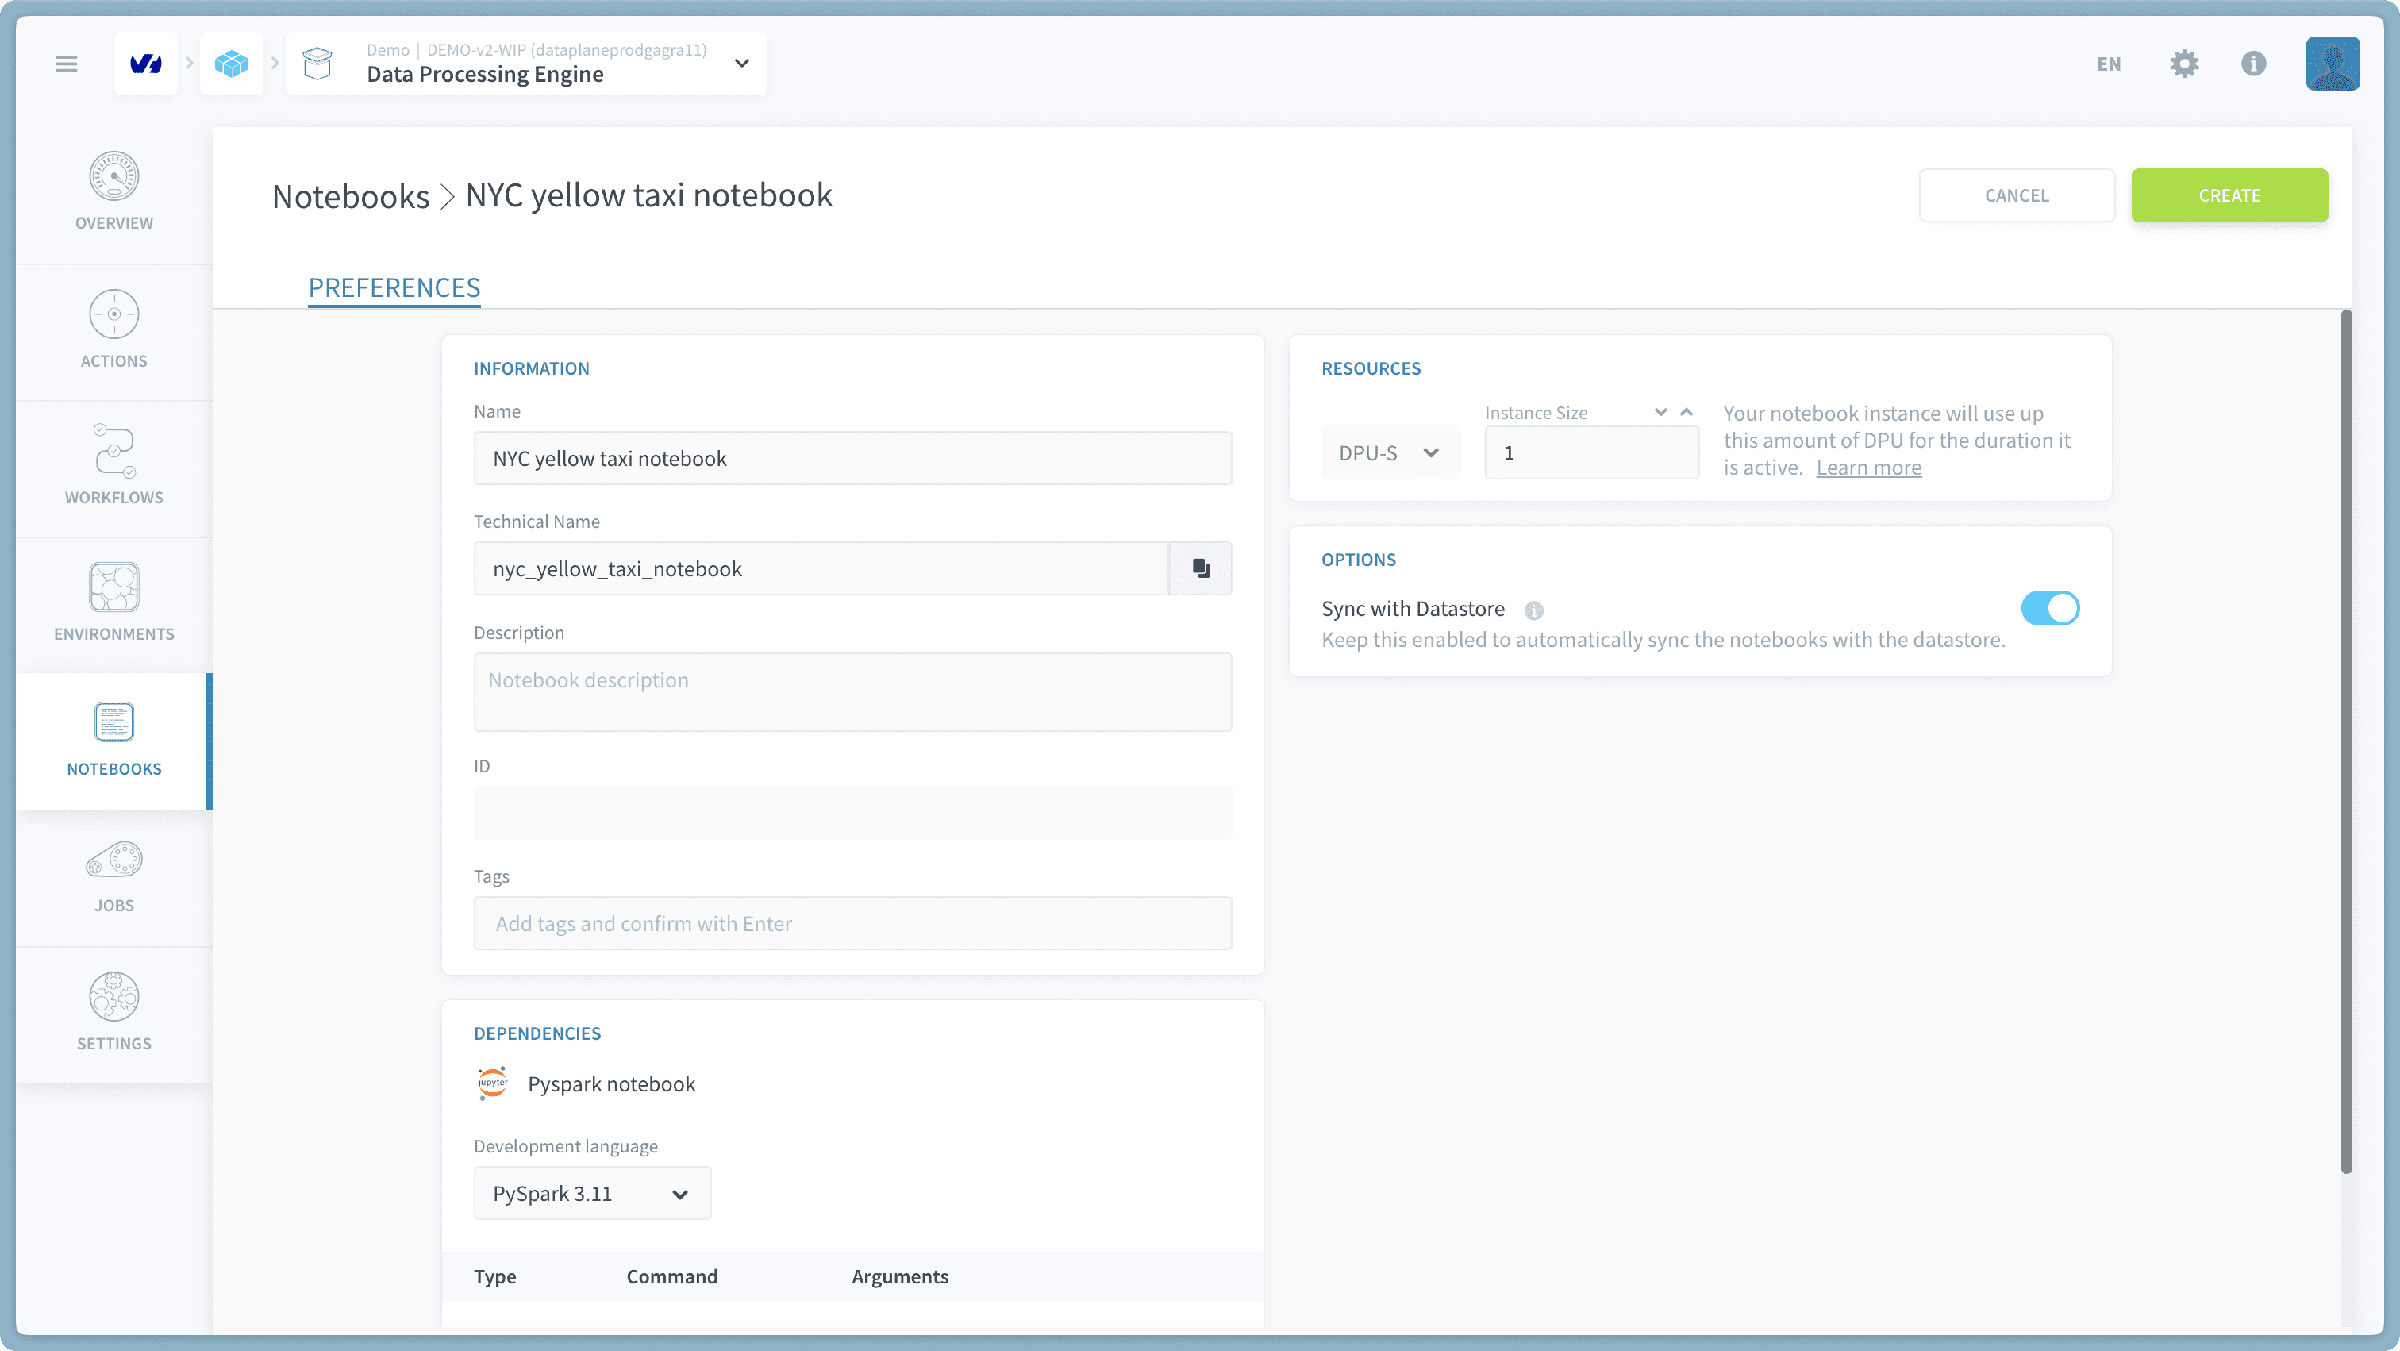
Après le lancement, la platform prendra quelques instants pour initialiser une instance JupyterHub. Une fois prête, cliquez sur le bouton Open in Jupyter pour accéder à l'interface du notebook.
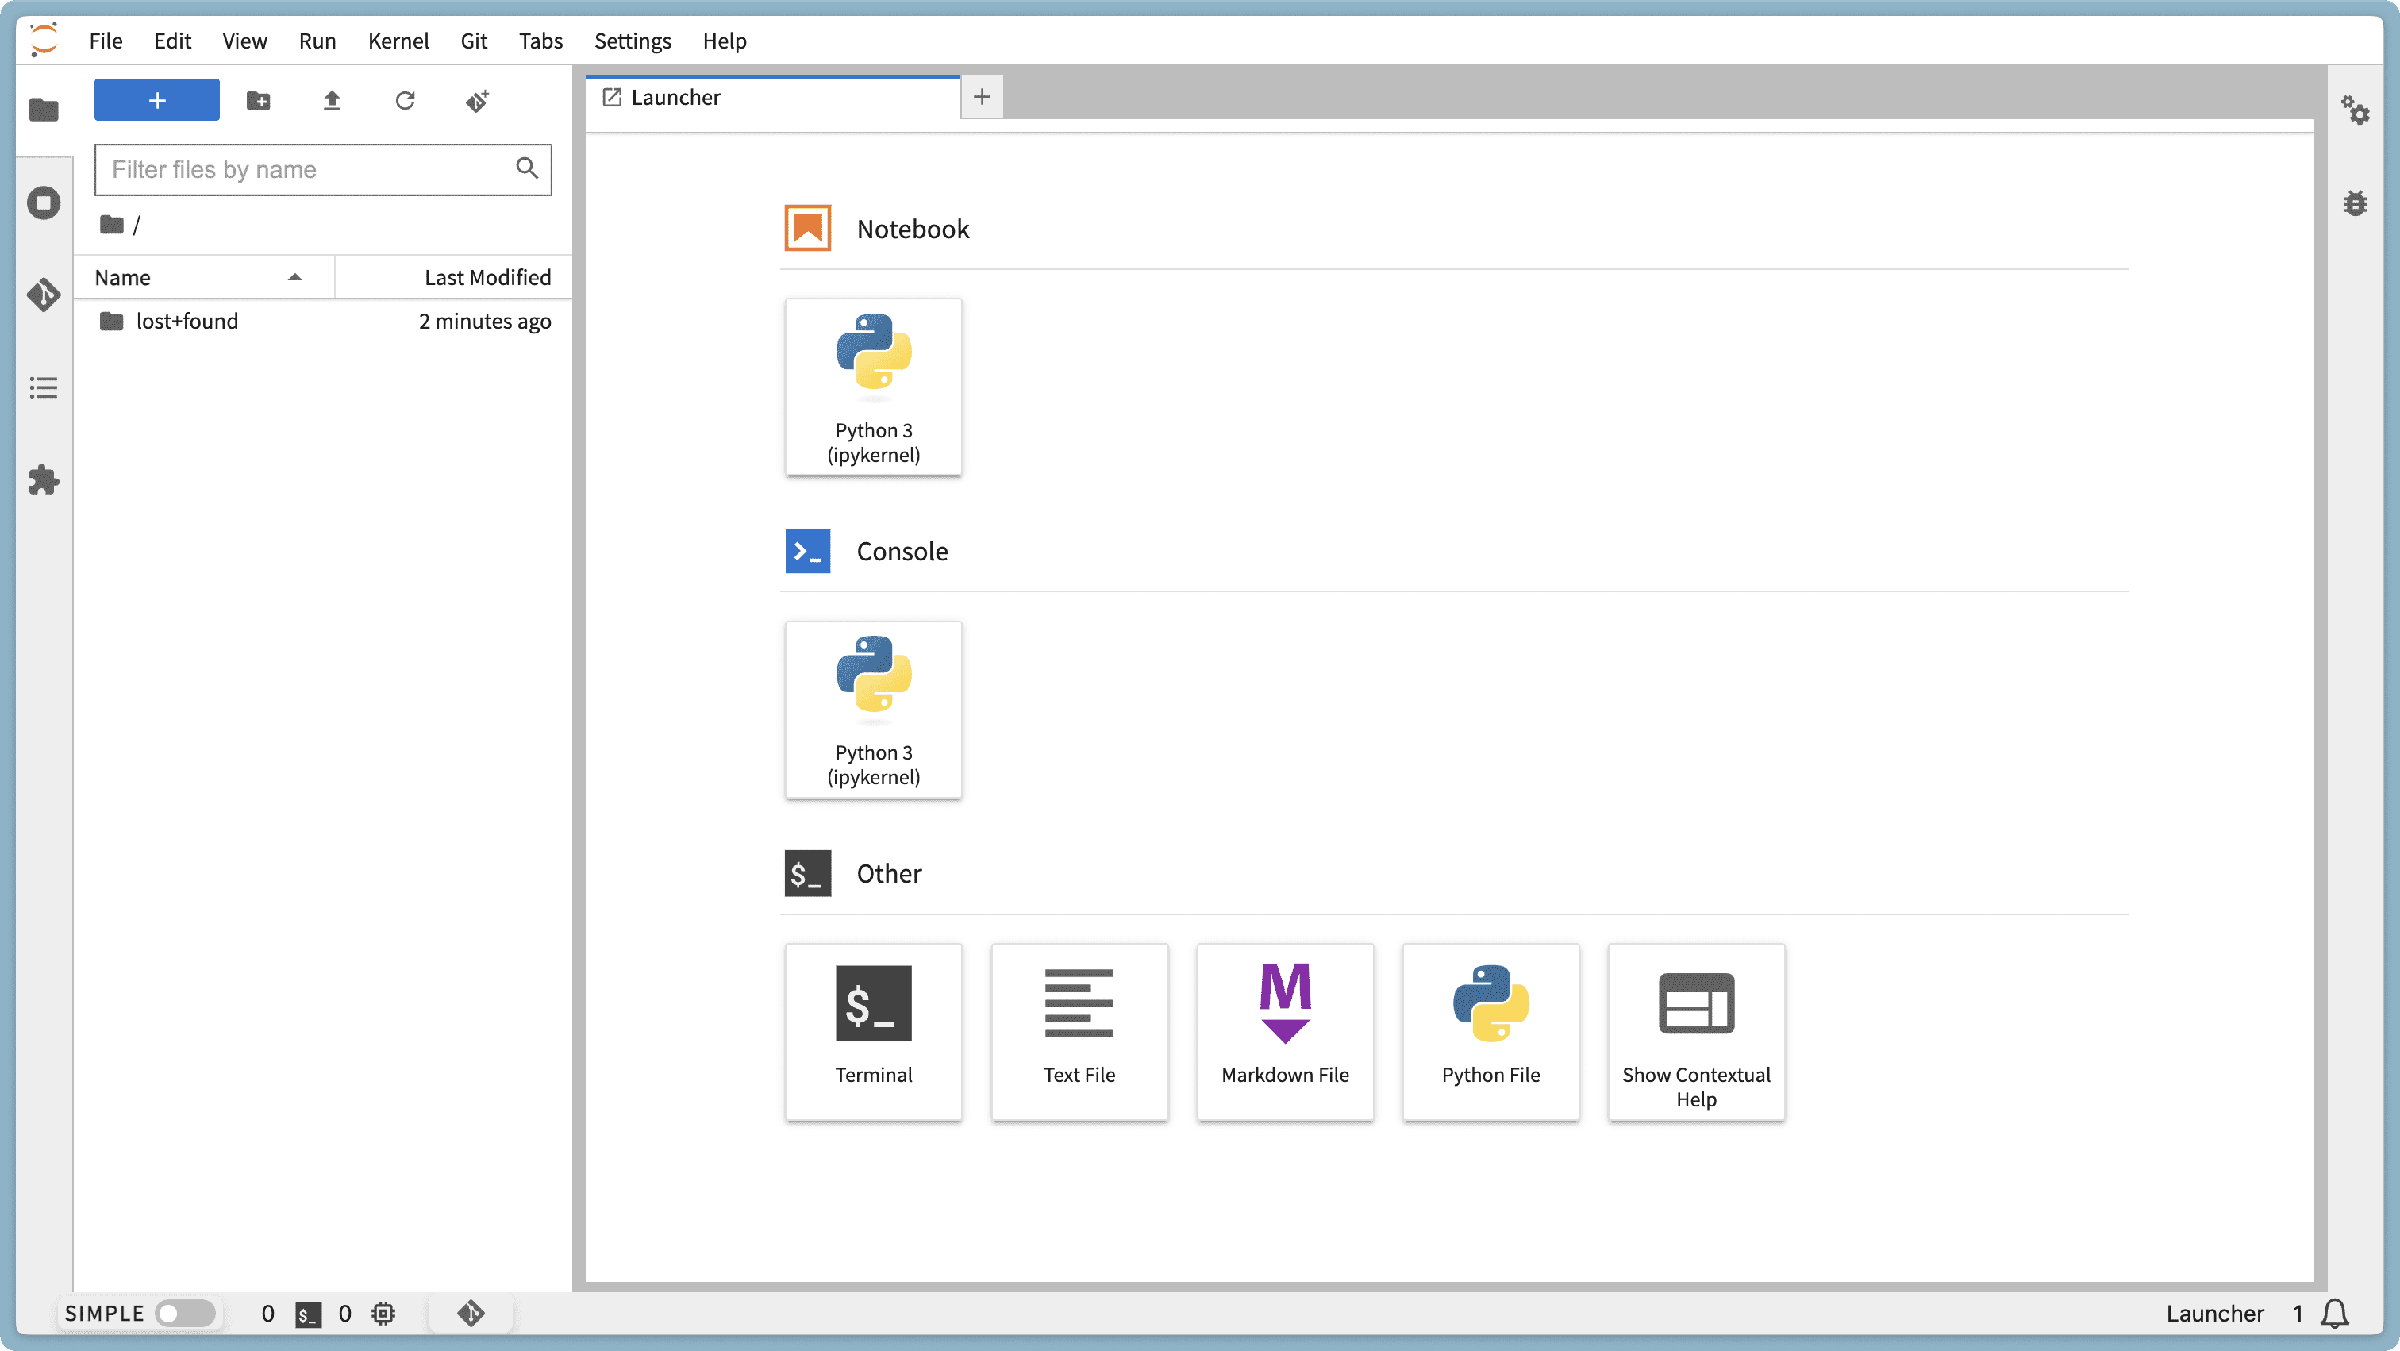
Avec l'environnement de données désormais entièrement configuré et toutes les sources chargées dans le Lakehouse, nous sommes prêts à plonger dans le notebook PySpark et à commencer notre analyse.
Parcours du notebook PySpark
Le notebook ci-dessous contient l'intégralité du code PySpark, structuré étape par étape avec des commentaires et des explications intégrés. Vous pouvez le télécharger et le charger directement dans votre environnement Jupyter sur la Data Platform OVHcloud. Chaque étape est expliquée en détail pour vous aider à suivre le processus d'analyse, et un résumé est fourni à la fin pour une consultation rapide.
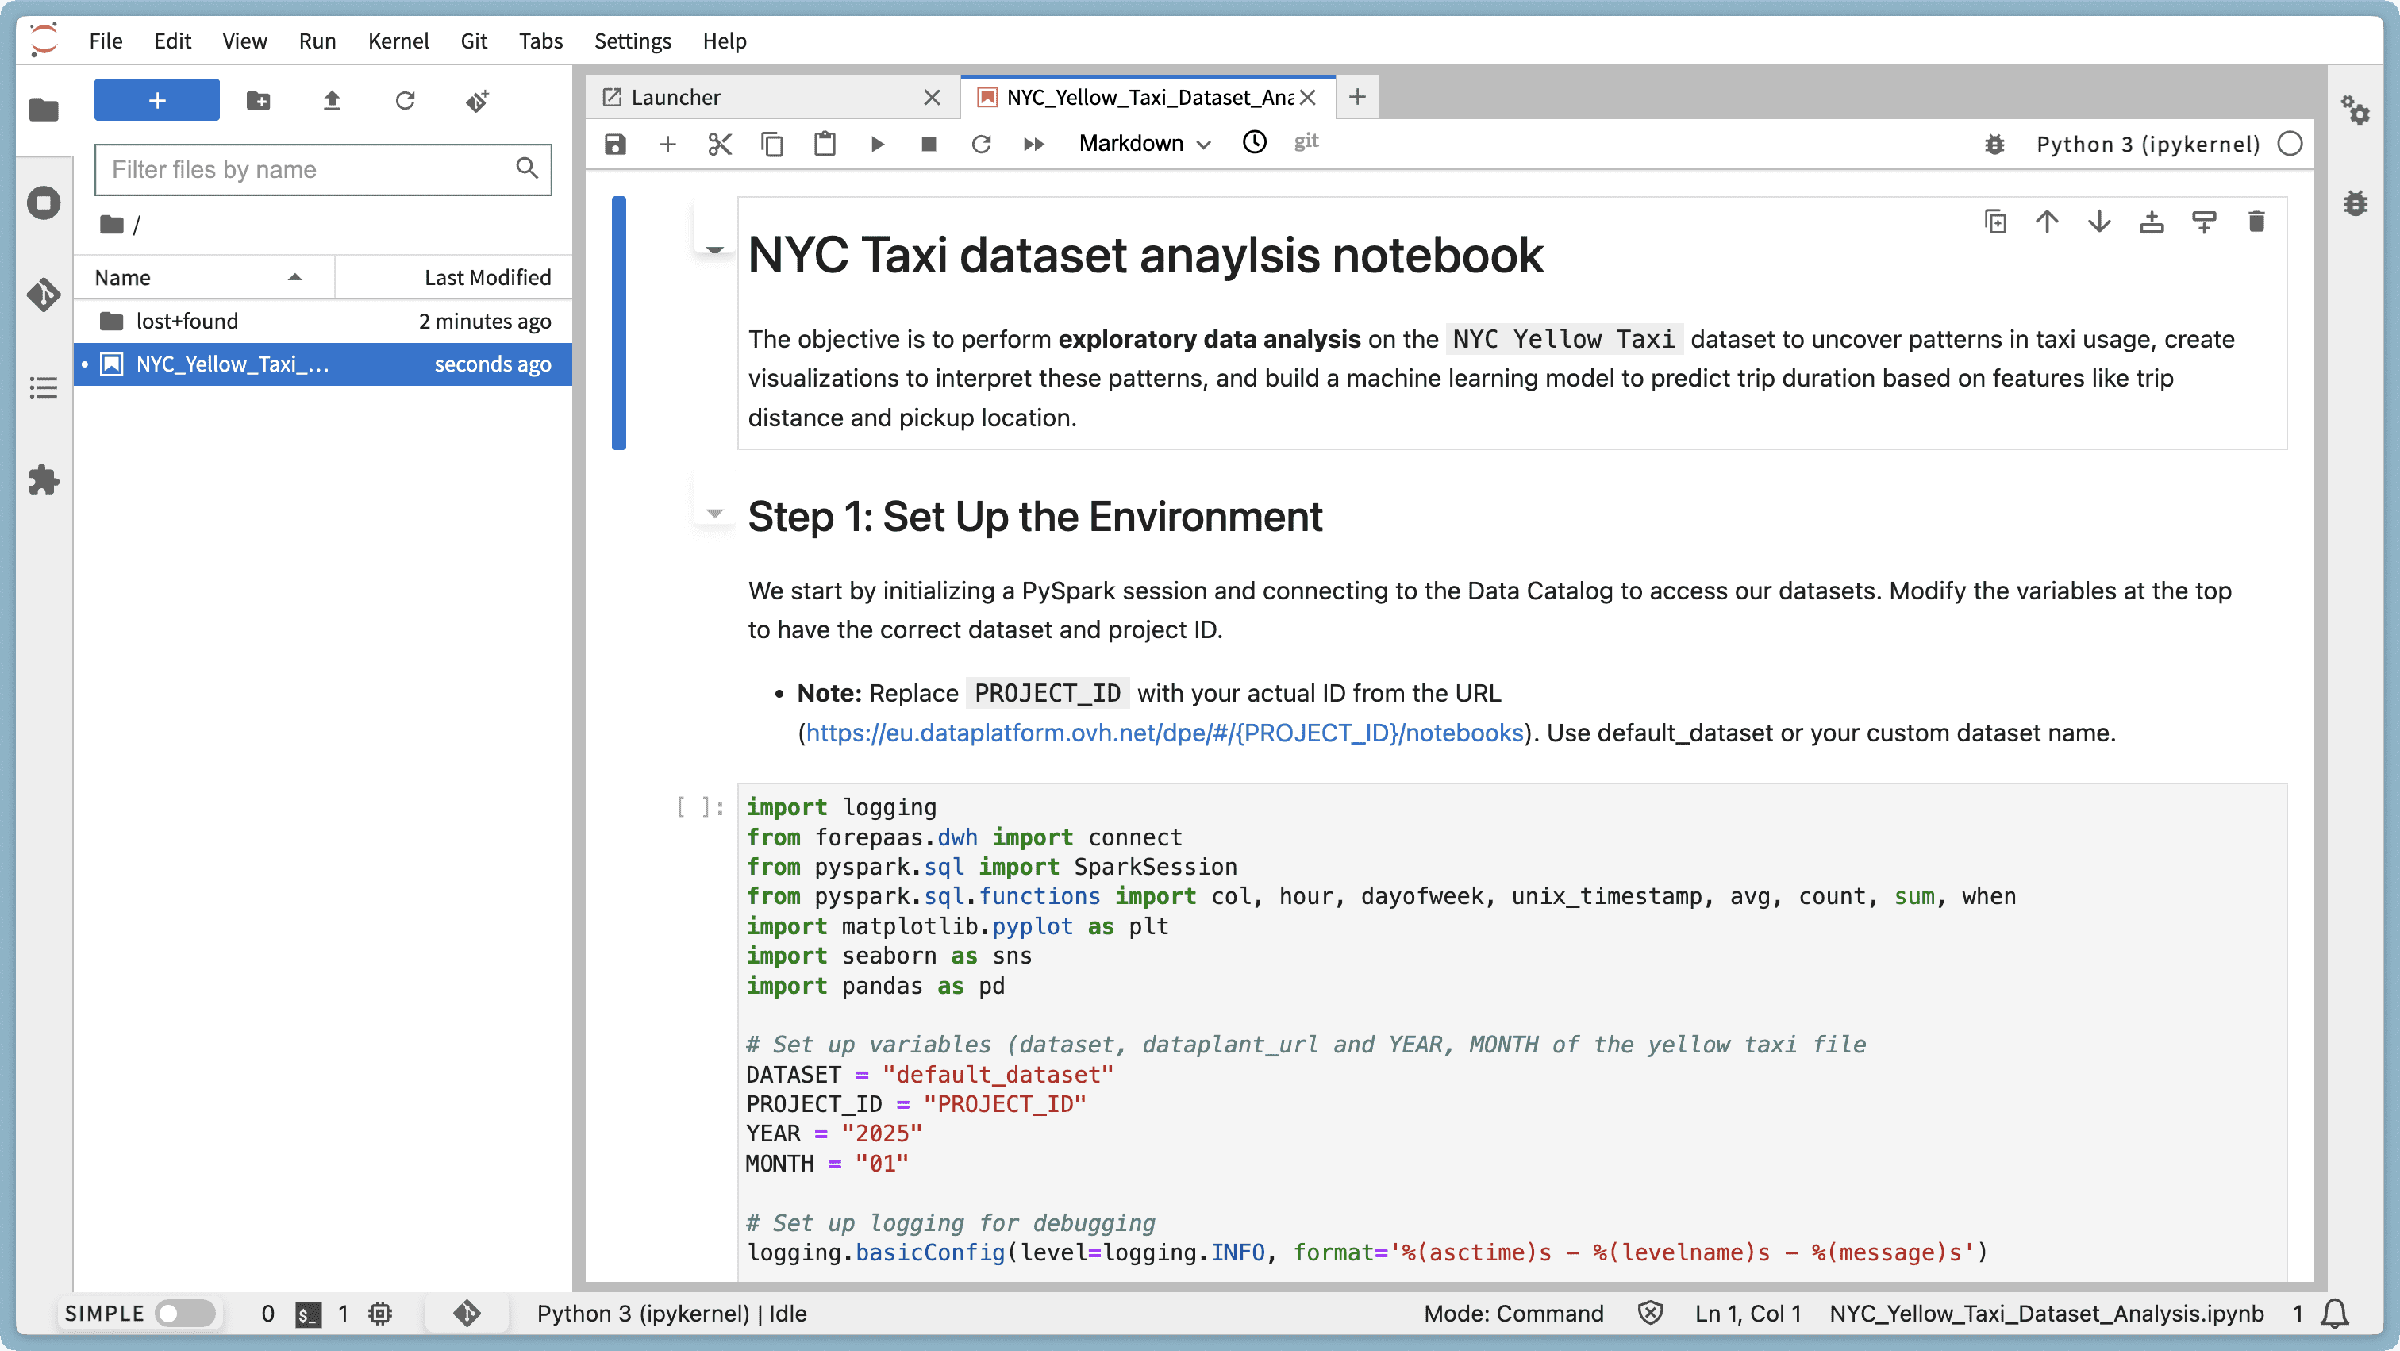
Que contient le notebook ?
Le notebook vous guide à travers :
- La connexion au Lakehouse Manager et le chargement du dataset
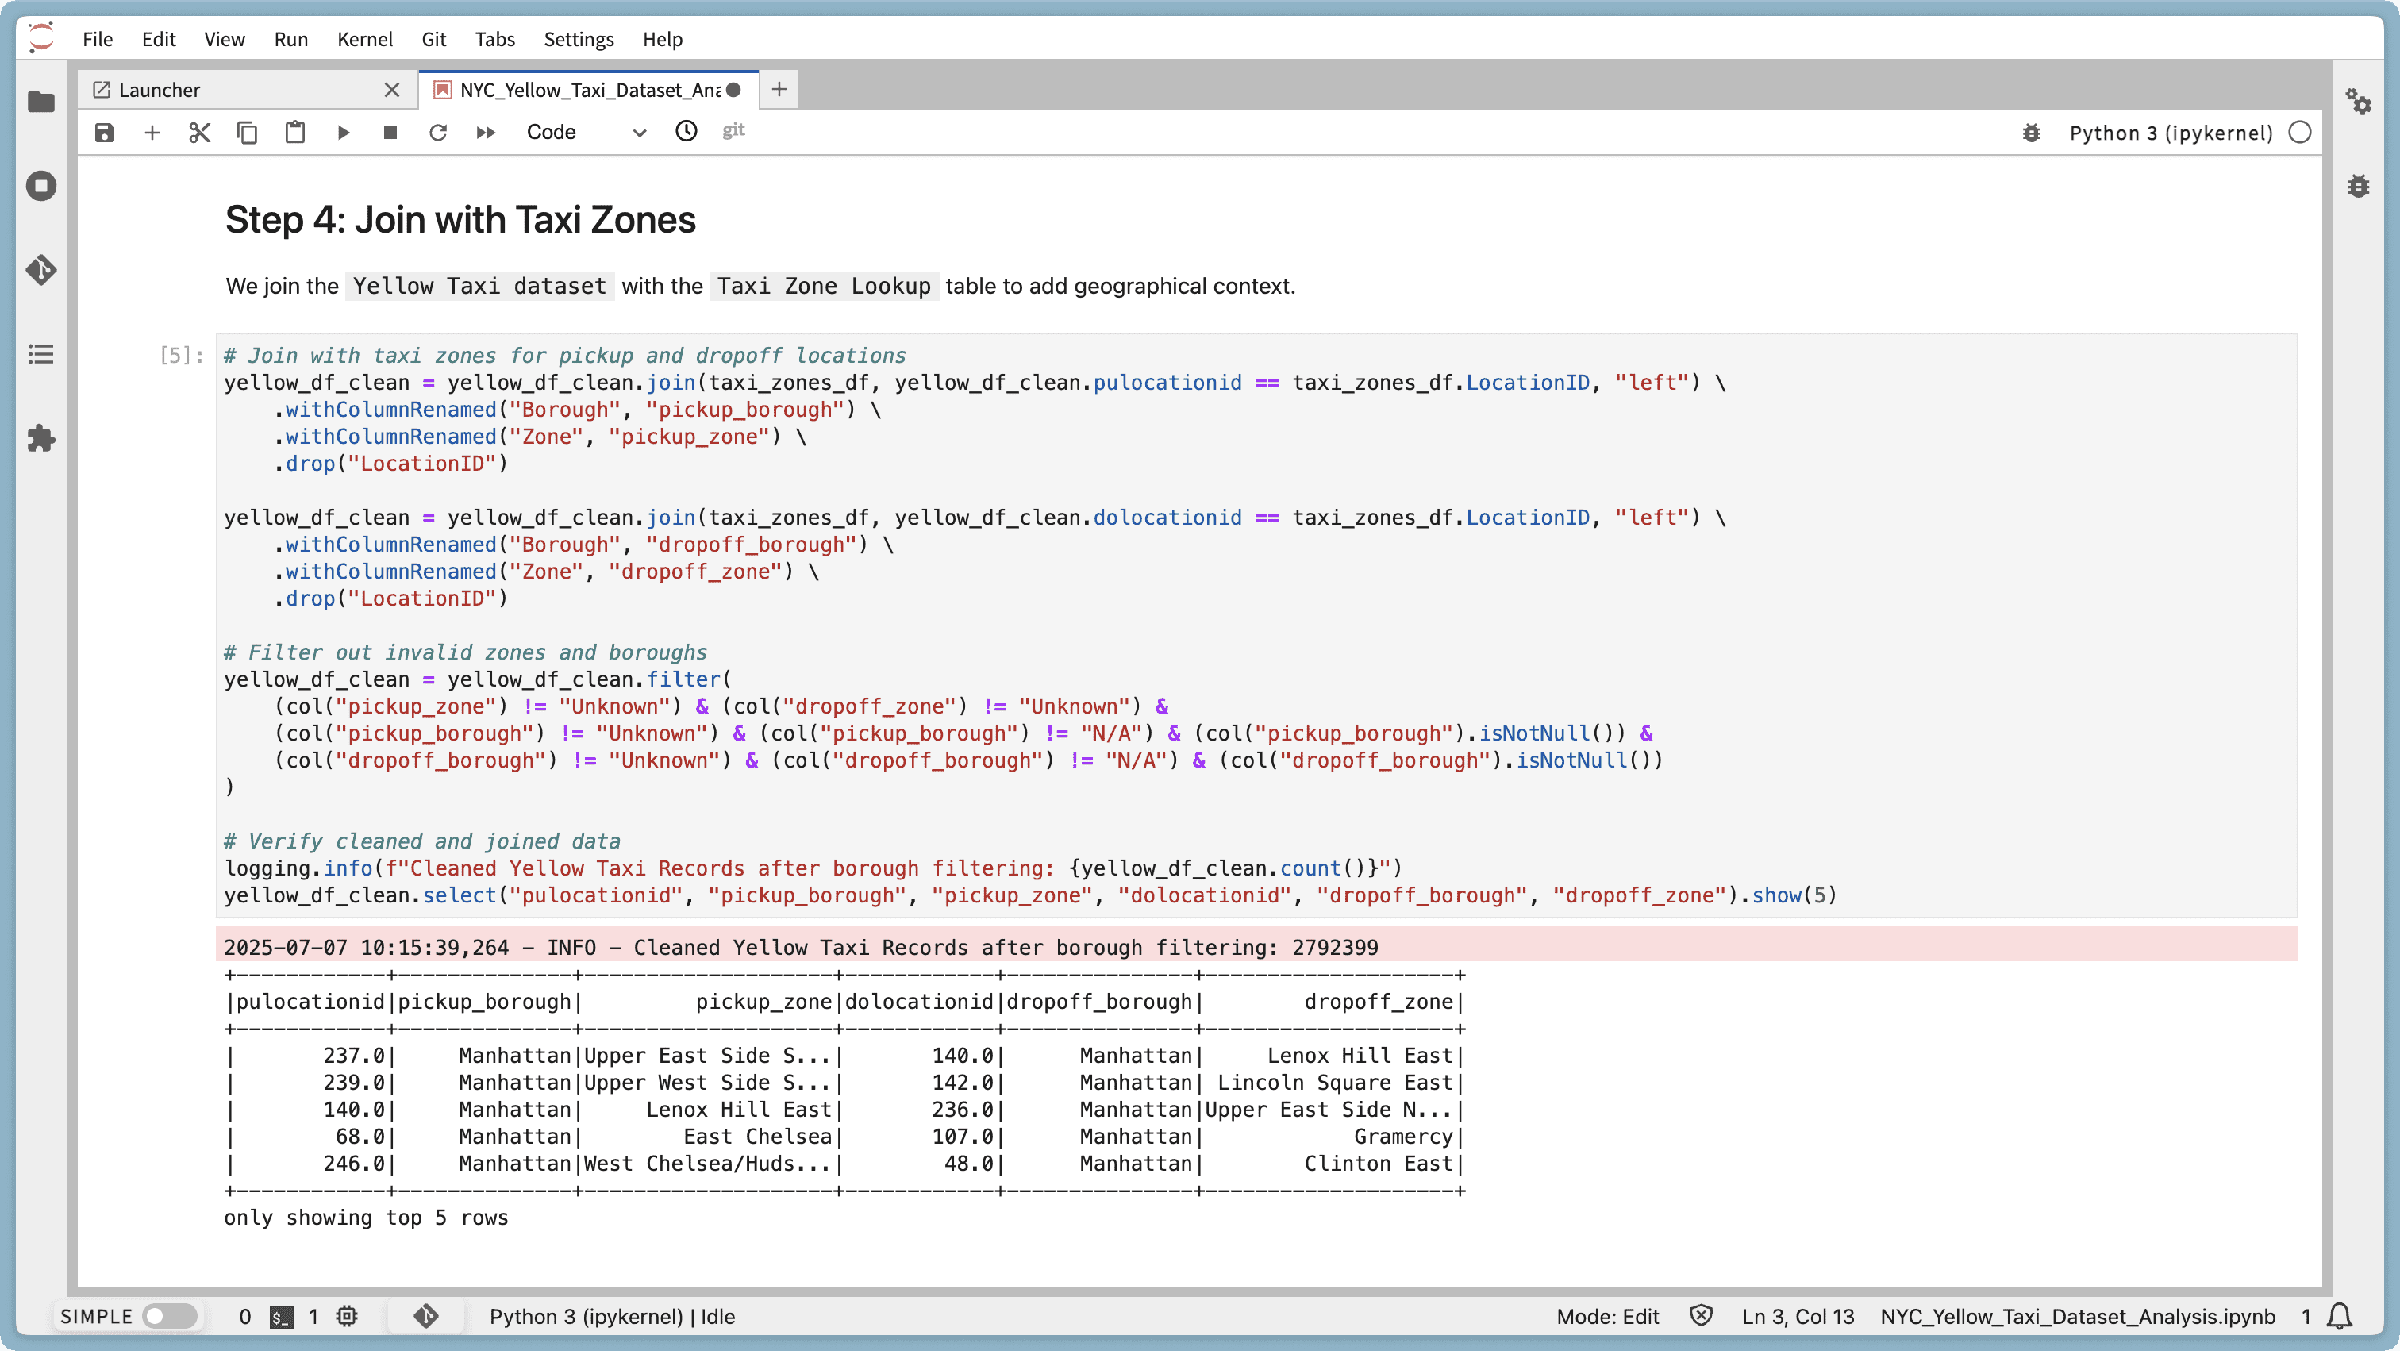
- Le nettoyage et la jointure des données de trajet avec les zone lookups
- La réalisation d'une EDA avec Matplotlib et Seaborn
- La construction et la comparaison de trois modèles de ML (Linear Regression, Random Forest, GBT)
- La restitution des métriques de performance et des enseignements
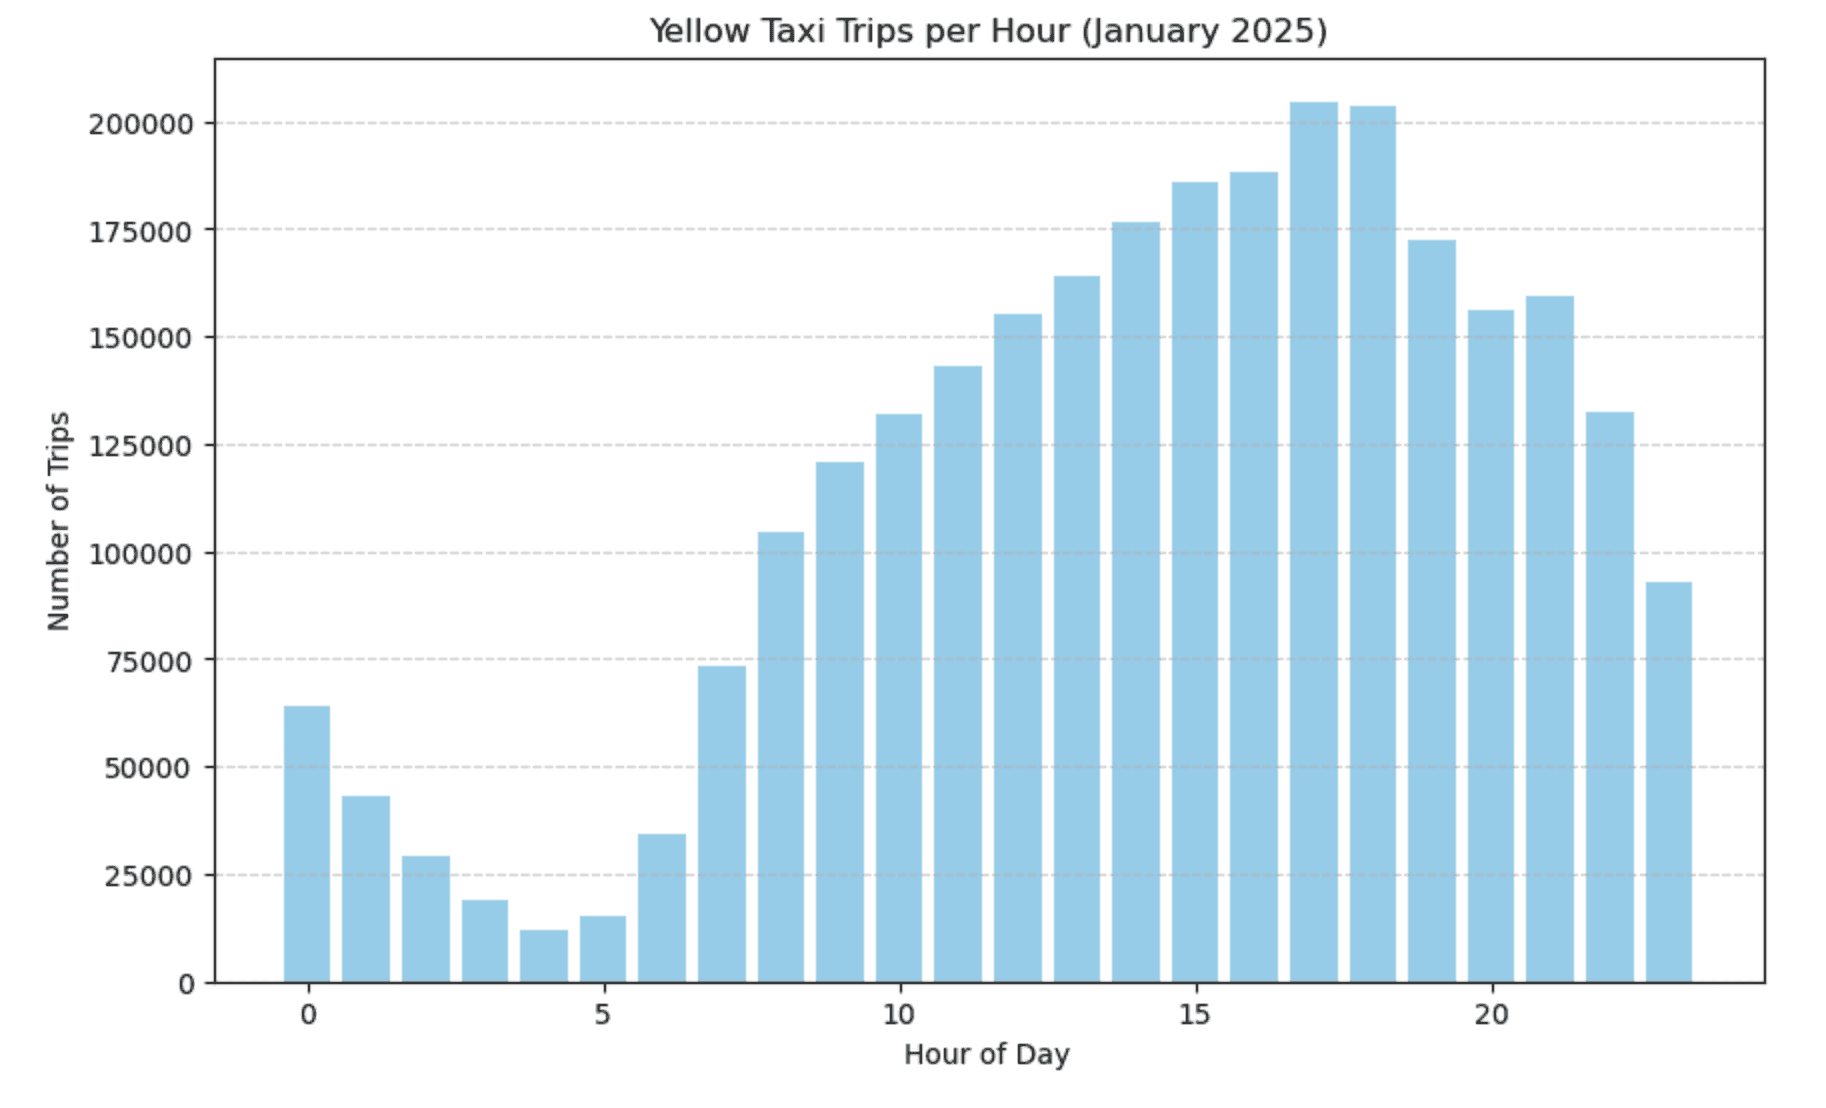
Voici quelques exemples de résultats issus du notebook :
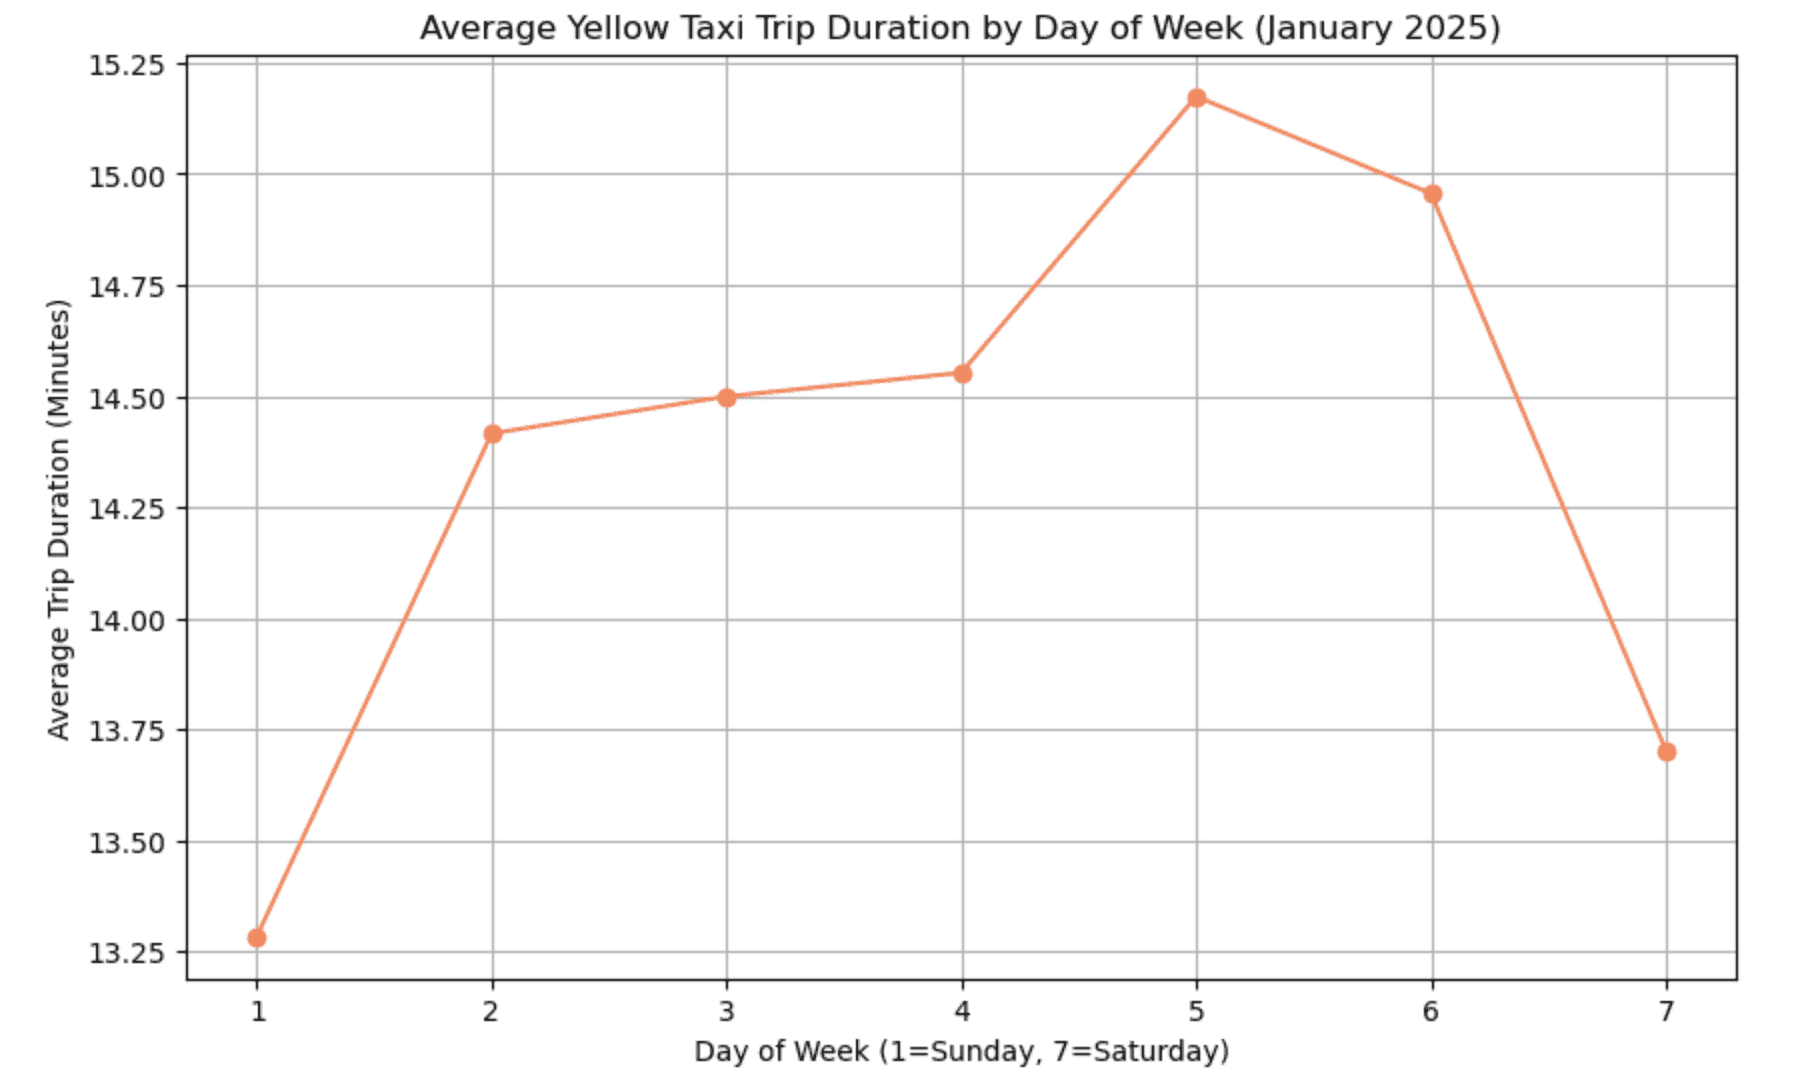
Prédiction de la durée des trajets NYC Taxi – résumé
Objectif
L'objectif de cette analyse était de prédire trip_duration à l'aide de modèles de machine learning entraînés sur les données NYC Yellow Taxi. Ces prédictions peuvent aider à optimiser les stratégies de répartition des taxis, à améliorer les estimations de tarif, et à soutenir la prise de décision opérationnelle.
Modèles comparés
Nous avons évalué trois modèles de régression pour comprendre leur efficacité sur cette tâche :
- Linear Regression – une base simple et interprétable
- Random Forest – une méthode d'ensemble qui capture les relations non linéaires
- Gradient Boosted Trees (GBT) – une approche par boosting visant à maximiser la précision prédictive
Préparation des données
Pour garantir des données d'entrée de haute qualité et de meilleures performances de modèle, les étapes suivantes ont été réalisées :
- Suppression des valeurs aberrantes extrêmes (trajets de moins de 60 secondes ou de plus de 3600 secondes)
- Encodage des variables catégorielles (par ex.
pickup_borough) - Mise à l'échelle et assemblage des features numériques dans un vecteur de features unifié
Features utilisées
trip_distancepickup_hourday_of_weekpickup_borough(indexé)
Répartition des données
- Ensemble d'entraînement : 80 % (~2,2 millions d'enregistrements)
- Ensemble de test : 20 % (~556 000 enregistrements)
Performance des modèles
Interprétation :
GBT a obtenu la meilleure performance globale, avec la plus faible Root Mean Squared Error (~4,8 minutes) et le meilleur score R² (80,6 % de variance expliquée).
Importance des features (Random Forest)
Enseignement :
La distance du trajet était de loin le prédicteur le plus influent. L'arrondissement de prise en charge avait un certain impact, tandis que les features temporelles (heure et jour de semaine) avaient un effet minimal sur la durée du trajet.
Impact du nettoyage des données
- Suppression des enregistrements avec des valeurs négatives ou irréalistes
- Réduction du bruit et amélioration de la fiabilité du modèle
- Le dataset final (~2,78 millions d'enregistrements) était plus représentatif
- A entraîné une RMSE plus faible et un R² plus élevé sur tous les modèles, en particulier GBT
Conclusion
Ce tutoriel a montré comment PySpark et la Data Platform OVHcloud peuvent être utilisés efficacement pour traiter, explorer, et modéliser des données de trajets de taxi à grande échelle. Grâce à une préparation structurée des données, une analyse visuelle, et une évaluation des modèles, nous avons identifié les principaux facteurs de la durée des trajets et construit un modèle prédictif performant.
Parmi les modèles testés, Gradient Boosted Trees (GBT) a offert les meilleurs résultats en termes de précision et de robustesse, soulignant sa valeur pour des tâches de prévision en conditions réelles.
Le workflow décrit ici, couvrant l'ingestion, la transformation, l'exploration, et le machine learning, peut servir de cadre réutilisable pour des projets d'analytique à grande échelle similaires dans différents domaines.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.