
Actions du Data Processing Engine
Vingt-et-un types d'actions, un document JSON chacun.
Qu'est-ce qu'une action ?
Une action est une unité de travail dans le Data Processing Engine : lire depuis quelque part, faire quelque chose, écrire quelque part. Une vingtaine de types d'actions couvrent les cas courants, du chargement d'une source enregistrée dans une table du Lakehouse à l'exécution de Python ou de PySpark arbitraire.
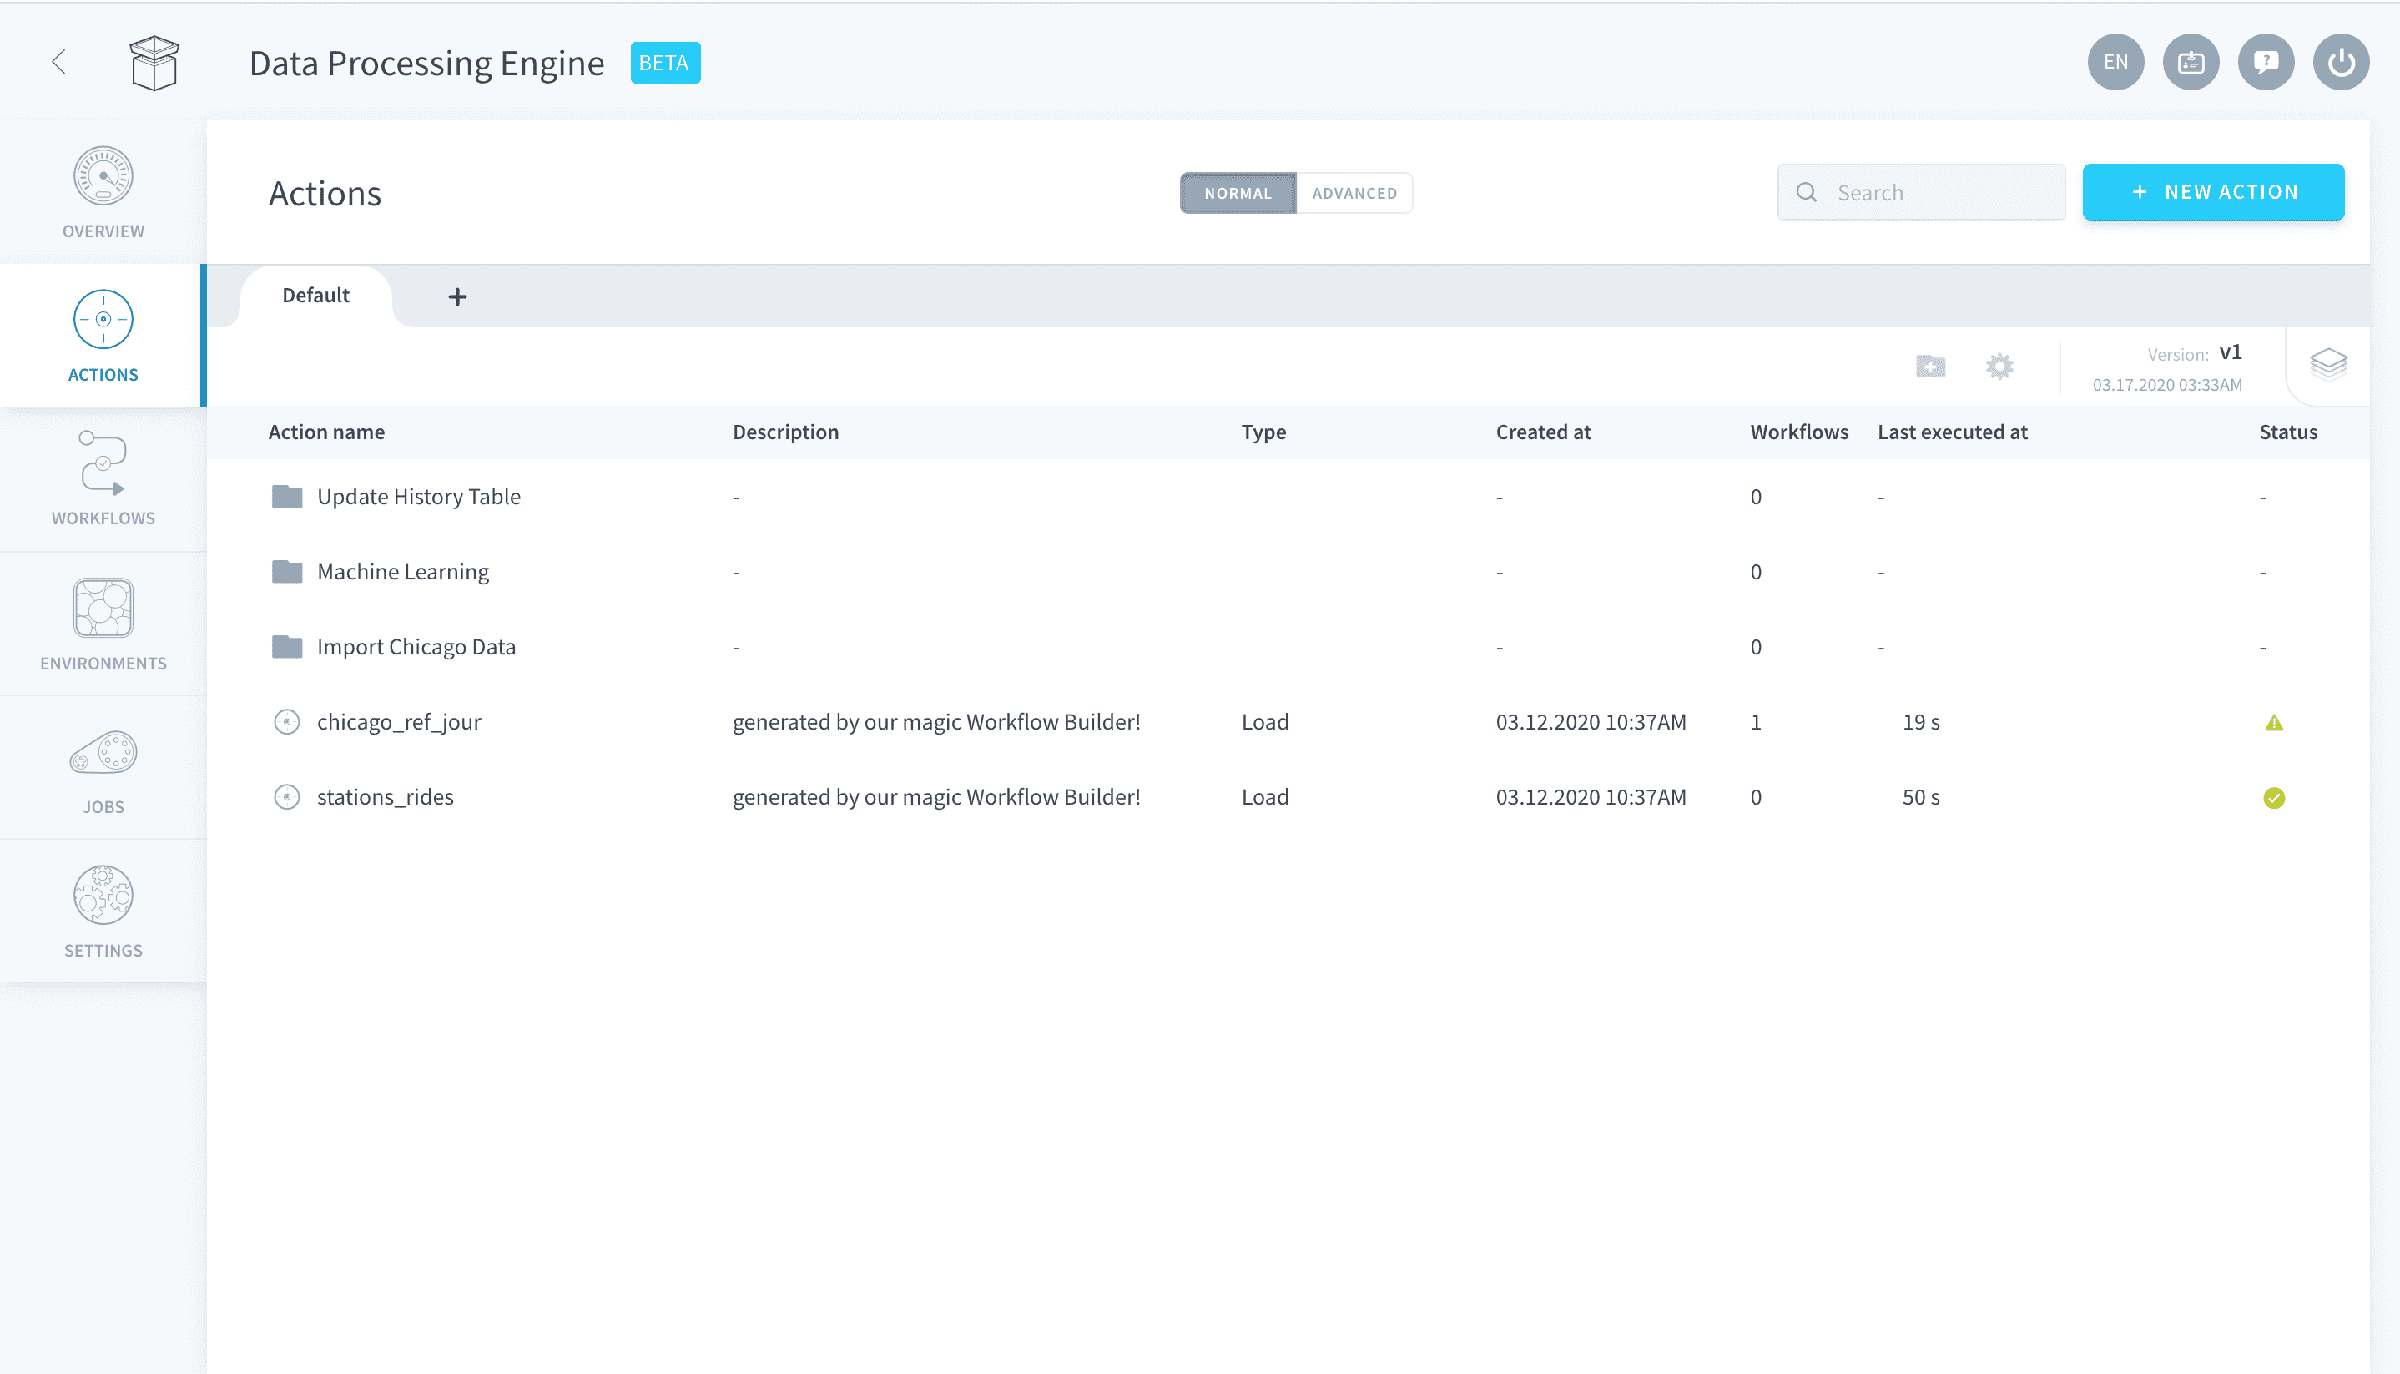
Elles se regroupent par ce qu'elles font. Loading fait entrer les données : Load, Load PySpark, Load to Bucket, File Transfer, CSV to PostgreSQL. Transformation remodèle les données déjà détenues dans le projet : Aggregate, Aggregate PySpark, SQL, Custom, Custom PySpark, Diff. Export renvoie les données vers l'extérieur : Export Table to Source, MySQL to Parquet, PostgreSQL to CSV, PostgreSQL to Parquet. Housekeeping maintient le projet en ordre : Delete, Delete Diff, Delete Bucket, Rebuild, Maintenance actions, Send OpenLineage Events.
Chaque action est configurée par un document JSON. L'éditeur graphique écrit ce document pour vous, et le mode avancé le modifie directement, c'est là que vivent les champs sans équivalent dans l'interface. Load, Aggregate et les Workflows documentent chacun leur JSON séparément.
Les actions sont conservées dans des dépôts, et c'est le dépôt qui est versionné, soit via le contrôle de version propre à la platform, soit en synchronisant le dépôt avec Git. Une action s'exécute toujours au sein d'un job, selon les préférences et les ressources définies sur l'action, sur son workflow, ou sur un environnement partagé.
La création d'une action, le versionnement d'un dépôt et sa synchronisation avec Git sont couverts ensemble dans Créer et gérer des actions.
Créer et gérer des actions→
Créer une action, versionner le dépôt, le synchroniser avec Git, et savoir ce qui déclenche une reconstruction.
Load→
Extraire, mapper et charger des données depuis une source vers une table du Lakehouse Manager.
Load PySpark→
Le même chargement, distribué avec PySpark pour les jeux de données volumineux.
Load to Bucket→
Charger des données brutes directement dans un bucket de stockage objet.
File Transfer→
Copier des fichiers entre des buckets, ou d'une source vers un bucket, en conservant la structure des chemins.
CSV to PostgreSQL→
Ingérer un fichier CSV depuis n'importe quelle source vers une table PostgreSQL existante.
Aggregate→
Lire une table, appliquer des transformations, écrire le résultat dans une autre table.
Aggregate PySpark→
Agrégation distribuée entre des tables du Lakehouse Manager.
SQL→
Exécuter du SQL sur des datasets et des tables sur Trino, y compris du DML et du DDL.
Custom→
Exécuter votre propre code Python pour de la logique ETL ou de validation.
Custom PySpark→
Exécuter votre propre code PySpark sur un cluster Spark.
Diff→
Construire un journal des modifications entre des datasets au fil du temps.
Export Table to Source→
Repousser des tables vers une source externe compatible.
MySQL to Parquet→
Transférer une table MySQL vers un bucket au format Parquet.
PostgreSQL to CSV→
Transférer une table PostgreSQL vers un bucket au format CSV.
PostgreSQL to Parquet→
Extraire depuis PostgreSQL et stocker le résultat au format Parquet.
Delete→
Supprimer entièrement un objet, comme une table.
Delete Diff→
Supprimer les lignes qui n'existent plus dans une comparaison différentielle.
Delete Bucket→
Retirer des fichiers, des dossiers ou l'ensemble du contenu d'un bucket.
Rebuild→
Reconstruire une table pour modifier les contraintes, repartitionner et nettoyer les métadonnées.
Maintenance actions→
Actualiser les métadonnées du projet et vider les caches des composants.
Send OpenLineage Events→
Transmettre des événements de lignage vers un backend OpenLineage externe.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.