
AI Deploy - Tutoriel - Déployer une app de segmentation de tumeurs
Comment créer et déployer une application permettant de segmenter des tumeurs cérébrales présentes dans des images IRM
AI Deploy est couvert par les Conditions particulières OVHcloud Public Cloud.
Objectif
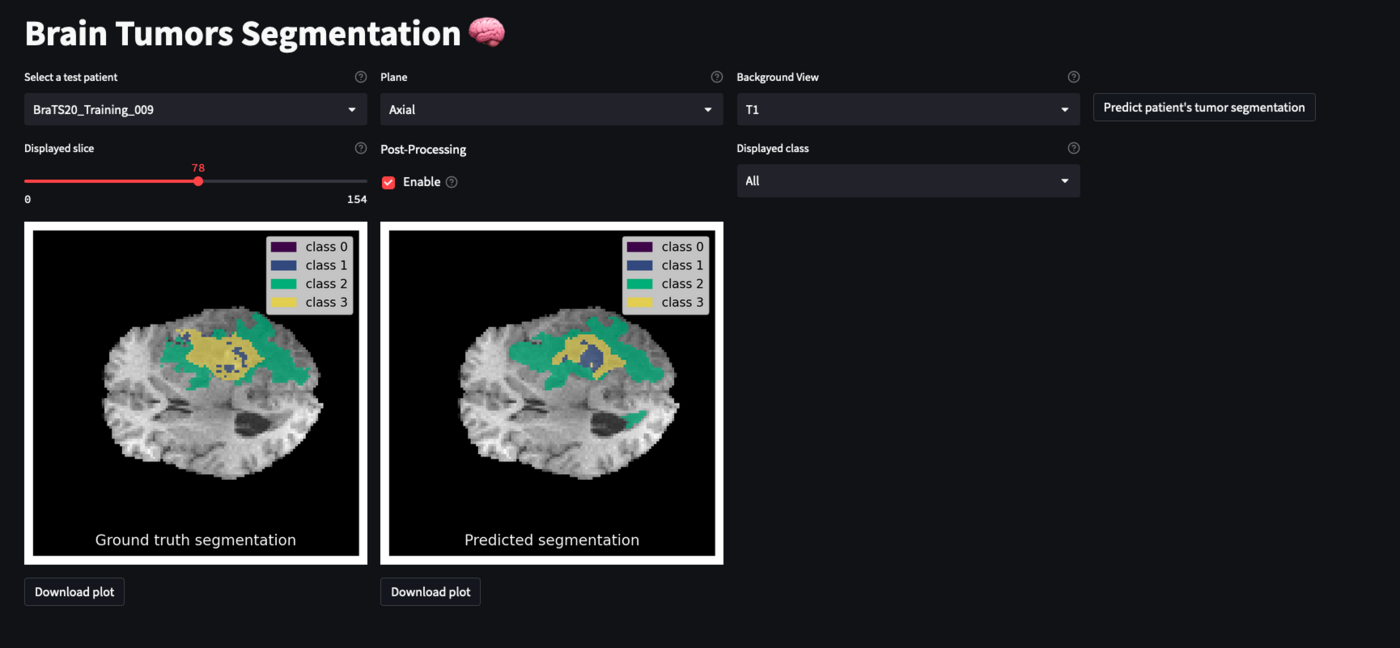
L’objectif de ce tutoriel est de montrer comment déployer une application de segmentation d’images, qui permet d’utiliser le modèle U-Net que nous avons entraîné dans ce notebook. Cela nous permettra de visualiser et de segmenter des tumeurs cérébrales.
Pour cela, nous utiliserons Streamlit, un framework Python qui transforme des scripts en application web partageable. Vous apprendrez également à construire et à utiliser une image Docker personnalisée pour une application Streamlit.
Pour plus d’informations sur l’entraînement de U-Net sur le dataset BraTS2020, reportez-vous à la documentation suivante.
Aperçu de notre application de segmentation d’images :
Prérequis
Pour déployer votre app, vous avez besoin de :
- Un projet AI Deploy créé au sein d’un projet Public Cloud de votre compte OVHcloud
- Un utilisateur pour AI Deploy
- L’AI CLI OVHcloud installée sur votre ordinateur local
- Docker installé sur votre ordinateur local, ou un accès à une instance Docker Debian, disponible sur le .
- Quelques connaissances sur la construction d’images et les Dockerfile
- Le dataset BraTS2020. Téléchargez-le ici
- Vos poids obtenus en entraînant le modèle U-Net sur ce dataset (reportez-vous à la partie « Étape 6 - Entraîner et sauvegarder le modèle » du tutoriel de notebook de segmentation d’images).
- Le code complet de l’application, disponible sur ce dépôt GitHub, que je vous invite à cloner.
Accès à l'espace client OVHcloud
- Lien direct :
- Pour accéder à vos services :
Public Cloud> Sélectionnez votre projet >Object Storage
En pratique
Nous allons suivre différentes étapes pour déployer notre application de segmentation de tumeurs cérébrales :
- Écrire le requirements.txt qui contient les bibliothèques nécessaires devant être installées pour que notre application fonctionne.
- Écrire le
Dockerfilequi contient toutes les commandes pour lancer notre app de segmentation d’images. - Envoyer le dataset et les poids du modèle vers un Object Storage (volume) afin de pouvoir utiliser ces données au sein de l’environnement de l’app.
- Construire l’image Docker à partir du Dockerfile.
- Envoyer l’image vers un registre.
- Déployer votre app.
Si vous avez cloné le dépôt de l’application, vous n’aurez pas besoin de réécrire les fichiers (requirements.txt et Dockerfile) puisque vous les possédez déjà. Dans ce cas, vous pouvez passer directement à l’étape « Construire l’image Docker », même s’il est préférable de comprendre le processus global.
Écrire le fichier requirements.txt de l’application
Le fichier requirements.txt nous permettra d’indiquer tous les modules nécessaires au fonctionnement de notre application. Ce fichier sera utile pour le Dockerfile.
Placez ce fichier (ainsi que les suivants) dans le même répertoire que vos scripts Python.
Écrire le Dockerfile de l’application
Un Dockerfile est un document texte qui contient toutes les commandes qu’un utilisateur pourrait appeler en ligne de commande pour construire une image.
Ce fichier doit commencer par l’instruction FROM, indiquant l’image parente à utiliser. Dans notre cas, nous choisissons de partir de l’image officielle tensorflow/tensorflow :
Ensuite, définissez le répertoire de travail et ajoutez-y tous vos fichiers (scripts Python, requirements.txt et le Dockerfile) grâce aux commandes suivantes :
Avec AI Deploy, workspace sera votre répertoire de travail.
Indiquons maintenant que nous devons installer le fichier requirements.txt, qui contient les modules Python nécessaires, à l’aide d’une commande pip install ... :
Une fois notre environnement configuré, nous devons définir notre commande de lancement par défaut pour démarrer l’application :
Enfin, donnez les bons droits d’accès à l’utilisateur OVHcloud (42420:42420) :
Envoyer le dataset et les poids du modèle vers un Object Storage
Afin d’utiliser notre modèle entraîné sur les images du dataset, nous devons créer deux conteneurs d’objets, l’un pour les poids du modèle, l’autre pour le dataset BraTS2020. Nous pouvons soit :
- envoyer le dataset sous forme de fichier
.zip(4 Go), qui sera décompressé par le code Python de l’app au démarrage de l’application Streamlit. - envoyer l’intégralité du dataset. Bien que beaucoup plus lourd à envoyer (40 Go), cela ne nécessitera pas d’étape de décompression.
Dans ce tutoriel, nous utiliserons le format .zip.
Si les poids de votre modèle et/ou votre .zip se trouvent dans un dossier, veillez à n’ajouter que les fichiers, et non leurs dossiers. Sinon, le chemin de ces ressources ne sera plus directement rattaché à la racine /workspace. Le nom du dossier doit être précisé avant le nom du fichier, ce qui implique d’adapter le code de l’application, en particulier les endroits où les chemins des ressources sont mentionnés (variables.py et la fonction dataset_unzip() de utils.py).
Vous pouvez envoyer vos données vers le cloud soit en utilisant l’, soit avec l’AI CLI OVHcloud.
Envoyer les données depuis l’interface (espace client)
Si vous n’êtes pas à l’aise avec les commandes, cette méthode sera plus intuitive.
Cliquez sur pour accéder à votre projet Public Cloud, puis sélectionnez la section Object Storage (dans la catégorie Storage) et créez un nouveau conteneur d’objets en cliquant sur Stockage > Object Storage > Créer un conteneur d'objets.
Vous pouvez ici créer le conteneur d’objets qui stockera le dataset et les poids du modèle. Plusieurs types et régions sont disponibles, choisissez les paramètres qui vous conviennent le mieux.
Nous vous conseillons de séparer vos données en créant un conteneur dédié aux poids du modèle et un second conteneur pour le dataset.
Nous nommerons nos conteneurs d’objets BraTS2020_dataset_zip et BraTS2020_model_weights.
Une fois vos conteneurs d’objets créés, vous les verrez dans la liste Object Storage. En cliquant dessus, vous pourrez cliquer sur le bouton Ajouter des objets, qui vous permettra d’envoyer vos données vers le cloud.
1.2 - Envoyer les données via la CLI
Pour suivre cette partie, assurez-vous d’avoir installé la CLI ovhai sur votre ordinateur ou sur une instance.
Comme dans l’espace client, vous devrez préciser la région, le nom de votre conteneur et le chemin où vos données seront situées. La création d’un conteneur d’objets peut se faire avec la commande suivante :
Voici les commandes que nous allons saisir :
- Envoyer le dataset (
.zip) :
- Envoyer les poids du modèle :
Veillez à envoyer les 2 fichiers obtenus lors de l’entraînement de votre modèle.
Les noms des fichiers de poids peuvent varier selon votre cas. Assurez-vous que la variable best_weights_path (du fichier variables.py) indique le chemin des poids de votre modèle. Modifiez-la si nécessaire.
Une fois vos données envoyées, elles sont accessibles depuis tous les outils AI d’OVHcloud, avec des permissions en lecture seule (RO) ou en lecture-écriture (RW).
Avant de continuer, assurez-vous de modifier la liste samples_test dans le fichier variables.py.
En effet, cette liste doit contenir les patients de l’ensemble de test, qui n’ont pas été utilisés pour l’entraînement du modèle. Cette liste ne sera pas la même pour vous, les patients ayant été mélangés aléatoirement. Il est donc important de la remplacer par votre propre liste d’échantillons de test !
Construire l’image Docker depuis le Dockerfile
Depuis le répertoire contenant votre Dockerfile, exécutez l’une des commandes suivantes pour construire l’image de votre application :
-
La première commande construit l’image en utilisant l’architecture par défaut de votre système. Cela peut fonctionner si votre machine utilise déjà l’architecture
linux/amd64, requise pour exécuter des containers avec nos produits AI. Cependant, sur des systèmes ayant une architecture différente (par exempleARM64surApple Silicon), l’image obtenue ne sera pas compatible et ne pourra pas être déployée. -
La seconde commande cible explicitement l’architecture
linux/amd64afin de garantir la compatibilité avec nos services AI. Elle nécessitebuildx, qui n’est pas installé par défaut. Si vous n’avez jamais utilisébuildx, vous pouvez l’installer en exécutant :docker buildx install
L’argument point . indique que votre contexte de build (emplacement du Dockerfile et des autres fichiers nécessaires) est le répertoire courant.
L’argument -t vous permet de choisir l’identifiant à donner à votre image. En général, les identifiants d’image se composent d’un nom et d’un tag de version <name>:<version>. Pour cet exemple, nous avons choisi tumor_seg_streamlit_app:latest.
Tester en local (optionnel)
Lancez la commande Docker suivante pour exécuter l’application en local sur votre ordinateur :
Notes
-
L’argument
-p 8501:8501indique que vous souhaitez effectuer une redirection de port depuis le port 8501 de votre machine locale vers le port 8501 du container Docker. Le port 8501 est le port par défaut utilisé par les applications Streamlit. -
N’oubliez pas l’argument
--user=42420:42420si vous souhaitez simuler exactement le même comportement que celui qui se produira sur les apps AI Deploy. Il exécute le container Docker en tant qu’utilisateur OVHcloud spécifique (utilisateur 42420:42420).
Une fois démarrée, votre application devrait être disponible sur http://localhost:8501.
Envoyer l’image vers le registre partagé
Avertissement Le registre partagé doit être utilisé uniquement à des fins de test. Nous vous recommandons de créer et de rattacher votre propre registre. Plus d’informations à ce sujet sont disponibles ici. Les images envoyées vers ce registre sont réservées aux workloads AI Tools et ne seront pas accessibles pour des usages externes.
Trouvez l’adresse de votre registre partagé en lançant cette commande :
Connectez-vous à votre registre partagé avec vos identifiants habituels d’utilisateur AI Platform :
Taguez l’image compilée et envoyez-la vers votre registre partagé :
Lancer l’app AI Deploy
La commande suivante démarre une nouvelle app exécutant votre application Streamlit :
Notes
-
--default-http-port 8501indique que le port à joindre sur l’URL de l’app est8501. -
--gpu 1indique que nous demandons 1 GPU pour cette app. -
--volumenous permet de préciser le volume que nous souhaitons ajouter à notre job. Comme mentionné, nous ajoutons les volumes du dataset et des poids BraTS2020, que nous plaçons en modeRO:cache. RO signifie lecture seule (Read-Only), ce qui signifie que nous pourrons uniquement lire les données de ces volumes, sans pouvoir les modifier. Puisque tous nos volumes sont en mode RO, il est judicieux de mettre nos données en cache, ce qui permettra une initialisation plus rapide des apps connectées à ces mêmes volumes. -
Pensez à ajouter l’attribut
--unsecure-httpsi vous souhaitez que votre application soit accessible sans aucune authentification.
Aller plus loin
- Vous souhaitez utiliser Streamlit pour créer une app de classification audio ? Découvrez comment faire.
- Découvrez comment créer et déployer une app de reconnaissance vocale ici.
Pour une formation ou une assistance technique sur la mise en œuvre de nos solutions, contactez votre commercial ou consultez la page Professional Services pour obtenir un devis et faire analyser votre projet par nos experts.
Votre avis nous intéresse !
N’hésitez pas à nous faire part de vos questions, retours et suggestions pour améliorer le service :
- Sur le serveur Discord OVHcloud