
Supprimer les lignes en double avec l'action Deduplicate
L'action Deduplicate supprime les lignes en double d'une table, sur place, en conservant exactement une ligne par clé de déduplication
Objectif
L'action Deduplicate supprime les lignes en double d'une table, sur place, en conservant exactement une ligne par clé de déduplication. Le cas d'usage typique est une table qui a été chargée en mode append alors qu'un upsert était prévu : dédupliquer sur les champs identifiants de la table produit exactement la table qu'un upsert aurait produite. Comme toute autre action, elle peut être exécutée à la demande, planifiée avec un déclencheur cron, ou orchestrée au sein d'un workflow.
L'action fonctionne sur les tables stockées dans les datasets lakehouse (Iceberg) et PostgreSQL.
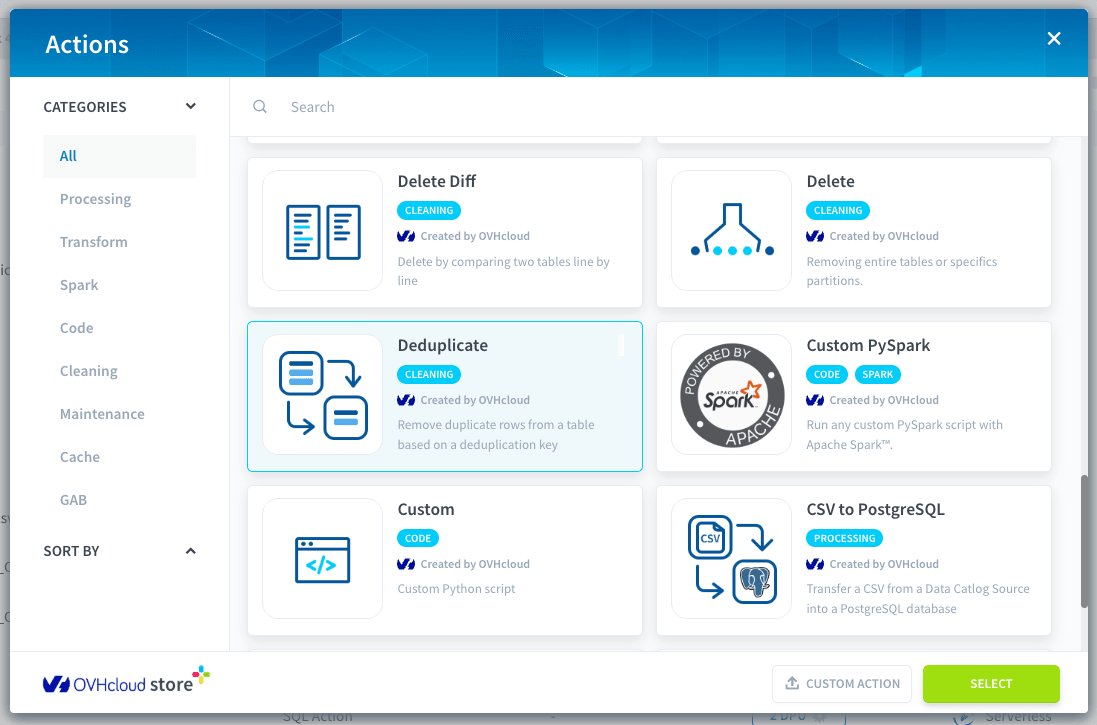
Deduplicate modifie la table cible elle-même. Sur les tables lakehouse, l'état précédent reste disponible sous forme de snapshot, une exécution peut donc être annulée avec le time travel. Sur les tables PostgreSQL, la suppression est définitive : activez l'option de sauvegarde avant de dédupliquer toute donnée que vous n'êtes pas prêt à perdre.
Configurer une action Deduplicate
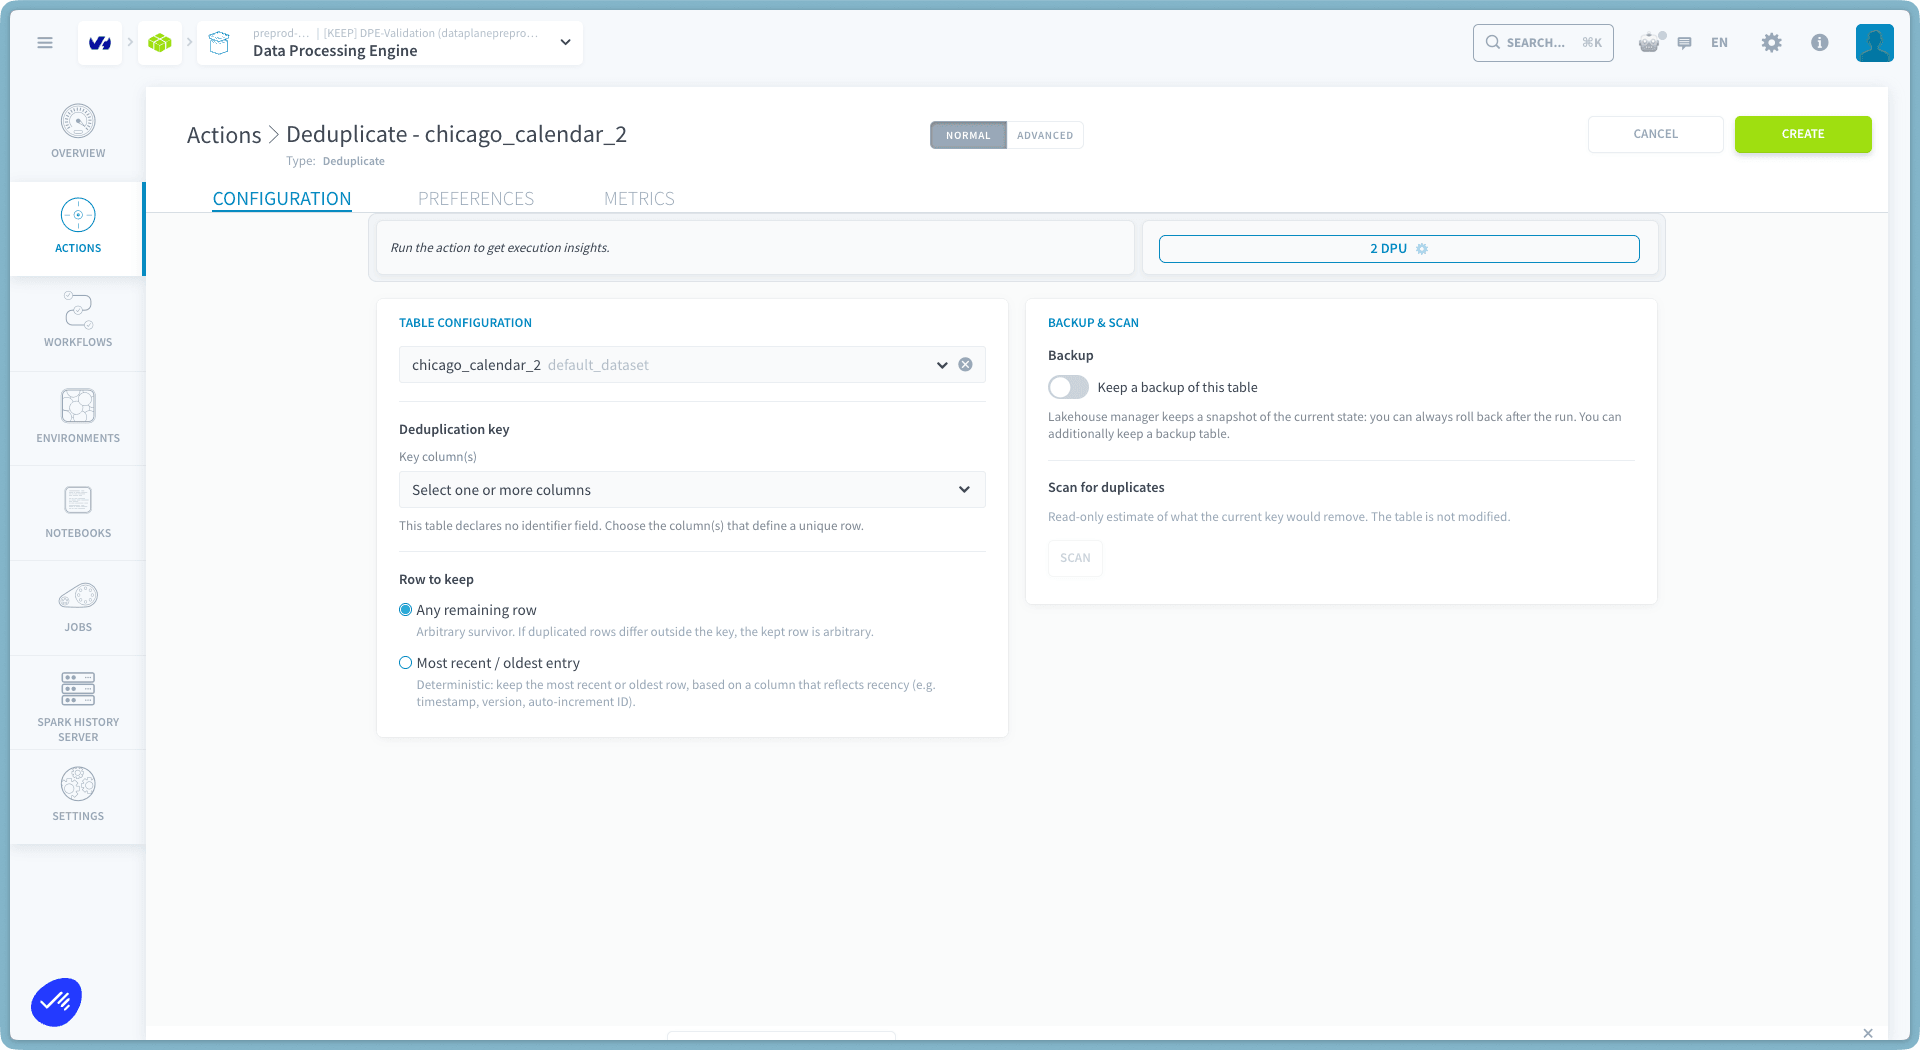
L'écran de configuration comporte deux panneaux : Table configuration à gauche, où vous choisissez la table, la clé de déduplication et la ligne à conserver, et Backup & scan à droite, où vous protégez l'exécution et prévisualisez son effet avant de créer l'action.
Choisir la table
Sélectionnez la table cible dans le sélecteur de table. Chaque entrée affiche le nom de la table ainsi que le dataset auquel elle appartient. Le nom de l'action est prérempli à partir de la table sélectionnée, par exemple Deduplicate - orders.
Choisir la clé de déduplication
La clé de déduplication est l'ensemble des colonnes qui définit une ligne unique : après l'exécution, la table contient exactement une ligne par combinaison distincte de ces colonnes.
Lorsque la table déclare des champs identifiants, ceux-ci s'affichent au-dessus du sélecteur de clé et la clé en est préremplie. Il s'agit de la clé recommandée : elle déduplique la table exactement comme l'aurait fait un chargement upsert à l'ingestion.
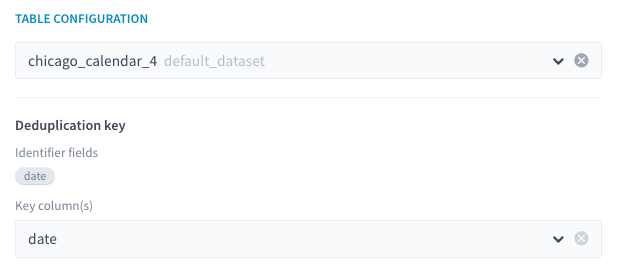
Vous pouvez à la place sélectionner tout autre ensemble de colonnes existantes. Si votre sélection diffère des champs identifiants déclarés de la table, un avertissement vous rappelle que des lignes qui ne sont pas des doublons selon la propre définition de la table pourraient être supprimées. Si la table ne déclare aucun champ identifiant, choisissez la ou les colonnes qui définissent une ligne unique pour vos données.
Les lignes dont les colonnes de clé sont vides sont regroupées ensemble, selon la sémantique SQL standard GROUP BY : deux lignes avec NULL dans la même colonne de clé sont considérées comme des doublons l'une de l'autre.
Choisir la ligne à conserver
Lorsque plusieurs lignes partagent la même clé, le paramètre Row to keep décide laquelle est conservée :
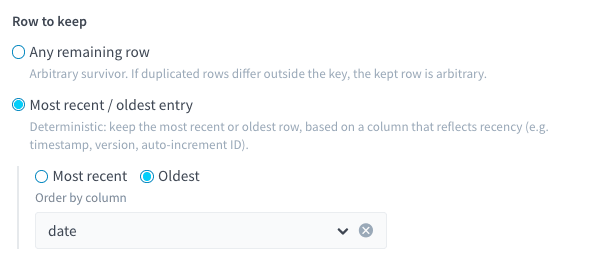
- Any remaining row (par défaut) : la ligne conservée est arbitraire. C'est le bon choix lorsque les lignes en double sont des copies identiques. Si les lignes en double diffèrent en dehors de la clé, la ligne conservée est arbitraire.
- Most recent / oldest entry : déterministe. Choisissez Most recent ou Oldest, puis sélectionnez la colonne Order by column : une colonne de date, d'horodatage ou numérique qui reflète la récence, comme un horodatage de mise à jour, un numéro de version ou un identifiant à incrémentation automatique. Les lignes dont la colonne de tri est vide sont classées en dernier : une ligne avec une valeur l'emporte toujours sur une ligne sans valeur.
Conserver une sauvegarde
Activez Keep a backup of this table pour créer une copie complète de la table avant que quoi que ce soit ne soit supprimé. La copie est nommée <table>_backup_<id> et enregistrée dans le Lakehouse Manager comme n'importe quelle autre table.
La sauvegarde n'est créée que lorsque l'exécution a effectivement des doublons à supprimer, et son nombre de lignes est vérifié avant que la table cible ne soit modifiée : si la sauvegarde ne peut être créée ou vérifiée, l'exécution s'arrête et la table reste intacte. La table de sauvegarde n'est jamais supprimée automatiquement, même en cas d'échec d'une exécution ; supprimez-la vous-même une fois que vous n'en avez plus besoin.
Sur les tables lakehouse, un snapshot de l'état actuel est conservé dans tous les cas, la sauvegarde constitue donc une sécurité supplémentaire. Sur les tables PostgreSQL, la sauvegarde est le seul moyen de récupérer les lignes supprimées.
Scanner les doublons
Avant de créer l'action, cliquez sur Scan pour obtenir une estimation en lecture seule de ce que la configuration actuelle supprimerait. Le scan ne modifie jamais la table. Il nécessite une table sélectionnée et au moins une colonne de clé.
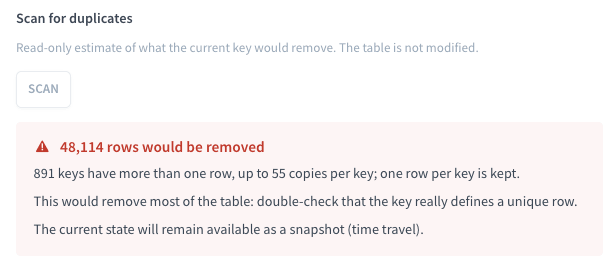
La carte de résultat affiche :
- le nombre de lignes qui seraient supprimées, et la règle de survie qui s'appliquerait ;
- le nombre de clés ayant plus d'une ligne, et le pire nombre de copies par clé ;
- si l'état précédent restera disponible (snapshot lakehouse) ou si la suppression est définitive (PostgreSQL).
Si le scan ne trouve aucun doublon pour la clé, la carte confirme qu'il n'y a rien à supprimer. Si plus de la moitié de la table serait supprimée, un avertissement supplémentaire vous invite à vérifier que la clé définit réellement une ligne unique : supprimer la majeure partie d'une table signifie généralement que la clé est incorrecte, par exemple une seule colonne de date sur une table comportant de nombreuses lignes par jour.
Le résultat du scan est abandonné dès que vous changez la table, la clé ou la règle de survie : relancez-le pour obtenir une nouvelle estimation. Les mêmes statistiques sont recalculées au début de chaque exécution, de sorte que l'exécution confirme ce que le scan avait prévisualisé.
Déroulement de la déduplication
Le mécanisme dépend du moteur du dataset qui contient la table :
Chaque exécution commence par un scan de la table. Lorsque le scan ne trouve aucun doublon pour la clé, l'exécution se termine immédiatement et la table n'est pas touchée.
L'action supprime uniquement des lignes : elle ne modifie jamais le schéma, le partitionnement ou les champs identifiants de la table.
Sur les tables lakehouse, une table transitoire <table>_dedup_tmp peut apparaître dans le dataset pendant l'exécution de l'action. Elle est supprimée automatiquement à la fin de l'exécution, et un reliquat laissé par un échec critique est nettoyé au début de l'exécution suivante.
N'écrivez pas dans la table cible pendant l'exécution de l'action : les écritures concurrentes ne sont pas prises en charge. Sur les tables lakehouse, le commit en conflit échoue et le rollback automatique restaure l'état d'avant exécution.
Vérifier le résultat d'une exécution
Chaque exécution écrit un résumé dans les logs d'exécution de l'action : le nombre de lignes avant et après, le nombre de lignes supprimées, le nombre de clés ayant des doublons, la clé utilisée, et comment annuler l'exécution. Lorsque l'option de sauvegarde est activée, le résumé nomme également la table de sauvegarde. Par exemple :
Annuler une déduplication
- Tables lakehouse : l'id du snapshot d'avant exécution est affiché dans les logs de l'exécution. Restaurez la table à ce snapshot avec le time travel, dans la période de rétention des snapshots (14 jours par défaut).
- Tables PostgreSQL : il n'existe pas de snapshots, la suppression elle-même ne peut donc pas être annulée. Si l'exécution a été créée avec l'option de sauvegarde, la copie
<table>_backup_<id>contient le contenu exact de la table avant exécution.
Exemples
Sélectionnez un onglet ci-dessous pour voir une configuration type, présentée sous forme de JSON tel que vous le verriez en mode avancé :
Un chargement s'est exécuté deux fois en mode append, si bien que chaque ligne d'orders existe deux fois. Les lignes sont des copies identiques, donc n'importe quelle ligne survivante convient. Dédupliquer sur le champ identifiant de la table order_id produit la table que l'upsert aurait produite :
Utiliser le mode avancé
Si vous devez accéder au fichier de configuration JSON de l'action, activez le mode Advanced en cliquant sur Advanced en haut de la page.
L'action accepte les paramètres suivants :
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.