
Action Load PySpark
Il s'agit généralement de la première étape de tout système de traitement de données, nécessaire avant d'exécuter tout autre processus sur les données provenant des sources connectées
Objectif
L'action Load PySpark extrait des données brutes depuis des sources et les insère dans des tables primaires de votre entrepôt de données à l'aide d'Apache Spark™. Il s'agit généralement de la première étape de tout système de traitement de données, nécessaire avant d'exécuter tout autre processus sur les données provenant des sources connectées.
Autrement dit, si vous avez configuré un connecteur via les Connectors, le Projet dispose des informations pour se connecter à la source ainsi que de ses métadonnées, mais ne contiendra pas les données réelles tant qu'elles n'auront pas été chargées à l'aide de l'action Load PySpark.
L'action Load PySpark n'est compatible qu'avec les connecteurs de source suivants : MySQL, PostgreSQL, Snowflake, Trino, AWS S31, Microsoft Azure Blob Storage, Data Platform Buckets, File Upload, et S3.
Configurer une action Load PySpark
Pour créer une nouvelle action Load PySpark, accédez à l'onglet Actions du Data Processing Engine (DPE), cliquez sur New Action et sélectionnez l'action Load PySpark.
Choisir une source et une destination
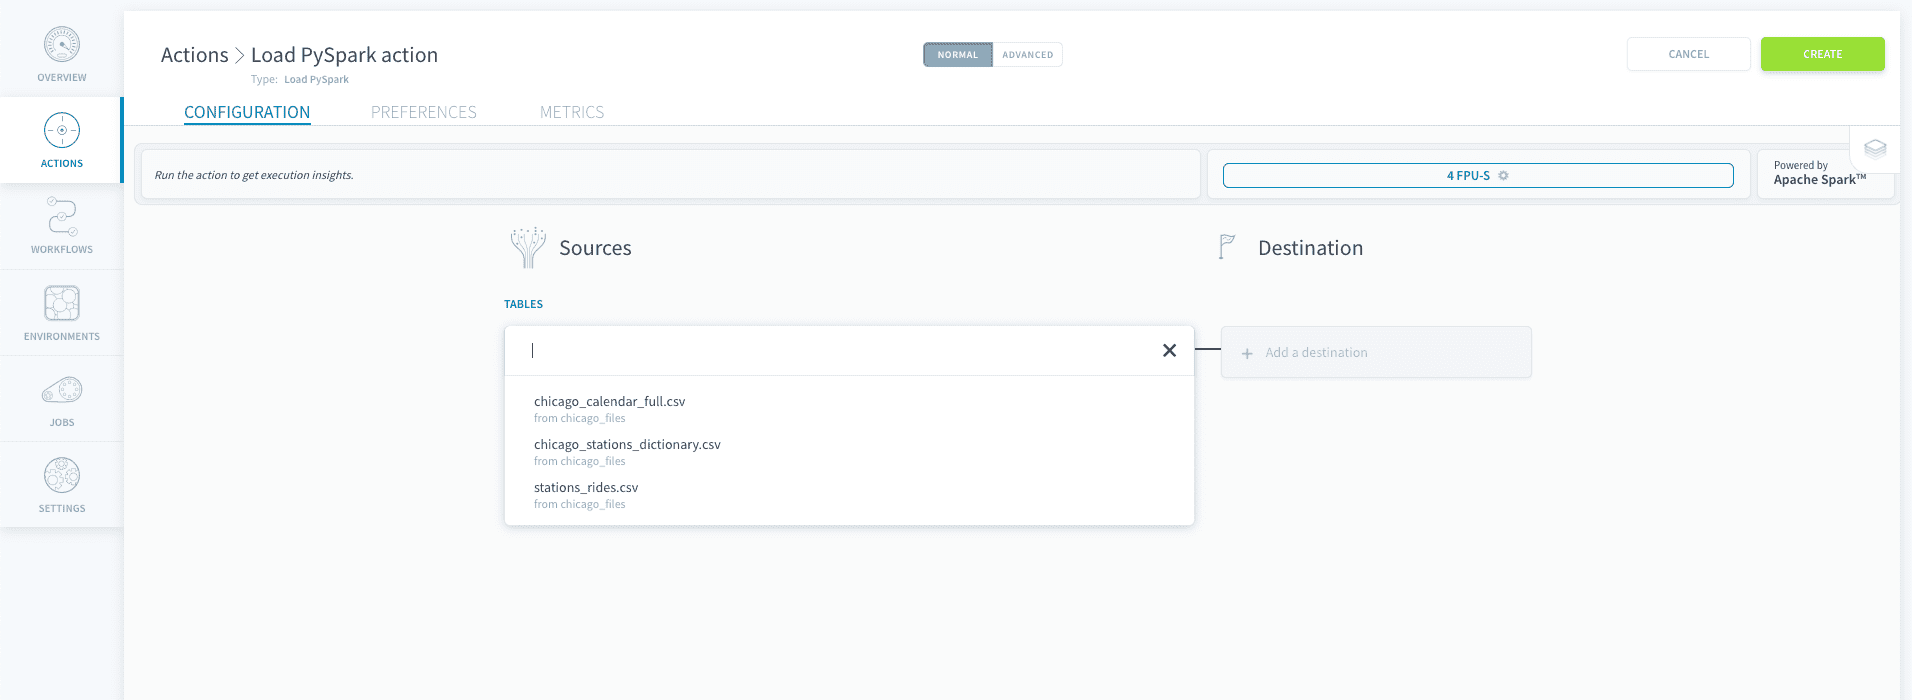
Pour configurer l'action Load PySpark, commencez par sélectionner une source dans la liste que vous avez déjà configurée dans l'onglet Sources des Connectors.
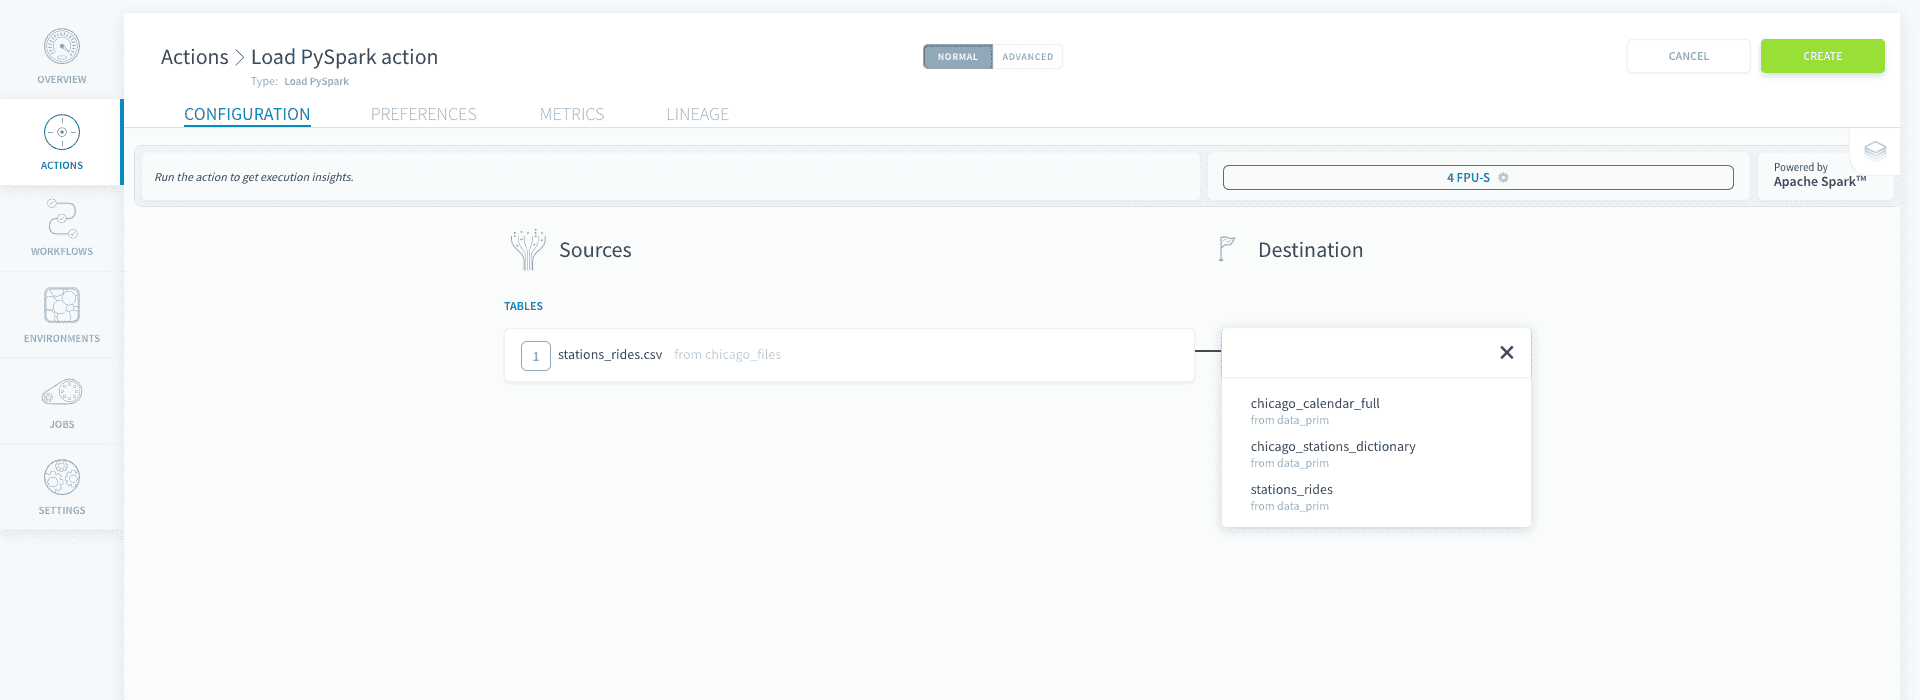
Ensuite, une table de destination vers laquelle envoyer vos données. Comme pour les sources, les tables doivent être configurées au préalable dans l'onglet Tables du Lakehouse Manager. Assurez-vous d'avoir construit votre modèle de données, sinon les tables ne seront pas accessibles par les autres composants de la platform.
Associer les attributs
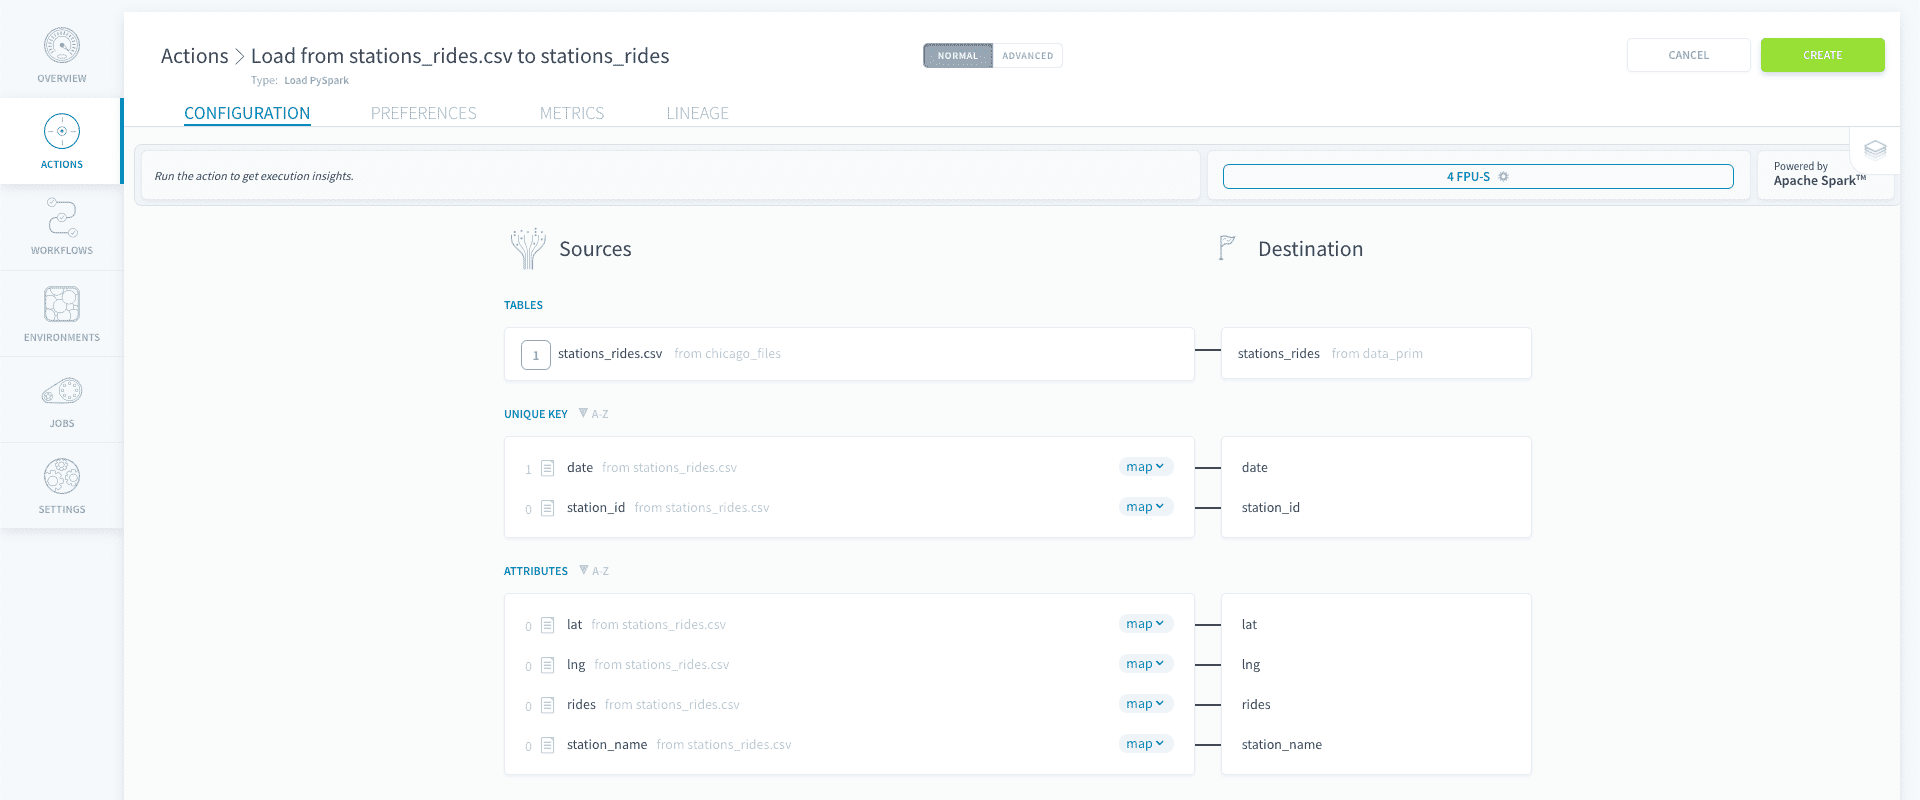
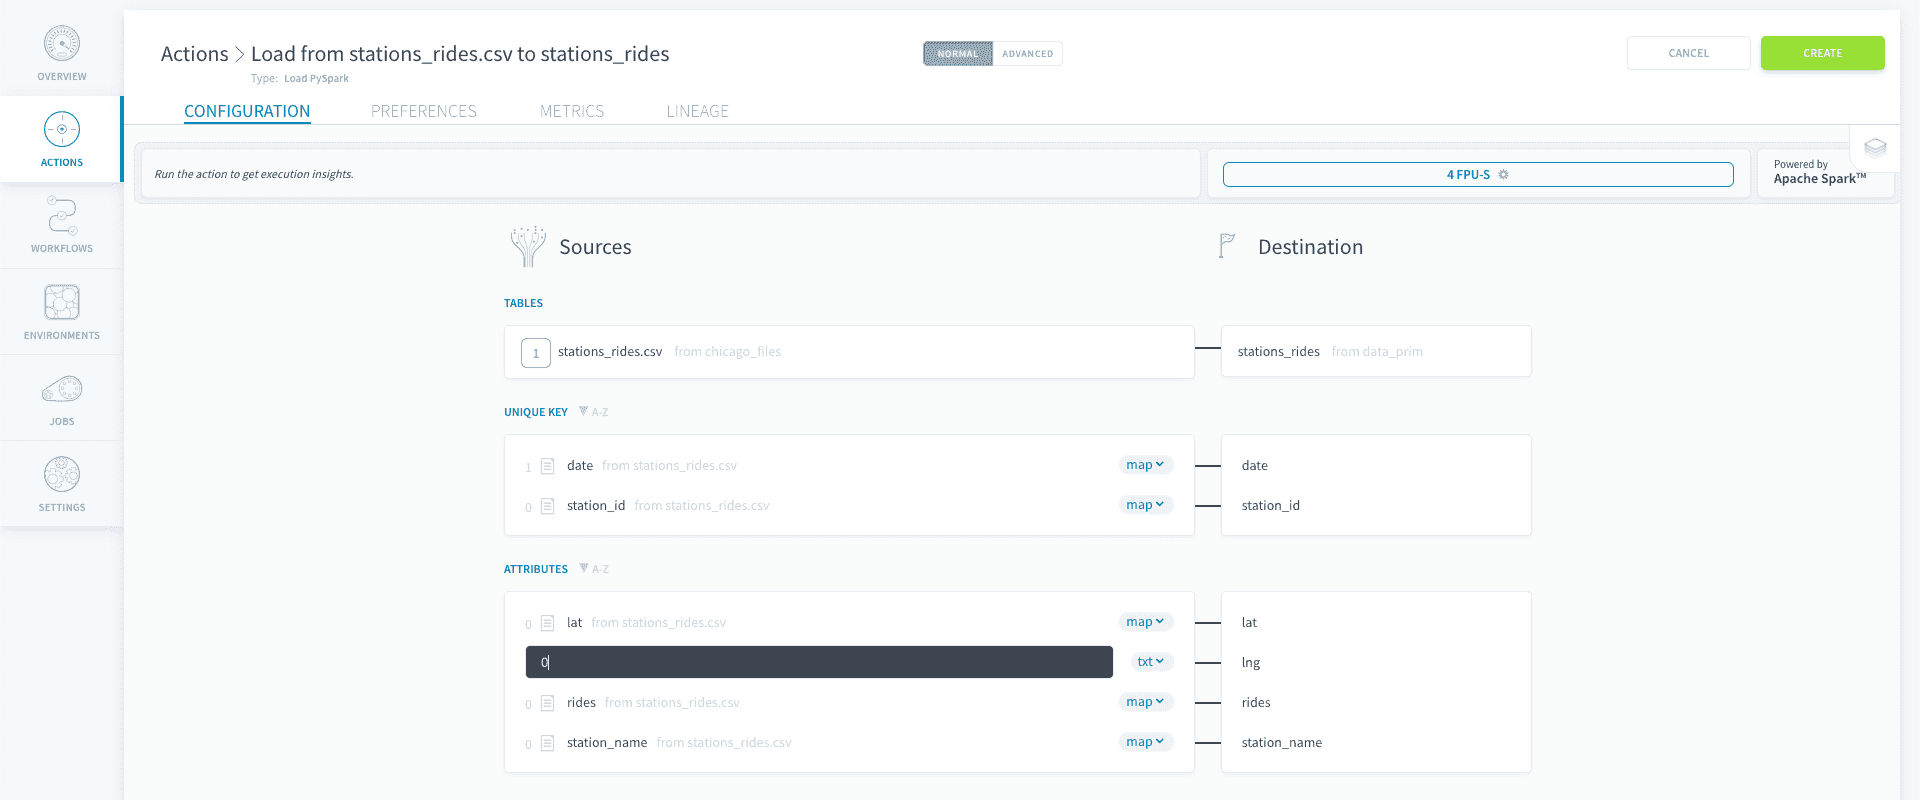
Une fois la source et la destination sélectionnées, le système associera automatiquement les attributs de destination de votre table de destination avec les différentes colonnes qu'il a identifiées dans la source de données brutes.
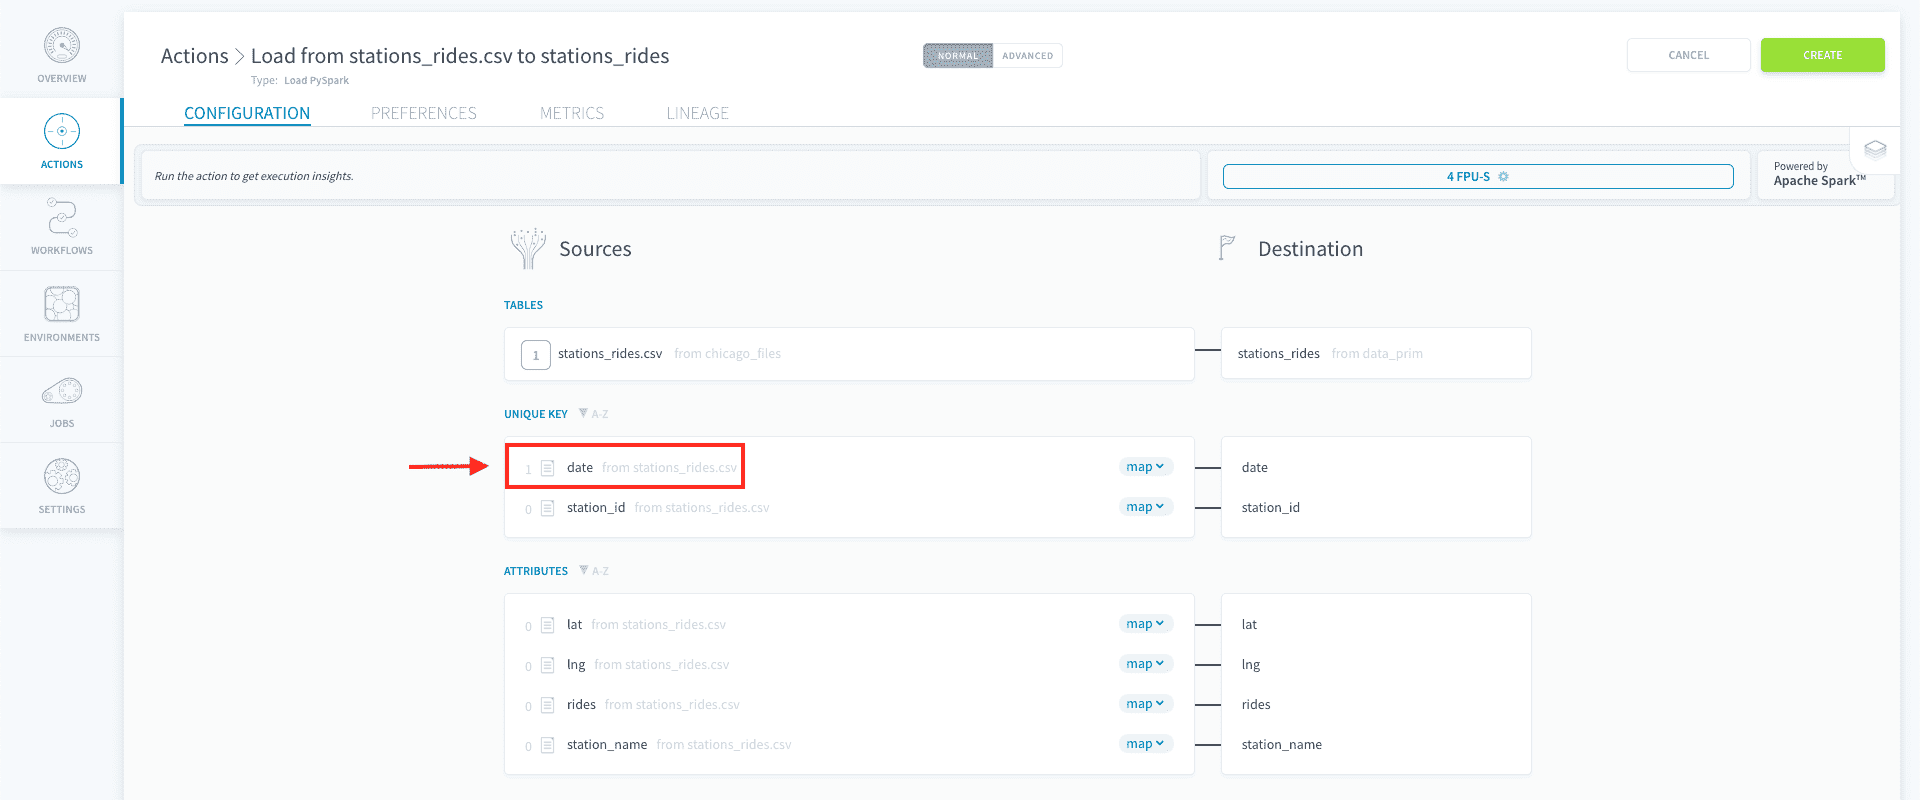
Sur l'image ci-dessous, vous pouvez voir que l'attribut date affiche une valeur de « 1 » à côté de l'icône de bloc-notes. Cela indique le nombre de règles de validation des données, aussi appelées blueprint rules, définies dans les Connectors, qui seront automatiquement appliquées lors du chargement des données. Les blueprint rules permettent aux utilisateurs de filtrer rapidement les données invalides comme les valeurs nulles ou les cellules vides, ou de reformater des valeurs telles que les dates ou les devises.
Notez que vous pourriez vouloir insérer du texte brut directement dans votre table de destination. Cela peut être utile par exemple lorsque vous souhaitez compter le nombre de points de données ou marquer une certaine source avec un label qui sera utilisé plus tard dans une table d'agrégation. Pour ce faire, sélectionnez < txt >, ce qui définira l'attribut source comme un champ de saisie de texte brut.
Configurer les préférences de l'action
Une fois satisfait de l'association de vos attributs, accédez à l'onglet préférences pour configurer les paramètres de l'action.
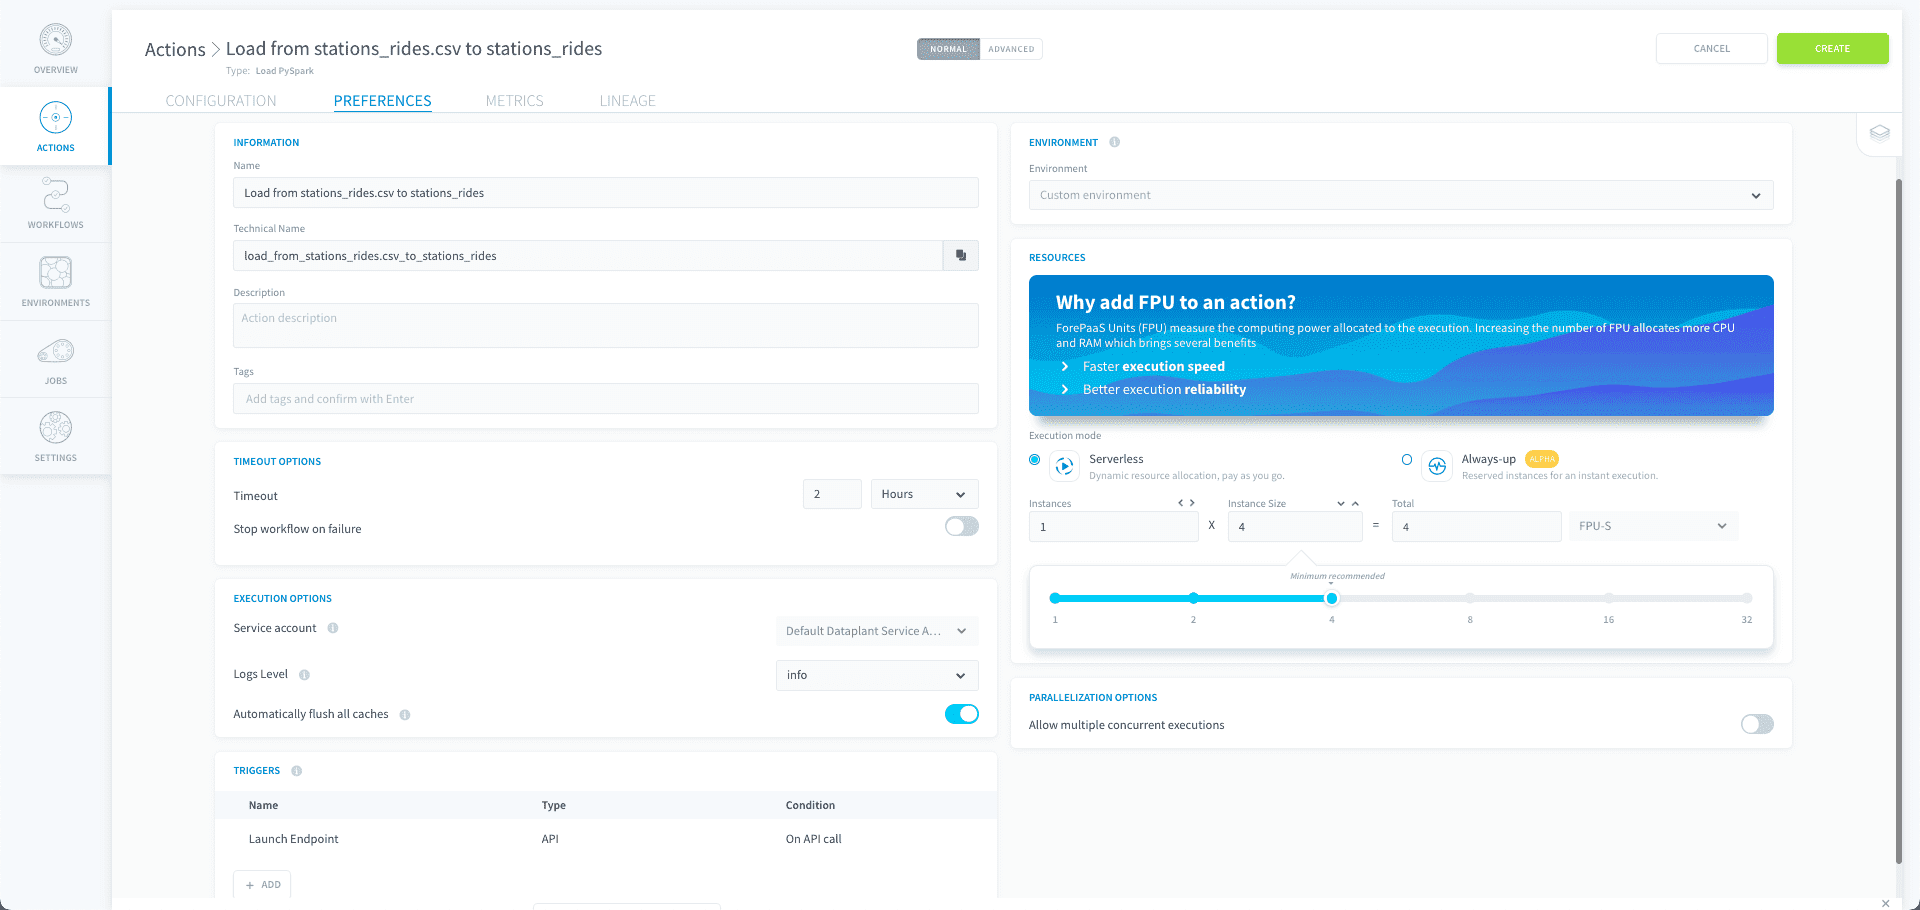
Lorsque vous avez terminé de modifier votre action, cliquez sur Create pour valider l'action.
Mode avancé
Si vous devez accéder au fichier de configuration JSON de l'action, vous pouvez activer le mode Advanced en cliquant sur Advanced en haut de la page.
Utiliser le mode avancé d'une action Load
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.
1 : S3 est une marque déposée appartenant à Amazon Technologies, Inc. Les services de OVHcloud ne sont pas sponsorisés, approuvés, ou affiliés de quelque manière que ce soit.