
Découvrir la segmentation sur un ensemble de fichiers
Pour des sources ayant la même structure dans un dossier source distant, ce mode de segmentation permet au Data Processing Engine (DPE) de trouver automatiquement tous
Objectif
Pour des sources ayant la même structure dans un dossier source distant, ce mode de segmentation permet au Data Processing Engine (DPE) de trouver automatiquement tous les fichiers d'un dossier, puis de créer des tâches avec un nombre spécifique de fichiers. Il remplacera le fichier source dans les actions « load_from.source » pour chaque fichier.
Exemple : chaque jour, de nouveaux fichiers arrivent dans la source. Vous avez besoin que votre action load absorbe tous ces fichiers entrants, sans connaître à l'avance leur nom exact.
- rides_chicago_2020-01-01.csv
- rides_paris_2020-01-01.csv
- rides_tokyo_2020-01-01.csv
Chaque tâche gérera des fichiers différents, permettant la parallélisation du travail entre différents workers.
Prérequis
Avant d'utiliser ce type de segmentation, certains points doivent être vérifiés :
- Tous les fichiers doivent avoir le même format et la même structure
- Tous les fichiers doivent se trouver dans le même dossier
- Si d'autres fichiers de structures différentes sont présents dans le dossier, ces fichiers doivent avoir un nommage spécifique afin de pouvoir être filtrés par une RegExp.
- Tous les attributs/colonnes présents dans le schéma, ainsi que dans chaque fichier, doivent :
- être présents (sauf pour les formats semi-structurés tels que XML ou JSON : ils seront remplacés par des valeurs NULL si non présents) ;
- avoir le même type ou la même structure (exemple : structures datetime).
Compatibilité
Cette option de segmentation n'est compatible qu'avec les actions et sources suivantes :
Comment utiliser ce type de segmentation ?
Pour configurer cette option de segmentation, sélectionnez Based on files dans la liste déroulante « Segmentation Type ».
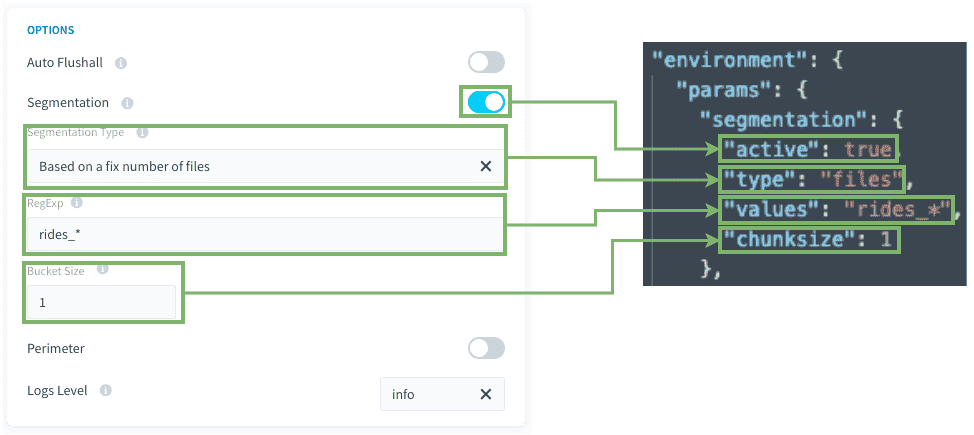
RegExp / Values : vous pouvez définir une regexp pour identifier les noms de fichiers que vous souhaitez récupérer. le caractère étoile (*) permet de rechercher n'importe quel caractère (il sera remplacé dans la regexp par : .* ). Il peut aussi s'agir d'une liste de RegExps, ou d'une liste codée en dur de noms de fichiers précis.
Bucket size / Chunksize : définissez le nombre de fichiers absorbés pour chaque tâche. il est recommandé de définir cette valeur à 1, sauf si vous avez des centaines de fichiers, auquel cas vous voudrez mettre un nombre plus élevé de fichiers pour chaque tâche afin de garder un nombre de tâches raisonnable (moins de 100 tâches).
Règles et mapping des blueprints
Dans les Connectors, vous devrez analyser un fichier qui servira de blueprint pour tous les autres fichiers. Il est important de conserver la définition de ce fichier dans les connectors afin de conserver les règles de blueprint.
Dans le DPE, en créant l'action Load, vous utiliserez le fichier analysé comme source. Ce faisant, tous les fichiers chargés auront les mêmes règles de blueprint appliquées.
Comment cela fonctionne-t-il en coulisses ?
Si votre action a une segmentation basée sur un nombre fixe de fichiers, lors de l'exécution de l'action, seule ou via un workflow, elle exécutera :
- Une pré-stage cachée récupère tous les noms de fichiers de votre source correspondant à la RegExp définie dans la configuration.
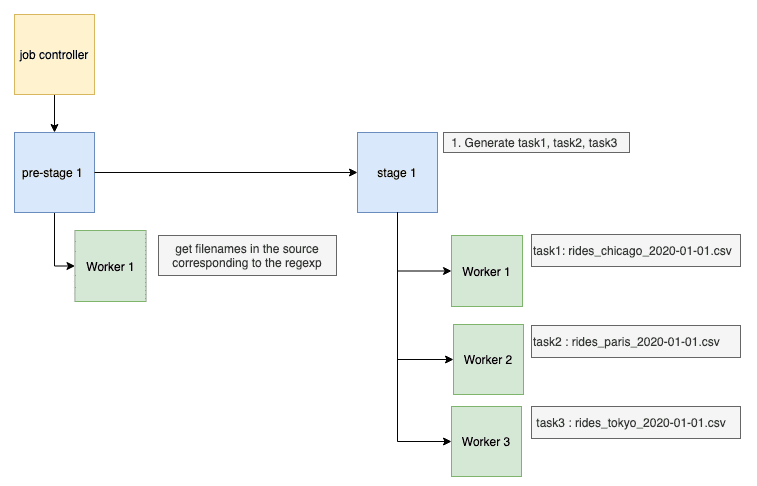
- Le Job Controller découpe l'action en plusieurs tâches, chacune avec une valeur différente (ou un ensemble de valeurs, selon la configuration
chunksize) parmi les noms de fichiers trouvés à l'étape 1. - Puis chaque worker exécute chaque tâche l'une après l'autre.
Cela signifie qu'il n'y a aucun problème à avoir des centaines de tâches, votre action sera parallélisée en fonction du nombre de workers.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.
1 : S3 est une marque déposée appartenant à Amazon Technologies, Inc. Les services de OVHcloud ne sont pas sponsorisés, approuvés, ou affiliés de quelque manière que ce soit.