
Organiser les tables en datasets dans le Lakehouse Manager
Les Datasets sont des regroupements logiques de tables partageant des paramètres par défaut, sous forme Standard ou External
Objectif
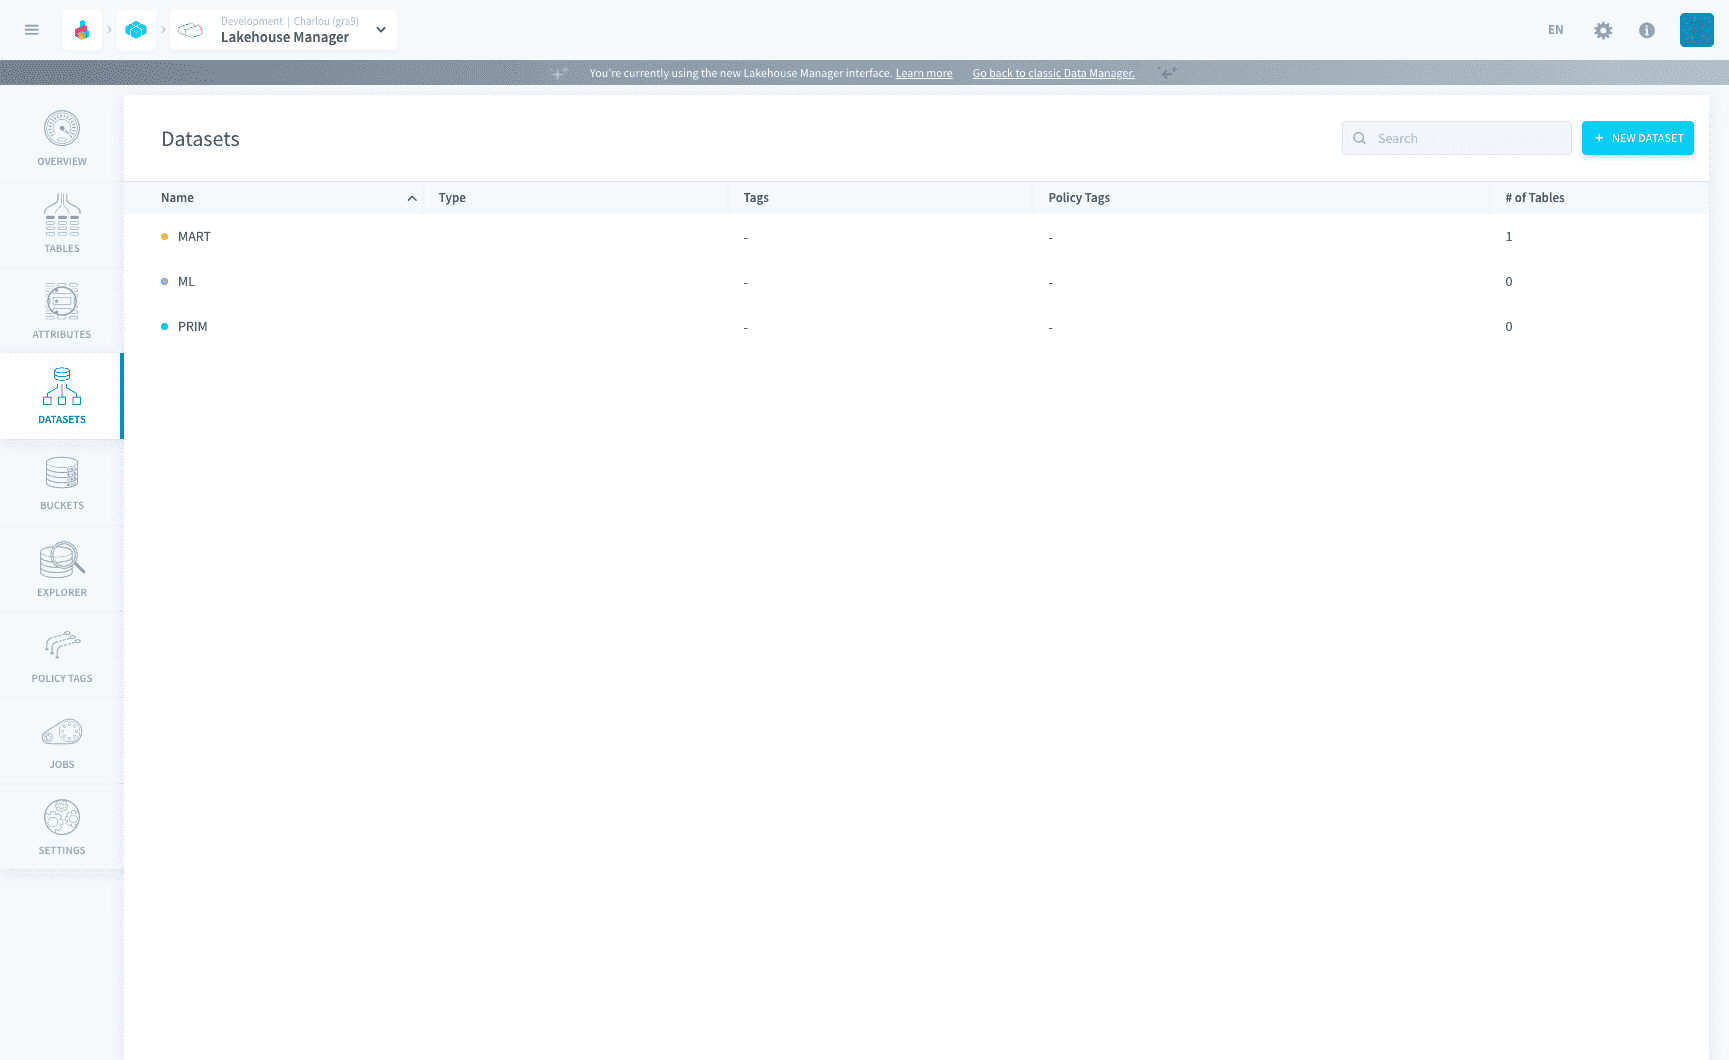
Les Datasets sont des regroupements logiques de tables, qui leur permettent de partager certains paramètres par défaut.la Platform prend en charge les Datasets Standard ainsi que External pour gérer vos tables.
Par défaut, un dataset standard nommé default_dataset vous est attribué. Ce dataset standard utilisera le Lakehouse Manager Engine, basé sur Apache Iceberg.
Une fois un dataset créé, il existe une période d'attente de 60 secondes avant qu'il puisse être utilisé pour des requêtes.
Datasets
Les Datasets ont été conçus dans l'optique d'encourager les utilisateurs à gérer les paramètres d'une table au niveau du groupe/dataset. Vous pouvez Éditer, Dupliquer et Supprimer des datasets depuis la vue liste.
Standard Dataset
Le Lakehouse Manager joue le double rôle de service de gestion des données et de moteur de stockage pour le dataset standard. Vous pouvez en apprendre davantage sur ce moteur en cliquant sur le lien discover pendant la création d'un dataset.
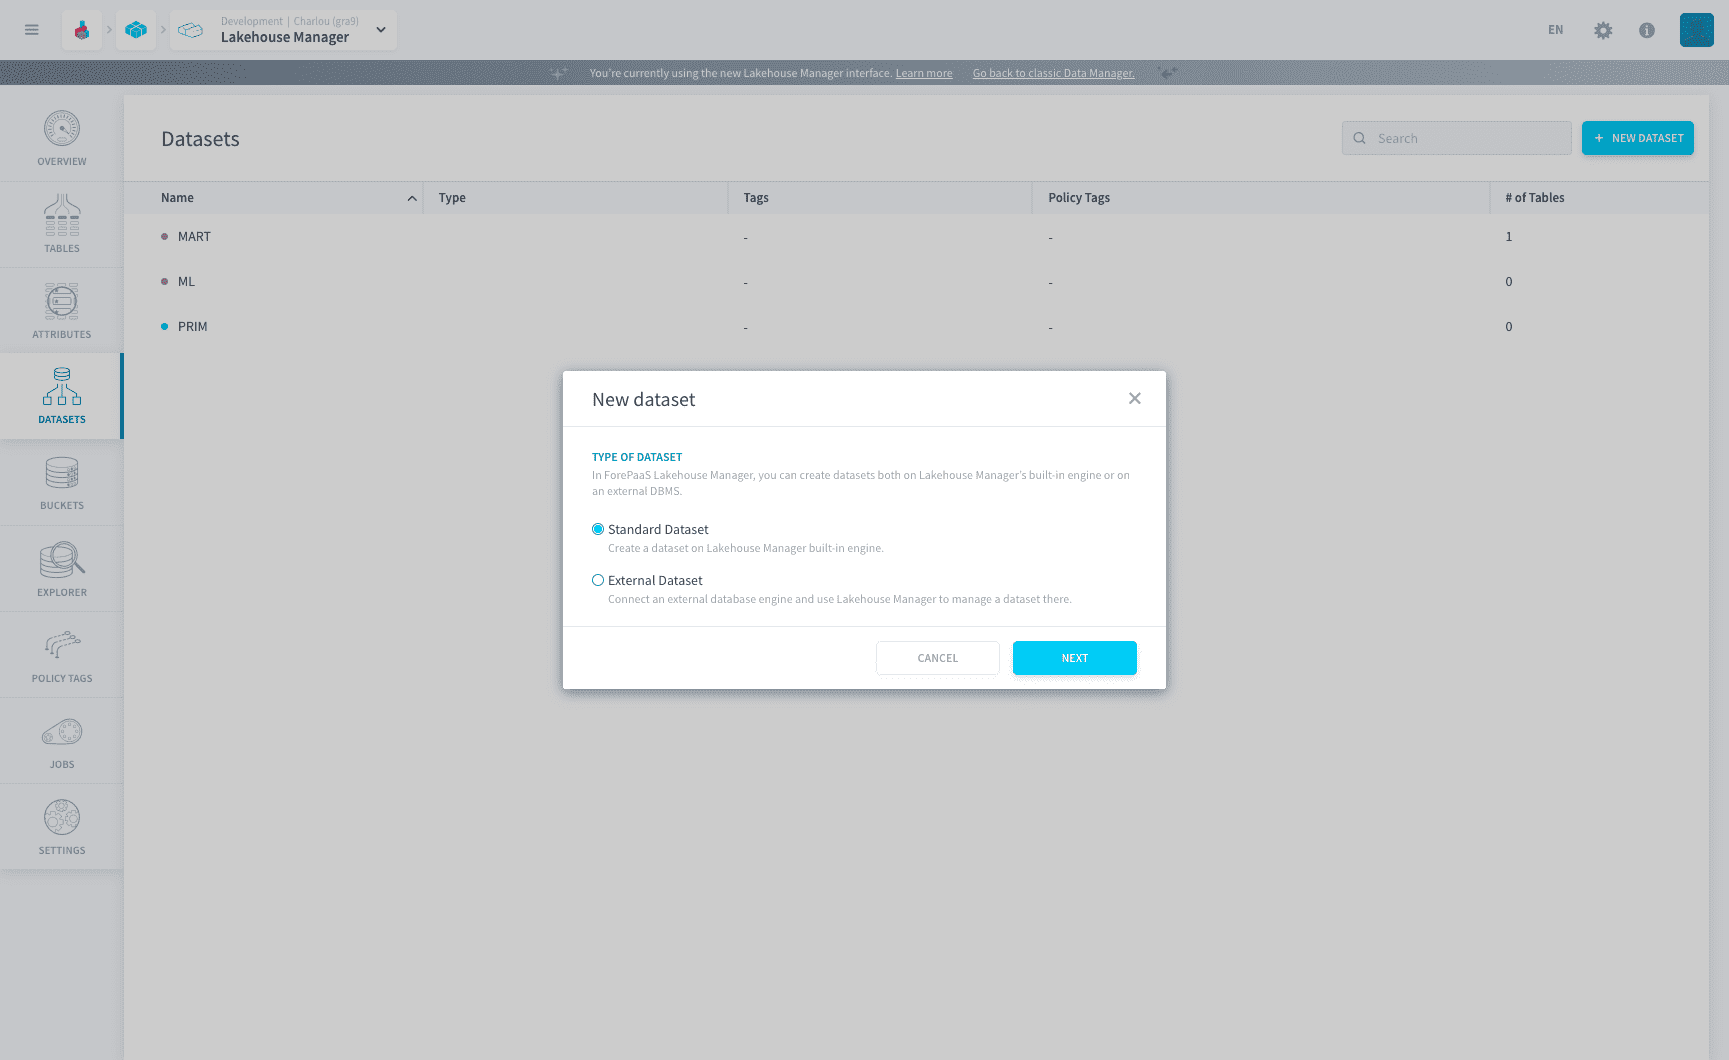
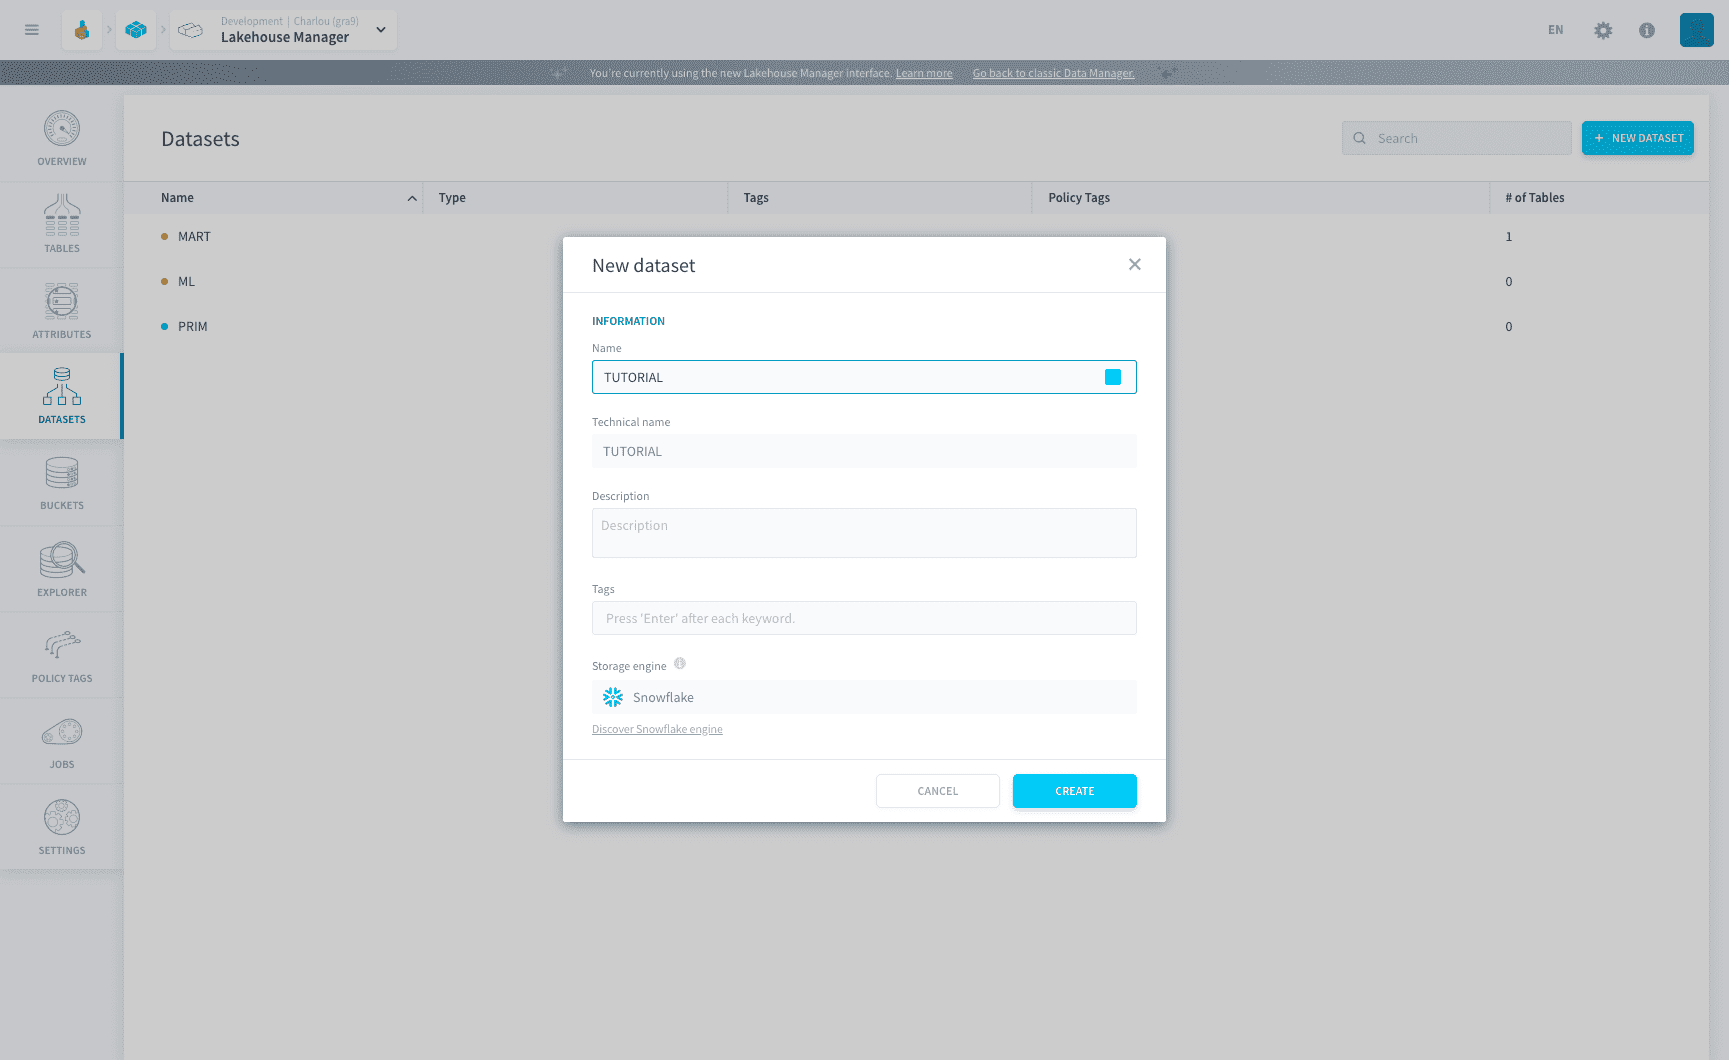
Cliquez sur le bouton New Dataset pour commencer à créer un nouveau dataset, puis sélectionnez standard dataset. Remplissez tous les champs requis du dataset et cliquez sur Create.
Comment les données sont stockées
Le Lakehouse Manager sépare l'organisation logique de vos données de l'endroit où les octets vivent réellement. Trois concepts sont faciles à confondre, il est donc utile de les distinguer :
- Datasets : une enveloppe logique qui regroupe des tables. Un dataset ne stocke aucune donnée lui-même.
- Tables : les objets physiques, stockés dans Apache Iceberg et gérés par le Lakehouse Manager.
- Buckets : un espace de stockage d'objets compatible S31 pour les fichiers non structurés, indépendant du Lakehouse. Voir Buckets.
Un dataset n'est donc pas un bucket : c'est un regroupement logique de tables.
Comme un dataset ne contient que des métadonnées, partager ou déplacer un dataset ne copie jamais de données : cela modifie ce vers quoi le Lakehouse pointe. Voir Partage inter-projets.
Gestion des Datasets
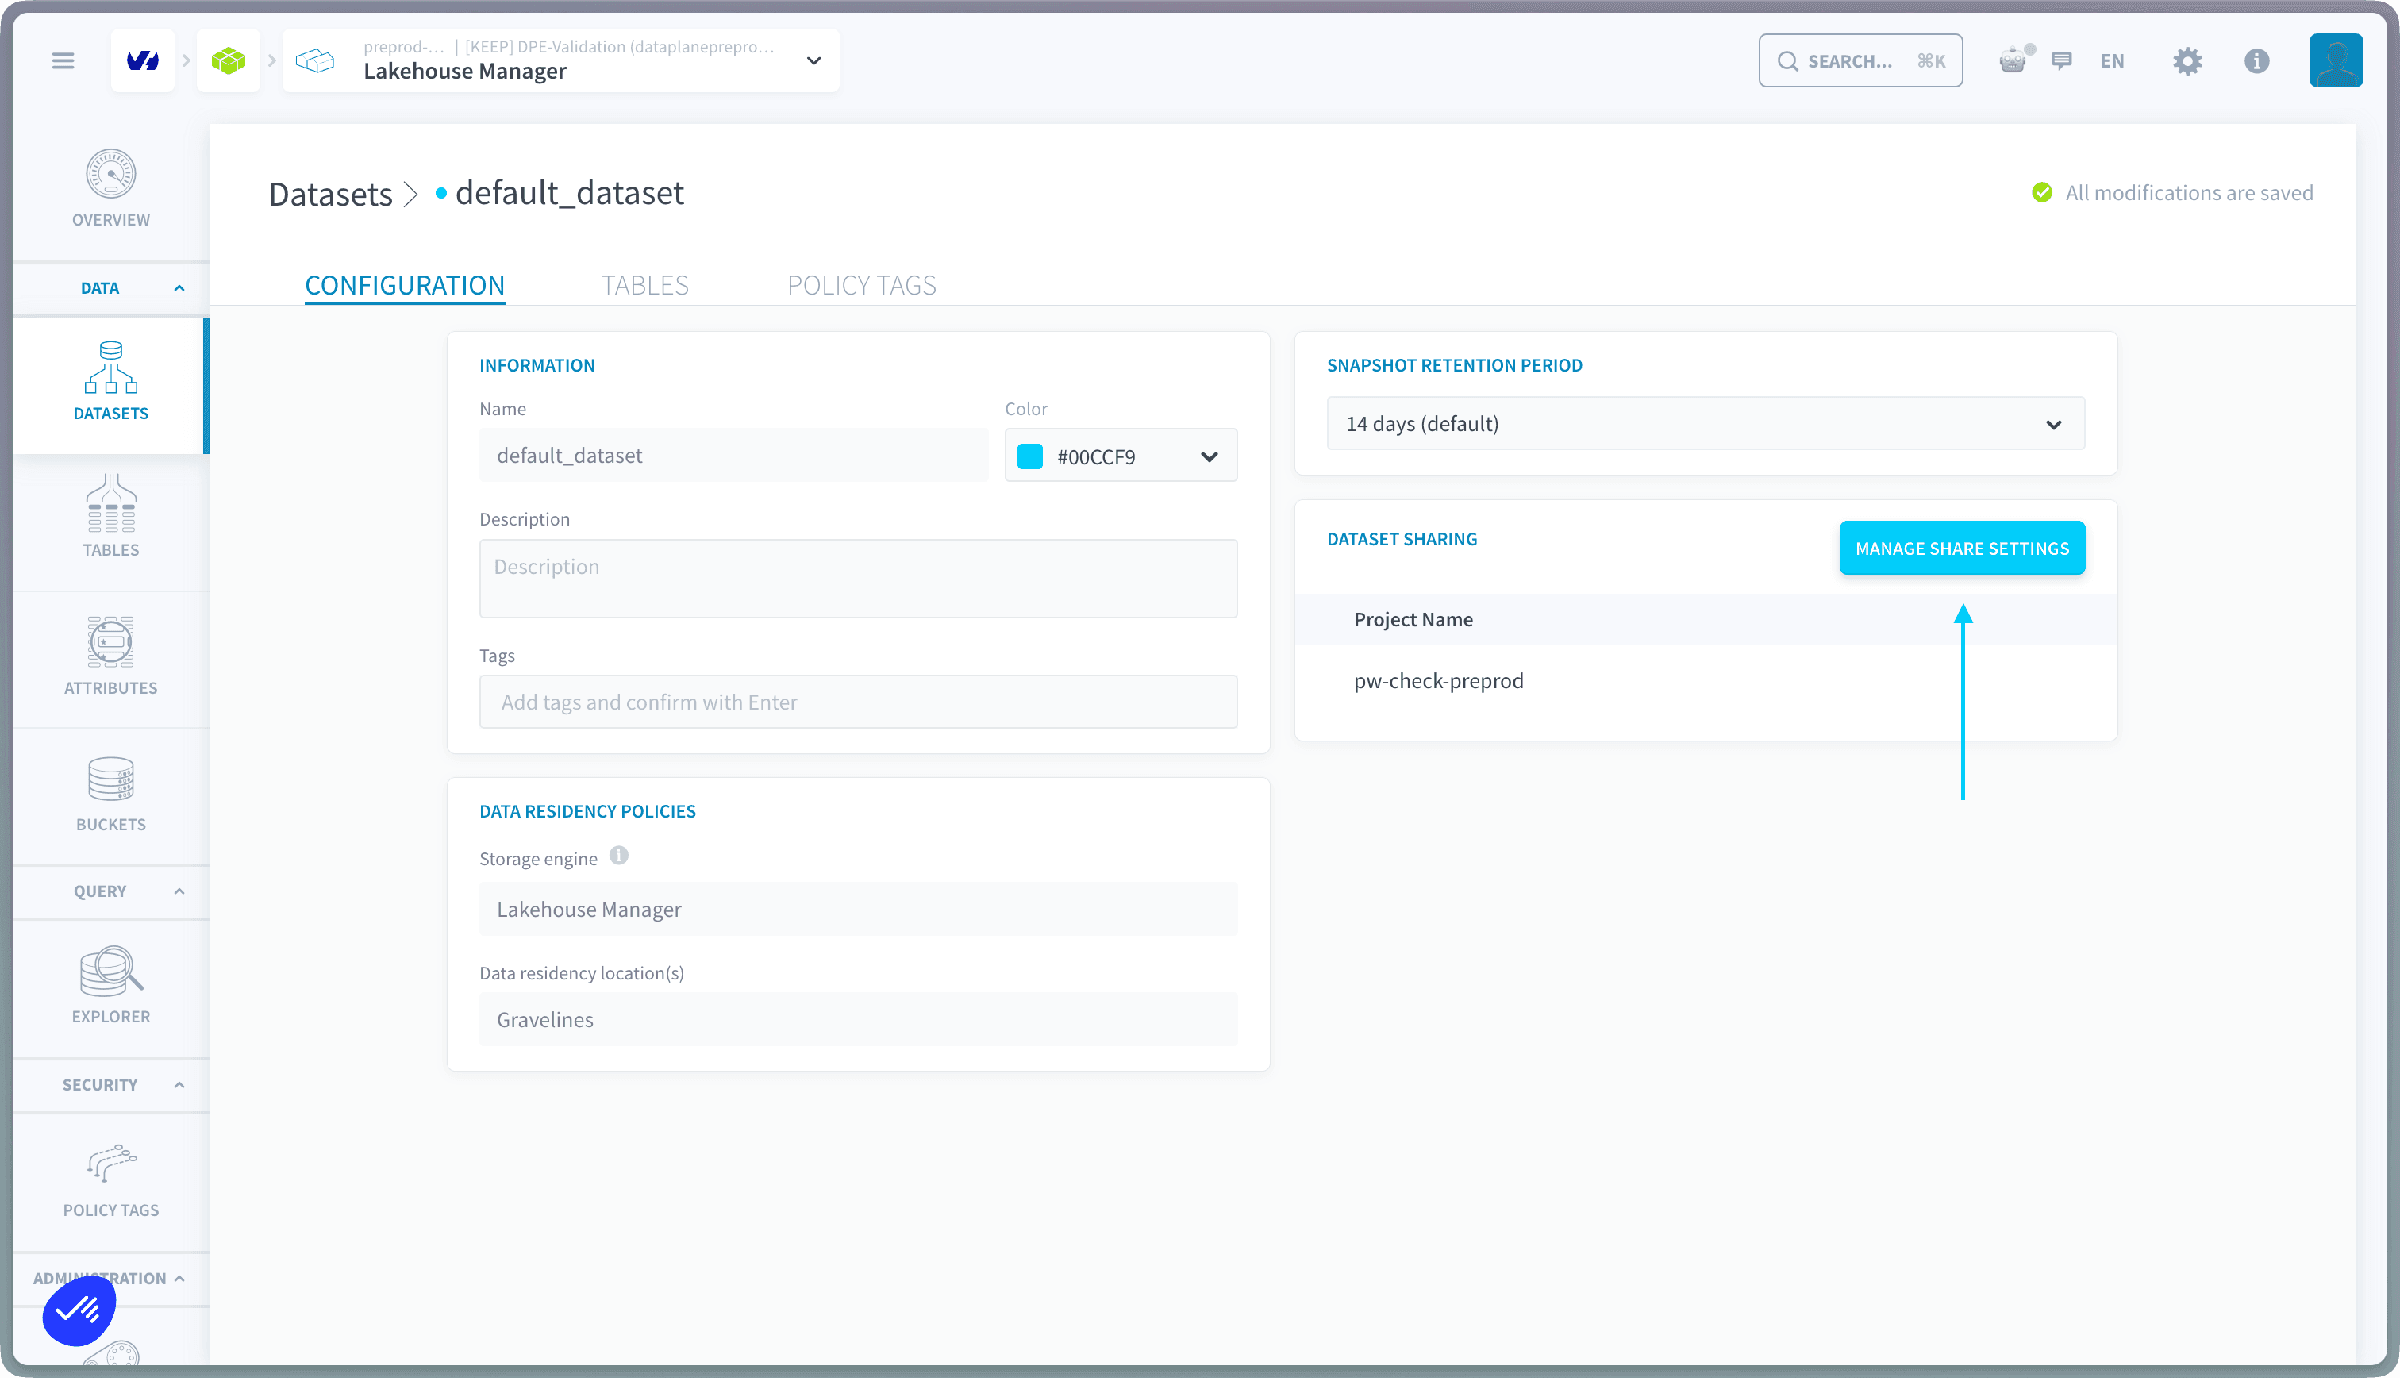
La page de configuration affiche toutes les informations que vous devez connaître sur votre dataset. Vous pouvez éditer la description et les tags de vos datasets, et consulter également les politiques de résidence des données - moteur de stockage utilisé et emplacement de résidence des données.
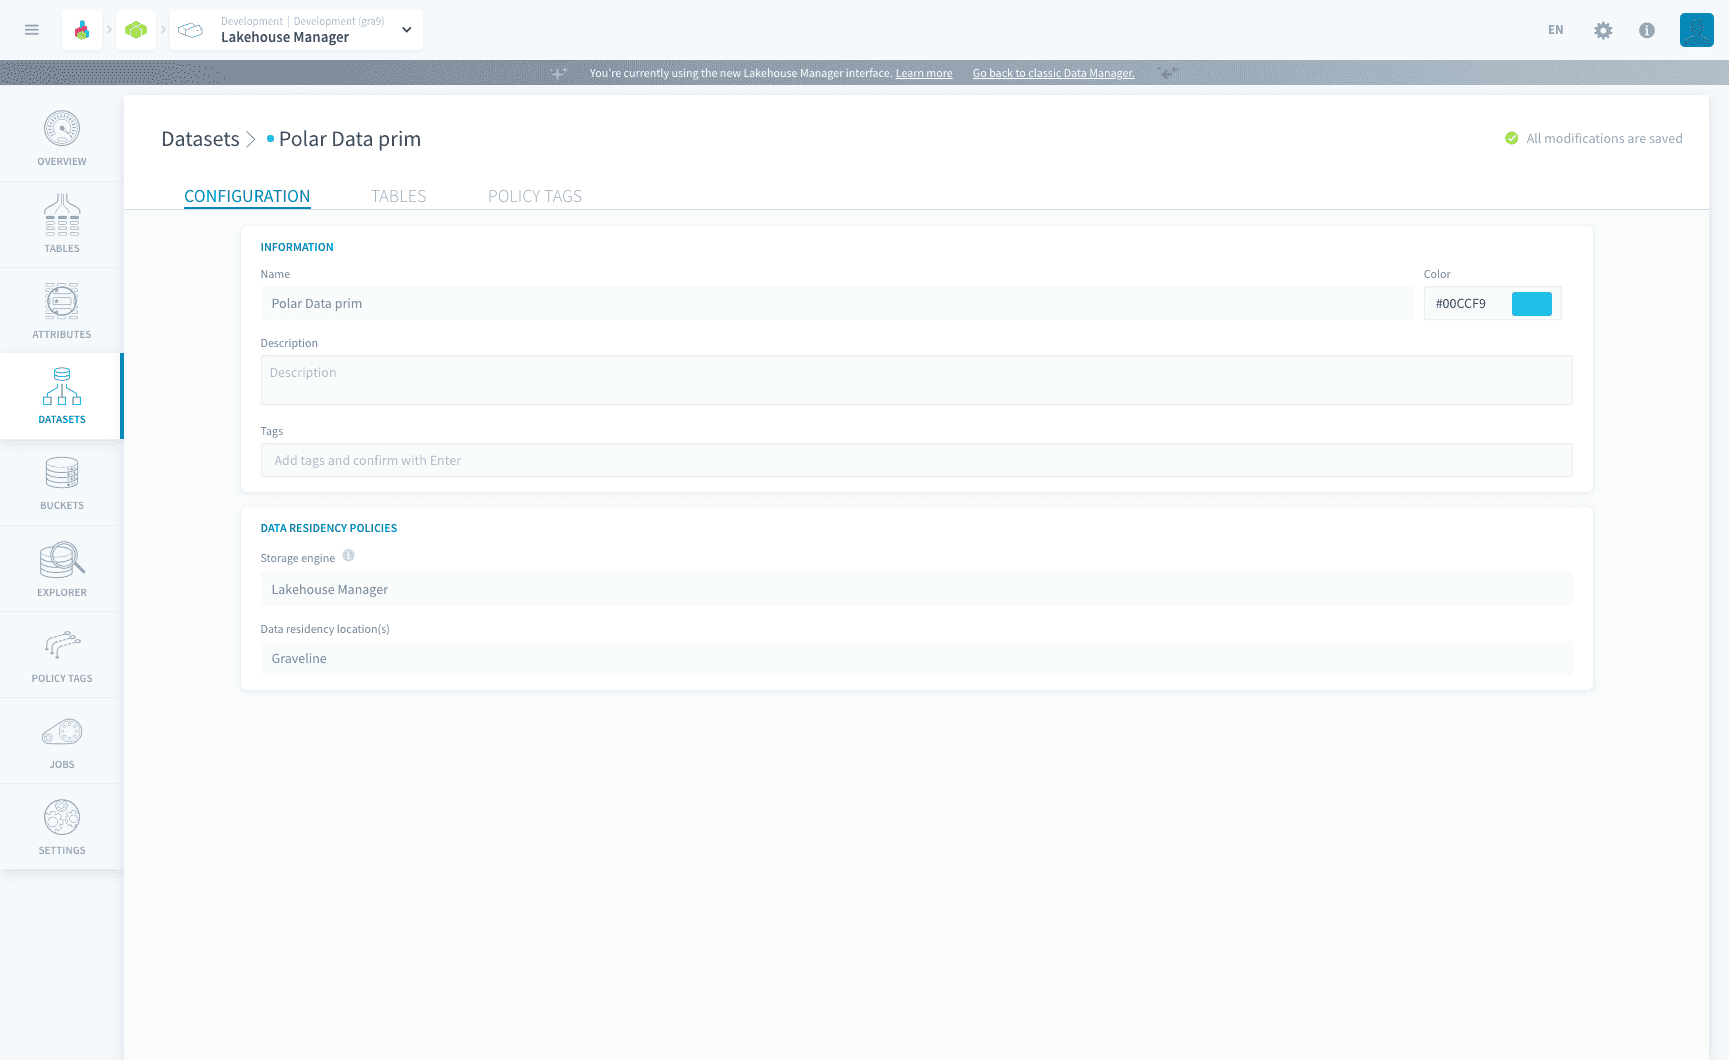
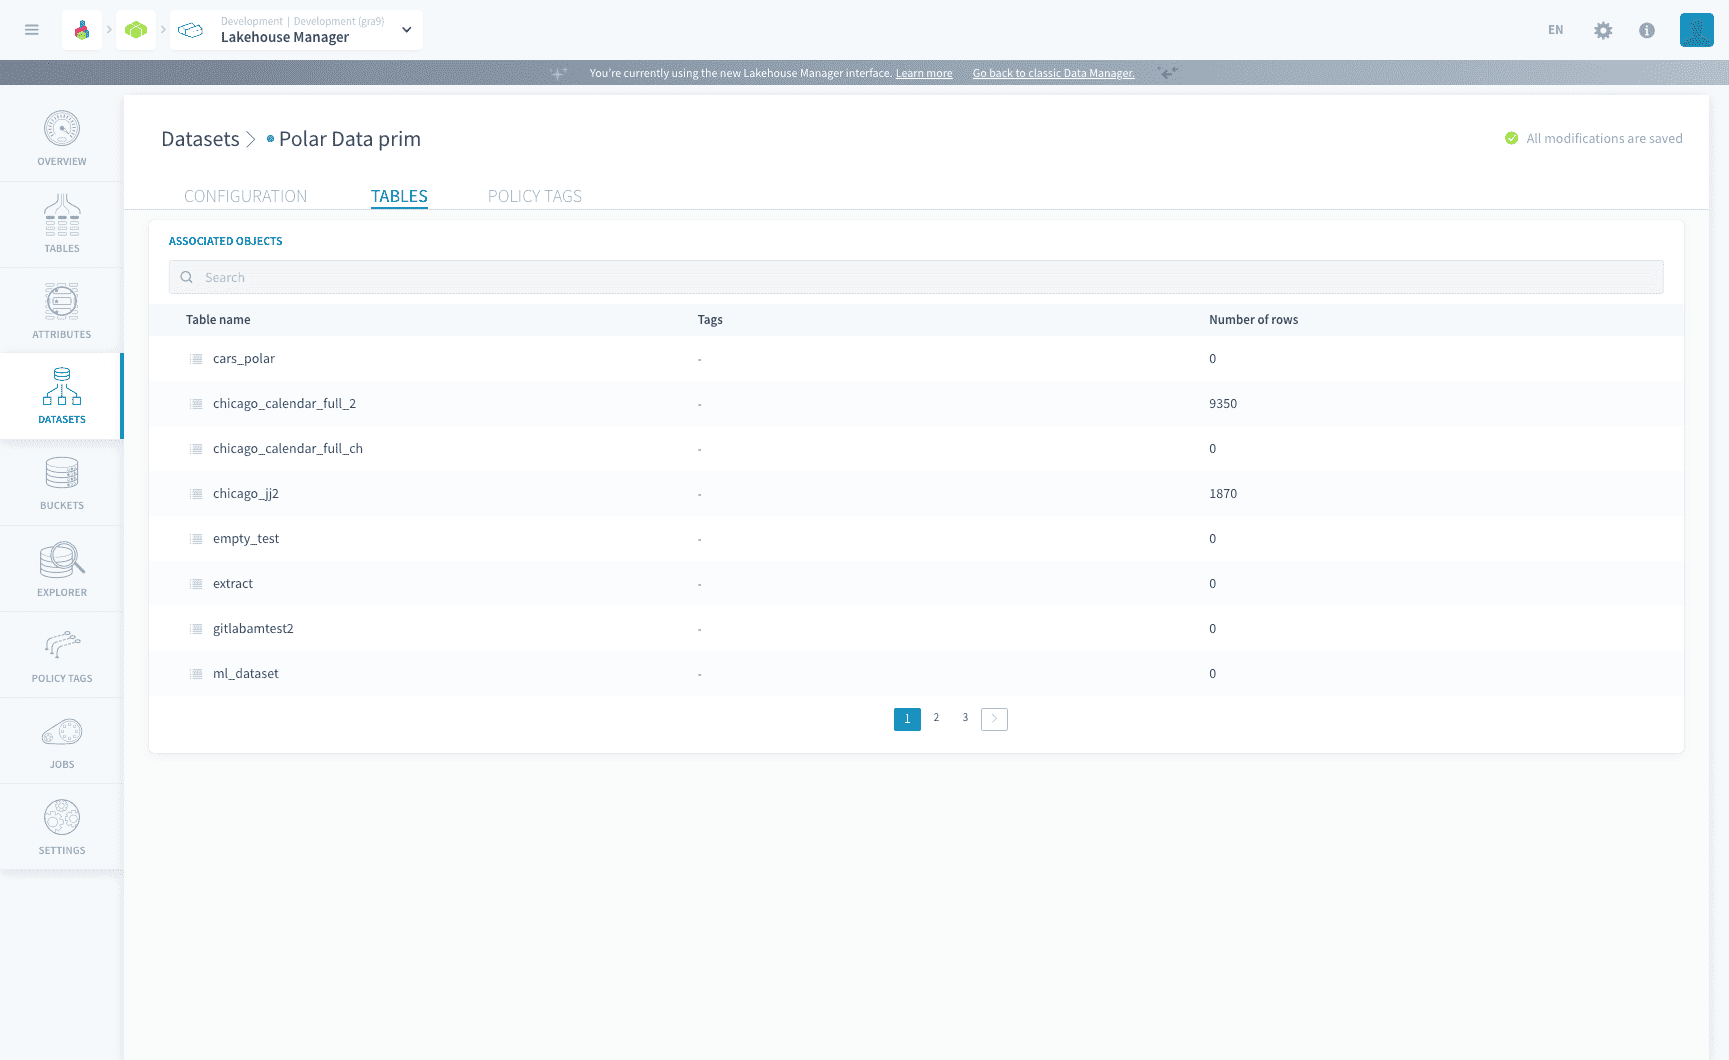
Dans l'onglet tables, vous pouvez voir toutes les tables associées faisant partie du dataset. Il est important de se rappeler qu'il s'agit uniquement d'une vue, et que vous ne pouvez éditer aucune des tables depuis ce menu.
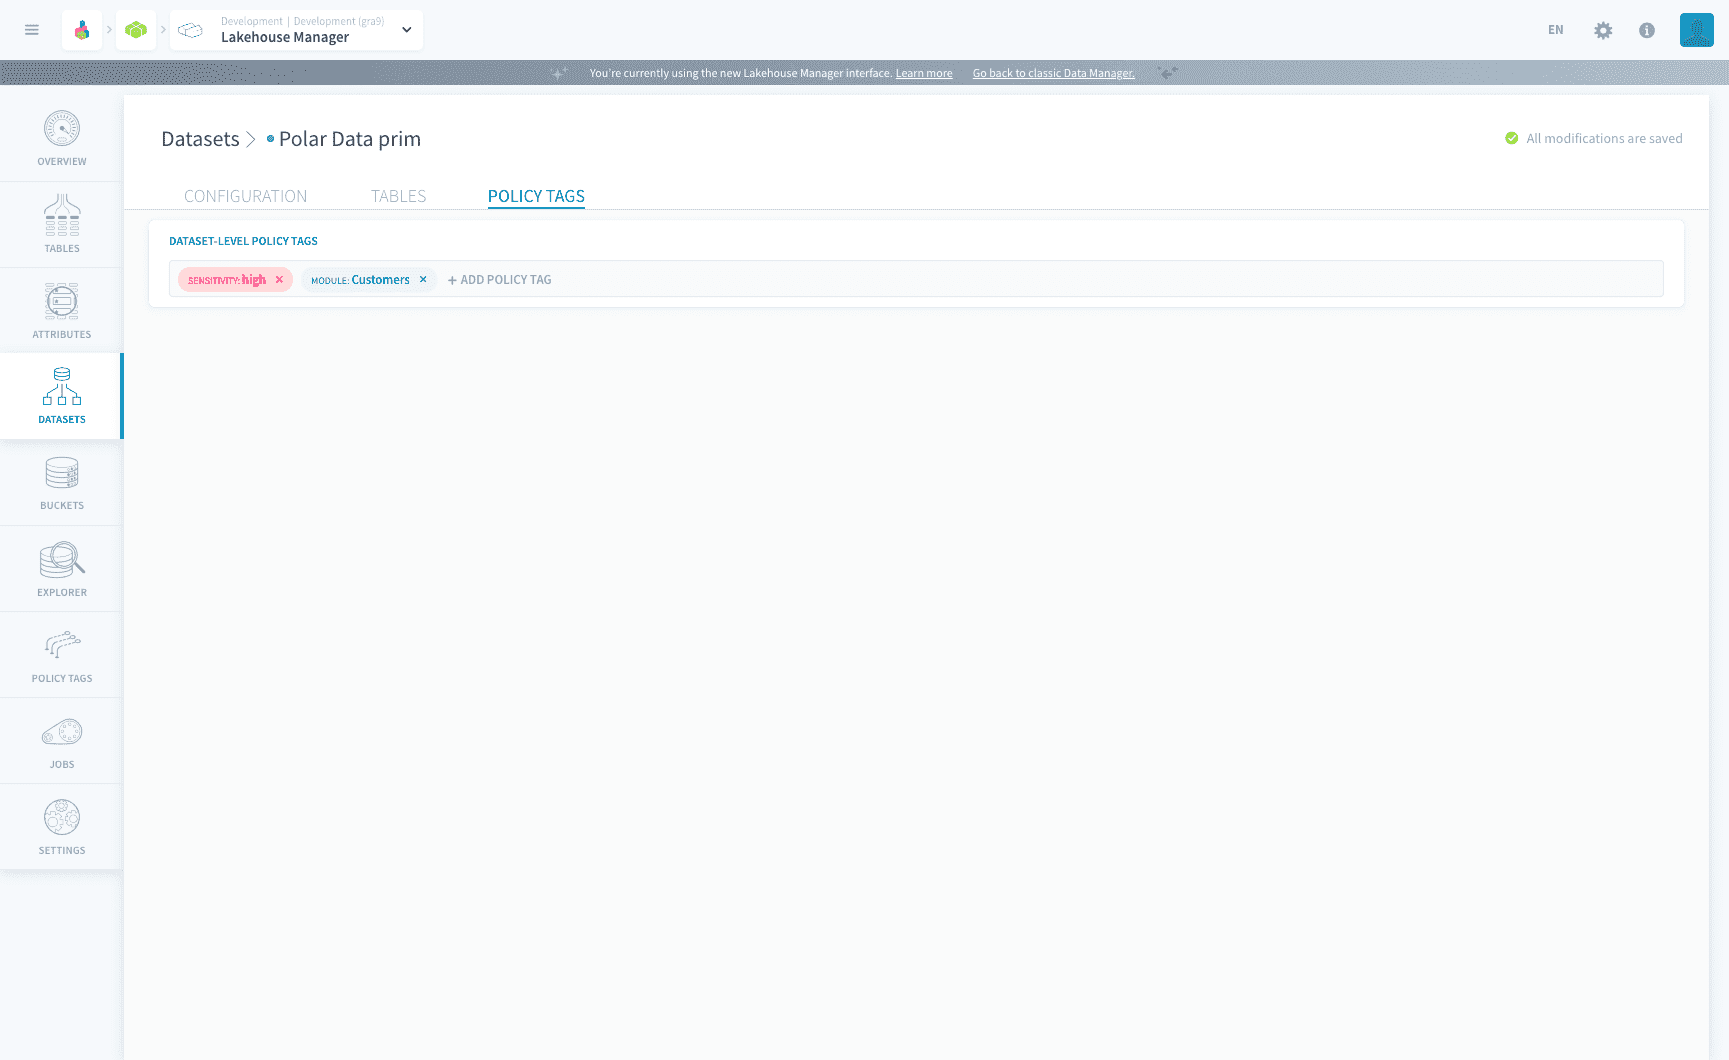
Le menu policy tags vous permet d'attribuer des policy tags à l'échelle du dataset, qui seront ensuite appliqués à toutes les tables faisant partie du dataset. Vous pouvez choisir parmi les policy tags disponibles, ou même en créer sur le moment. Ici se trouve le guide étape par étape pour associer des policy tags.
Organiser vos données : l'approche médaillon
La Data Platform n'impose pas d'architecture Bronze / Silver / Gold (« médaillon ») : vous êtes libre de modéliser votre lakehouse de la manière qui convient à votre cas d'usage. Par défaut, un dataset vous est provisionné (default_dataset).
Cela dit, gérer des couches médaillon avec des datasets est un pattern valide qui s'intègre naturellement au reste de la platform. Un pipeline typique ressemble à ceci :
- Bronze : données brutes, ingérées via les Connectors.
- Silver : nettoyées, validées et dédupliquées par les actions du Data Processing Engine.
- Gold : enrichies, jointes et agrégées par les actions du Data Processing Engine, prêtes à être consommées dans l'Analytics Manager ou votre outil BI.
Chaque couche est un dataset ; les transformations entre les couches sont des actions orchestrées dans un workflow.
Partage inter-projets (bêta)
Cette fonctionnalité est actuellement en bêta. Merci de nous signaler tout problème rencontré.
Par défaut, chaque projet sur la Data Platform est entièrement isolé : il n'existe aucun moyen implicite d'accéder à un dataset depuis un autre projet. Le partage inter-projets permet au propriétaire d'un dataset de l'exposer, depuis le projet source, à un ou plusieurs projets destinataires de manière contrôlée, sans rompre les limites de sécurité existantes.
Ce que le partage fait, et ne fait pas
- Le partage s'effectue au niveau du dataset, entre projets au sein de la même organisation. Vous ne pouvez pas partager avec une autre organisation.
- Un dataset partagé est un singleton, pas une copie. Les lectures, écritures, constructions, et l'utilisation dans les notebooks et actions personnalisées s'appliquent aux mêmes données sous-jacentes, tant du côté source que du côté destinataire.
- Pour l'instant, le partage est complet : l'intégralité du dataset est exposée au projet destinataire.
- L'isolation entre projets non liés reste strictement appliquée.
Permissions et rôles
Le partage est géré depuis le projet source.
- Un dataset partagé est exposé en READ & WRITE.
- Le rôle LM & AM Editor est requis pour partager un dataset ou pour supprimer un partage existant.
L'accès à un dataset partagé est toujours évalué dans le contexte du projet destinataire, et non du projet source. Lorsque l'utilisateur B du projet B lit un dataset partagé depuis le projet A, la platform demande « l'utilisateur B a-t-il accès à ce dataset dans le projet B ? », jamais « dans le projet A ». Comme l'utilisateur B n'existe pas dans le projet A, cette seconde question renverrait toujours faux. Vos règles d'accès restent donc ancrées dans le projet destinataire.
Un module Advanced Data Access Control plus granulaire est à l'étude pour des permissions plus fines sur les objets partagés.
Partager un dataset
- Depuis le projet source, ouvrez le dataset que vous souhaitez partager et allez dans son onglet Configuration.
- Cliquez sur Manage share settings.
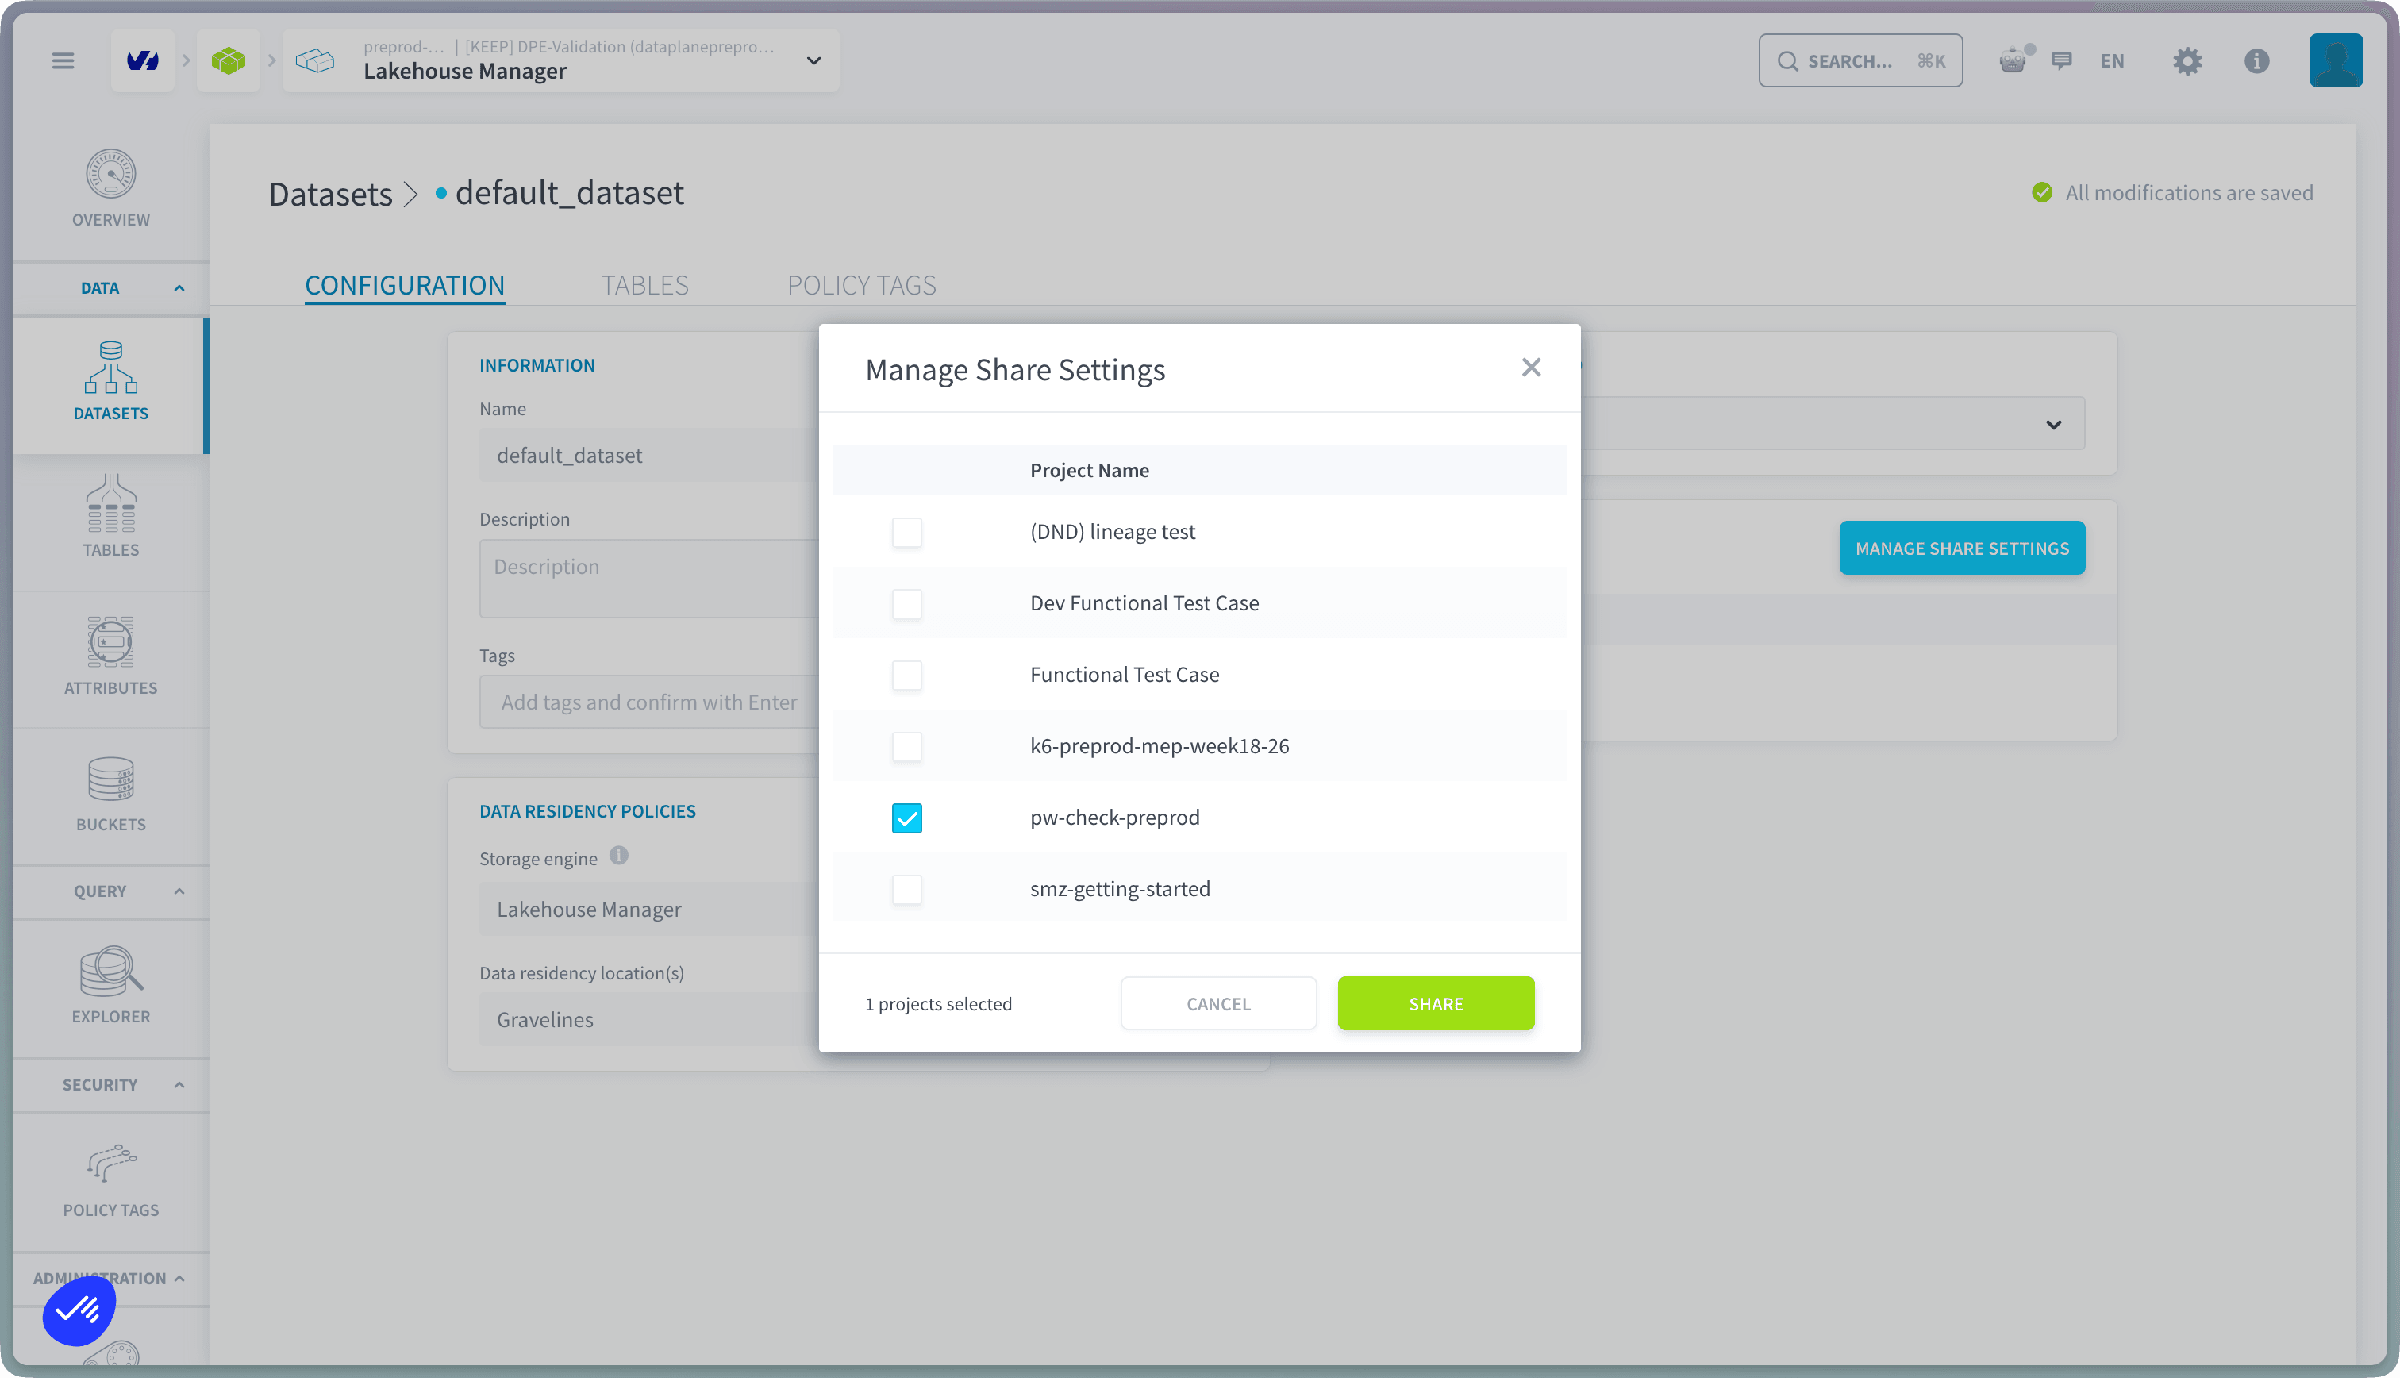
- Sélectionnez un ou plusieurs projets dans la liste des projets disponibles de votre organisation, puis confirmez.
- Vous recevrez un email confirmant que le dataset a été partagé.
Le projet source affiche les informations d'utilisation pour chaque projet avec lequel le dataset a été partagé, afin que vous puissiez suivre qui consomme les données partagées.
Sur le projet destinataire
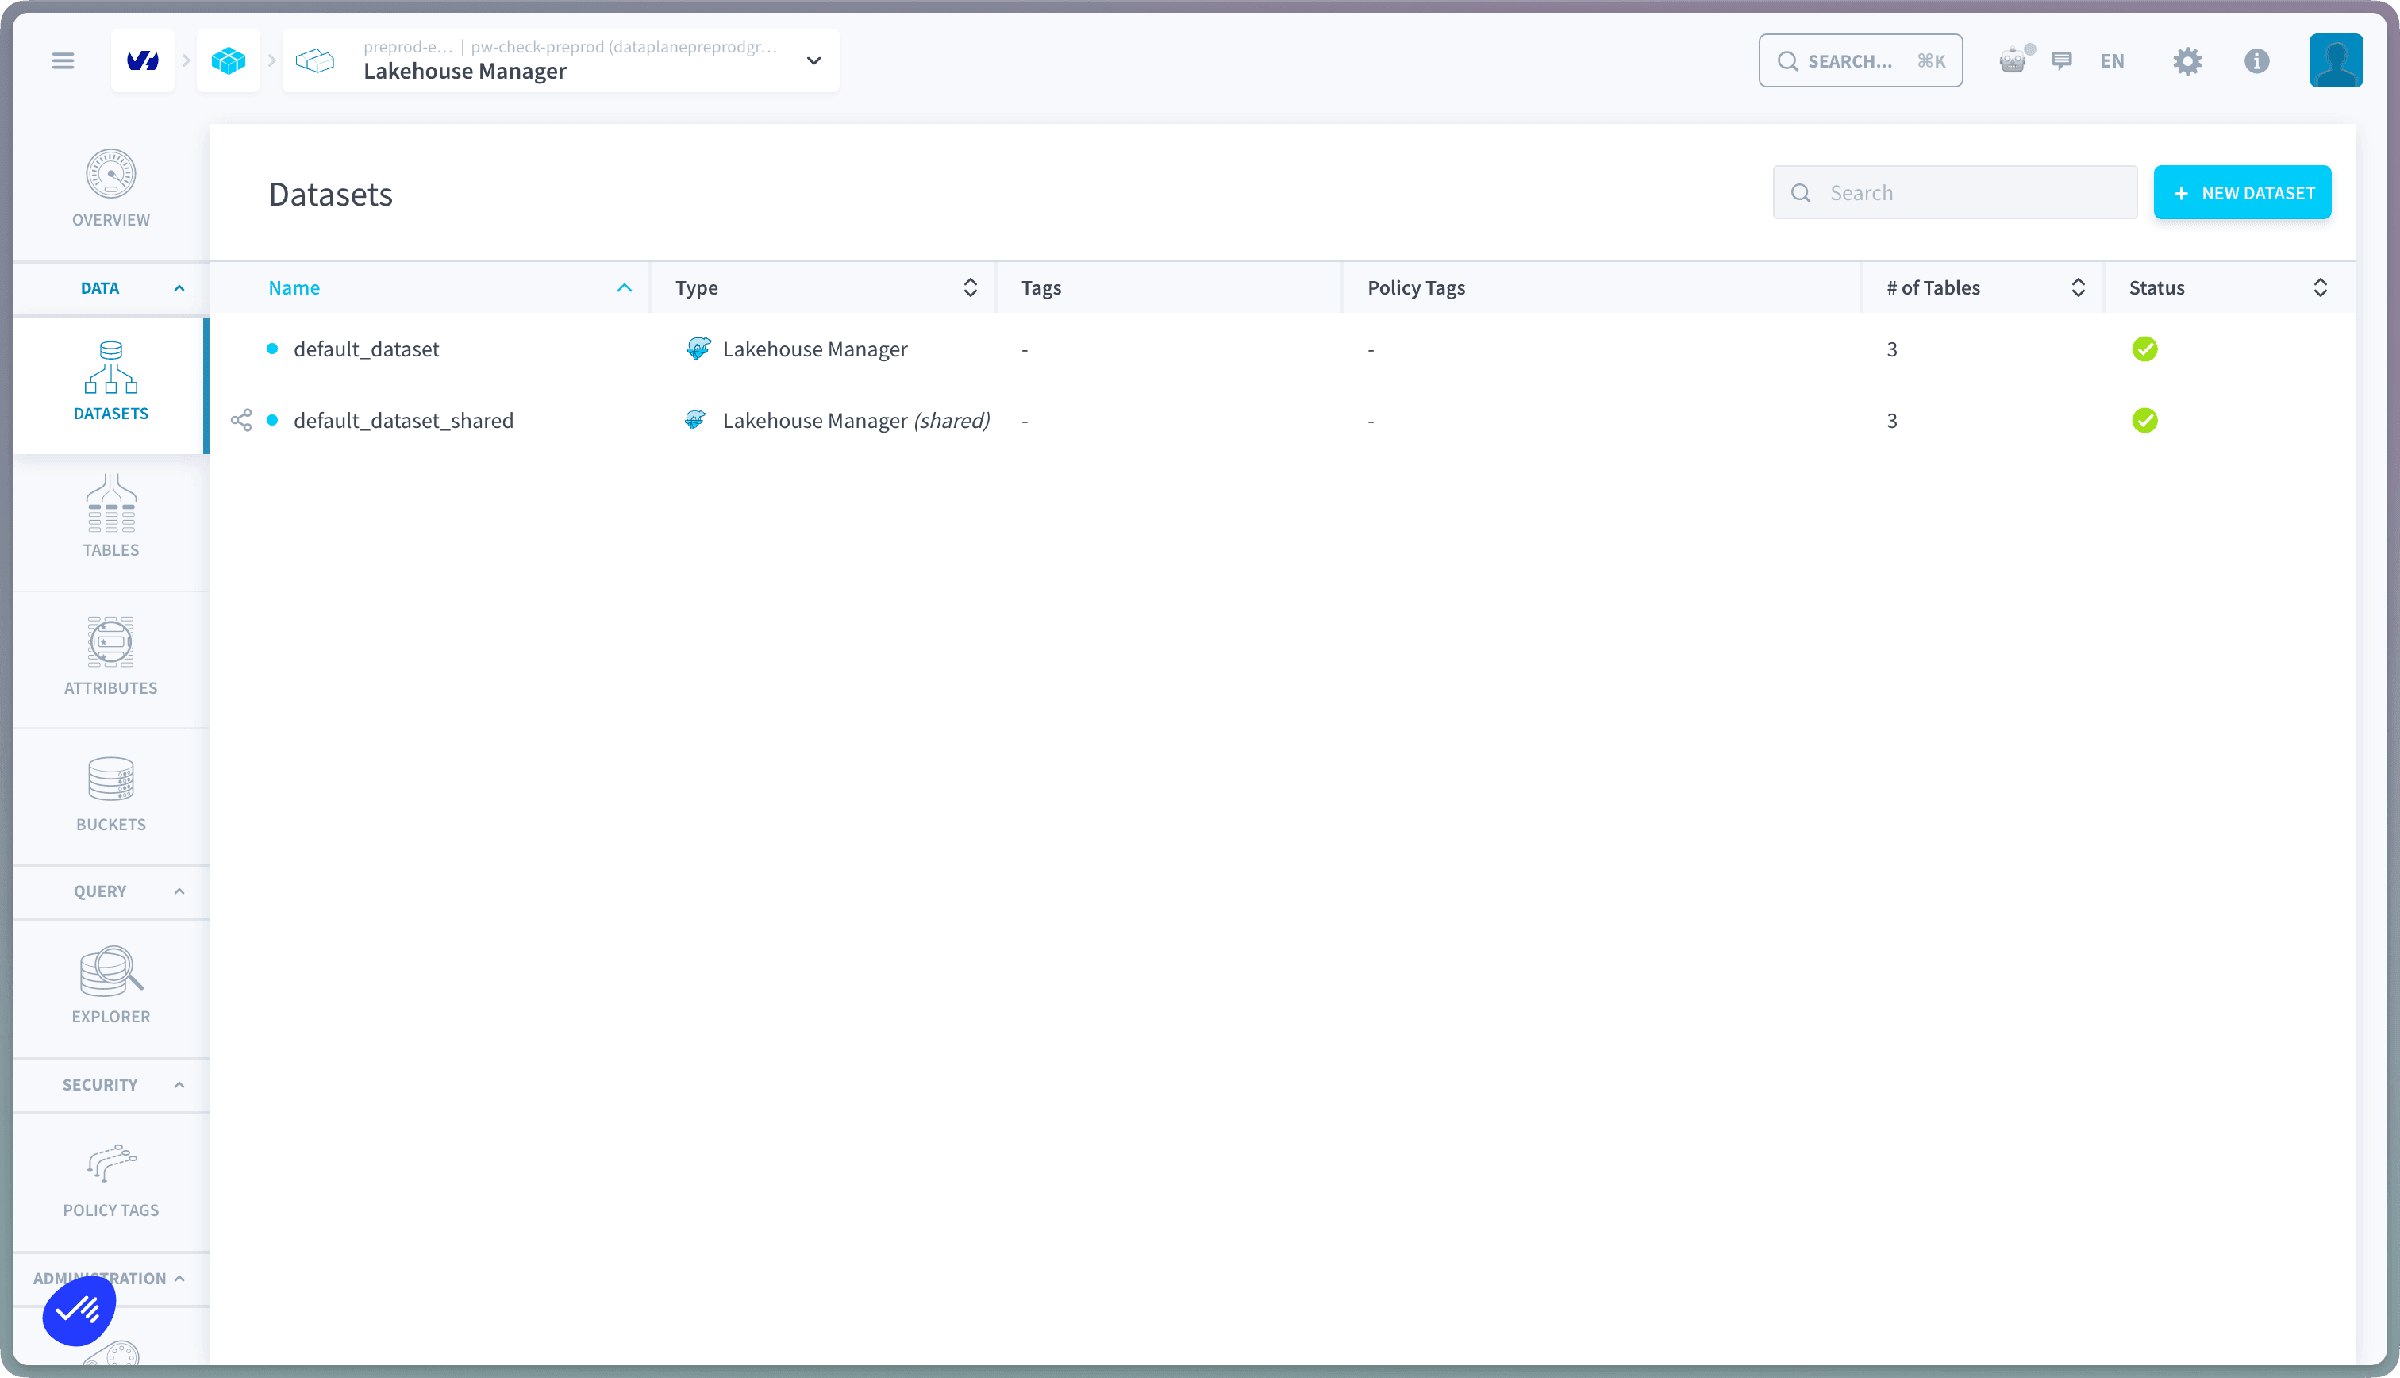
Les datasets partagés apparaissent dans le menu Datasets du Lakehouse Manager du projet destinataire, aux côtés des datasets propres au projet. Ils sont signalés par une icône de partage et le type Lakehouse Manager (shared).
Ouvrir un dataset partagé affiche ses détails en mode lecture seule : la configuration du dataset et la structure des tables restent gérées depuis le projet source. Les tables associées peuvent être prévisualisées en cliquant sur l'icône d'aperçu.
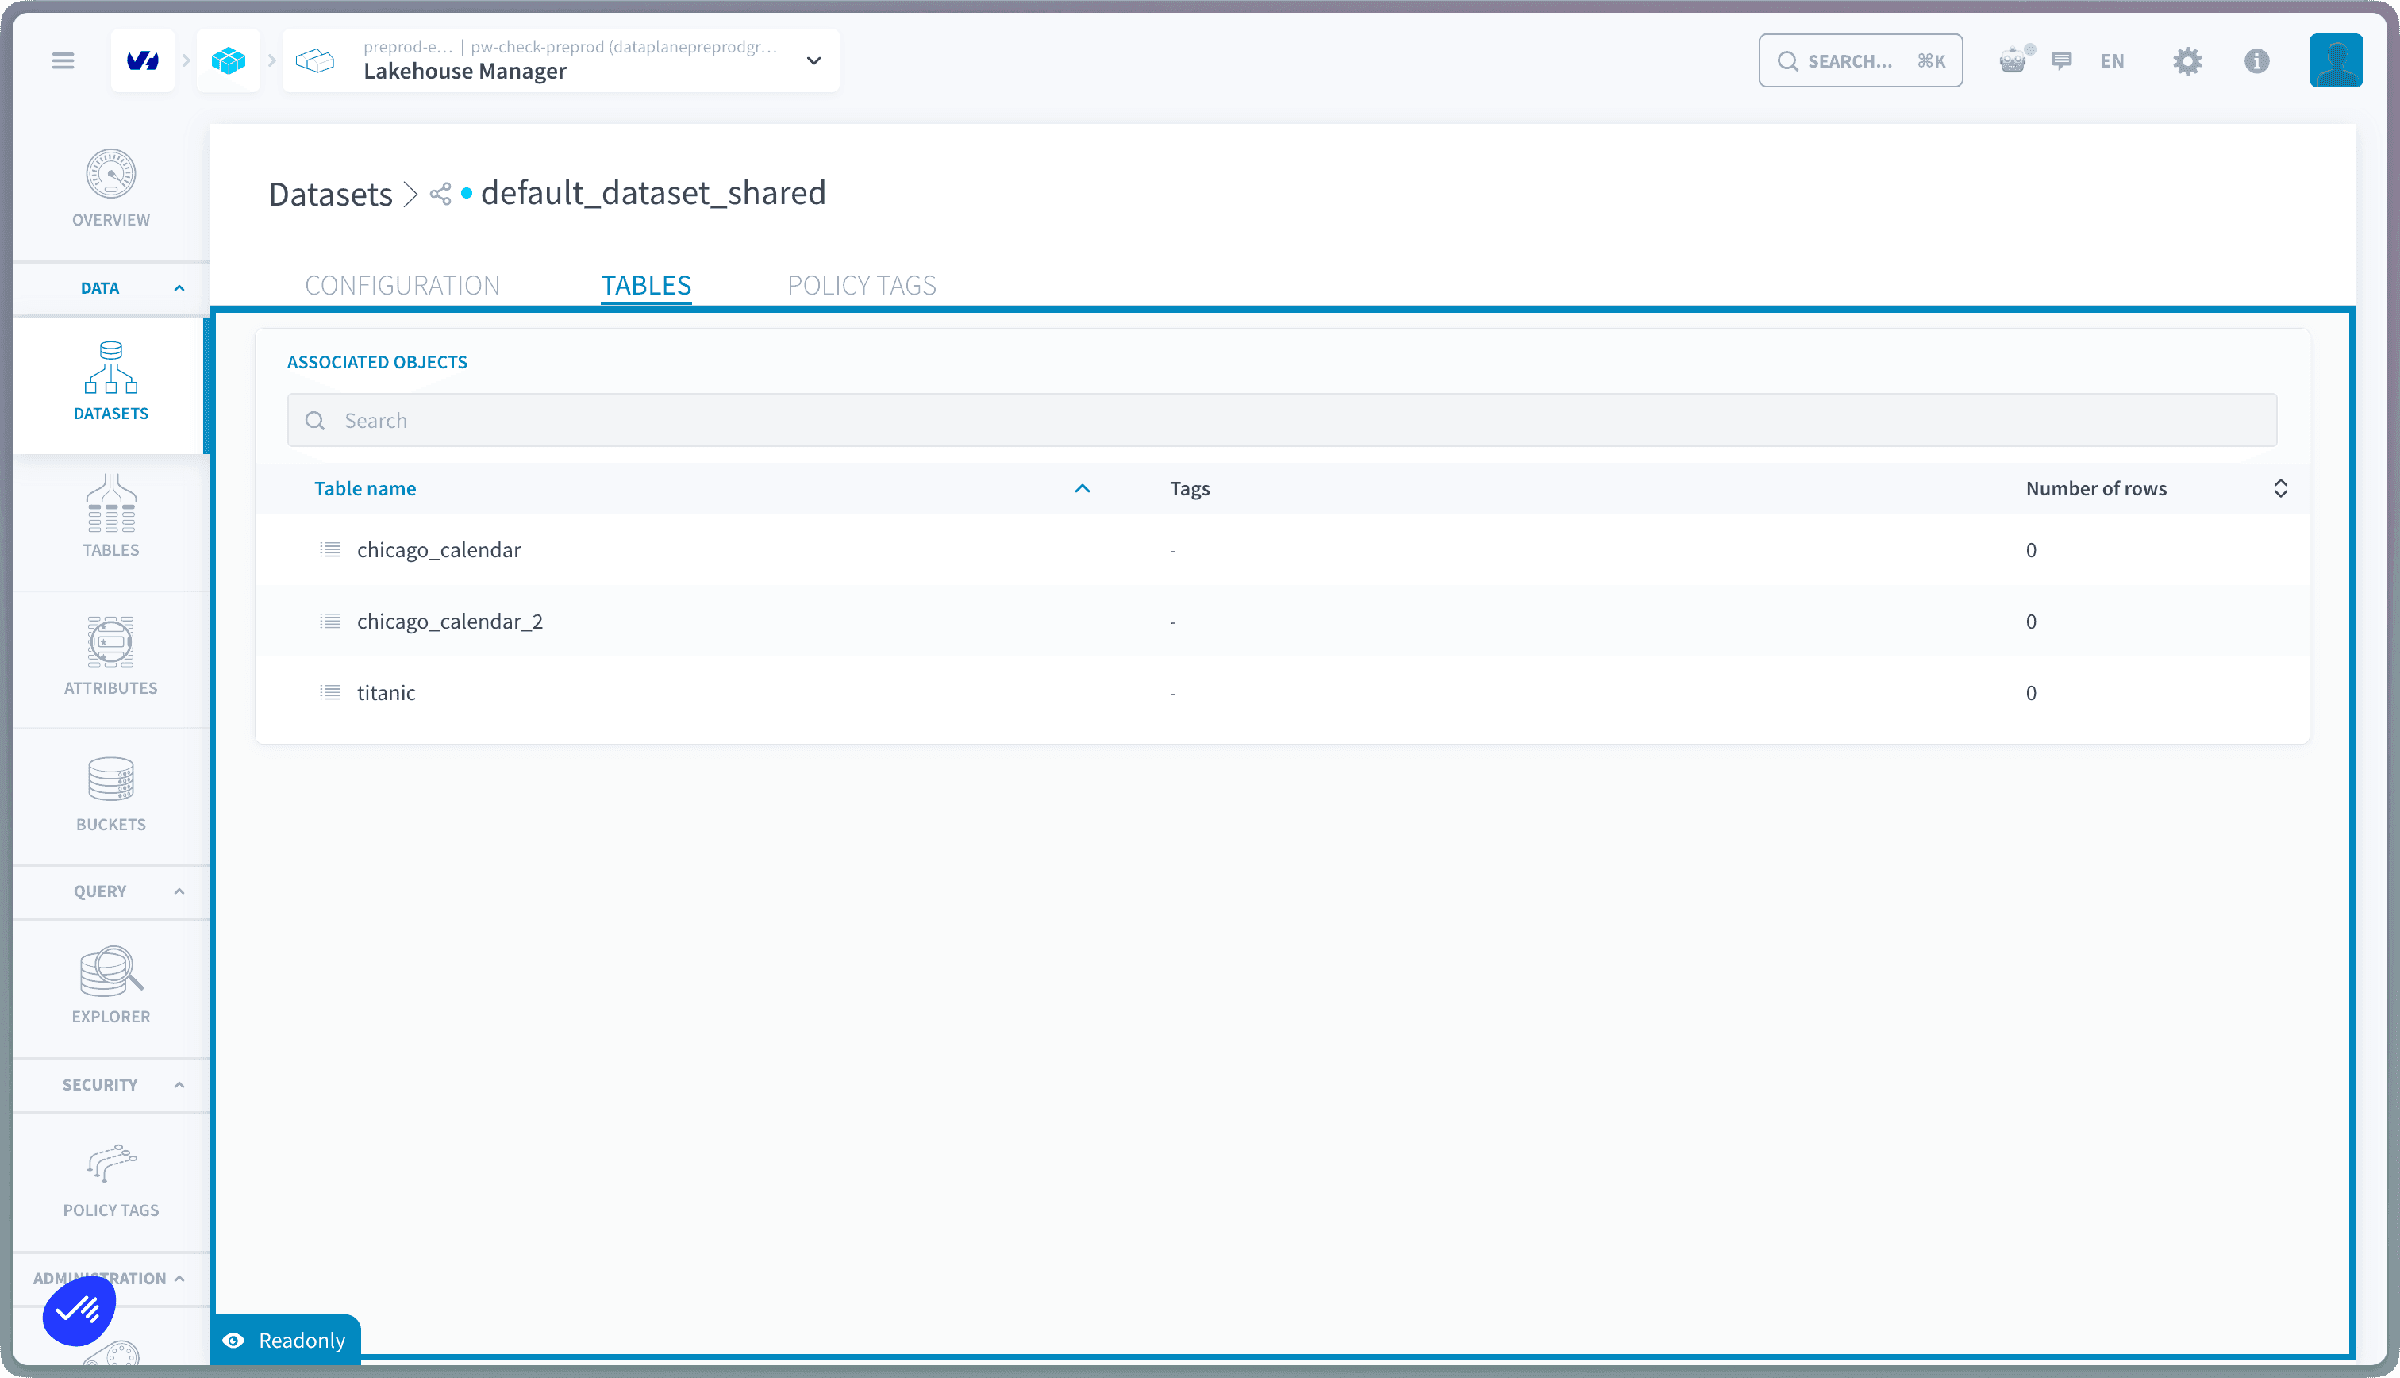
Le dataset partagé peut être utilisé comme source dans les Connectors et dans Trino, de sorte que les utilisateurs du projet destinataire travaillent avec ses données exactement comme ils le feraient avec un dataset dédié.
Dans l'Explorer
Dans l'Explorer, utilisez l'option list by dataset pour trouver une nouvelle catégorie Shared Datasets. Toutes les tables provenant de datasets partagés avec ce projet sont listées ici.
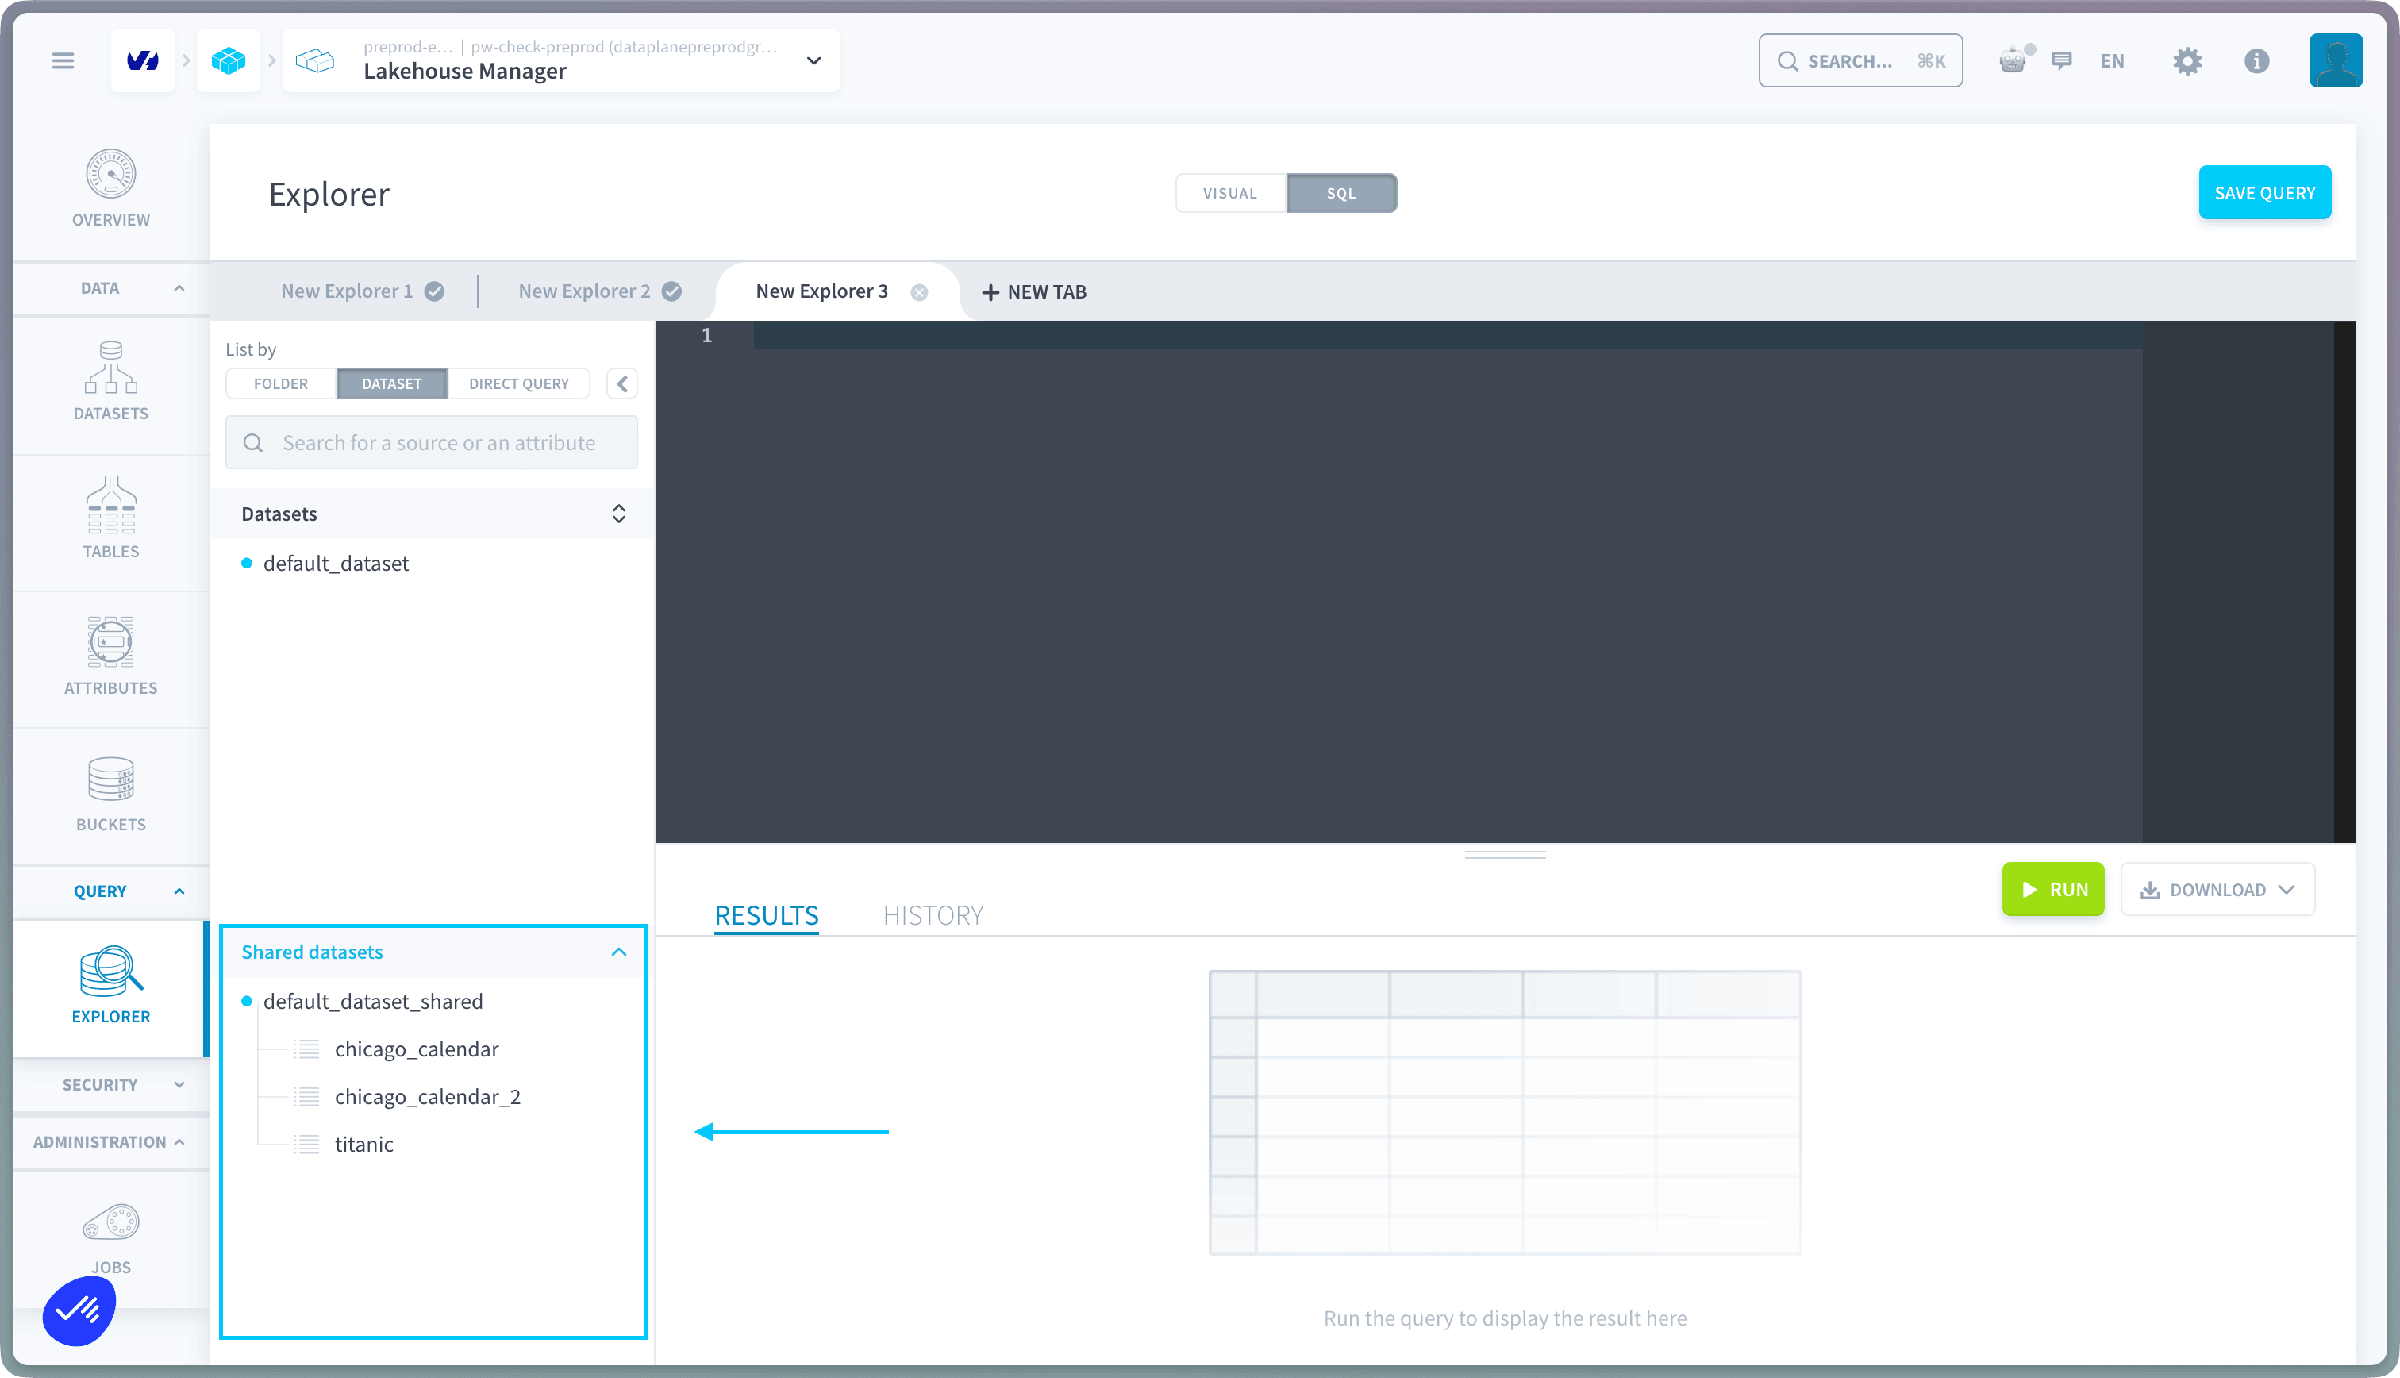
Les tables de datasets partagés ne peuvent être interrogées qu'à l'aide de l'éditeur SQL. La prise en charge du visual builder n'est pas encore disponible.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.
1 : S3 est une marque déposée appartenant à Amazon Technologies, Inc. Les services de OVHcloud ne sont pas sponsorisés, approuvés, ou affiliés de quelque manière que ce soit.