
Découvrir la segmentation basée sur un ensemble de valeurs prédéfinies
Vos actions peuvent être exécutées sur un ensemble de valeurs de votre choix tout en segmentant sur celles-ci en même temps
Objectif
Vos actions peuvent être exécutées sur un ensemble de valeurs de votre choix tout en segmentant sur celles-ci en même temps.
Exemples d'utilisation :
- Segmenter sur un ensemble précis de sites ou d'articles de e-commerce
- Appliquer une règle métier A à un sous-ensemble de données A avec une action aggregate A, et une règle métier B à un sous-ensemble de données B dans une action aggregate B.
Vous pouvez trouver la page de documentation produit actuelle sur la segmentation, détaillant le comportement et les spécifications de la fonctionnalité sur cette page.
Prérequis
Avant d'utiliser ce type de segmentation, certains points doivent être vérifiés :
1. L'attribut var_name est-il indexé dans la table source ?
Si ce n'est pas le cas, la requête d'extraction sera bien plus lente.
2. Y a-t-il suffisamment de CPU sur les bases de données source et destination ?
- Gardez à l'esprit que les opérations
selectetinsertsont gourmandes en CPU. - Par exemple, si votre base de données ne dispose que d'1 CPU, il est probablement risqué de configurer 6 workers pour sélectionner et insérer simultanément dans l'instance du SGBD...
Règle générale : 1 CPU devrait être disponible pour chaque worker s'exécutant simultanément.
3. Éviter de générer trop de tâches dans une même stage.
Pour garantir de bonnes performances du Data Processing Engine (DPE), nous déconseillons d'avoir des stages avec plus de 500 tâches.
Ce n'est pas une limite stricte, mais des dégradations de performance peuvent être observées au-delà de 500 tâches. Pour réduire le nombre de tâches, vous pouvez définir une bucket size plus élevée, afin que chaque tâche traite davantage de valeurs (ce qui signifie moins de tâches au final).
Compatibilité
Cette option de segmentation n'est compatible qu'avec les actions et sources suivantes :
Comment utiliser ce type de segmentation ?
Voici un aperçu rapide comparant le mode visible et le mode JSON avancé.
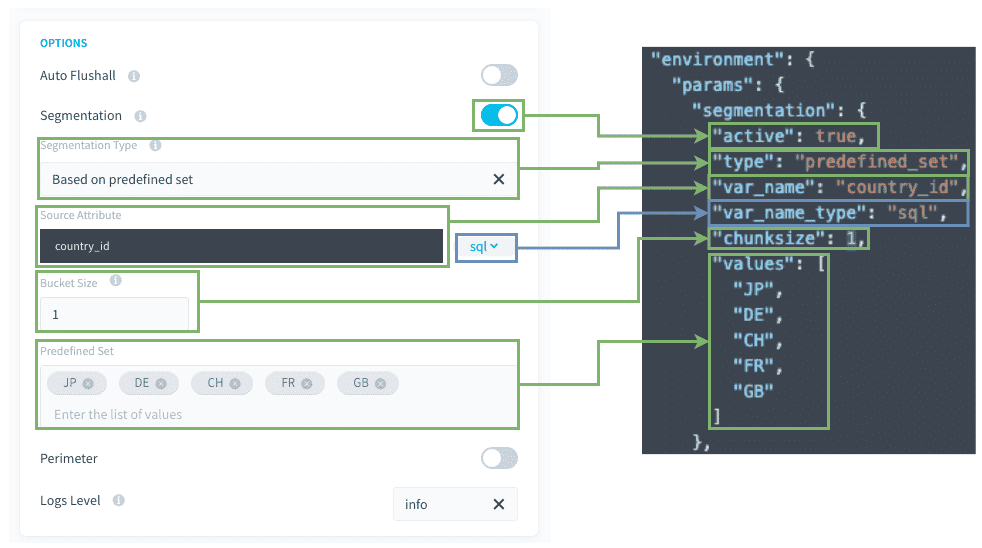
Attribut de la source / var_name : attribut SQL qui sera utilisé pour le filtrage de la source.
Bucket size / Chunksize : nombre de valeurs à filtrer pour chaque tâche.
Ensemble prédéfini / values : ensemble de valeurs codées en dur à filtrer.
Autres astuces
Vous pouvez utiliser des formules SQL
Pour segmentation.var_name (dans la dernière partie de l'attribut), vous pouvez utiliser des formules SQL, tant qu'elles sont compatibles avec votre SGBD. Notez que le SGBD peut évoluer avec le temps, vous devrez donc peut-être revérifier et corriger ces formules SQL si vous décidez de les utiliser.
Par exemple, vous pourriez avoir :
Comment cela fonctionne-t-il en coulisses ?
Ce mode de segmentation fonctionne de la même manière que la segmentation basée sur un attribut d'une table de Projet. La seule différence est que les valeurs sont déjà définies dans la configuration, plutôt qu'un attribut de table du Lakehouse Manager, il n'y a donc pas besoin de pré-stage.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.