
Jobs du Data Processing Engine
Chaque exécution laisse une trace que vous pouvez inspecter et régler.
Qu'est-ce qu'un job ?
Un job est une exécution unique d'une action ou d'un workflow. Chaque job porte son propre environnement d'exécution : les ressources qui lui sont allouées, ses paramètres de segmentation et de périmètre, et ses variables d'environnement. Ceux-ci proviennent des préférences de l'action ou du workflow, ou d'un environnement partagé.
Le Data Processing Engine est basé sur des jobs. Lorsqu'une exécution est déclenchée, la platform construit un conteneur correspondant à l'environnement défini, l'exécute, puis l'arrête, de sorte que les ressources ne sont consommées que pour la durée de l'exécution.
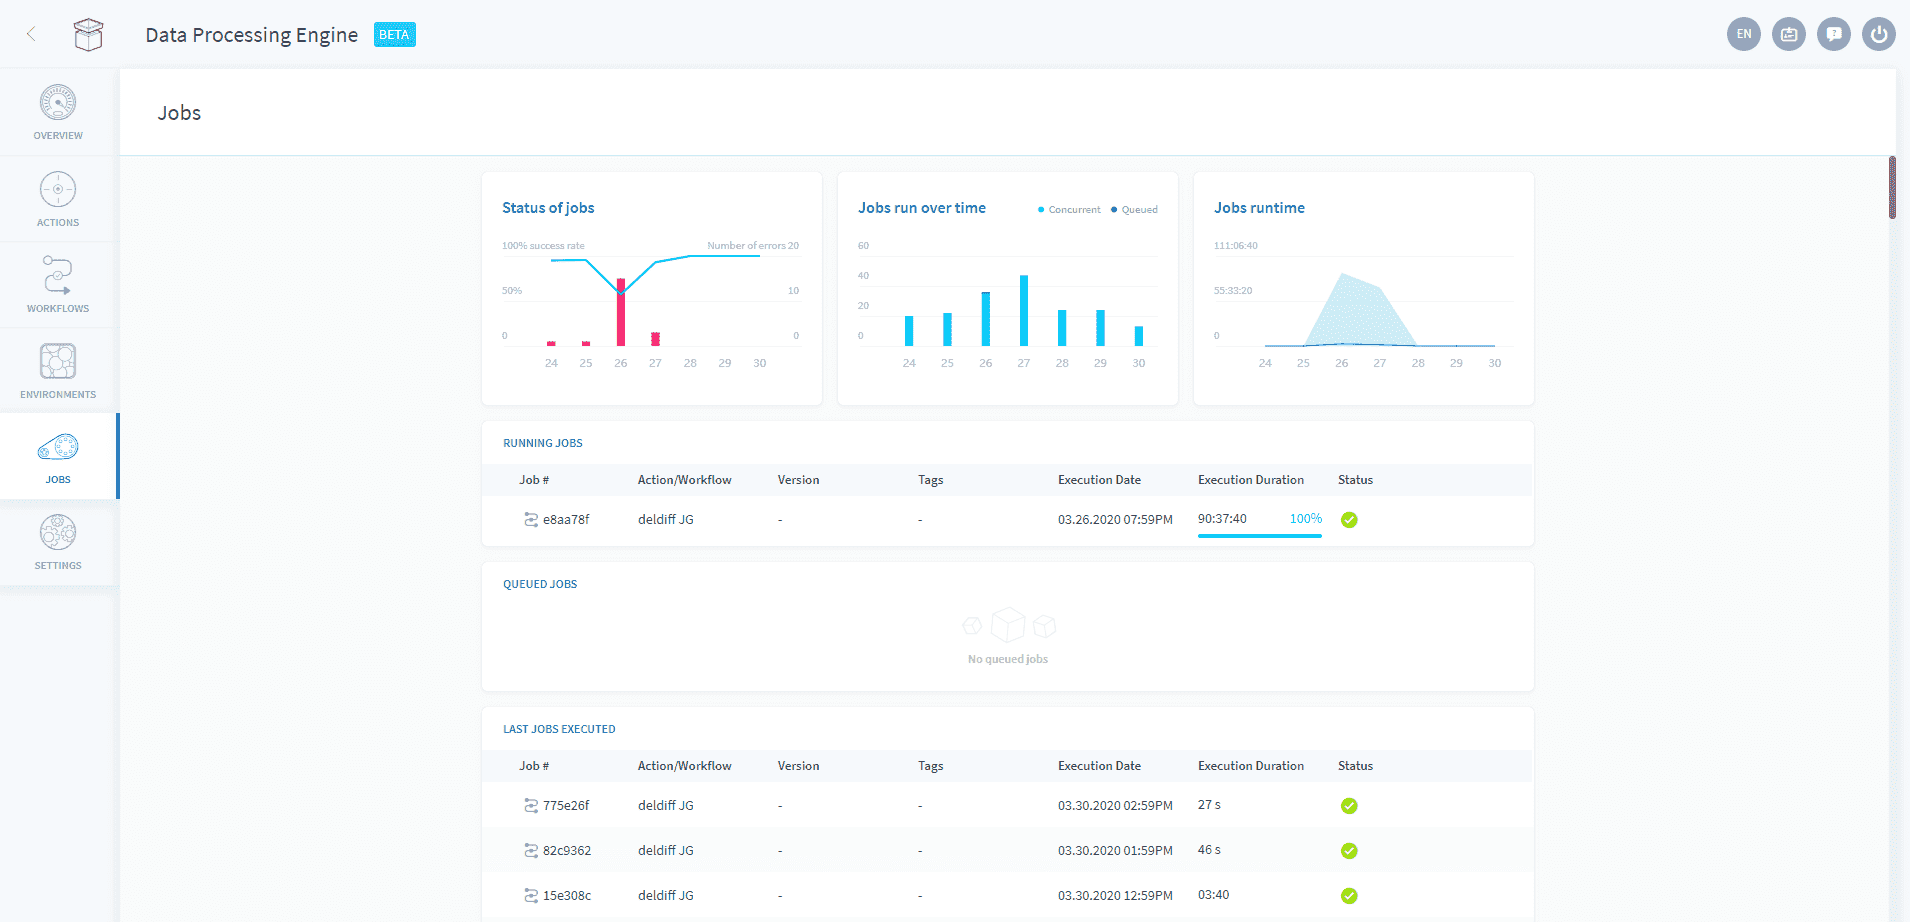
L'écran des Jobs affiche trois états.
Les jobs Running diffusent leurs logs en direct, et le nombre pouvant s'exécuter simultanément est plafonné par les quotas du projet.
Les jobs Queued sont des exécutions mises en file au-delà de ce plafond. La mise en file est désactivée par défaut et débloquée sur demande via le support. Les jobs en file démarrent dans l'ordre affiché à l'écran, de haut en bas, à mesure que chaque job en cours se termine.
Les jobs Finished conservent 30 jours d'historique, chacun avec des statistiques CPU et RAM par exécution, et un résultat de succès, d'échec, ou d'interruption manuelle. Un job qui dépasse son timeout est signalé comme tel, pour le distinguer des autres échecs. Les exécutions des actions PySpark, et des workflows qui les contiennent, s'ouvrent directement dans le Spark History Server.
La segmentation et le périmètre ont leur propre vocabulaire. Les deux références ci-dessous définissent les termes tels qu'ils apparaissent dans l'interface et en mode avancé.
Ressources→
Dimensionner un job verticalement, ou le répartir entre plusieurs workers.
Segmentation→
Diviser un job en tâches parallèles par date, valeur ou compte.
Périmètre→
Filtrer les données qu'un job traite avant son exécution.
Préférences d'exécution→
Timeouts, compte de service, stratégie d'écriture, déclencheurs et modes d'exécution.
Vocabulaire de segmentation et de périmètre
Vocabulaire de segmentation et de périmètre
Segments : Sous-ensemble d'une source de données. Les segments pour les sources en lignes / colonnes peuvent être définis à partir d'un nombre fixe de lignes, d'un attribut de la source (une date ou une valeur) ou d'un compte utilisateur (pour les sources basées sur des comptes).
Segmentation / Segmenter: Action de diviser une action DPE en plusieurs tâches qui traitent un ou plusieurs segments.
Valeurs de segmentation: Valeurs référencées utilisées pour diviser une action en tâches plus petites.
Type de segmentation: Nom technique en mode avancé : segmentationValues. Détermine le processus selon lequel la liste des valeurs de segmentation est récupérée.
Attribut source / (Variable de segmentation): Nom technique en mode avancé : segmentationVarName. Détermine quelle colonne de la source est utilisée pour appliquer le filtre aux valeurs de segmentation
Périmètre: Filtre la source d'une action DPE.
Type de périmètre: Nom technique en mode avancé : perimeterValues. Détermine comment la liste des valeurs de périmètre est récupérée.
Valeurs de périmètre: Liste des valeurs pour appliquer le périmètre.
Attribut source / (Variable de périmètre): Nom technique en mode avancé : perimeterVarName. Détermine quelle colonne de la source est utilisée pour appliquer le filtre aux valeurs de périmètre.
Taille de bucket: Nom technique en mode avancé : segmentationChunkSize. Le nombre de valeurs de segmentation que chaque tâche traite.
Détail de la taille de bucket
Détail de la taille de bucket
À tout moment, il est possible de regrouper certaines tâches en buckets (chunk) pour gérer plusieurs segments de la source de données. Lorsque la liste des segments (valeurs, date ou comptes de réseaux sociaux) est cohérente, cela évite de générer trop de tâches.
La taille de bucket définit combien de segments chaque tâche traite :
- Si vous définissez la taille de bucket à 2, chaque tâche traitera 2 segments
- Si vous définissez la taille de bucket à 10, chaque tâche traitera 10 segments
- Etc.
Vous trouverez ci-dessous une illustration de l'impact de définir la taille de bucket à 30 par rapport à une taille de bucket de 1. Supposons que nous exécutions la segmentation sur la base de la date du workflow qui s'exécute du 1er janvier 2018 au 31 décembre 2019.
| sans Segmentation Chunk Size | avec Segmentation Chunk Size |
|---|---|
| ChunkSize = 1 | ChunkSize = 30 |
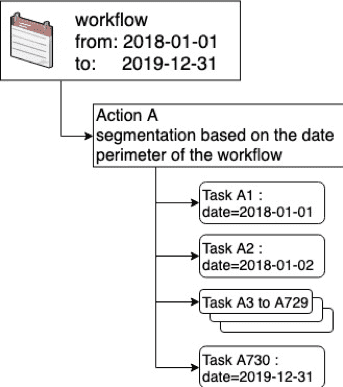 | 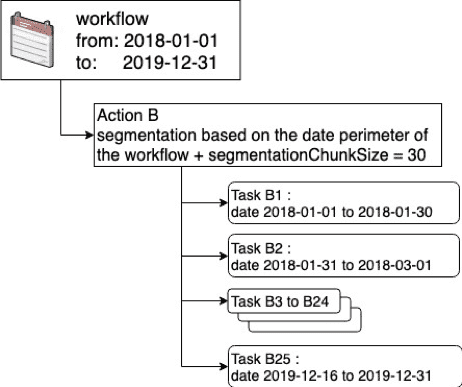 |
Dans le premier cas, l'action DPE sera divisée en 730 tâches (365 x 2), une pour chaque jour sur 2 ans. Dans le second cas, la taille de bucket est fixée à 30, auquel cas l'action DPE ne sera divisée qu'en 25 tâches (365 x 2 / 30) puisque chaque tâche traite 30 jours.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.