
Gérer les attributs de table dans le Lakehouse Manager
La page Attributes regroupe tous les attributs de votre lakehouse Manager par noms d'attribut uniques
Objectif
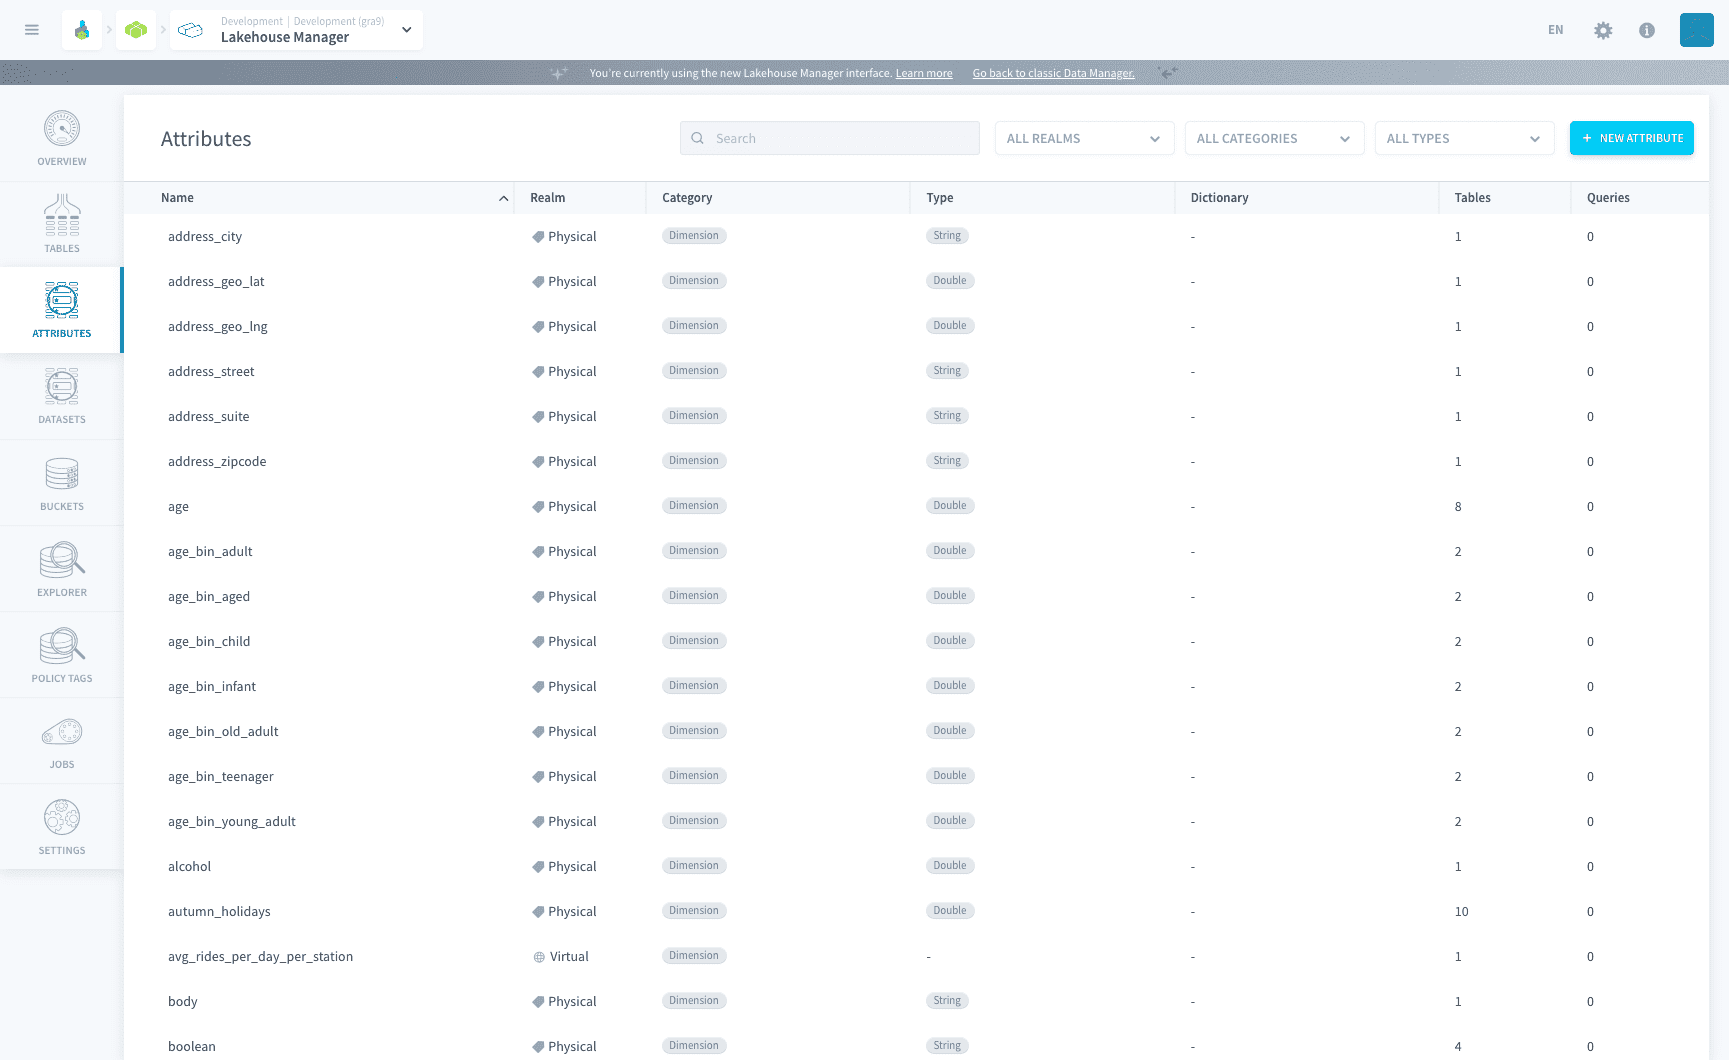
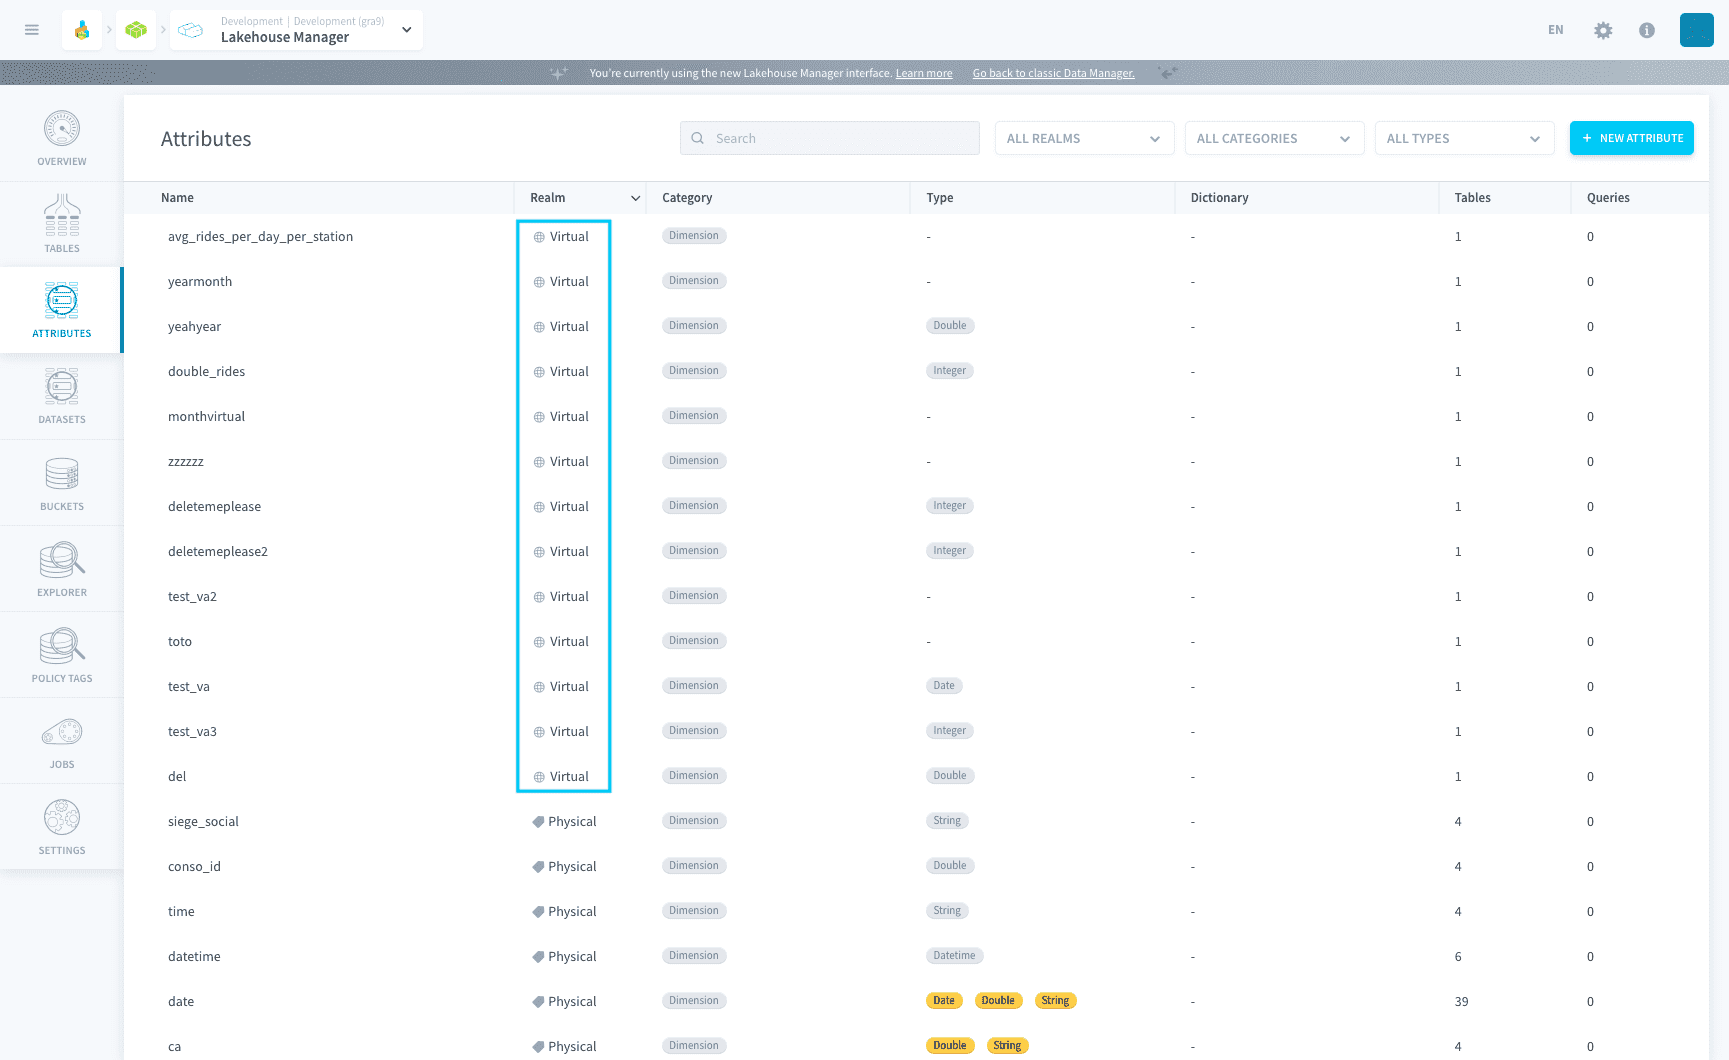
La page Attributes regroupe tous les attributs de votre lakehouse Manager par noms d'attribut uniques. Chacun de ces attributs fait partie d'un domaine : physical ou virtual.
Attributs physiques
Les attributs physiques sont les attributs physiquement stockés dans les tables du Lakehouse Manager. Vous pouvez éditer leur catégorie, leur type et d'autres informations au niveau de la table.
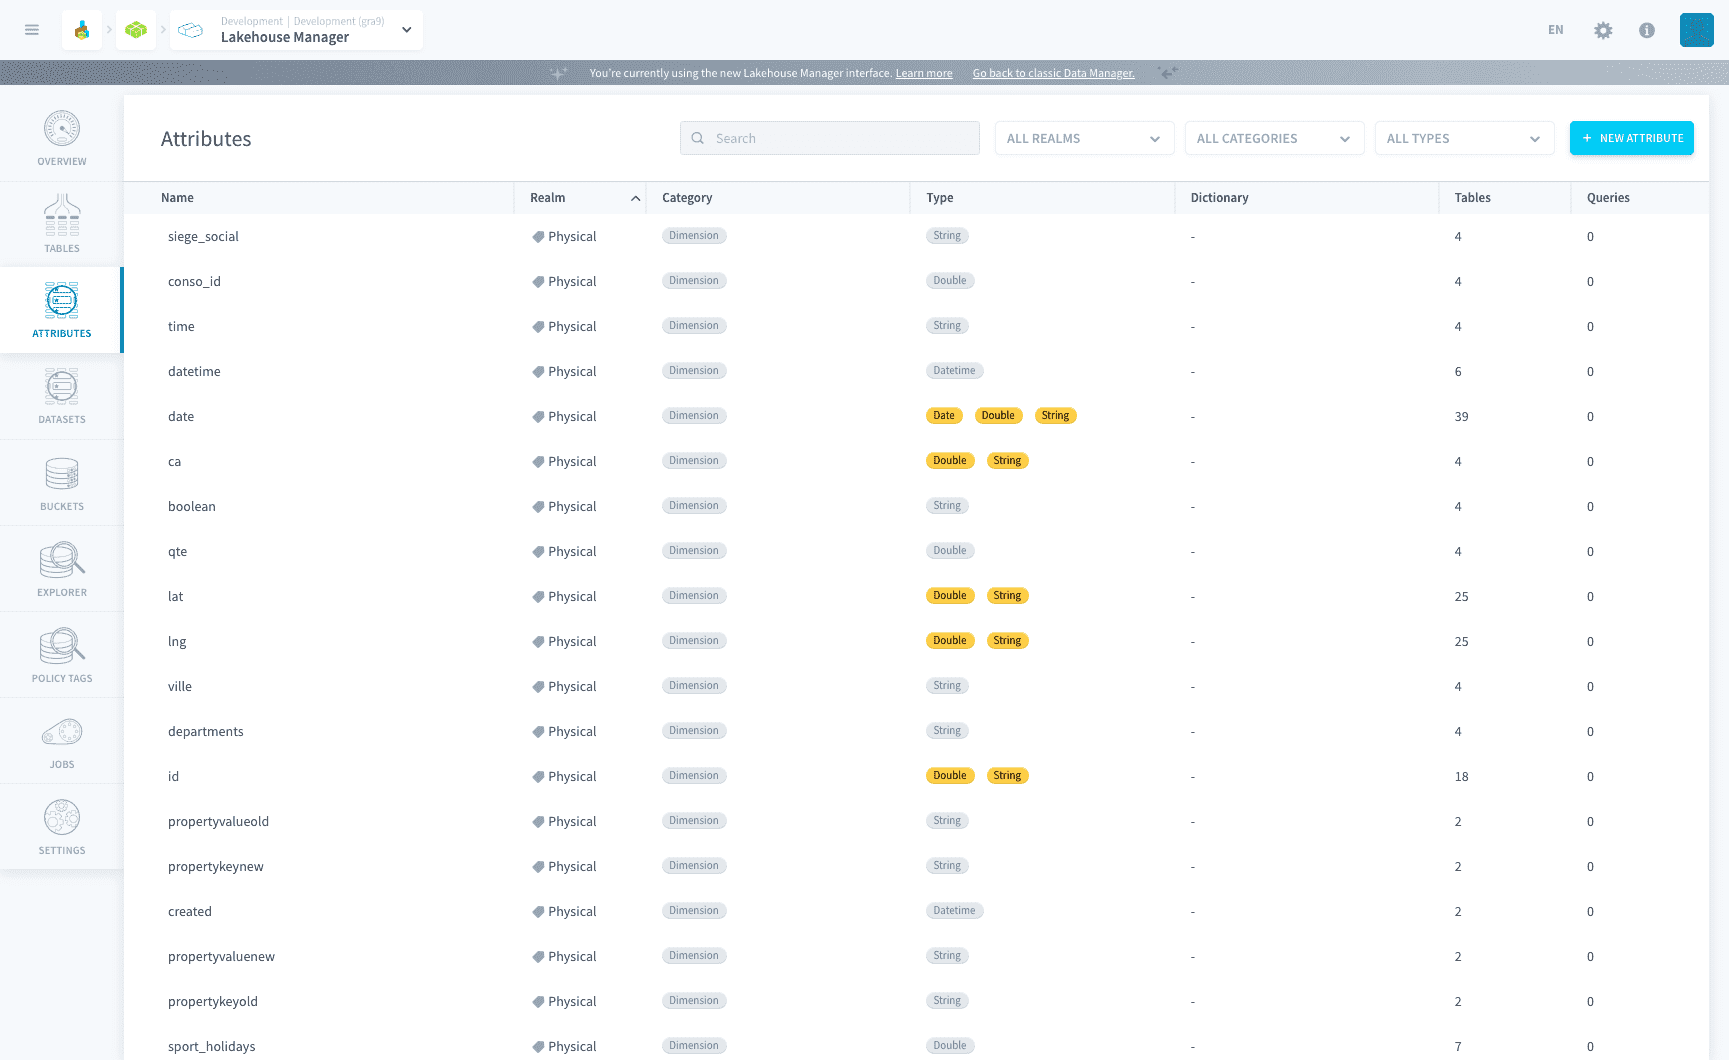
Ils sont regroupés par nom sur la page Attributes, ce qui vous permet d'observer d'un coup d'œil les différentes catégories et types que prend chaque attribut à travers tout votre data warehouse / data lake.
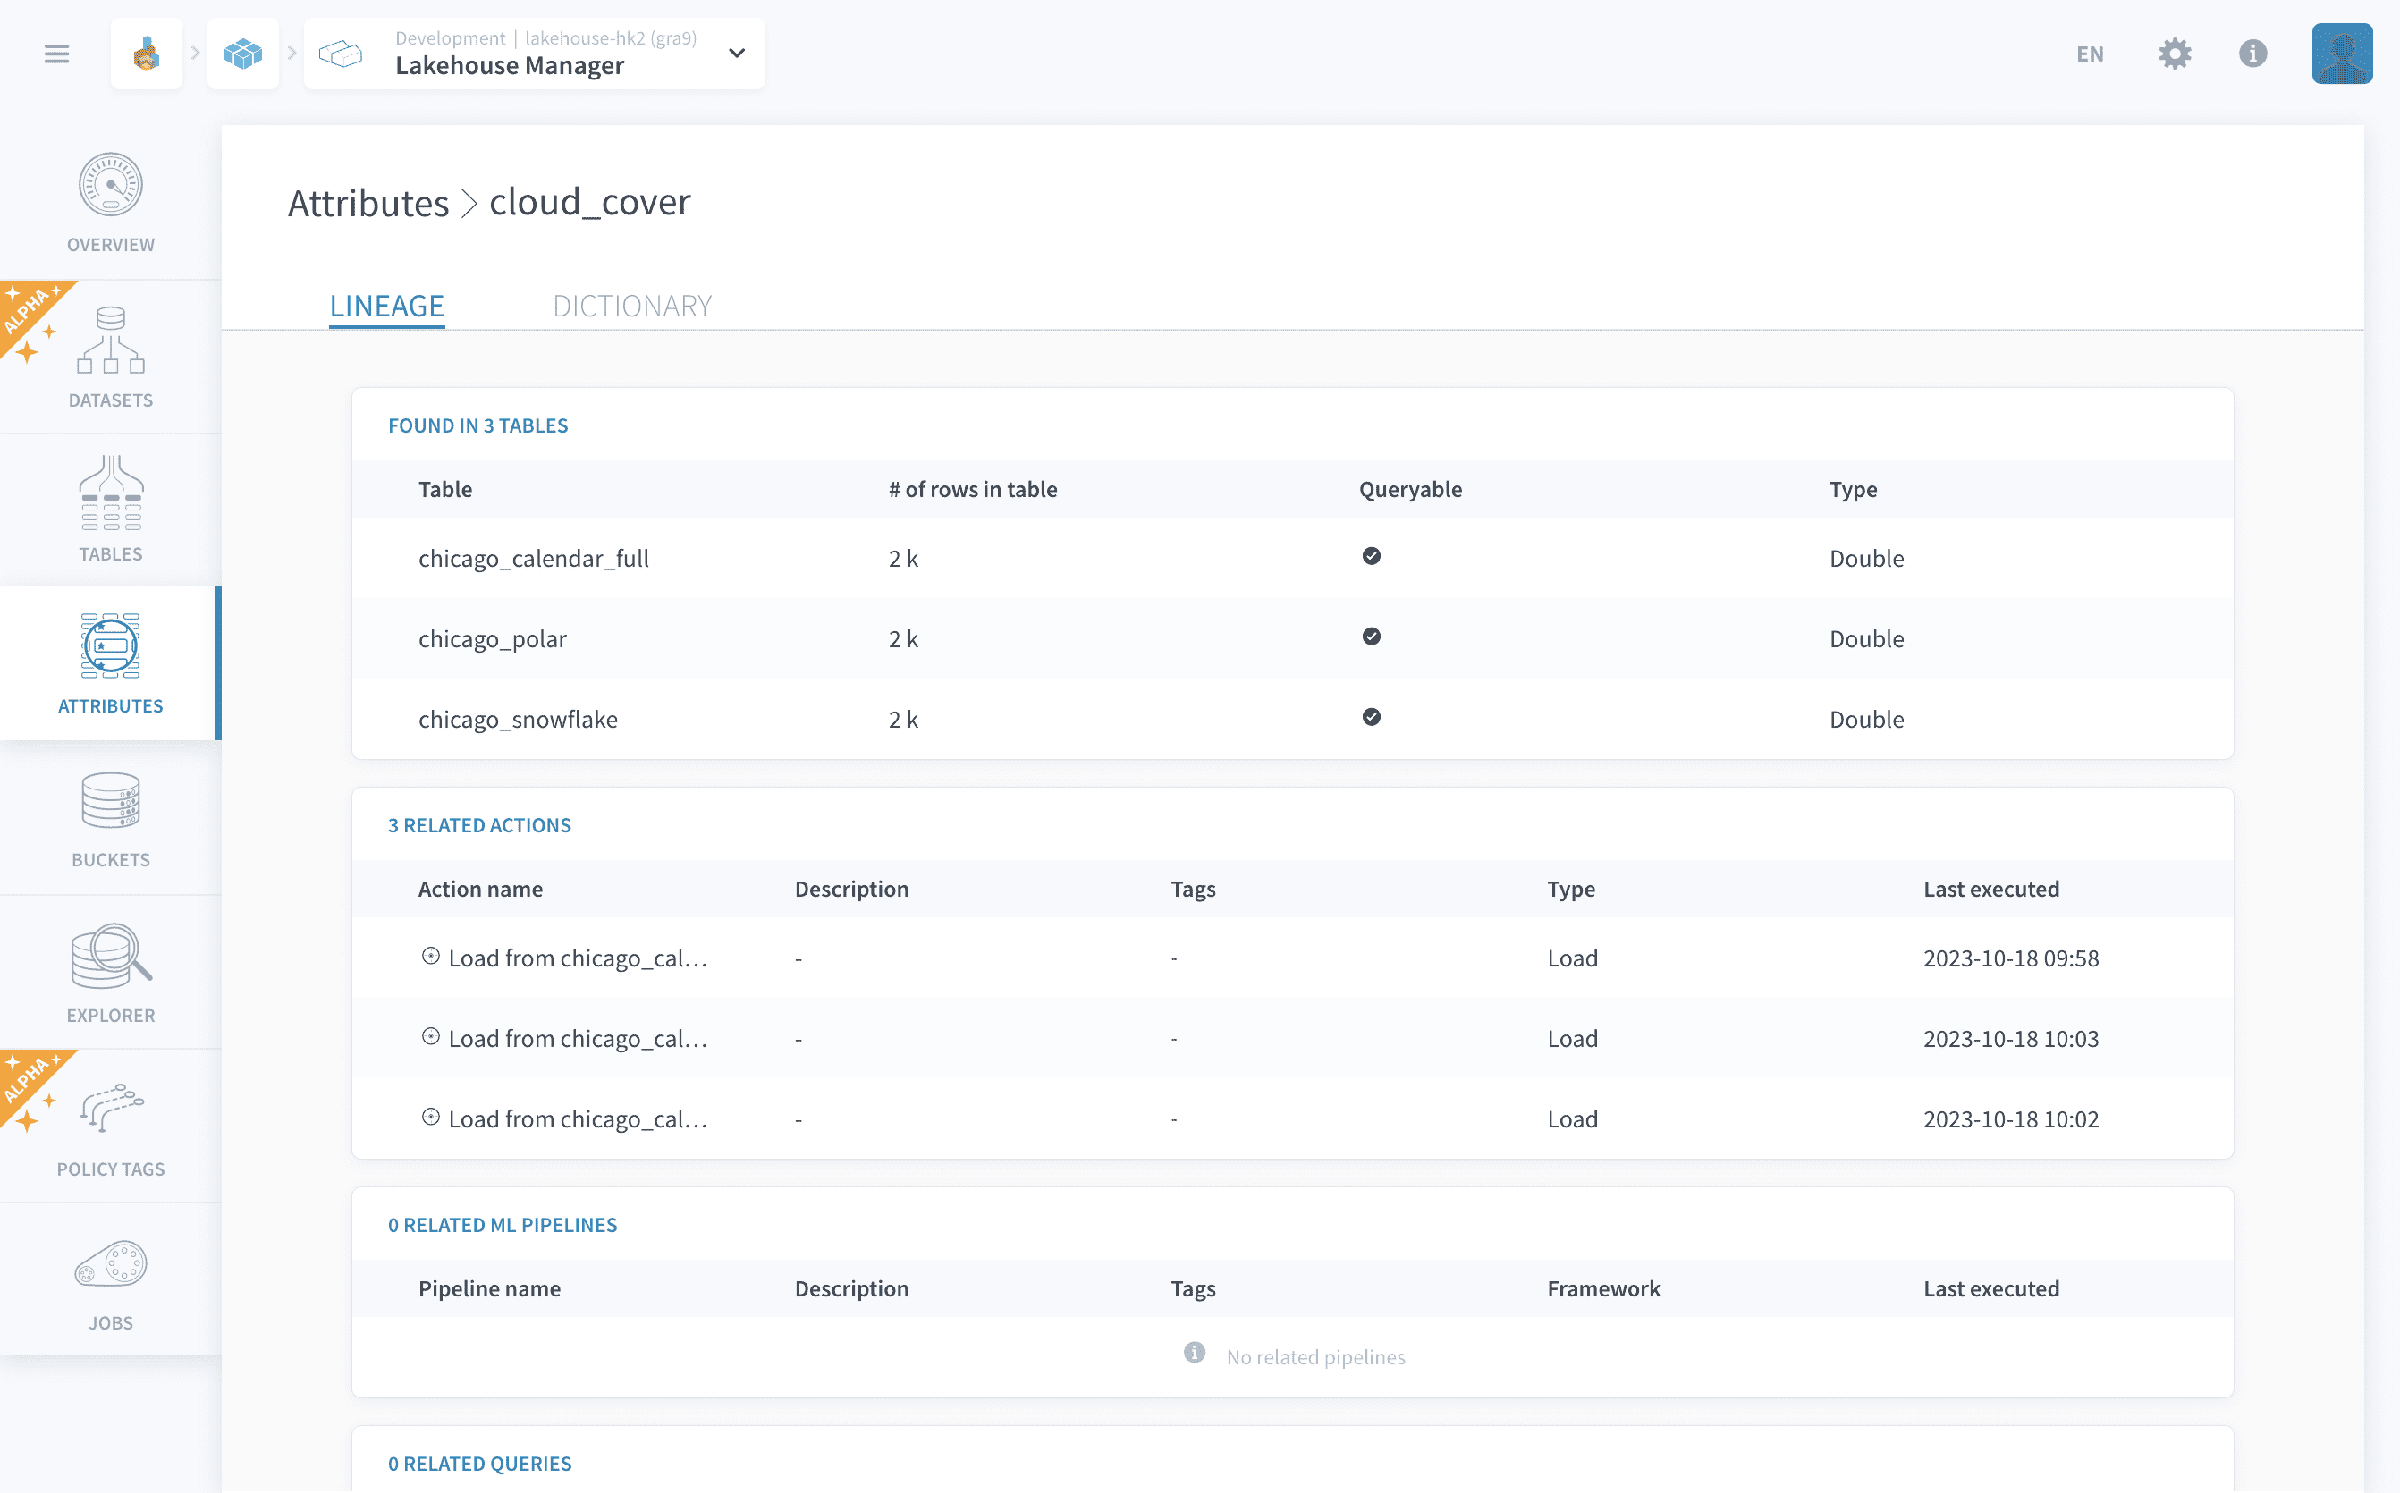
Chaque attribut peut être déplié afin d'obtenir le lineage complet sur les objets de votre Projet qui utilisent cet attribut :
Certains attributs peuvent être une clé pour un dictionnaire. Dans ce cas, un autre attribut est utilisé comme label pour cet attribut, afin d'être automatiquement affiché dans les applications à la place de la clé.
Les labels peuvent être définis au niveau d'une table (contenant la clé du dictionnaire comme clé primaire) dans l'écran Tables.
Types d'attributs pris en charge
Les attributs prennent en charge les types primitifs suivants :
integer, bigint, float, real, double, decimal, varchar, boolean, timestamp, date.
Il n'existe pas de type GEOMETRY natif, et les structures complexes ou imbriquées ne sont pas stockées nativement. Les patterns ci-dessous couvrent les besoins les plus courants en attendant.
Les types métier personnalisés avec validation native dans le schéma (SIRET, IBAN, coordonnées GPS) ne sont pas pris en charge. Stockez un SIRET ou un IBAN en tant que varchar, sans validation au niveau du schéma.
Travailler avec des données non structurées ou complexes
Documents (PDF, Word, ...)
- Stockez le fichier brut dans un bucket.
- Extrayez son contenu dans une action Custom (Python, avec des bibliothèques telles que
pypdfoupython-docxinstallées via Python Requirements). - Écrivez les métadonnées et le texte extrait dans une table afin qu'il puisse être interrogé.
Objets géographiques
Il n'existe aujourd'hui aucun chemin natif. Deux options :
- Stockez la géométrie en tant que texte WKT dans un attribute
varchar, ou en WKB dans un attributeVARBINARY. - Exécutez les calculs spatiaux en dehors du schéma, avec Apache Sedona (ajouté comme dépendance Git dans une action Custom PySpark) ou avec
geopandas/shapelydans un Notebook.
Trino expose les fonctions spatiales standard (ST_*) lorsque la version déployée les inclut. Vérifiez la disponibilité pour votre projet avant de vous y fier dans une requête.
JSON semi-structuré
- Utilisez un champ
ROW/MAPdans Iceberg lorsque le schéma est stable. - Utilisez un attribute
varcharassocié aux fonctionsjson_*de Trino (json_extract,json_parse) lorsque le schéma varie.
Recherche full-text / vectorielle
Il n'existe aucun chemin natif. Le pattern recommandé consiste à exporter vers un service externe (un Elasticsearch managé, une base de données vectorielle) via une action Custom en sortie.
Un moteur de stockage PostgreSQL est sur la feuille de route et sera, à terme, la meilleure réponse pour les données géographiques via PostGIS.
Contraintes
Un attribut physique peut porter des contraintes qui sont appliquées à la table lorsqu'elle est construite :
- Required : le champ ne peut jamais contenir NULL.
- Required + Identifier : le champ est requis et utilisé pour définir l'unicité d'une ligne pour les opérations d'upsert. Un champ identifiant ne peut pas être un
doubleou undecimal.
Vous définissez ces contraintes lors de l'ajout ou de l'édition d'un attribut sur une table.
Les contraintes s'appliquent uniquement aux attributs physiques. Les attributs virtuels ne peuvent pas être Required ou Identifier.
Conventions de nommage
Les noms d'attribut sont uniques par table, mais la platform les agrège par nom au niveau du Projet sur la page Attributes. Ceci est utile pour repérer les incohérences, par exemple le même attribute code typé en integer dans une table et en bigint dans une autre, mais cela ne les empêche pas.
Les règles générales de nommage et la liste des mots réservés s'appliquent aux attributs comme aux tables : consultez Conventions de nommage et Mots réservés sur la page Tables.
VALUE figure dans la liste des mots réservés. Préférez plutôt amount, metric_value ou entity_value.
Gérer les attributs homonymes
Lorsque des attributs tels que code, libelle ou value proviennent de sources différentes avec des types différents, appliquez les pratiques suivantes :
- Préfixez par domaine ou par source. Utilisez
clt_code,clt_libelle,clt_valuepour les clients,prd_code,prd_libellepour les produits,cmd_codepour les commandes, etc. Un préfixe transformecodeenentity_codeet supprime toute ambiguïté, à la fois à la lecture et dans les formules à détection automatique. - Si le renommage n'est pas possible, harmonisez le type entre les tables. Choisissez le type le plus large (
decimaloubigint) et faites unCASTau moment de l'INSERTdans les tables sources. Cela supprime au moins l'incohérence de type sur la page Attributes. - Documentez avec des tags et une description pour distinguer les usages lorsqu'un nom est ambigu.
- Réservez les noms génériques courts (
code,libelle,value,id,name,status) à un usage transversal, ou évitez-les complètement.
Documenter les attributs partagés : le dictionnaire de données
La Data Platform ne propose pas de catalogue de données externe complet, mais plusieurs mécanismes intégrés agissent déjà comme un dictionnaire de données fonctionnel :
- La page Attributes. Une entrée par nom d'attribut à travers tout le Projet, une répartition des types et catégories qu'il prend à travers les tables (idéal pour repérer
codeenintegervsbigintvsdecimal), et le lineage complet sur les objets qui le consomment, comme décrit ci-dessus. - Les Policy tags. Bien que les policy tags aient été conçus pour le contrôle d'accès, ils peuvent également être réutilisés pour catégoriser vos données :
domain: finance,sensitivity: high,pii: true,glossary_term: client_id. Les policy tags sont hérités du dataset vers la table puis vers l'attribute, un tag défini sur un dataset s'applique donc à tout attribute non tagué en dessous. Cela vous permet de définir une base et de la surcharger si nécessaire. - Les Dictionnaires. Le mécanisme de dictionnaire (clé → label) décrit ci-dessus gère les tables de référence code → label.
Les descriptions enrichies par attribut, un glossaire métier, la gestion de la propriété (ownership), et l'intégration avec un catalogue externe (Collibra, DataHub) ne sont pas disponibles. Pour ces besoins, un outil externe complémentaire reste nécessaire.
Attributs virtuels
Les attributs virtuels sont utilisés pour calculer de nouvelles formules sur vos données. Ils ne sont pas stockés dans la base de données mais sont calculés à la volée pour une requête ou un tableau de bord/graphique de restitution.
Formule d'attribut virtuel
L'élément le plus important d'un attribut virtuel est sa définition SQL.
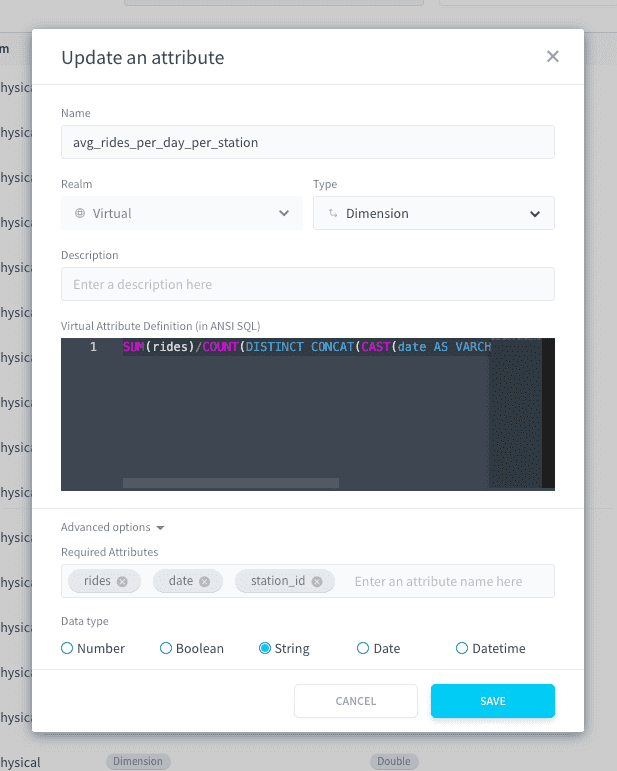
Écrivez une formule contenant une combinaison de mots-clés SQL et d'attributs physiques.
La formule doit être écrite en utilisant une syntaxe SQL conforme à ANSI pour garantir la portabilité de votre Projet. La syntaxe spécifique à un moteur n'est pas prise en charge par la Data Platform.
Exemple de formule d'attribut virtuel
SUM(rides)/COUNT(DISTINCT CONCAT(CAST(date AS VARCHAR), CAST(station_id AS VARCHAR)))
Ici, rides, date, et station_id sont des attributs physiques provenant d'une table du Lakehouse Manager. La Platform les détectera automatiquement, ainsi que la table la plus pertinente à interroger (si elle n'est pas explicitement définie dans votre formule).
Options des attributs virtuels
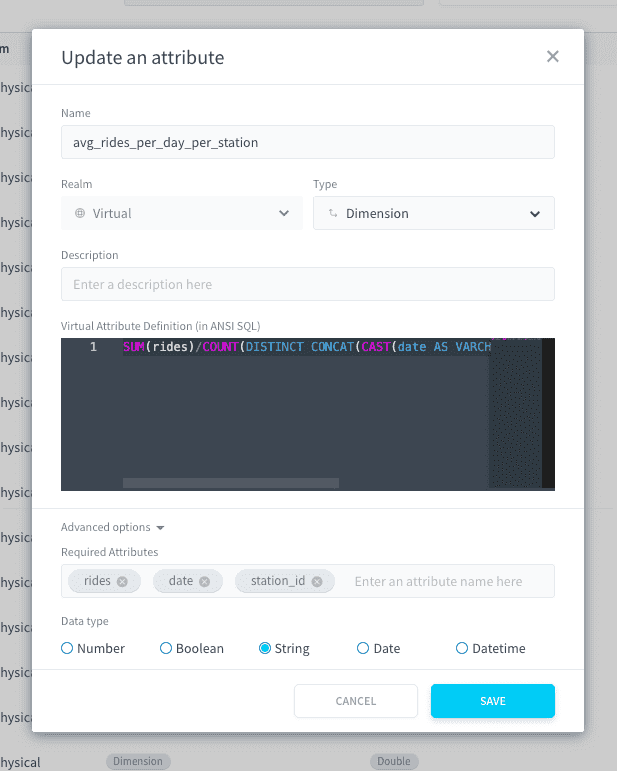
Attributs requis
la platform détecte automatiquement les attributs physiques nécessaires à l'exécution de la formule de l'attribut virtuel.
Vous pouvez les éditer dans les options avancées de l'attribut virtuel. Les raisons d'éditer le type incluent (sans s'y limiter) : un attribut physique dans la formule est détecté comme un mot-clé SQL au lieu d'un attribut requis, ou l'inverse.
Type
Le type de l'attribut virtuel est automatiquement déduit lors de sa création. Ce type permet à la platform d'automatiser la planification des requêtes qui utilisent l'attribut virtuel.
Vous pouvez l'éditer dans les options avancées de l'attribut virtuel. Les raisons d'éditer le type incluent (sans s'y limiter) : des valeurs de filtre basées sur un attribut virtuel sont automatiquement converties vers un autre type, faisant échouer les requêtes résultantes dans l'Analytics Manager.
Aller plus loin
Si vous avez besoin d'une formation ou d'une assistance technique pour la mise en oeuvre de nos solutions, contactez votre commercial ou cliquez sur ce lien pour obtenir un devis et demander une analyse personnalisée de votre projet à nos experts de l’équipe Professional Services.
Posez vos questions, faites-nous part de vos commentaires et interagissez directement avec l’équipe qui développe la Data Platform sur le canal Discord dédié.
Si vous avez besoin d'une assistance concernant vos services OVHcloud, créez une demande depuis notre centre d'aide.
Rejoignez notre communauté d'utilisateurs.