AI Training - Tutoriel - Fine-tuner Olala Mini 7A1B avec LoRA
Fine-tunez Olala Mini 7A1B avec LoRA sur votre propre jeu de données grâce à AI Training et une image Docker prête à l'emploi, avec la traduction anglais↔français comme exemple
Objectif
Ce tutoriel vous montre comment fine-tuner Olala Mini 7A1B sur votre propre cas d'usage avec AI Training, à l'aide d'une image Docker prête à l'emploi. Vous n'avez besoin d'écrire aucun code ni de construire aucune image : il vous suffit de créer 2 buckets Object Storage et de lancer un job.
Le tutoriel prend comme exemple complet la traduction anglais↔français, avec des jeux de données ouverts que le job télécharge lui-même : vous pouvez le lancer tel quel pour découvrir le fonctionnement et vérifier les résultats. La traduction n'est qu'un exemple : vous pouvez ensuite fine-tuner le modèle sur vos propres données et votre propre tâche, par exemple répondre à des questions sur vos produits, classer des tickets de support ou rédiger dans le style de votre entreprise (consultez la section « Utiliser votre propre jeu de données »).
Le job utilise LoRA (Low-Rank Adaptation) : au lieu de réentraîner tout le modèle, il entraîne de petites matrices d'adaptation, ce qui est rapide et tient sur un seul GPU. Dans l'exemple de traduction, il adapte le modèle au domaine de la banque centrale et de la finance avec le corpus OPUS ECB, des phrases issues des publications de la Banque centrale européenne traduites en français par des professionnels. Vous pouvez aussi utiliser le jeu de données généraliste OPUS-100.
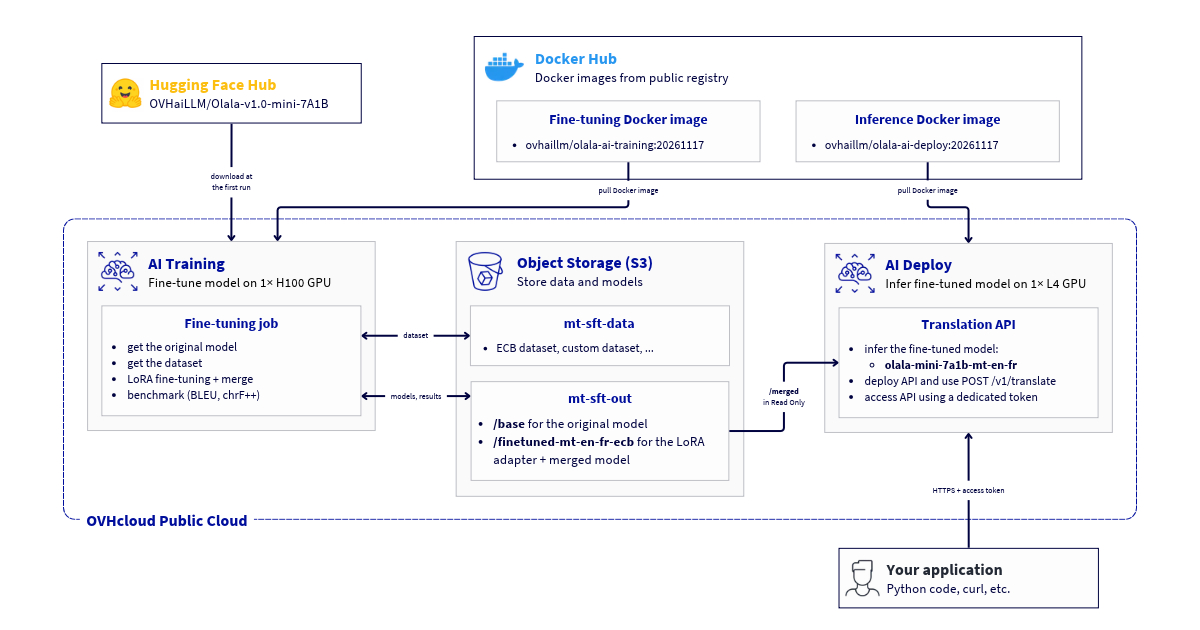
Avec l'exemple de traduction, le job exécute seul l'ensemble du pipeline :
- lors de la première exécution, il télécharge le modèle de base Olala Mini 7A1B depuis Hugging Face dans votre bucket de modèles ;
- il télécharge et prépare le jeu de données dans votre bucket de données : il récupère le corpus ouvert depuis OPUS ou Hugging Face, filtre les paires bruitées, en conserve un sous-ensemble (4 000 paires d'entraînement et 400 paires d'évaluation pour ECB, 2 000 et 200 pour OPUS-100) et l'écrit sous forme de fichiers JSON Lines ;
- il mesure la qualité de traduction du modèle de base (scores BLEU et chrF++) ;
- il fine-tune le modèle avec LoRA ;
- il fusionne l'adaptateur dans un modèle complet ;
- il mesure la qualité du modèle fine-tuné et compare les deux scores.
L'ensemble du workflow, du fine-tuning avec AI Training au déploiement avec AI Deploy :
Prérequis
- Un projet Public Cloud créé.
- La CLI ovhai installée sur votre système (ce guide explique comment l'installer).
- L'accès aux GPU H100 dans votre projet : l'image utilise FlashAttention-3, qui nécessite un GPU Hopper. Les GPU H100 sont disponibles dans la région GRA.
- Si vous souhaitez utiliser votre propre jeu de données : un fichier d'entraînement et, en option, un fichier d'évaluation au format JSON Lines (consultez la section « Utiliser votre propre jeu de données »).
En pratique
Créer les buckets Object Storage
Le job lit et écrit ses données dans 2 buckets Object Storage, montés comme volumes :
- mt-sft-data : le jeu de données. Lors de la première exécution, le job y télécharge le jeu de données ouvert. Les jobs suivants le réutilisent sans le télécharger à nouveau.
- mt-sft-out : les modèles, le modèle de base et les modèles fine-tunés, chacun dans son propre dossier :
base/: le modèle de base Olala Mini 7A1B. Lors de la première exécution, le job le télécharge depuis Hugging Face dans ce dossier. Les jobs suivants le réutilisent sans le télécharger à nouveau.- un dossier par entraînement, par exemple
finetuned-mt-en-fr-ecb/: les résultats du job, c'est-à-dire l'adaptateur LoRA, le modèle fine-tuné, les checkpoints et les scores de benchmark.
Chaque job ne monte que deux dossiers de mt-sft-out (le modèle de base et ses propres résultats) : il ne télécharge donc pas les modèles de vos autres entraînements.
Les deux buckets sont des buckets Object Storage compatibles S31 dans la région GRA (la même région que le job). Le guide « Conformité entre les produits AI et Object Storage compatible S3 » explique en détail comment les créer, comment donner à AI Training l'accès à ces buckets et comment les monter dans un job.
Créer vos buckets via la CLI ovhai
Pour suivre cette partie, assurez-vous d'avoir installé la CLI ovhai sur votre ordinateur ou sur une instance.
Commencez par déclarer votre Object Storage S3 de la région GRA comme datastore. Utilisez les identifiants S3 (access key et secret key) d'un utilisateur disposant des rôles AI Operator et ObjectStore operator, disponibles dans Object Storage > Utilisateurs. Remplacez <ALIAS> par le nom que vous choisissez pour ce datastore, par exemple s3-gra :
Créez ensuite les deux buckets dans ce datastore :
Dans toutes les commandes de ce tutoriel, remplacez <ALIAS> par l'alias de votre datastore.
Lancer le job AI Training
L'image contient le code d'entraînement et toutes ses dépendances. Le modèle Olala Mini 7A1B n'est pas dans l'image : le job le télécharge depuis Hugging Face dans le dossier base/ de votre bucket mt-sft-out lors de la première exécution. Il s'exécute sur un GPU H100 : si plusieurs GPU sont attachés au job, seul le premier est utilisé.
Par défaut, le job fine-tune le modèle sur 4 000 paires de phrases ECB (moitié anglais→français, moitié français→anglais) pendant 2 epochs, et évalue le modèle sur 400 paires mises de côté, avant et après l'entraînement.
Créer votre job d'entraînement via la CLI ovhai
Pour suivre cette partie, assurez-vous d'avoir installé la CLI ovhai sur votre ordinateur ou sur une instance.
--flavor h100-1-gpu --gpu 1demande un GPU H100.--volume mt-sft-out@<ALIAS>/base:/workspace/model:RWmonte le dossierbase/du bucket de modèles, qui contient le modèle de base. Il doit être accessible en écriture (RW) pour que le job puisse y enregistrer le modèle téléchargé.--volume mt-sft-data@<ALIAS>/:/workspace/data:RWmonte le bucket de données. Il doit être accessible en écriture (RW) pour que le job puisse y enregistrer le jeu de données téléchargé.--volume mt-sft-out@<ALIAS>/finetuned-mt-en-fr-ecb:/workspace/out:RWmonte le dossierfinetuned-mt-en-fr-ecb/du même bucket, où le job écrit ses résultats. Utilisez un dossier différent pour chaque entraînement, et jamaisbase.- Les options
--envsont réglées sur leurs valeurs par défaut : vous pouvez les retirer et obtenir le même job. Elles sont décrites dans la section « Personnaliser le fine-tuning ».
Pour vérifier que tout fonctionne avant un entraînement complet, vous pouvez lancer un job court : il évalue 50 phrases au lieu de 400 et ne s'entraîne que pendant 20 steps.
Suivre l'entraînement
Vous pouvez suivre la progression du job dans ses logs :
Les logs affichent le téléchargement du modèle (première exécution uniquement), la préparation du jeu de données, les scores du modèle de base, la loss d'entraînement tous les 10 steps, la loss d'évaluation tous les 50 steps, et enfin le tableau comparatif :
Les premiers steps sont plus lents : lors de la première utilisation, les kernels du modèle sont compilés pour le GPU.
Le job enregistre un checkpoint tous les 250 steps (125 avec OPUS-100). S'il est interrompu puis relancé avec le même dossier mt-sft-out, il reprend à partir du dernier checkpoint et n'évalue pas à nouveau le modèle de base.
Récupérer le modèle fine-tuné
Lorsque le job est à l'état DONE, ses résultats sont synchronisés dans son dossier du bucket mt-sft-out, ici finetuned-mt-en-fr-ecb/ :
Vous pouvez les télécharger avec la CLI ovhai :
Les résultats sont envoyés dans le bucket à la fin du job. Pour les récupérer pendant que le job est encore en cours, utilisez ovhai job push-data <job_id>.
Pour interroger votre modèle fine-tuné via une API, déployez-le depuis le bucket avec AI Deploy : consultez le guide « AI Deploy - Tutoriel - Déployer un modèle Olala Mini 7A1B fine-tuné ».
Personnaliser le fine-tuning
Vous pouvez modifier le comportement du job avec des variables d'environnement, définies avec --env dans la CLI ovhai. Les options activé/désactivé prennent la valeur 1 (oui, activé) ou 0 (non, désactivé) :
Par exemple, pour fine-tuner le modèle sur le jeu de données généraliste OPUS-100 au lieu d'ECB :
DATASET sélectionne aussi les paramètres d'entraînement adaptés au jeu de données (pour OPUS-100 : learning rate 1e-4, checkpoint tous les 125 steps).
Vous pouvez également remplacer les paramètres d'entraînement en les ajoutant après la commande, sous la forme key=value :
Utilisez un dossier de sortie différent (ici mt-sft-out@<ALIAS>/finetuned-mt-en-fr-ecb-r16) pour chaque nouvelle configuration. Sinon, le job reprend à partir des checkpoints de l'entraînement précédent.
Utiliser votre propre jeu de données
L'exemple de traduction n'est qu'un point de départ : le job peut fine-tuner le modèle sur toute tâche que vous pouvez écrire sous forme de conversation, dans laquelle le modèle apprend à donner la réponse attendue à une demande. Pour utiliser vos propres données, préparez un fichier d'entraînement et, en option, un fichier d'évaluation, envoyez-les dans un bucket et indiquez DOWNLOAD_DATA=0.
Comprendre le format des fichiers
Les fichiers sont au format JSON Lines : un objet JSON par ligne, chacun étant un exemple complet. Chaque ligne contient une liste messages, avec un message par rôle :
Le champ optionnel chat_template_kwargs avec {"reasoning_effort": "disabled"} désactive l'étape de raisonnement du modèle : le modèle répond directement, ce qui convient aux réponses courtes et directes.
Par exemple, une ligne d'un fichier d'entraînement destiné à classer les messages des clients d'une boutique en ligne :
Le fichier d'évaluation utilise le même format, avec des exemples absents du fichier d'entraînement : le job l'utilise pour calculer la loss d'évaluation pendant l'entraînement. Quelques centaines d'exemples suffisent.
Exemple avec le format de traduction
L'exemple de traduction de ce tutoriel utilise ce format avec un prompt système fixe et une demande de traduction écrite sous forme d'objet JSON dans le message user. Si votre cas d'usage est la traduction anglais↔français, utilisez le même format : le job peut alors aussi évaluer votre modèle (scores BLEU et chrF++).
Les fichiers préparés par le job à partir des jeux de données ouverts restent dans votre bucket mt-sft-data (ecb_enfr_train.jsonl, ecb_enfr_eval.jsonl, et opus100_enfr_*.jsonl si vous avez utilisé OPUS-100). Téléchargez l'un d'eux pour voir des exemples complets :
La demande de traduction contient les champs suivants :
Voici une ligne complète, un exemple anglais→français avec un terme dans le mapping terminologique :
Pour entraîner le modèle dans les deux sens, incluez des exemples anglais→français et français→anglais, par exemple en les alternant. Copiez le prompt système exactement comme dans cette ligne, indiquez dans domain le domaine de vos textes et remplissez terminology_mapping avec les termes du glossaire présents dans la phrase source (ou laissez-le vide).
Les jeux de données ouverts que le job prépare (ECB et OPUS-100) ne contiennent aucun exemple de terminologie : un modèle fine-tuné uniquement sur ces données n'applique donc pas toujours les termes que vous envoyez dans terminology_mapping. Si la terminologie est importante pour votre cas d'usage, ajoutez à votre propre jeu de données des exemples dans lesquels terminology_mapping est rempli et la traduction le respecte.
Préparer vos fichiers
Exportez vos exemples (depuis un tableur, une base de données, un outil de ticketing ou une mémoire de traduction) et convertissez chacun d'eux en une ligne au format ci-dessus, avec quelques lignes de code dans le langage de votre choix. Nommez vos fichiers train.jsonl et eval.jsonl, et gardez les exemples d'évaluation en dehors du fichier d'entraînement.
Lancer le job avec votre jeu de données
Créez un nouveau bucket dans votre datastore S3 et envoyez-y vos fichiers (lancez l'envoi depuis le dossier qui contient les fichiers, car le chemin courant est inclus dans le nom des objets) :
Lancez ensuite le job avec ce bucket. Comme le job ne télécharge aucune donnée, votre bucket de données peut être monté en lecture seule (le dossier base/ de mt-sft-out reste en RW, car le job y télécharge le modèle lors de la première exécution) :
DOWNLOAD_DATA=0désactive le téléchargement : le job utilise vos fichiers.TRAIN_FILEetEVAL_FILEpointent vers vos fichiers dans le bucket monté.DATASETne sélectionne ici que les paramètres d'entraînement :ecb(learning rate5e-5) ouopus100(learning rate1e-4). Vous pouvez aussi les définir vous-même : consultez la section « Personnaliser le fine-tuning ».SKIP_BENCH=1ignore les benchmarks, qui ne fonctionnent qu'avec des données de traduction. Le job calcule toujours la loss d'évaluation sur votre fichier d'évaluation. Si vos données utilisent le format de traduction, indiquezSKIP_BENCH=0pour obtenir aussi les scores BLEU et chrF++, etBENCH_Npour choisir le nombre de phrases du benchmark.
Si vous n'avez pas de fichier d'évaluation, indiquez --env EVAL_FILE= : le job s'entraîne sans évaluation. S'il manque un fichier, le job s'arrête immédiatement avec un message d'erreur dans ses logs.
Aller plus loin
Les jeux de données ouverts utilisés par le job :
- Corpus OPUS ECB : environ 196 000 paires de phrases anglais-français issues de la Banque centrale européenne
- OPUS-100 sur Hugging Face : un corpus multilingue généraliste, qui inclut l'anglais-français
Consultez nos autres tutoriels pour apprendre à :
- déployer votre modèle Olala Mini 7A1B fine-tuné avec AI Deploy
- utiliser Object Storage compatible S3 avec les produits AI
Votre avis nous intéresse !
N'hésitez pas à nous faire part de vos questions, retours et suggestions pour améliorer le service :
- Sur le serveur Discord OVHcloud
1 : S3 est une marque déposée appartenant à Amazon Technologies, Inc. Les services OVHcloud ne sont pas sponsorisés, approuvés, ou affiliés de quelque manière que ce soit.