AI Deploy - Tutoriel - Déployer un modèle Olala Mini 7A1B fine-tuné
Découvrez comment déployer un modèle Olala Mini 7A1B fine-tuné avec AI Deploy et traduire des textes via son API de traduction, à l'aide d'une image Docker prête à l'emploi
AI Deploy est couvert par les Conditions particulières OVHcloud Public Cloud.
Introduction
Olala Mini 7A1B est un modèle de langage compact que vous pouvez fine-tuner sur vos propres données avec AI Training. Une fois votre modèle fine-tuné, AI Deploy vous permet de le servir sous forme d'endpoint HTTPS, afin que vos applications puissent lui envoyer des requêtes.
Ce tutoriel vous montre comment déployer le modèle fine-tuné produit par le guide « AI Training - Tutoriel - Fine-tuner Olala Mini 7A1B avec LoRA », à l'aide d'une image Docker prête à l'emploi. Vous n'avez besoin d'écrire aucun code ni de construire aucune image : le modèle reste dans votre bucket Object Storage et l'app le charge au démarrage.
L'app expose une API de traduction : vous envoyez le texte et les langues à la route /v1/translate, et l'app renvoie la traduction. L'app construit elle-même le prompt, dans le format exact utilisé pour le fine-tuning, de sorte que le modèle ne fait que traduire : une question ou une instruction présente dans votre texte est traduite, pas traitée.
Pour d'autres usages, par exemple pour tester le modèle comme assistant conversationnel, vous pouvez aussi ouvrir les routes de chat compatibles OpenAI (consultez la section « Utiliser les routes de chat »).
Cette app est destinée à tester et évaluer votre modèle fine-tuné, et non à le servir en production. Consultez la section « Limites » ci-dessous.
Limites
L'app utilise le serveur d'inférence de la bibliothèque Hugging Face Transformers (transformers serve), adapté à Olala Mini 7A1B. Il est simple à déployer et prend en charge le modèle tel quel, mais il n'est pas conçu pour un trafic de production :
- Une requête à la fois : chaque réplica traite les requêtes une par une. Lorsque plusieurs requêtes arrivent en même temps, elles attendent dans une file, et le temps de réponse augmente avec le nombre de requêtes en attente. Ajouter des réplicas permet de servir davantage de requêtes en parallèle, mais chaque réplica utilise un GPU.
- Vitesse de génération limitée : le modèle génère les tokens plus lentement qu'avec un moteur d'inférence dédié comme vLLM ou SGLang, et un GPU plus puissant ne l'améliore que légèrement.
- Pas de limite de file ni de délai d'expiration des requêtes : le serveur ne rejette pas les requêtes lorsqu'il est surchargé.
- Traduction uniquement, mais sans garantie : la route
/v1/translateutilise toujours le format du fine-tuning, et le modèle traduit les questions et les instructions au lieu d'y répondre. Comme avec tout modèle de langage, un texte inhabituel peut tout de même produire un résultat inattendu, par exemple un texte qui ressemble lui-même à une demande de traduction. Vérifiez les traductions de vos propres textes avant de vous y fier. - Terminologie : le champ
terminology_mappingest transmis au modèle, mais les jeux de données du tutoriel de fine-tuning ne contiennent aucun exemple de terminologie : le modèle n'applique donc pas toujours vos termes.
Utilisez-la pour vérifier la qualité de votre modèle, le comparer avec le modèle de base ou construire une démo. Pour un usage en production, un moteur d'inférence dédié est nécessaire.
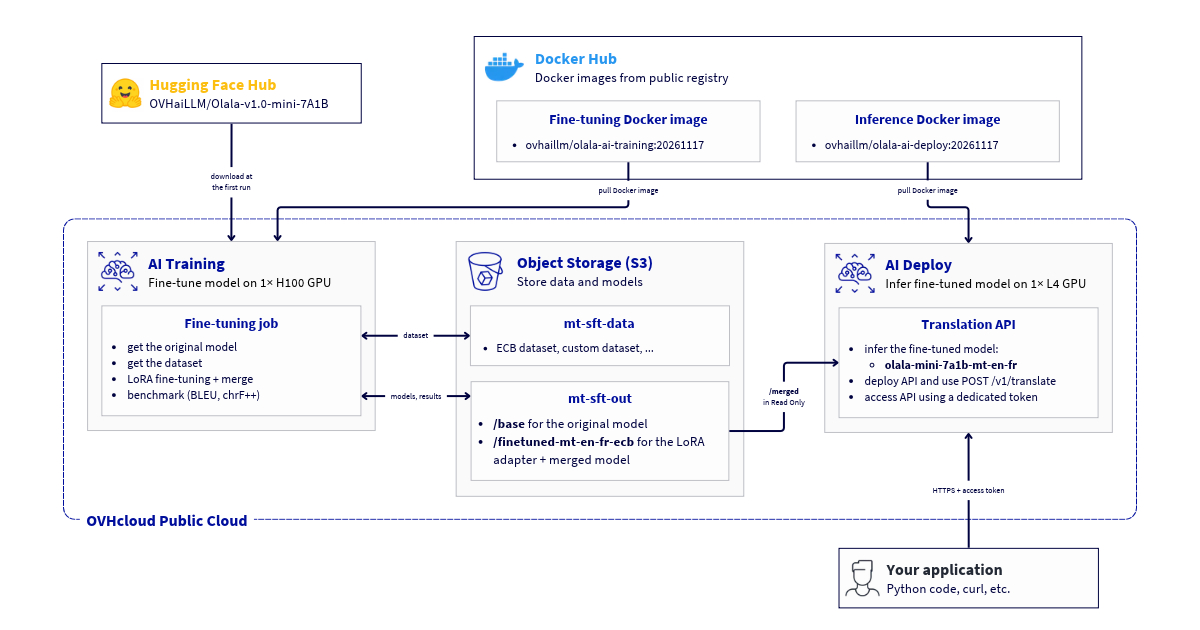
L'ensemble du workflow : le modèle fine-tuné écrit par AI Training dans votre bucket est servi par l'app AI Deploy :
Prérequis
Avant de commencer, vérifiez que vous disposez des éléments suivants :
- Un projet Public Cloud créé.
- La CLI ovhai installée sur votre système (ce guide explique comment l'installer).
- Un modèle Olala Mini 7A1B fine-tuné. Suivez d'abord le guide « AI Training - Tutoriel - Fine-tuner Olala Mini 7A1B avec LoRA » : à la fin du job, le modèle se trouve dans le dossier
finetuned-mt-en-fr-ecb/merged/de votre bucket Object Storagemt-sft-outcompatible S31 (à côté du modèle de base, dansbase/), dans la région GRA. Dans les commandes de ce tutoriel, remplacez<ALIAS>par l'alias de votre datastore S3, comme dans le tutoriel AI Training. - L'accès aux GPU L4 (ou à des GPU NVIDIA plus puissants) dans votre projet. Le modèle ne fonctionne pas sur CPU.
En pratique
Suivez ces étapes pour déployer et utiliser votre modèle :
- Vérifier votre modèle dans Object Storage
- Déployer votre app
- Suivre le déploiement
- Créer un token
- Interroger votre modèle
- Gérer votre app
Vérifier votre modèle dans Object Storage
L'app lit le modèle depuis votre bucket, monté comme volume en lecture seule. Le dossier du modèle doit contenir les fichiers écrits par le job de fine-tuning : model.safetensors, config.json, configuration_olala.py, modeling_olala.py, generation_config.json, tokenizer.json, tokenizer_config.json et chat_template.jinja.
Listez-les avec la CLI ovhai :
Si votre modèle se trouve dans un autre dossier ou bucket, par exemple mt-sft-out@<ALIAS>/finetuned-mt-en-fr-opus100/merged après un entraînement OPUS-100, remplacez mt-sft-out@<ALIAS>/finetuned-mt-en-fr-ecb/merged par son emplacement dans les commandes suivantes.
Déployer votre app
L'image contient le serveur d'inférence et toutes ses dépendances. Elle charge le modèle depuis /workspace/model et le sert sur le port 8080. Le modèle nécessite un GPU disposant d'au moins 24 Go de mémoire : un GPU L4 suffit.
Déployer votre app via la CLI ovhai
Pour suivre cette partie, assurez-vous d'avoir installé la CLI ovhai sur votre ordinateur ou sur une instance.
Exécutez la commande suivante pour déployer votre application :
Les options --env définissent le comportement de l'app. SERVED_MODEL_NAME est obligatoire : l'app ne démarre pas sans elle. Les autres options sont ici réglées sur leurs valeurs par défaut : vous pouvez les retirer et obtenir la même app.
Par exemple, pour un modèle fine-tuné sur OPUS-100, montez mt-sft-out@<ALIAS>/finetuned-mt-en-fr-opus100/merged et indiquez --env SERVED_MODEL_NAME=olala-mini-7a1b-mt-en-fr-opus100.
Explication des paramètres
--flavor l4-1-gpu --gpu 1: un GPU L4. Pour lister les GPU disponibles, exécutezovhai capabilities flavor list.--replicas 1: une instance de l'app. Consultez la section « Gérer votre app » pour en ajouter.--default-http-port 8080: le port du serveur d'inférence. Il est fixé à8080dans l'image : utilisez toujours cette valeur.--volume mt-sft-out@<ALIAS>/finetuned-mt-en-fr-ecb/merged:/workspace/model:RO: monte uniquement le dossierfinetuned-mt-en-fr-ecb/merged/de votre bucket, qui contient le modèle, en lecture seule.--label app=olala-mini-7a1b-mt-en-fr: un label utilisé pour créer un token d'accès limité à cette app (consultez la section « Créer un token »).--probe-path /v1/models ...: la readiness probe. AI Deploy n'envoie du trafic à un réplica que lorsque sa route/v1/modelsrépond. Au démarrage, l'app charge le modèle sur le GPU et compile les kernels du modèle avec une courte génération de test avant que ses routes ne répondent : la première requête est ainsi servie à pleine vitesse.--liveness-probe-path /health ...: la liveness probe. Si/healthcesse de répondre 3 fois de suite, AI Deploy redémarre le réplica. La probe démarre après 180 secondes, une fois le modèle chargé, et/healthcontinue de répondre pendant que le modèle génère de longues réponses.
Une app est facturée tant qu'elle est en cours d'exécution, même lorsqu'elle ne reçoit aucune requête. Arrêtez-la lorsque vous n'en avez pas besoin (consultez la section « Gérer votre app »).
Suivre le déploiement
L'app passe par les états QUEUED, INITIALIZING et SCALING avant d'être RUNNING :
INITIALIZING: les fichiers du modèle sont copiés depuis votre bucket ;SCALING: l'image est téléchargée, puis le modèle est chargé sur le GPU et ses kernels sont compilés. L'app estRUNNINGlorsque la readiness probe réussit.
Pour suivre la progression et les logs de l'app en temps réel, exécutez :
Une fois le modèle chargé, les logs se terminent par :
ovhai app get <app_id> affiche l'état de l'app et son URL, sous la forme https://<app_id>.app.gra.ai.cloud.ovh.net.
Créer un token
L'app n'est pas publique : chaque requête doit contenir un token d'accès. Créez un token qui ne peut accéder qu'aux apps portant le label app=olala-mini-7a1b-mt-en-fr :
Le token n'est affiché qu'une seule fois : copiez-le et conservez-le en lieu sûr. Les exemples suivants lisent le token et l'URL de l'app depuis des variables d'environnement :
Interroger votre modèle
L'app expose les routes suivantes :
Les routes de chat compatibles OpenAI (/v1/chat/completions, /v1/completions) sont désactivées par défaut et répondent par une erreur HTTP 403. Consultez la section « Utiliser les routes de chat » pour les activer.
Traduire un texte
Envoyez votre texte à la route /v1/translate avec curl :
La traduction se trouve dans le champ translation :
La requête utilise les mêmes champs que le format de traduction du fine-tuning :
Si finish_reason vaut length, la traduction a été tronquée à max_tokens : renvoyez la requête avec une valeur plus élevée. Une requête invalide est rejetée avec une erreur HTTP 400 qui explique le problème.
Le modèle traduit le texte, même lorsqu'il contient une question ou une instruction :
Avec Python et la bibliothèque requests (pip install requests) :
Utiliser les routes de chat
Pour tester le modèle comme assistant conversationnel, ou si vous l'avez fine-tuné sur une autre tâche que la traduction, déployez l'app avec --env TRANSLATE_ONLY=0. Les routes compatibles OpenAI POST /v1/chat/completions et POST /v1/completions sont alors ouvertes, et le modèle reçoit vos messages tels quels : il répond à la question que /v1/translate a traduite dans l'exemple précédent :
La réponse se trouve dans choices[0].message.content. Vous pouvez aussi utiliser les bibliothèques clientes OpenAI (pip install openai, avec base_url=$APP_URL/v1 et votre token comme clé d'API), recevoir la réponse en streaming avec "stream": true, et activer le raisonnement avec "chat_template_kwargs": {"reasoning_effort": "medium"} : le raisonnement est alors renvoyé dans le champ reasoning_content. Si vous avez fine-tuné le modèle sur votre propre tâche, envoyez le prompt système et le format de demande de vos données d'entraînement.
Gérer votre app
Chaque réplica de l'app exécute une copie du modèle sur un GPU et traite les requêtes une par une. Pour servir davantage de requêtes en parallèle, ajoutez des réplicas :
Pour arrêter l'app lorsque vous ne l'utilisez pas, puis la redémarrer plus tard avec la même URL :
Une app arrêtée n'est pas facturée pour le calcul. Pour la supprimer définitivement :
Le modèle reste dans votre bucket : vous pouvez le déployer à nouveau à tout moment.
Aller plus loin
- AI Training - Tutoriel - Fine-tuner Olala Mini 7A1B avec LoRA
- Utiliser Object Storage compatible S3 avec les produits AI
- AI Deploy - Premiers pas
- AI Deploy - Stratégies de mise à l'échelle
- AI Deploy - Accéder à vos apps via tokens
Votre avis nous intéresse !
N'hésitez pas à nous faire part de vos questions, retours et suggestions pour améliorer le service :
- Sur le serveur Discord OVHcloud
Pour une formation ou une assistance technique sur la mise en œuvre de nos solutions, contactez votre commercial ou consultez la page Professional Services pour obtenir un devis et faire analyser votre projet par nos experts.
1 : S3 est une marque déposée appartenant à Amazon Technologies, Inc. Les services OVHcloud ne sont pas sponsorisés, approuvés, ou affiliés de quelque manière que ce soit.